减少特征选择依赖,西工大提出单细胞多组学分析预训练模型 النص الأصلي بالصينية
编辑丨&
单细胞测序让研究人员能够观察单个细胞中的基因表达、染色质状态和蛋白质水平,从而解析不同细胞的身份、功能及其调控关系。但随着测量维度不断增加,如何将这些来源不同、特征数量庞大的数据整合起来,仍是单细胞计算分析中的难题。
回顾现有的单细胞预训练模型,其底层架构往往过度依赖转录组数据,且通常将每个细胞的输入规模限制在约 2,000 个基因左右。为了控制计算开销,研究人员不得不预先筛选高变基因(HVGs)或其他高变特征。
为此,2026 年 11 月 2 日,西北工业大学研究团队在《Nature Communications》发表「Building a pre-trained model for single-cell multi-omics analysis beyond highly variable feature selection」,提出预训练多模态模型 scPMMI。
论文链接:https://www.nature.com/articles/s41467-026-78933-8
按基因组位置组织特征
传统做法在对待不断膨胀的数据时虽然降低了算力负担,却也极易过滤掉那些表达变化虽不显眼、却蕴含关键生物学意义的调控信号。此外,单一组学模型难以打通不同分子层面的互补信息,限制了对细胞复杂状态的全局认知。
新模型 scPMMI 旨在突破传统框架的双重限制:一方面,它允许模型直接处理每个细胞中数万级别的全量分子特征;另一方面,通过配对多组学数据的联合预训练,使模型能够深刻捕捉不同分子模态之间共享的深层细胞状态信息。
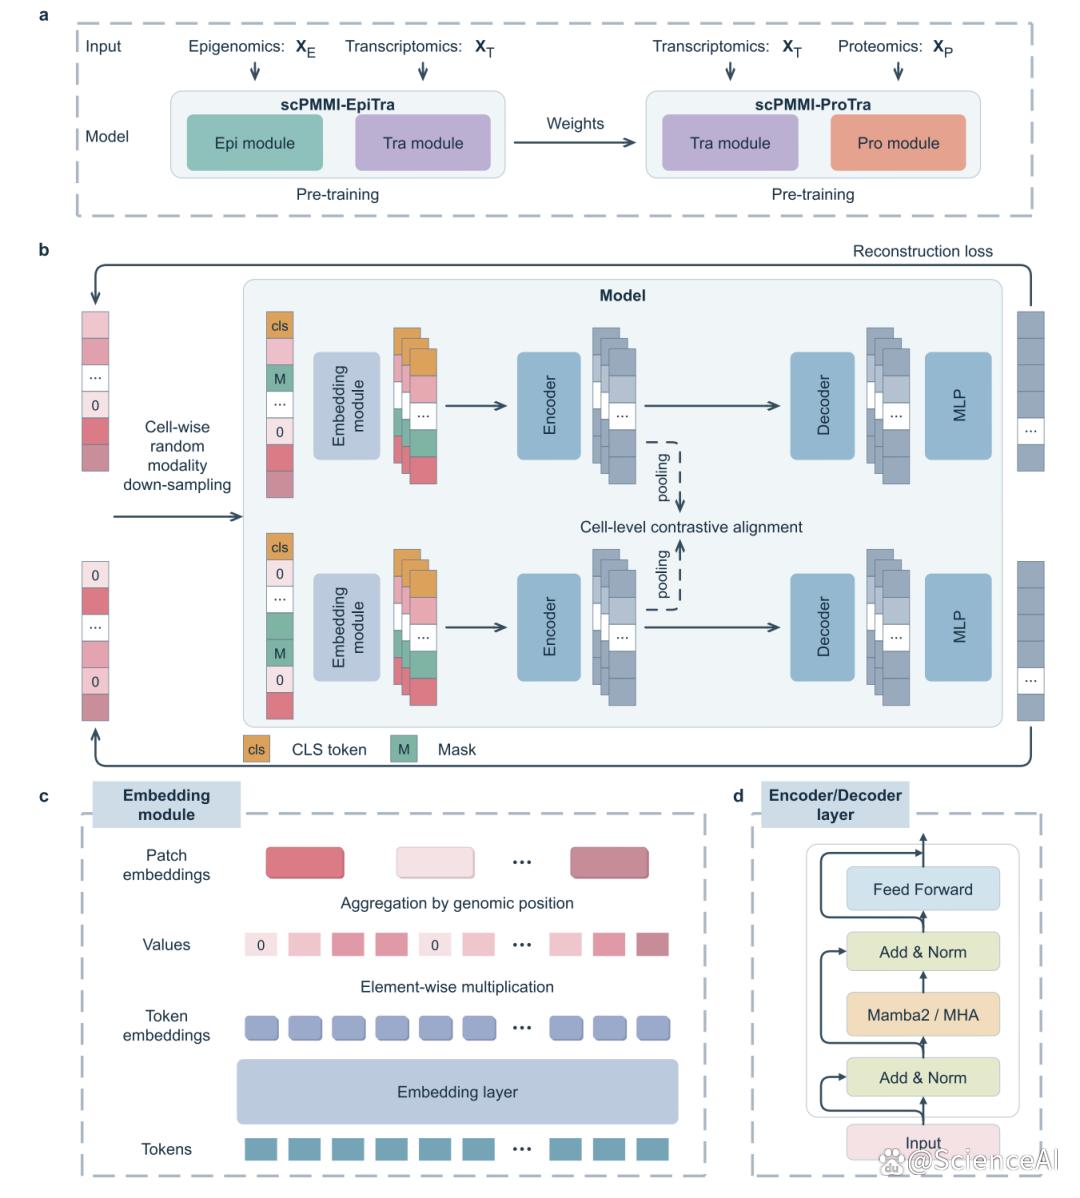
图 1:scPMMI 示意图概述。
它的核心架构可将分子特征转换为兼具空间位置与数值属性的紧凑表示。模型首先为每个基因、染色质可及性区域或蛋白质分配可学习的嵌入向量,并根据其实际表达量或测量值动态调整权重,从而将特征身份与量化数值有机结合。
针对转录组与表观基因组数据,研究团队引入了一种基于基因组坐标的分块策略:按照染色体物理位置,将连续的特征划分为互不重叠的特征分块,随后将同一分块内的特征嵌入进行聚合,并叠加可学习的位置编码。借此,模型无需将数万个基因和染色质区域作为孤立的输入单元处理,可在完整保留基因组空间拓扑关系的同时,大幅压缩序列长度。
相比之下,由于预训练数据集统一后的蛋白质面板仅包含 355 种特征,数据量相对精简,因此无需进行类似的分块处理,可直接输入嵌入模块。
在编码器层面上,scPMMI 巧妙地采用了 Mamba2 与多头注意力机制(MHA)相结合的混合架构。整个编码器共设 12 层,其中 5 层由擅长长序列建模的 Mamba2 担纲,7 层由多头注意力机制负责,解码器则由 4 层多头注意力模块构成。
这种设计兼顾了 Mamba2 高效处理长序列的潜能与注意力机制捕捉复杂特征间非线性关联的优势,确保模型能够从宏大的全特征空间中萃取高价值信号,摆脱了对少数高变基因的过度依赖。
求同存异
为了充分挖掘配对多组学数据的内在规律,scPMMI 设计了两种互补的自监督预训练任务:细胞层面的随机模态下采样任务(CRMD)与细胞层面的对比对齐任务(CCA)。前者专注于重建各个模态内部的分子细节,而后者则致力于打通不同模态间的共同细胞表示。
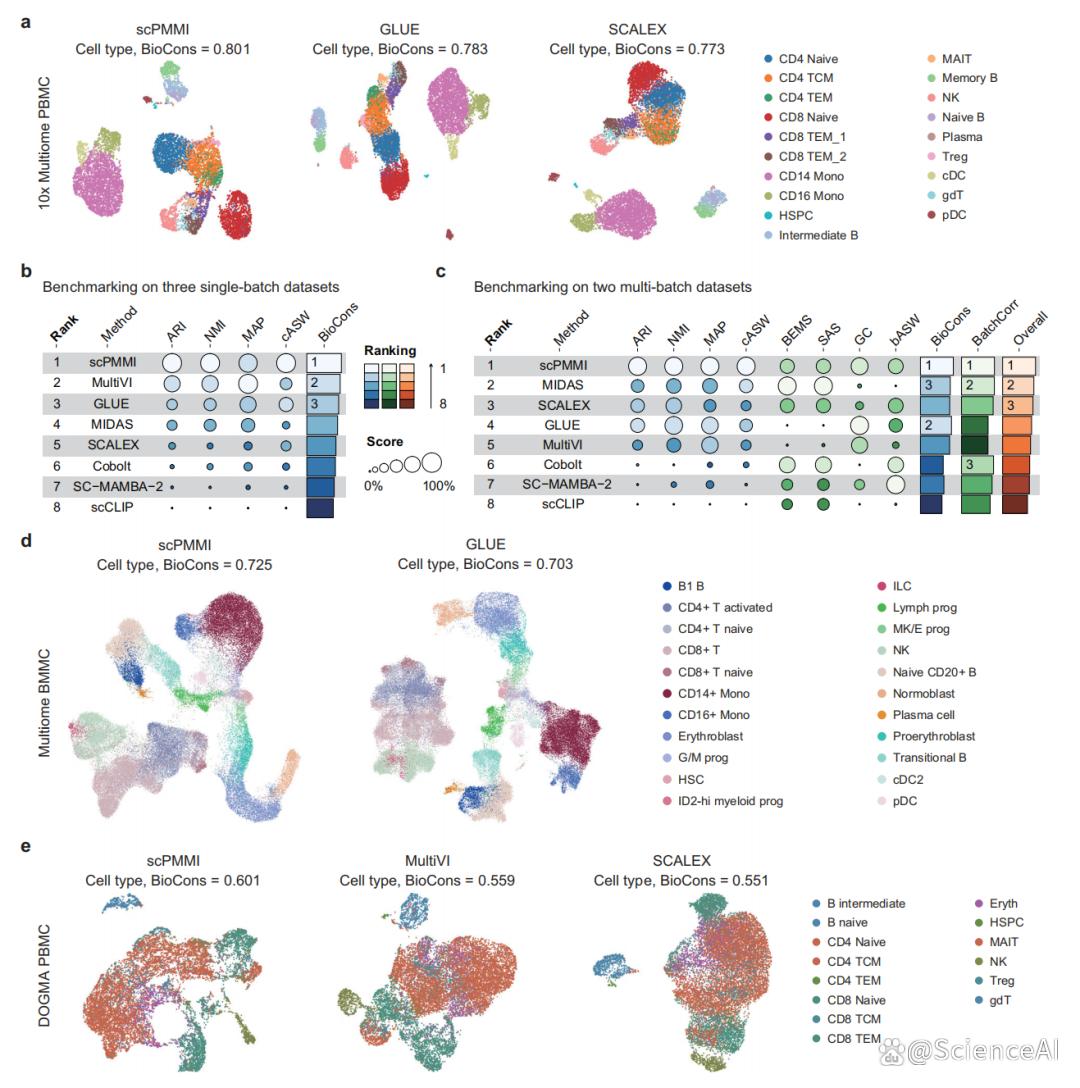
图 2:在多种多组学整合任务中的基准测试结果。
在完成预训练后,研究团队通过多项下游任务的微调,全面检验了 scPMMI 在多组学整合、细胞类型注释、蛋白质丰度预测、转录组增强及细胞分化轨迹重建等场景中的泛化与迁移能力。
下游任务检验
多组学整合评测中,scPMMI 与 scGPT、SC-MAMBA-2、MIDAS、MultiVI、GLUE、SCALEX、scCLIP 及 Cobolt 等主流方法展开了横向对比,并展示出其对复杂生物学结构与批次差异的卓越兼顾能力。
转录组与蛋白质组整合及蛋白质丰度预测任务中,模型展现出利用 RNA 表达信息推断细胞表面蛋白水平的能力。在 CITE-seq 数据集上,scPMMI 的平均预测相关性较对照方法提升了约 9%。
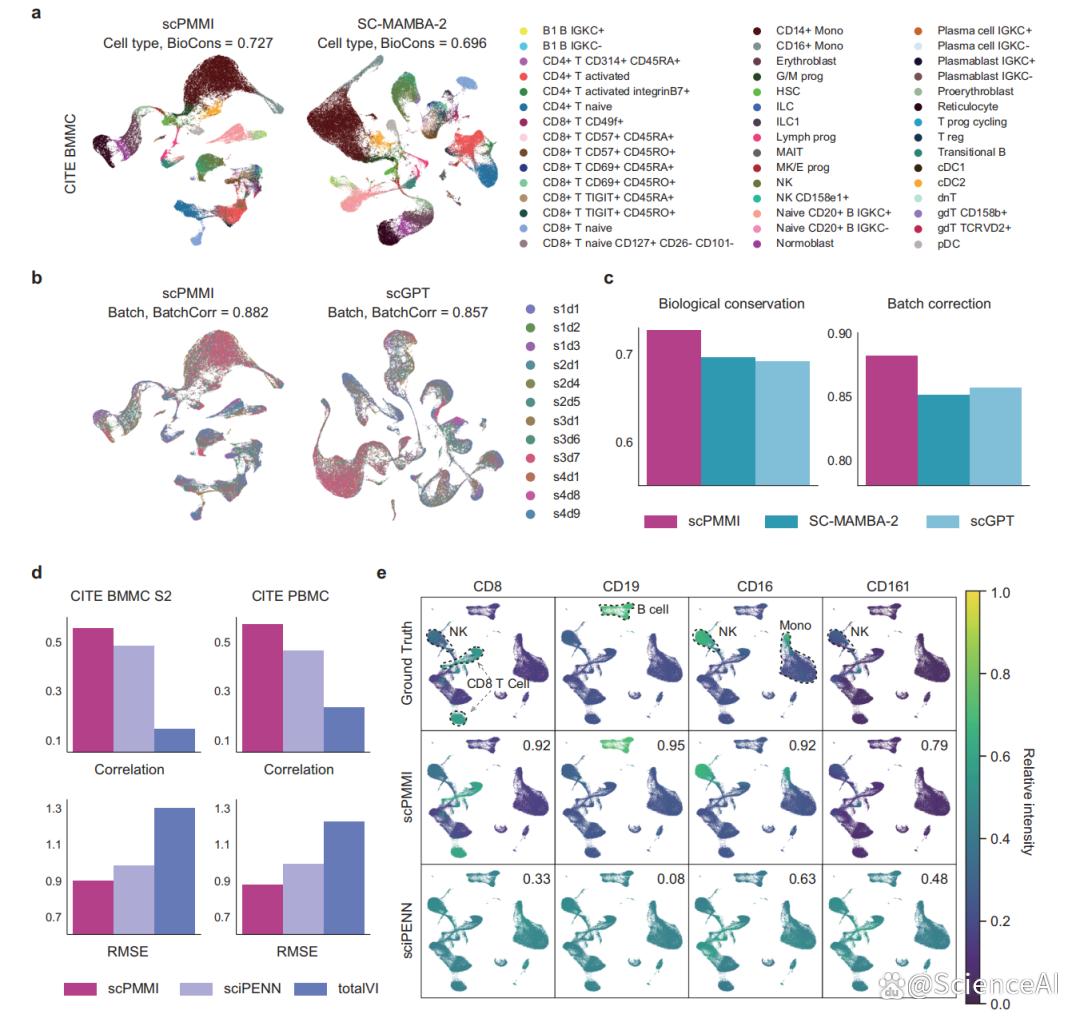
图 3:转录组学与蛋白质组学数据的整合及蛋白质丰度预测。
在细胞类型注释测试中,scPMMI 在五个测试数据集上实现了 86.3% 的平均准确率,较位列第二的 scGPT 高出 7.3%。即便在包含复杂罕见细胞亚型的数据集中,模型依然能够精准识别部分表达谱极为接近的细胞群,不过样本极度稀少的极少数稀有细胞类型仍存在一定的误分类风险。
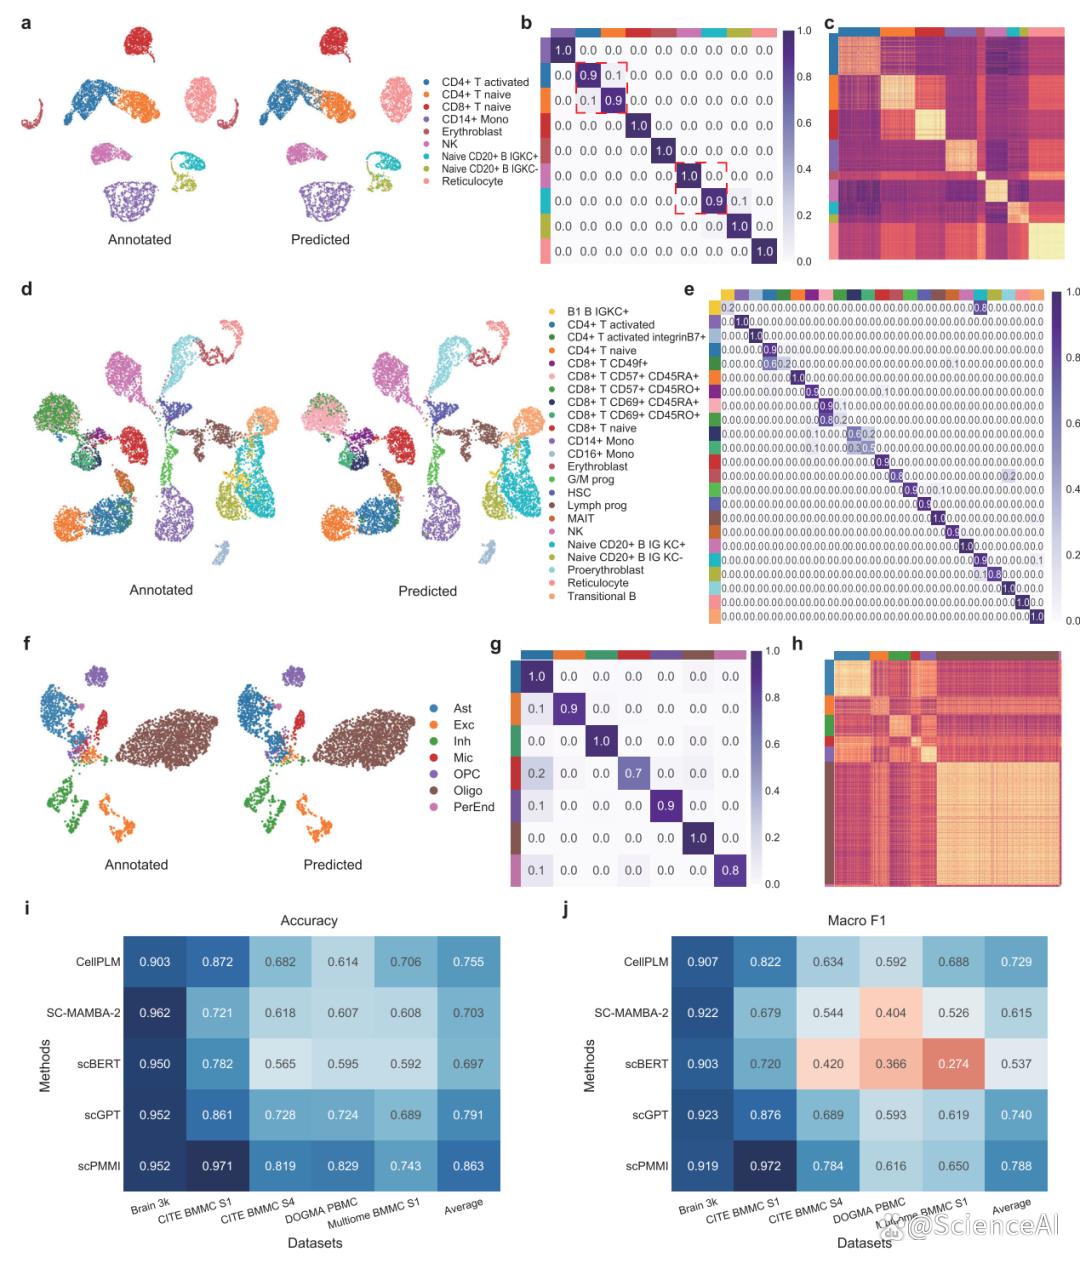
图 4:使用 scPMMI 的细胞类型注释结果。
在转录组增强实验中,研究人员将 10x Multiome PBMC 数据的 RNA 测序深度人为降至原始水平的 10%,随后借助配对的表观基因组信息引导模型恢复细胞表示。scPMMI 在聚类相关指标上超越了 scFoundation 和 scVI,并成功分辨出在原始数据中难以清晰剥离的初始 CD4 与初始 CD8 T 细胞亚群。另一个利用蛋白质组信息改善转录组细胞表示的实验同样取得了更优的聚类表现。
最后,研究团队利用包含 69,249 个骨髓单核细胞的多组学数据,分析红系分化过程。整合后的 scPMMI 细胞表示则重建出连续的发育路径,从造血干细胞经过巨核细胞/红系祖细胞,再到原红细胞、红细胞母细胞和正染性红细胞。模型在轨迹保留和生物学信号保留指标上均优于所比较的方法。
更完整的特征输入
尽管性能卓越,但研究团队仍指出了一些客观不足。全面扩大输入特征并不意味着高变特征筛选策略彻底失去了历史舞台。当数据过于稀疏或质量较差时,特征筛选仍然是有效的预处理方法。scPMMI 的核心优势在于其精心设计的架构,但这种增益高度依赖于具体的数据集特征与分析任务,并非所有场景都能从中获益。
除此之外,研究还面临着可用多组学数据量不足的问题。现有多组学预训练语料至少比那些使用数千万细胞进行单模态预训练的模型少一个数量级。因此,团队将 scPMMI 定位为单细胞多组学预训练模型,而不是拥有同等预训练规模的通用基础模型。未来还需要扩大配对数据的规模与组织、疾病类型覆盖范围,才能进一步提升模型的迁移能力。
相关链接:https://github.com/23AIBox/scPMMI