论文解析:同样错一个词,后果差 9 倍:语音 Agent 的 ASR 错误什么时候才要命 Оригинал на китайском
用户对语音助手说:“把温度调到 22 度。”
语音识别给出两种结果:
- 听成“把温度调到 32 度” —— 空调开到 32 度;
- 听成“把一个温度调到 22 度” —— 还是 22 度,什么事都没有。
两种情况都只听错了一个词,词错误率(WER)完全一样。但一个用户得再说一遍,另一个根本察觉不到。
这是德国汉诺威莱布尼茨大学一篇论文的核心例子。它回答的问题很实际:ASR 的识别错误,到底什么时候才会真正影响语音 Agent 做的事?
一、WER 衡量的是「错了多少」,不是「错在哪」
级联语音 Agent 的流程是:语音 → ASR → 大模型 → 结构化动作(工具调用)。
我们对 ASR 的传统评价标准是 WER:转录文本和参考文本之间的编辑距离,除以参考词数。它隐含一个假设——每个词的重要性相同。
但对下游真正重要的是另一件事:模型最终生成的工具调用,和用户原本的意图一不一致。转录有多像只是手段,动作对不对才是目的。
论文提出的指标叫 JCA(Joint Call Accuracy,联合调用准确率):最终动作正确的样本占全部样本的比例,包括“这一句不该调用任何工具”的情况。
二、给句子里的每个词分配一个角色
论文的第一个动作,是把句子里的片段按“在任务中承担什么作用”分成七类:
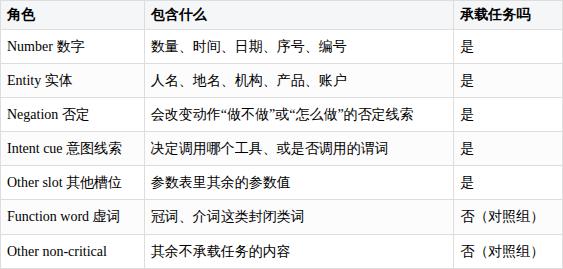
有一个细节值得留意:论文特意说明,“非关键”的意思是这个片段没有被标注为承载任务,并不等于改了就一定无害。
三、一场把变量按死的实验
这是我认为整篇论文设计得最漂亮的地方。
要做干预实验,就得排除干扰。论文的方法是配对:同一句源话、同样的编辑数量、同样的编辑操作(都是替换一个词)、同样的 Agent 配置、同样的参考动作。唯一的变量是被改的那个词属于哪个角色。
为什么要这么麻烦?因为严重的角色可能在声学上本来就更难识别。如果不做匹配,你会把“这个词本来就难听清”误当成“这个角色很危险”。
论文给了反证:去掉严重度匹配之后,任务角色造成的平均损失从 17.3 个百分点涨到 20.6——不匹配会明显夸大角色的效应。
实验规模:594 条源语句,一半来自 VoiceAgentBench、一半来自 BFCL Audio;其中 540 条需要调用工具、54 条不需要。ASR 用了 Whisper large-v3、SenseVoice-Small、Paraformer-large 三套;后面的 Agent 用 Qwen2.5-7B-Instruct,另用 Llama-3.1-8B-Instruct 做复现验证。
先看真实音频上的整体情况:
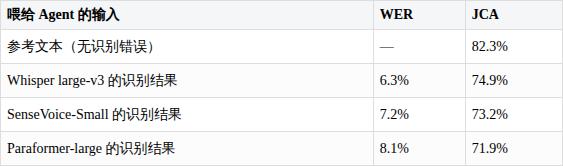
也就是说,光是 ASR 这一环,就让最终动作的准确率掉了 7.4 到 10.4 个百分点——而这还只是 6%~8% 的 WER。
四、致命排行:错在哪,损失差 9 倍
回到配对实验。同样只改一处,按角色分组后的净损失是这样排的:
- Negation 否定词:−25.7 个百分点(95% CI [20.0, 31.9])
- Number 数字:−21.9([16.7, 27.6])
- Entity 实体:−17.1([12.4, 22.4])
- Intent cue 意图线索:−12.4([8.1, 17.1])
- Other slot 其他槽位:−9.5([5.7, 13.8])
- Function word 虚词:−2.9([0.5, 5.7])
- Other non-critical:−1.4([−0.5, 3.8],与零无显著差异)
错一个否定词损失 25.7 个百分点,错一个虚词只损失 2.9 个百分点——差 9 倍。
而这两种情况在 WER 眼里,是完全等价的一次替换。
换成另一个 Agent(Llama-3.1-8B)再跑一遍,排序完全一致(否定 23.3、数字 19.0、实体 15.7……)。说明这个规律不挑模型,是任务结构决定的。
五、只说「是不是关键」还不够
看到这里你可能会想:那我只要判断“这次改的是不是关键内容”就行了。
论文专门测了这件事。他们做了一组递进的预测实验——给定一次改动,能不能提前预测“这次会不会把动作搞错”。特征一步步加:
- B0 只有词汇严重度:AUC 0.62
- B1 加 BERT 语义距离:0.68
- B2 加 Semantic-WER:0.70
- B3 加“是否命中关键区”(二值):0.73
- B4 再加“具体是哪个角色”:0.78
核心对比是 B4 对 B3:两者都已经包含了词汇和语义的控制变量,唯一的差别是 B4 进一步说清了被改片段的角色身份。
B4 比 B3 高 0.05(95% CI [0.02, 0.08],p = 0.003)。
也就是说:光知道“关键内容被改了”不够,知道“是哪一类关键内容”能显著提升你判断后果的能力。
六、这些错误最后变成了什么
把 216 个“被搞坏”的样本归个类:
参数值错占 47.7%,是最常见的一类——工具选对了、结构也对,就是数字或名字填错了。
但真正值得警惕的是另外三项加起来占 30.1%:决策错(该调的没调)7.9% + 选错工具 19.4% + 输出格式错 2.8%。
这意味着什么
近三分之一的出错不是“参数填错了”,而是整个动作的方向就变了。这一类错误用户往往更难察觉,也更难通过简单的参数校验兜住。
七、对做语音 Agent 的人意味着什么
- 回归测试按角色排优先级,别按 WER 排。数字、否定、实体这三类要优先覆盖。同样的测试预算花在这里,收益高一个量级。
- 汇报指标别只看整体 WER。6% 的 WER 落在虚词上和落在数字上,是两件完全不同的事。可以按角色分层统计错误率。
- 对高风险角色做「确认回路」。识别出数字、否定、实体之后回读确认一遍,成本很低,但恰好挡住的是损失最大的那几类。
- 区分“工具选错”和“参数填错”。论文的错误分类本身就是一份调试清单——先定位是哪一类,再决定改 ASR、改 prompt 还是改 schema。
一个别误用的地方
论文明确说了,这套方法用了参考文本和参考动作,是离线诊断工具,不是部署时的实时检测器。它适合用来做选型、做回归、做错误分析,不适合直接拿去线上做兜底判断。
另外也要看到它的边界:只测了英语、用的是合成语音、不需要调用工具的样本只有 54 条;而且配对只控制了词汇严重度,没有控制语义距离和声学似然。结论迁移到中文、真实录音、更大的工具集上,还需要再验证。
写在最后
这篇论文做的事情其实不复杂:它把“错得多不多”和“错在哪”拆开,然后用一场控制变量很严的实验,量化了后者的分量。
WER 告诉你转录有多像,不告诉你动作有多准。
对语音 Agent 来说,用户感知到的从来不是那句转录文本,而是空调有没有调到他要的温度、航班有没有订到他要的城市。既然关心的终点是动作,衡量的起点就不该停在词上。
下次评估 ASR 的时候,除了报一个 WER,也许可以再补一句:这几个错误,分别落在哪一类角色上。
论文信息
- 题目:When Does an ASR Error Matter? Task-Role Diagnostics for Tool-Using Voice Agents
- 作者:Xiaolong Wang, Shijie Su, Naqi Xiong(Leibniz University Hannover)
- 方法名:SpeechEvalX,代码与配置见 github.com/invoker-qqwrv/SpeechEvalX
- 数据:594 条源语句,来自 VoiceAgentBench 与 BFCL Audio 的公开子集
- 本文处理:文中所有数字均引自论文原表(Table 3–7),未做二次加工;解读与工程建议为本文作者观点。论文局限已在正文说明。