SOTA:当AI学会“选策略”而不是“选合约”,用结构化决策征服期权市场 Оригинал на китайском
“SOTA: STOCK OPTIONS TRADING AGENTS GUIDED BY OPTION-IMPLIED RETURN DISTRIBUTIONS”
期权交易有多难?单只股票就可能挂着数千个合约,行权价、到期日、看涨看跌各不相同,还得决定怎么把它们组合起来。现有方法大多选择"绕道走"——要么只预测单个合约收益,要么把策略锁死在一种固定结构里(比如跨式组合),市场一变就束手无策。
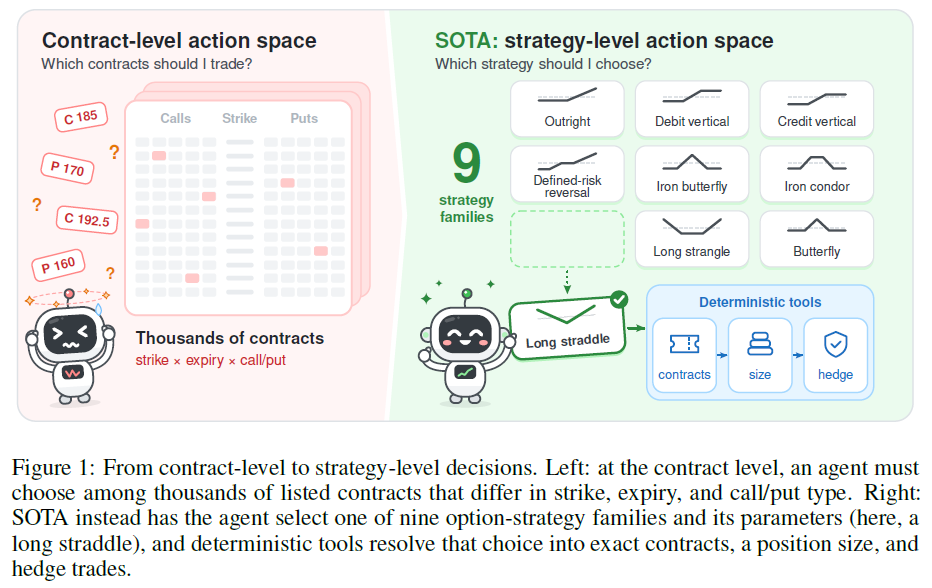
Yizhen Xie 与 Mengyang Liu 提出的 SOTA(Stock Options Trading Agents)换了个思路:让语言模型做"选择题",从九个具有经济意义的策略族(覆盖方向性、波动率、偏度、曲率四大类)里挑一个并给出参数,剩下的找合约、定头寸、做对冲全交给确定性求解器。这样一来,庞大的合约级决策问题被压缩成一个紧凑的策略空间。
模型以 Qwen3.8-27B 为底,先在前沿模型轨迹上监督微调,再用 GRPO 针对扣除交易成本后的组合收益做强化学习。在 SPY 与九只美股大盘股的期权上,六个月样本外期间 SOTA 斩获 18.32% 总收益、1.60 夏普比率、8.96% 最大回撤,而所有规则类与机器学习类基线全线告负(GBDT 亏 49.78%,Logistic 亏 55.45%)。
更耐人寻味的是新闻的"双面性":它能帮前沿教师生成更好的轨迹,却在强化学习阶段成了拖累——保留新闻后总收益从 18.32% 暴跌至 -2.72%,最大回撤飙到 31.69%。作者由此抛出一个值得玩味的判断:对构建专家监督有用的信息,未必对下游策略优化同样有用。
【 扫描文末二维码加入星球获取论文 】
摘要
随着期权市场壮大与AI进步,期权交易智能体系统日益受到关注。基于语言模型的智能体能够对新闻等情境信息进行推理,但期权交易是一个尤为困难的决策问题:单只股票可能拥有数千个合约,智能体必须同时决定交易哪些合约以及如何组合它们。现有方法往往回避这一复杂性,将策略限制在固定结构(如跨式组合)内,从而限制了随市场状况变化而切换策略的能力。
本文提出 SOTA(Stock Options Trading Agents),一个面向结构化期权策略选择的智能体交易框架。SOTA 将庞大的期权宇宙抽象为策略层面的决策,由确定性求解器负责投资组合实现。作者通过对 Qwen3.8-27B 进行监督微调与随后的强化学习来完成 SOTA 的后训练。SOTA 在同一交易环境中,针对九只美国大盘股及 SPY 的期权,与基于规则和机器学习的策略选择器进行对比评估。
在为期六个月的样本外期间,SOTA 取得 18.3% 的总收益,夏普比率为 1.60,最大回撤为 8.96%。作者还记录了一个关于新闻的不对称作用:新闻能够改进前沿教师模型的轨迹,但在强化学习期间保留新闻会使样本外收益从 18.3% 降至 2.7%。
简介
年来期权交易迅速扩张(Bryzgalova et al., 2023),为能力日益增强的交易智能体提供了天然的试验场景。近期的语言模型交易系统将金融决策建模为与市场环境的序贯交互:智能体观察市场信息与组合状态,并选择买入、卖出或持有等动作(Yang et al., 2023a;Yu et al., 2025;Zhang et al., 2024;Xiao et al., 2024)。将这一形式化推广到期权则较为困难,因为决策空间大得多且随时间变化。
对单个标的而言,智能体可能面对数千个在行权价、到期日与期权类型上各异的合约。现有方法通过两种方式降低复杂度:一是预测单个合约的收益(Bali et al., 2023),二是把交易问题限制在单一策略类别(如波动率交易,Sheu & Wei, 2011;Chen et al., 2025b)。这些形式化虽有价值,但无法直接支持在异质收益结构之间进行动态选择。
强化学习(RL)适合处理含交易成本、离散再平衡与组合状态依赖的序贯交易问题(Sutton & Barto, 2018;Mnih et al., 2015;Bühler et al., 2019;Chen et al., 2025b)。它已被应用于组合管理、股票交易与高频交易(Jiang & Liang, 2017;Yang et al., 2020;Briola et al., 2021;Qin et al., 2024;Zong et al., 2024)。然而在期权中,基于学习的方法主要聚焦于对冲(Bühler et al., 2019)或在固定波动率结构(如平值跨式组合)内学习头寸(Tan et al., 2024;Chen et al., 2025b)。在异质期权策略之间进行选择仍然颇具挑战。
本文提出 SOTA,一个面向结构化期权策略选择的智能体交易框架。SOTA 将策略层推理与合约层实现分离:语言模型在九个具有经济意义的策略族及其参数中进行选择,确定性求解器则将每个决策映射为精确合约、头寸规模与对冲。这种结构化策略选择接口在缩减决策空间的同时,并未把智能体限制在单一收益结构上。策略还可以在产生可执行期权头寸之前,将结构化市场信息与新闻等情境信号结合起来。
本文的主要贡献包括:
1)将期权交易形式化为结构化策略选择,而非合约层面选择。智能体在九个策略族及其参数中选择,确定性求解器将这些决策映射为合约、头寸规模与对冲。这相当于把庞大的合约级决策问题缩减为一个紧凑的策略空间,覆盖方向性、波动率、偏度与曲率交易。
2)构建了一个时点(point-in-time)交易环境,其状态概括了期权隐含收益分布,并使用匿名化的前沿模型轨迹对 Qwen3.8-27B 做监督微调,随后基于扣除交易成本后的组合收益进行强化学习。
3)在九只美国大盘股以及 SPY 的期权上,SOTA 在六个月样本外期间取得 18.3% 的总收益与 1.60 的夏普比率,而所有基于规则与基于机器学习的基线均产生负收益。消融实验表明,强化学习较单纯的监督微调有所改进,而新闻对前沿教师有益,但在强化学习期间保留会降低表现。
相关工作
智能体交易
智能体交易系统把交易视为与市场的重复交互:每一步智能体观察价格与自身组合,采取动作,并通过盈亏获得反馈。早期系统用强化学习学习该策略,已应用于股票(Yang et al., 2020)、加密货币(Jiang & Liang, 2017;Qin et al., 2024;Zong et al., 2024)以及使用限价订单簿数据的高频交易(Briola et al., 2021),FinRL-Meta 等共享环境使这些设定易于基准测试(Liu et al., 2022)。这些方法主要作用于数值型市场数据。
语言模型智能体则增加了处理新闻、备案文件及其他文本的能力。金融语言模型将通用模型适配到金融文本(Yang et al., 2023a;b)。在此基础上构建的交易智能体加入了过往事件的记忆(Yu et al., 2025)、多模态输入与工具使用(Zhang et al., 2024),或分析师、研究员、交易员与风控经理等多智能体角色(Yu et al., 2024;Xiao et al., 2024),并有智能体平台与市场模拟器支撑这些设计(Yang et al., 2024;Zhang et al., 2026)。当语言模型智能体自行交易时,其表现仍参差不齐:在真实股票数据上,StockBench 发现大多数语言模型智能体难以跑赢简单的买入并持有基线(Chen et al., 2025a)。
在这两条研究路线中,动作空间都小而固定:买入、卖出或持有单只股票或加密货币,或在一组固定资产上选择组合权重。期权并不符合这一模式:每个标的可能有数千个合约,可用合约集合随合约到期与新合约上市而变化,且一个头寸往往组合了多个合约。SOTA 保留了智能体循环,但改变了动作:智能体选择一种期权策略及其参数,确定性工具将该决策转化为合约、头寸规模与对冲。
期权隐含收益分布
期权价格编码了市场对未来收益的分布(Breeden & Litzenberger, 1978)。不同行权价与到期日的隐含波动率揭示了该分布的波动率、偏度与峰度(Corrado & Su, 1996;Dennis & Mayhew, 2002;Bakshi et al., 2003;Dumas et al., 1998;Cont & da Fonseca, 2002;Zhang & Xiang, 2008)。这些期权隐含指标对未来结果具有信息价值:隐含波动率可预测已实现波动率(Christensen & Prabhala, 1998),期权交易量携带关于未来股价与波动率的信息(Easley et al., 1998;Pan & Poteshman, 2006;Ni et al., 2008),而与波动率相关的特征可预测期权收益的横截面(Goyal & Saretto, 2009;Cao & Han, 2013),机器学习模型则在大规模上利用了这种关系(Bali et al., 2023)。本文的市场状态正是由这些指标构建的。
期权交易策略
期权策略通过组合合约来创造不同的收益暴露。期权价值的二阶近似为:
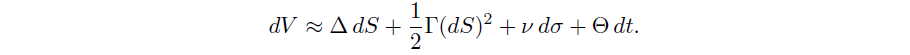
其中 delta 衡量方向性暴露,gamma 反映相对于标的价格的凸性,theta 表示时间衰减,vega 衡量对隐含波动率的敏感度。附录 A 给出了它们的 Black–Scholes–Merton 公式(Black & Scholes, 1973;Merton, 1973)。这些敏感度支撑了本框架中四大类交易策略:方向性、波动率、偏度与曲率策略。
方向性策略:表达对标的价格涨跌的观点,其收益主要由净 delta 暴露驱动,不同期权结构允许以不同杠杆、不对称性与下行保护程度来表达同一方向性观点。
波动率策略:表达对标的资产波动幅度(而非方向)的观点。做多波动率头寸从大幅价格变动中获益,做空波动率头寸则在价格变动有限时获益。其表现取决于凸性、时间衰减与期权价格变化之间的权衡(Bakshi & Kapadia, 2003;Carr & Wu, 2009;Goyal & Saretto, 2009)。
偏度策略:表达对下行与上行风险定价是否存在差异的观点。它们比较远离当前股价的看跌与看涨期权的相对价值,并可在这种不对称性发生变化时获利(Bakshi et al., 2003;Gârleanu et al., 2009;Kozhan et al., 2013)。
曲率策略:表达对接近当前股价的合约与远离当前股价的合约之间价格差异的观点,从中央行权价与更极端行权价的相对定价变化中获利(Breeden & Litzenberger, 1978;Zhang & Xiang, 2008)。
SOTA 在横跨这四类别的九个策略族上执行结构化策略选择。
SOTA:面向股票期权交易智能体的结构化策略选择
期权交易构成一个大且动态变化的决策问题:对单个标的,智能体可能面对数千个在行权价、到期日与期权类型上各异的合约。因此,在时间敏感的交易日中直接进行合约层面选择相当困难。
SOTA 将该问题形式化为结构化策略选择:语言模型选择一种期权策略及其参数,确定性求解器负责合约选择、头寸规模、对冲与组合实现。这种分离在缩减合约级决策问题的同时,保留了跨异质收益结构的灵活性。图 1 概括了该框架:左侧为合约级动作空间——"我应该交易哪些合约?";右侧为 SOTA 的策略级动作空间——"我应该选择哪种策略?"。在合约层面,智能体必须在数千个在行权价、到期日与看涨/看跌类型上各异的上市合约中挑选;而 SOTA 让智能体在九个期权策略族及其参数中选择(图中示例为多头跨式组合),再由确定性工具将该选择解析为精确合约、头寸规模与对冲交易。
问题建模
交易环境。智能体在一组标的 U 的期权上进行交易,决策日期为 t = 0, 1, ......, T。在日期 t,标的 u ∈ U 具有价格 S_t^u 与一份上市期权链 C_t^u。每个合约 c ∈ C_t^u 由其行权价、到期日与类型(看涨或看跌)定义,每份合约价格为 p_t^c,取买卖报价中点。一条期权链持有数千个具有不同非线性暴露的合约,并随合约到期与新合约上市而随时间变化。
进入日期 t 的组合持有每个期权 c 的 q_t^c 份合约、每个标的 h_t^u 股用于 delta 对冲,以及现金 B_t。其按市值计的价值为:
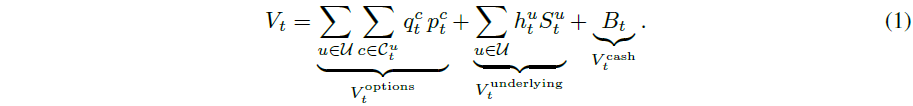
交易是序贯的。在每个日期 t,智能体观察市场与自身组合,并发出交易决策 a_t。环境将 a_t 转换为交易 Δ q_t^c 与 Δ h_t^u,以中点价格执行,并收取费用与佣金 TC_t。交易后的持仓与现金为:
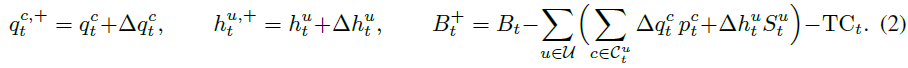
这些持仓结转至日期 t+1,在新价格下重新标记,到期合约进行结算。因此从 V_t 到 V_t+1 的变化反映了期权价格变动、对冲头寸、交易成本与结算。直接对每个上市合约选择 Δ q_t^c 会形成一个大且动态变化的决策空间,因此本文转而将每个决策 a_t 表示为来自具有经济意义的策略族的标准化期权组合,由确定性求解器将其转化为合约层面的交易。
马尔可夫决策过程。本文将期权策略选择形式化为马尔可夫决策过程:
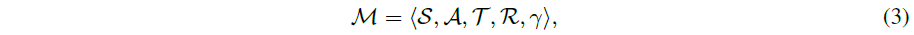
其中 S 为状态空间,A 为结构化策略空间,T 为转移机制,R 为奖励函数,γ 为折扣因子。
状态。在每个交易日 t,智能体观察到时点状态:
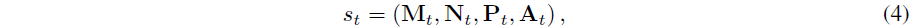
其中 M_t 包含市场特征,N_t 为新闻与备案文件的时点文本摘要,P_t 为未平仓期权头寸,A_t 为组合层面信息。组合状态使得每个决策可以以承自先前交易的暴露与结果为条件。
市场状态由期权定价与期权收益文献中被认为与期权收益变动相关的变量构建(Goyal & Saretto, 2009;Cao & Han, 2013;Bakshi et al., 2003;Pan & Poteshman, 2006)。对每个标的,状态包含 10 个特征:标的收益、已实现波动率、隐含波动率水平及其变化、隐含减已实现波动率之差、期限结构、偏度、曲率、期权流与未平仓量变化。
结构化策略选择。策略不直接在上市合约中选择,而是选择结构化交易策略。在每个决策时点,策略输出一组动作:开新仓(a_t^open)、平现有仓(a_t^close)、将现有头寸展期至更晚到期(a_t^roll),或保持组合不变(a_t^hold)。
一个动作 a_t 被指定为 (u, f, ω, θ, κ),其中 u 为标的,f 为策略族,ω 为做多/做空方向,θ 为期限桶,κ 为策略在 delta 网格上的坐标。
为避免查询完整期权链的价格,智能体首先为每个标的提出至多六个候选策略。最终交易决策前只对这些候选组合进行解析与定价。这种两阶段机制在无需将数千个合约放入模型上下文的前提下,保留了价格感知的策略选择。因此学习到的策略专注于策略选择,而确定性求解器负责合约选择、组合规模与 delta 对冲,附录 E 报告了后者的实现规则。
转移。转移核 T(s_t+1 | s_t, a_t) 刻画市场状态、新闻与备案文件、现有头寸及其风险暴露、以及扣除交易成本后的组合价值的变化,持仓与现金按公式(2)演化。
奖励。单步奖励为组合价值对数的变化:
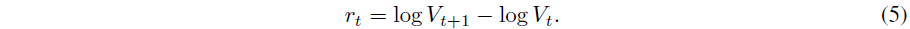
策略分两阶段训练:先在前沿模型的交易轨迹上进行监督微调,得到初始策略选择策略;随后用 GRPO(Shao et al., 2024)针对组合表现优化策略。
实验
实验设置
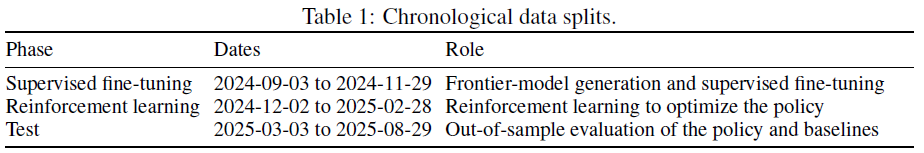
数据集。SOTA 在 10 个活跃交易标的上评估:SPY 以及九只美国大盘股(AAPL、AMZN、GOOGL、META、MSFT、MU、NVDA、PLTR 和 TSLA)。期权数据包括 OPRA 交易与报价以及 OptionMetrics。标的价格为九只股票的 CRSP 每日开盘与收盘价,以及 SPY 的 SpringerRock 标的标记。新闻来自 Massive.com 的新闻 API,监管备案文件来自 SEC EDGAR。表 1 报告了按时间顺序的数据划分。
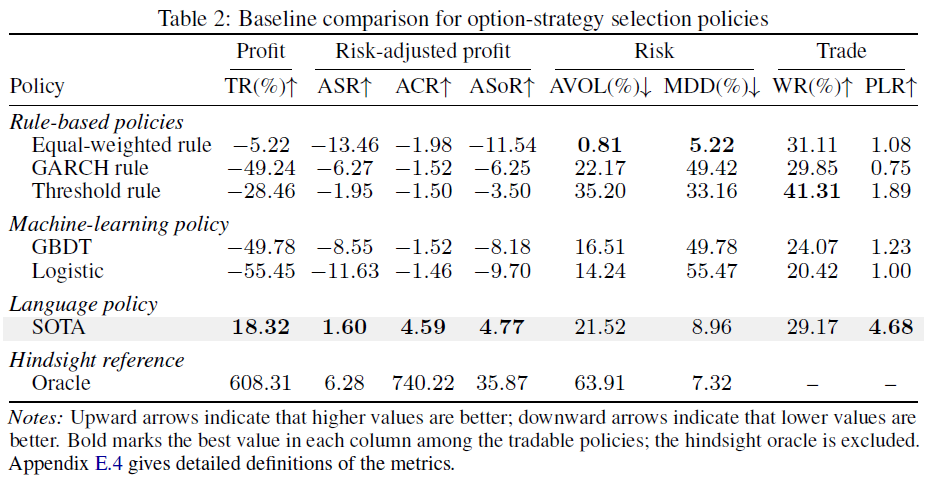
评估指标。使用八个金融指标评估组合表现:总收益(TR)、年化夏普比率(ASR)、年化 Calmar 比率(ACR)、年化 Sortino 比率(ASoR)、年化波动率(AVOL)、最大回撤(MDD)、胜率(WR)与盈亏比(PLR)。TR 衡量评估期内的累计收益。AVOL 为日收益的年化标准差,MDD 为组合价值从峰值到谷底的最大跌幅。ASR 衡量收益相对于总波动率,ACR 相对于最大回撤,ASoR 相对于下行偏差。WR 为盈利交易占已完成交易的比重,PLR 为盈利交易的平均盈利相对于亏损交易的平均亏损之比。附录 E.4 给出精确定义。
基线。将 SOTA 与传统的基于规则和基于监督机器学习的期权策略选择策略进行比较。基于规则的基线包括等权策略配置、基于 GARCH 的规则(Bollerslev, 1986),以及基于结构化市场特征的阈值策略。GARCH 规则将波动率预测与同期期权市场信息结合。监督机器学习基线从数值市场状态预测收益,并用预定实现规则将这些预测映射为策略选择。所有可行策略使用相同的测试日期、执行模型、交易成本假设、组合约束与确定性求解器,因此表现差异反映的是策略选择规则而非组合实现。附录 G 给出基线的详细说明。
基线比较
表 2 在测试期内比较了 SOTA 与基于规则和机器学习的基线。SOTA 取得 18.32% 的总收益、1.60 的年化夏普比率与 8.96% 的最大回撤。在同一评估中,所有基于规则与监督机器学习的基线均产生负的总收益与风险调整收益。等权规则波动率相对较低但收益为负,而 GARCH 与阈值规则表现出更大亏损与回撤。GBDT 与 logistic 策略分别亏损 49.78% 与 55.45%。在该评估中,SOTA 是唯一具有正总收益与风险调整收益的可行策略,表明后训练的语言策略捕捉到了固定规则或监督映射未能复现的策略选择模式。
表 2 最后一行报告了一个事后 oracle。它在每个决策时点使用已实现的未来结果,从同一候选集中选出表现最好的策略。因此 oracle 不可交易,但它使用与可行策略相同的交易成本、规模规则、头寸限制与对冲规则。其收益为结构化策略空间内可获得的盈利水平提供了参照。
消融研究
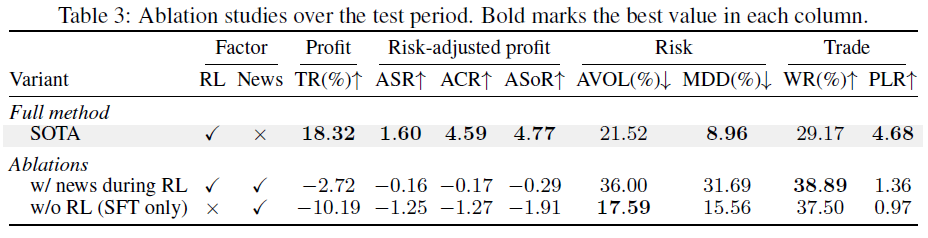
考察训练流程的两个组成部分:新闻在策略信息集中的作用,以及监督微调之后强化学习的贡献。
新闻在信息集中的作用
为减少时间与身份泄漏,作者对呈现给前沿教师的信息进行匿名化处理:遮蔽股票身份、绝对价格水平与日历时间,同时保留市场状态与同期可得的新闻。作者发现,纳入匿名化新闻能改善用于监督微调的前沿模型轨迹质量。在按年化夏普比率过滤轨迹后,附录 E.5 报告了按策略族统计的保留轨迹表现。
随后作者考察新闻在强化学习期间是否仍然有用。在固定监督检查点的条件下,比较在策略信息集中保留与不保留同期新闻的强化学习。不使用新闻训练的策略取得 18.32% 的总收益与 1.60 的夏普比率,最大回撤为 8.96%。而在强化学习期间保留新闻会使总收益降至 -2.72%,最大回撤升至 31.69%。
这些结果指向文本信息的不对称作用:新闻对构建前沿模型监督有用,但在策略优化期间保留它并不能改善样本外表现。
强化学习的作用
作者随后评估强化学习之前的监督策略。由于仅 SFT 策略与带新闻的 RL 策略使用相同信息集,二者的比较可分离出强化学习的贡献。强化学习将总收益从 -10.19% 提高到 -2.72%,夏普比率从 -1.25 改善到 -0.16,尽管波动率与最大回撤也有所上升。这表明在相同信息集下,强化学习改善了监督策略,而完整方法的表现还取决于在策略优化期间移除新闻。
总结
本文提出了 SOTA,一个用于结构化期权策略选择的语言模型后训练框架。通过将策略层推理与合约层实现分离,SOTA 允许学习到的策略在异质期权策略之间进行选择,同时由确定性求解器处理实现。在 10 个活跃交易的期权标的上,后训练策略相对于非 LLM 的策略选择基线与微调语言策略改善了样本外组合表现。作者还记录了文本信息的不对称作用:新闻改进前沿模型监督,但在强化学习期间保留新闻并不能改善样本外表现。更广泛地说,结果表明对构建专家监督有用的信息,在下游策略优化阶段未必同样有用。未来工作可将学习到的决策空间扩展到合约选择、头寸规模与动态对冲,并探索结构化市场信息与文本信息的其他表示形式。