Super-agent 设计探索:迈向更自主的 Agent 系统 Оригинал на китайском
两层、五个部件、四个特征,以及一个被忽略的事实:这套架构真正难的不是「更自主」,而是「可停止」。
10 月 31 日,DeepSeek Harness 团队发了一篇设计探索,标题很直白:《Super-agent 设计探索:迈向更自主的 Agent 系统》。
先把三件事说清楚:
- • 这不是 DeepSeek 发布的新模型;
- • 不是一个可以直接托管使用的产品;
- • 团队提到,部分设计已在一个叫
dsh-superagent-prototype的插件里实现,用来验证技术路线;他们把它定义为工程探索,不是生产系统。
但它把一个被行业含糊过去的问题说清楚了:当一个 Agent 要同时面对人、工具、事件和长时间运行,它不该继续是一个会话。
一个会话,意味着一个上下文、一条时间线、一个执行者、一个「对用户说话的人」。这四件事挤在一起,短任务没问题;一旦任务变成「持续几天、跨 IM 和 GitHub、随时被事件唤醒」,它就会同时撞上四堵墙。
DeepSeek 的解法不复杂,甚至有点像公司组织架构:Router 负责做人,Worker 负责做事,Trigger 决定什么时候上班,Watchdog 决定什么时候叫停。
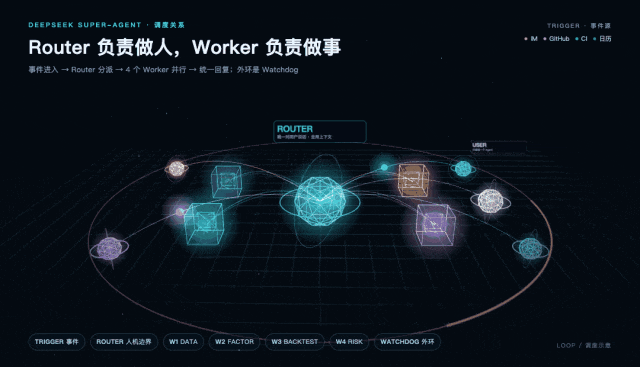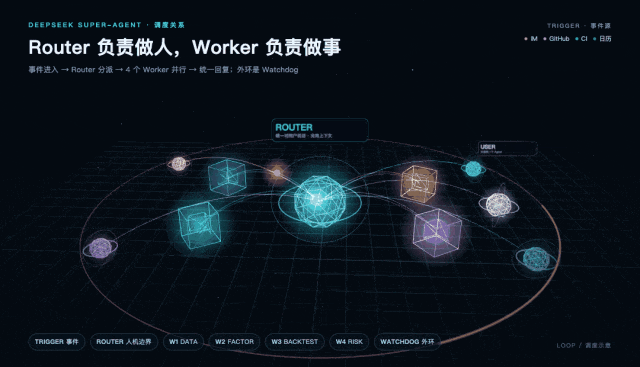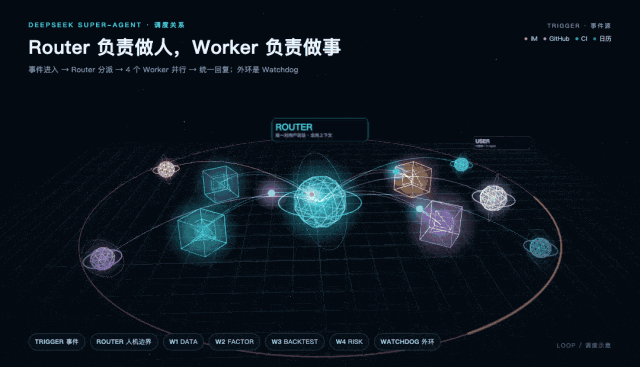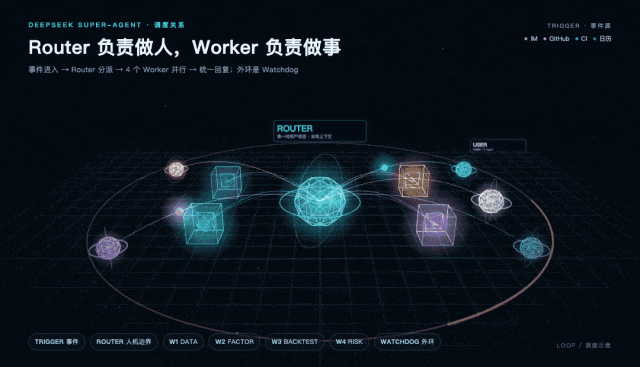
▲ 事件从四个入口进入 Router,再分发给四个 Worker;外环是 Watchdog。先看整体节奏,精确命名看下一张结构图。
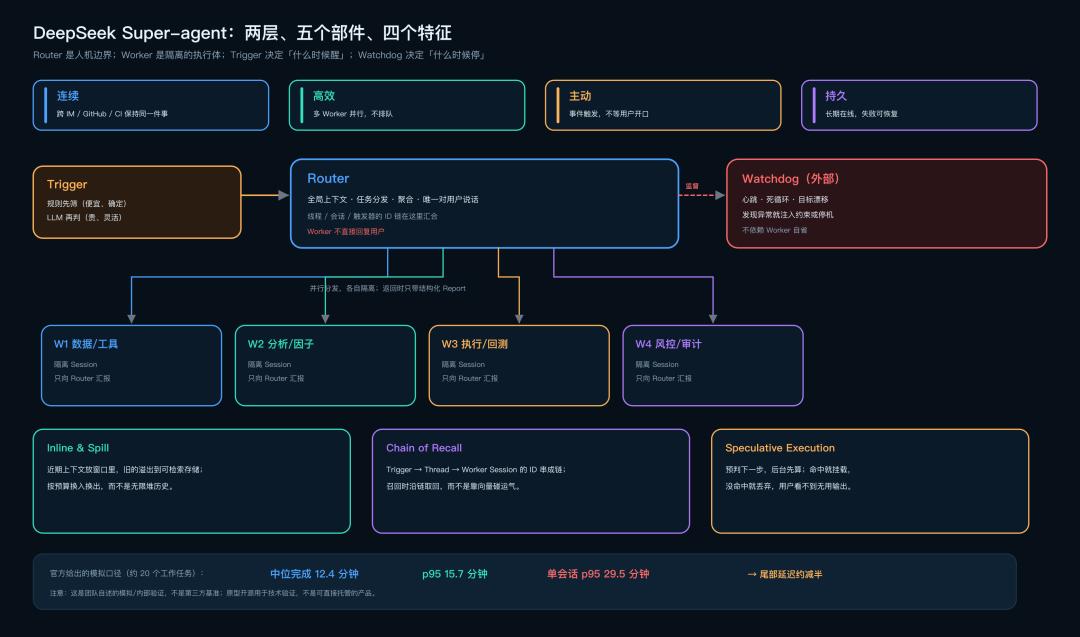
▲ 两层、五个部件、四个特征。Router 是人机边界;Worker 是隔离执行体;Trigger 决定「什么时候醒」;Watchdog 决定「什么时候停」。
先说结论
这套架构值得看的,不是「多 Agent」三个字,而是五个边界:
- 1. 人机边界:只有 Router 对用户说话,Worker 只向 Router 汇报。
- 2. 触发边界:事件先过规则,再过 LLM;规则负责「不漏」,LLM 负责「不烦」。
- 3. 生命周期边界:
start()和stop()都是正式接口;不能停的 Agent,不叫自主,叫失控。 - 4. 状态边界:计算无状态、状态进日志、环境进沙箱;Worker 可以死,任务不能丢。
- 5. 监督边界:Watchdog 在 Worker 之外,不依赖 Worker 自省。
对应五个部件:双层 Router/Worker、事件 Trigger、面向人的交互(全双工 + 多信道)、计算/状态/环境分离、外部 Watchdog。
四个特征是团队自己总结的:连续、高效、主动、持久。翻成大白话:
- • 连续:跨 IM、GitHub、CI,保持同一件事的上下文;
- • 高效:多个 Worker 并行,不排一条队;
- • 主动:事件来了就醒,不等用户开口;
- • 持久:长期在线,失败可恢复。
但注意:这四个词描述的是能力,不是质量。 一个系统可以同时做到连续、高效、主动、持久,却在做错事。真正的分水岭,是它能不能被停下、被审计、被追责。
一个 Agent 的四堵墙
第一堵:串行的墙
假设一个任务要调 8 个工具,每个 20 秒。串行执行是:
8 × 20s = 160s
用户等 2 分 40 秒。这还没算模型思考、重试、排队。
并行执行的理论下界是:
max(20s) + 协调开销
如果协调开销是 5 秒,就是 25 秒。差距不是 20%,是 6 倍。
但并行不是免费的:任务要能拆、Worker 要隔离、结果要能合并。很多 Agent 系统失败,不是模型不行,是任务根本拆不开——所有步骤都依赖上一步的输出,那只能串行。Super-agent 的 Router/Worker 结构,本质上是在任务可拆的前提下,把「串行等待」换成「并行 + 协调」。
第二堵:上下文的墙
假设 300 条消息,每条平均 500 token,就是 150k token。公开资料里,DeepSeek V3.2 是 128K 上下文,V4 做到了 1M。但 1M 也会满,而且上下文越长,注意力越稀。
更麻烦的是成本:每一轮 ReAct 都把历史重读一遍,token 账单随轮次线性增长。一个持续三天的任务,上下文不是「不够长」,是「长得没有结构」。
所以 Super-agent 不追求「一个无限长的会话」,而是把上下文拆成三件套:Inline & Spill、Chain of Recall、Speculative Execution。后面细讲。
第三堵:故障隔离的墙
单会话 Agent 最怕死循环。模型在一个工具上反复试,上下文越堆越长,最后要么超时,要么把错误结论交给用户。没有第二个执行体可以接管,也没有独立监督者能喊停。
多 Worker 的第一个好处不是快,是故障隔离:一个 Worker 卡住,其他 Worker 还能跑;Router 可以取消它,Watchdog 可以停它,任务不必陪葬。
第四堵:角色冲突的墙
一个 Agent 同时要:
- • 对用户礼貌、解释清楚;
- • 对工具果断、参数准确;
- • 对风险敏感、该拒绝就拒绝;
- • 对全局有记忆、知道三天前发生了什么。
这四个目标经常打架。对用户解释得越细,上下文越臃肿;对工具越果断,越容易越权;对风险越敏感,越容易什么都不做。
Router/Worker 的本质,是把「做人」和「做事」拆成两种角色。 做人要的是稳定、一致、可追责;做事要的是并行、隔离、可替换。
双层不是唯一解,但它把两种极端分开了
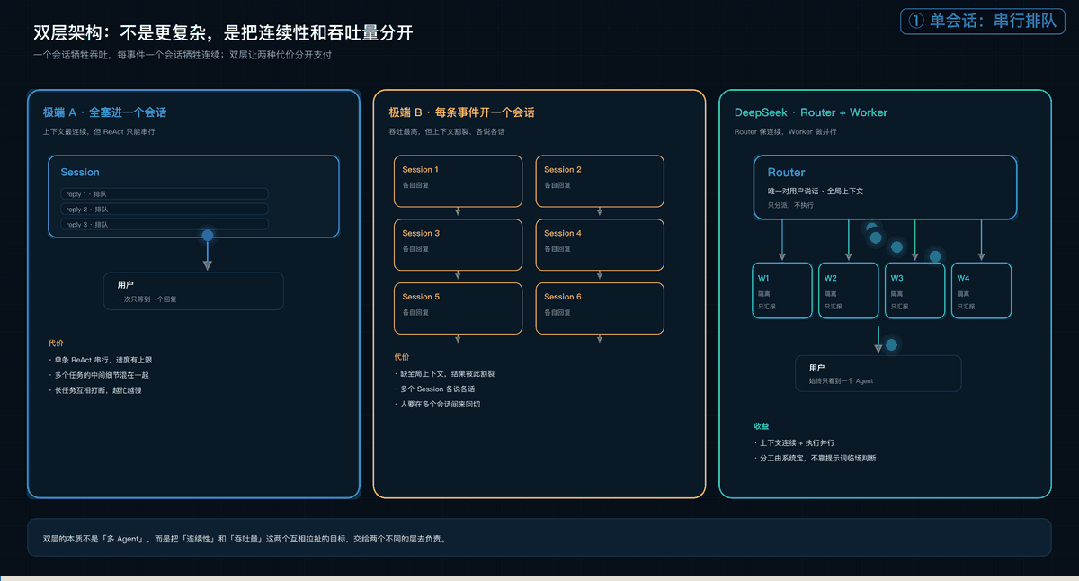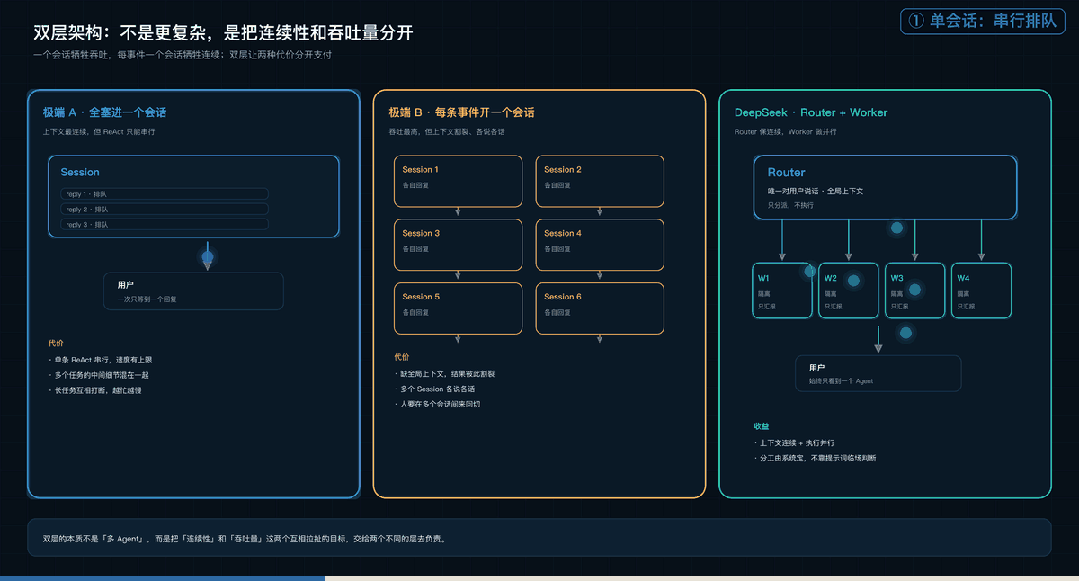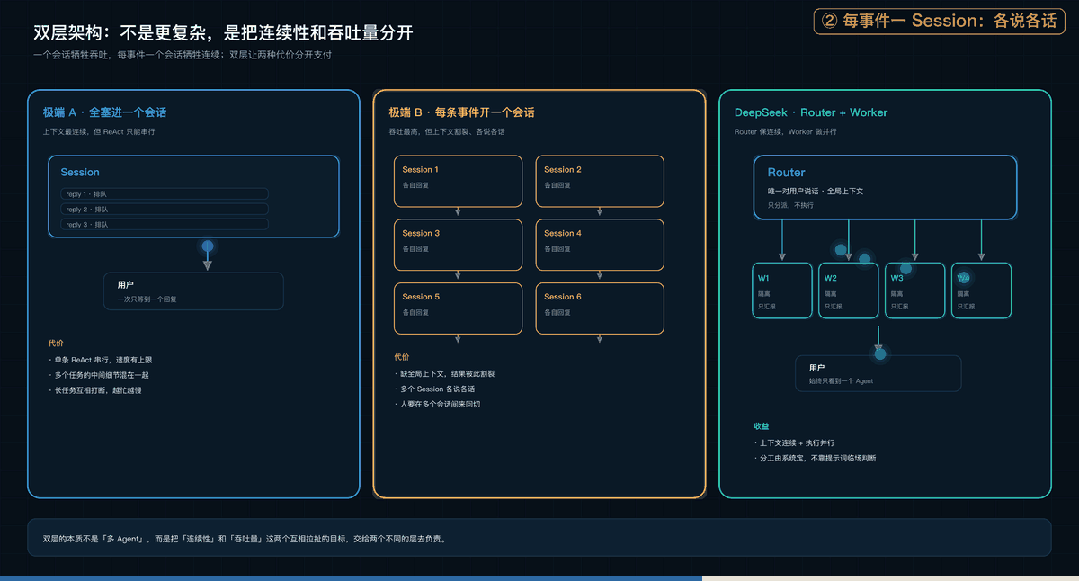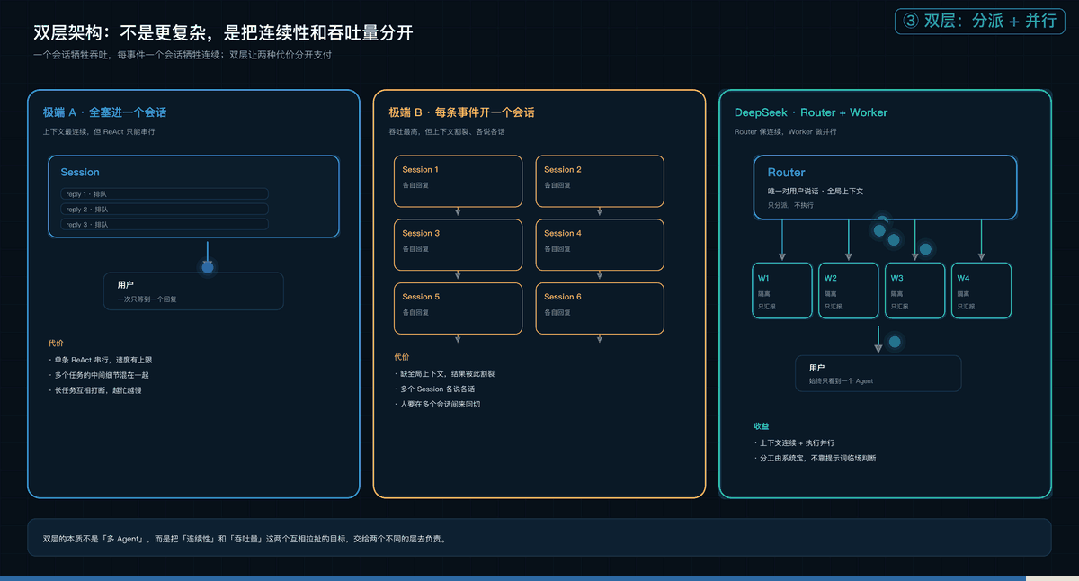
▲ 动图:三个面板依次高亮;左侧回复排队,右侧请求并行分发,最后汇到同一个用户出口。
单人 Agent 的设计空间,其实只有两个极端。
极端 A:所有事件都塞进一个 Session。 上下文最连续,用户感觉始终在跟同一个它说话;但一个 ReAct Loop 只能一步一步走,上一件事没做完,下一件进不来。任务一多,中间细节互相污染,越忙越慢。
极端 B:每来一条事件就新开一个 Session。 并发吞吐最高,每件事各干各的;但任务之间往往不完全独立,缺了全局上下文,结果彼此割裂。更糟的是,好几个 Session 各自回复用户,交互会变成一团乱麻。
DeepSeek 的选择是把两层分开:
- • Router 层常驻,统一接住人的交互,维护全局连续性、做分派和汇总;
- • Worker 层每个上下文隔离,挂着完整工具,并发执行具体任务;
- • 人只跟 Router 说话,Worker 只向 Router 汇报。
这听起来像常见的 Agent Team,但有一个关键区别:中心节点管到多细。
Agent Team 的 Team Lead 通常要拆一个复杂任务、规划子步骤、盯着成员细节,自己背着很重的推理负担;Super-agent 的 Router 只处理任务与任务之间的高层关联,单个任务内部怎么拆,交给 Worker。分工的粒度不同,Router 才可以做得轻。
DeepSeek 的实践经验是:Router 的活常常没想象中复杂,用轻量模型往往就能兼顾速度和效果,甚至可以连 Bash 工具都省掉;Worker 通常才需要最强模型和全套工具。
还有两个容易被忽略的细节:
- • “双层”是逻辑分工,不是物理限制。 Router 内部也可以由多个 Session 组成,有些逻辑甚至用普通代码写;DeepSeek 选了最直接的做法——一个常驻 LLM Session 当 Router 核心。
- • Worker 内部还可以再开 Subagent,甚至本身就是一个 Agent Team。 这些对 Router 透明;Router 只看任务边界,不关心 Worker 里面怎么组织。
所以双层不是“多 Agent”的同义词,而是一种边界设计:连续性归 Router,吞吐量归 Worker。两边各自优化,不互相拖累。
Router 负责做人
再看 2D 调度动图。它把一次完整调度压成 4 个阶段,循环播放。
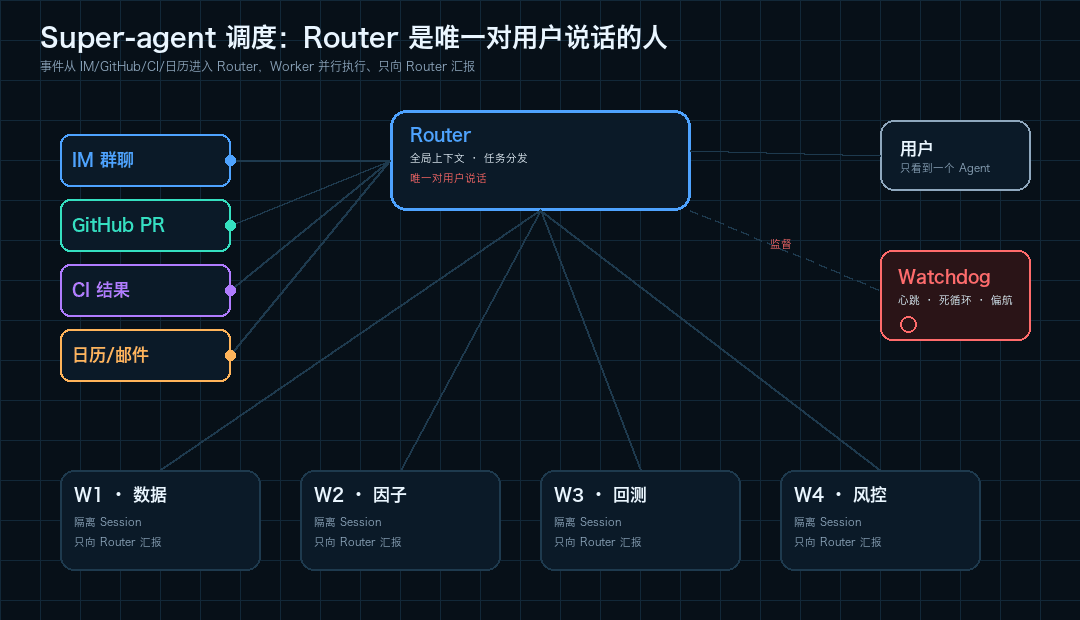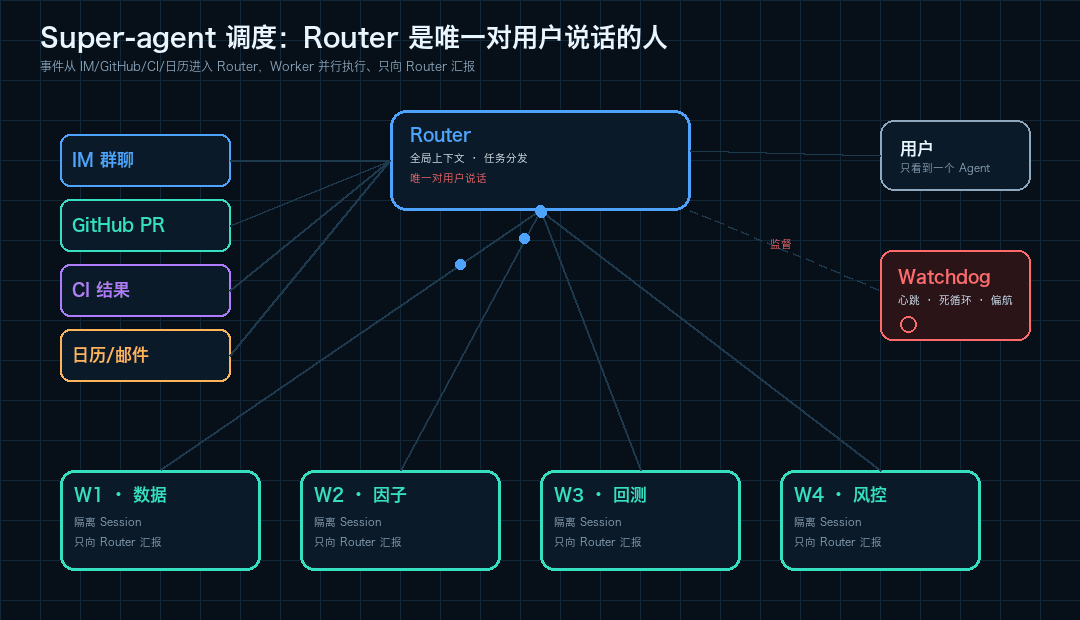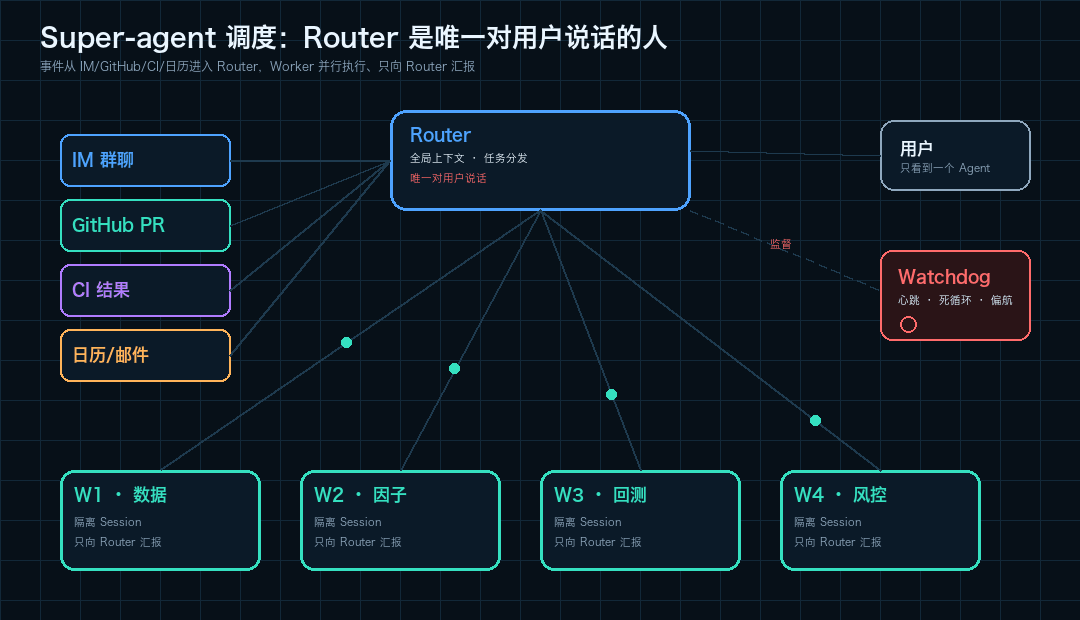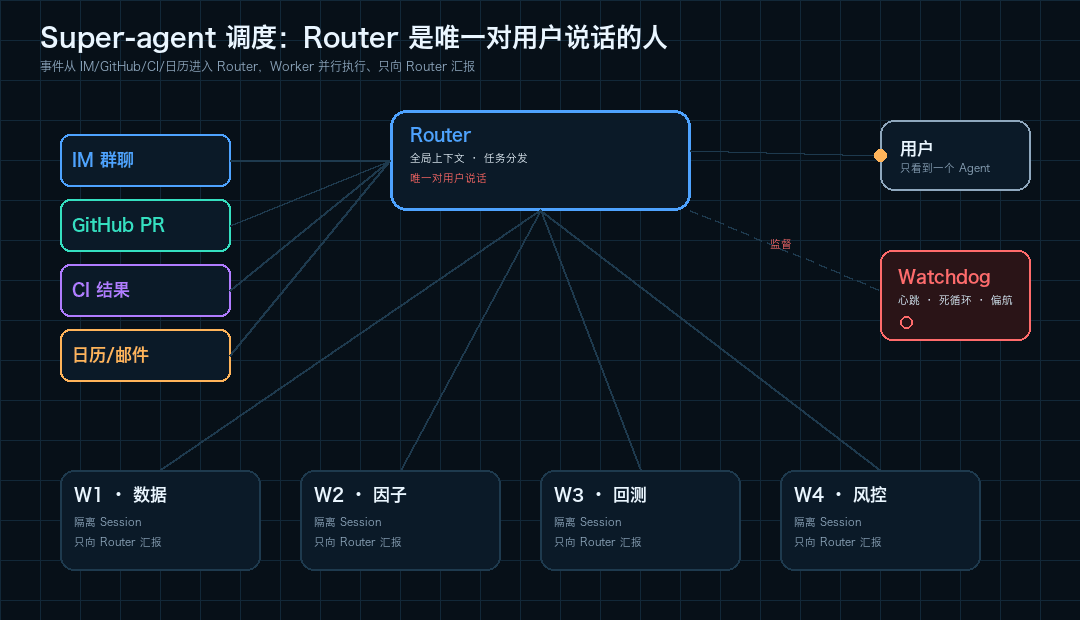
▲ 四个阶段:事件汇入 Router → Router 并行分发 → Worker 回报 → Router 统一回复。右侧的 Watchdog 持续心跳。
第一段:四个来源同时进来。 IM 群聊、GitHub PR、CI 结果、日历/邮件。它们不直接找 Worker,而是先到 Router。Router 在这一步只做三件事:识别事件、挂到正确的 Thread、决定要不要叫醒 Worker。
第二段:Router 分发。 四个 Worker 同时启动,各自在隔离 Session 里跑。注意图里 Worker 卡片写的是「只向 Router 汇报」——它们没有直接回复用户的通道。
第三段:Worker 回报。 每个 Worker 交回结构化 Report,而不是一段自由文本。Router 负责合并、去重、判断冲突。
第四段:Router 统一回复。 用户只看到一个 Agent、一个口径、一个责任人。
这张图里最容易被忽略的是右侧的 Watchdog。它不在主链路上,但它一直在数心跳。主链路越自主,旁路的监督越重要。
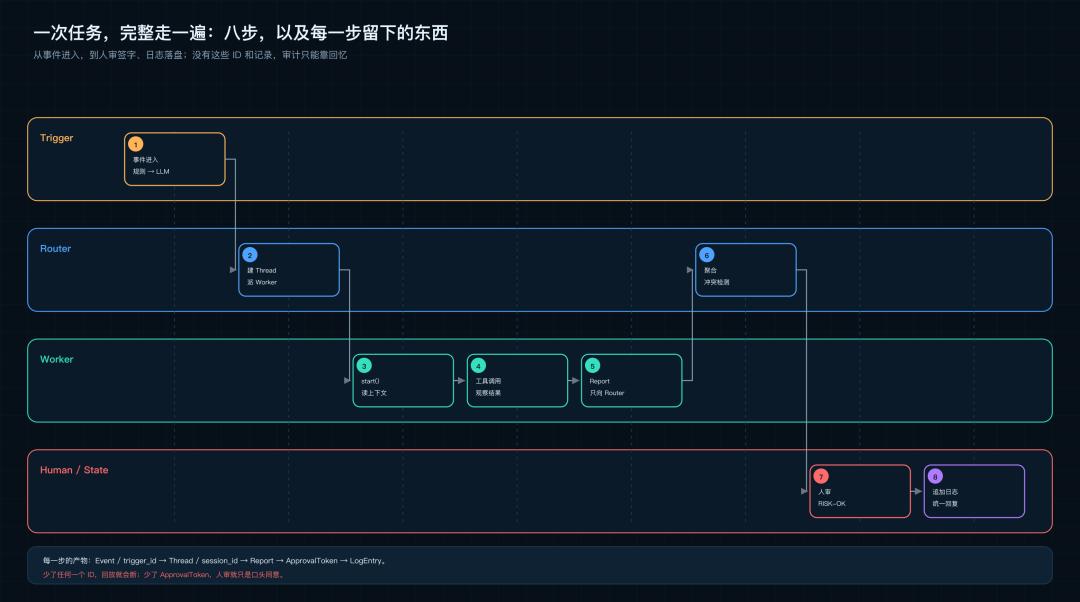
▲ 一次任务的八步:Event → Router 建 Thread/派 Worker → Worker start/读上下文/工具/Report → Router 聚合 → 人审 → 日志。每一步都留下一个 ID 或记录。
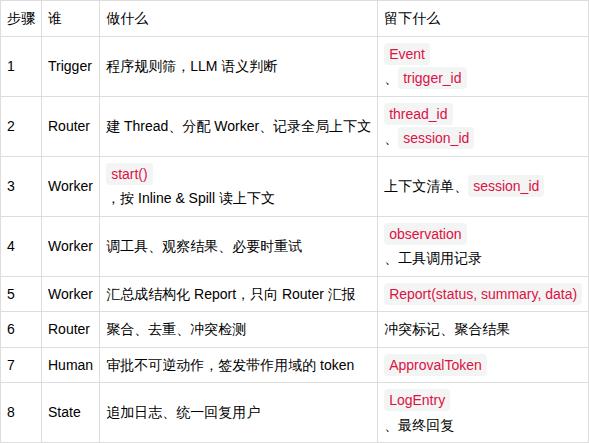
把镜头拉近,一次任务其实有八步;这张图也是后面几节的索引。注意第 4、5 步:工具调用的观察结果不会直接变成用户回复,它先变成 Worker 的 Report;第 7 步的人审 token 也不是装饰,它是“提案”变成“动作”的分界线。
为什么不让 Worker 直接回复用户
三个理由,一个比一个现实:
第一,口径。 四个 Worker 各自回复,用户会收到四套说法。谁对?谁负责?Router 是唯一的「出口」,也是唯一的「责任人」。
第二,安全。 Worker 手里有工具,可能被网页、邮件、PR 描述里的 prompt injection 操纵。如果它能直接对用户说话,攻击者就多了一条外泄通道。Router 是最后一道话语过滤——但它不是安全边界,真正的隔离要靠沙箱、最小权限和工具白名单。
第三,聚合。 用户要的不是四份报告,是一个结论。Router 知道全局上下文、风险限额、用户偏好;Worker 只知道自己的任务。结论必须由掌握全局的人下。
一个例外:订阅直通
Worker 可以订阅某个 Thread,后续事件绕过 Router 直达。这不是脱离监管:订阅关系仍登记在 Router 的 Thread 注册表里,Worker 也只向 Router 汇报。直通的是事件,不是话语权。 具体机制在 Trigger 一节展开。
一个 Router 会话,为什么没被消息压垮
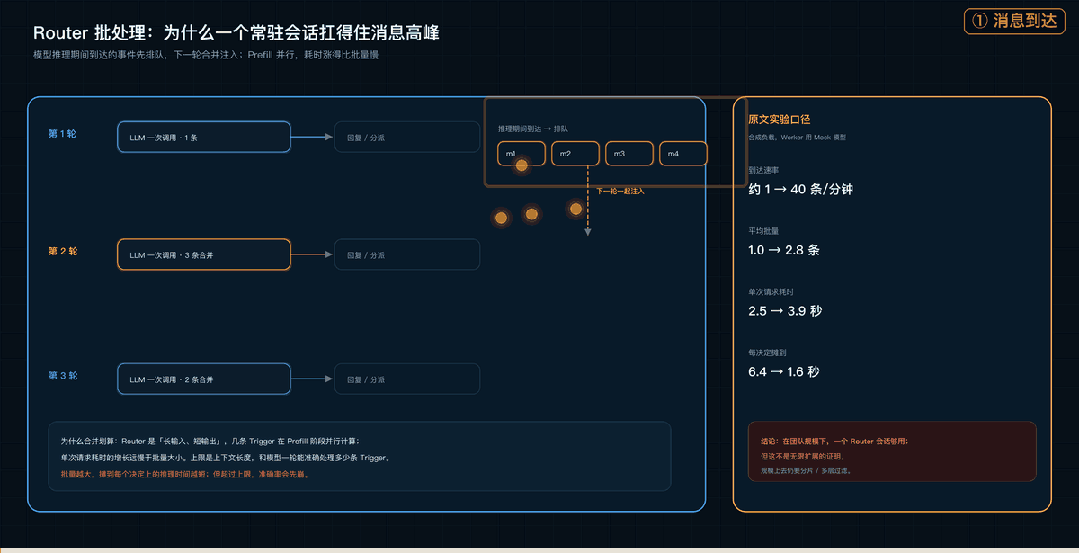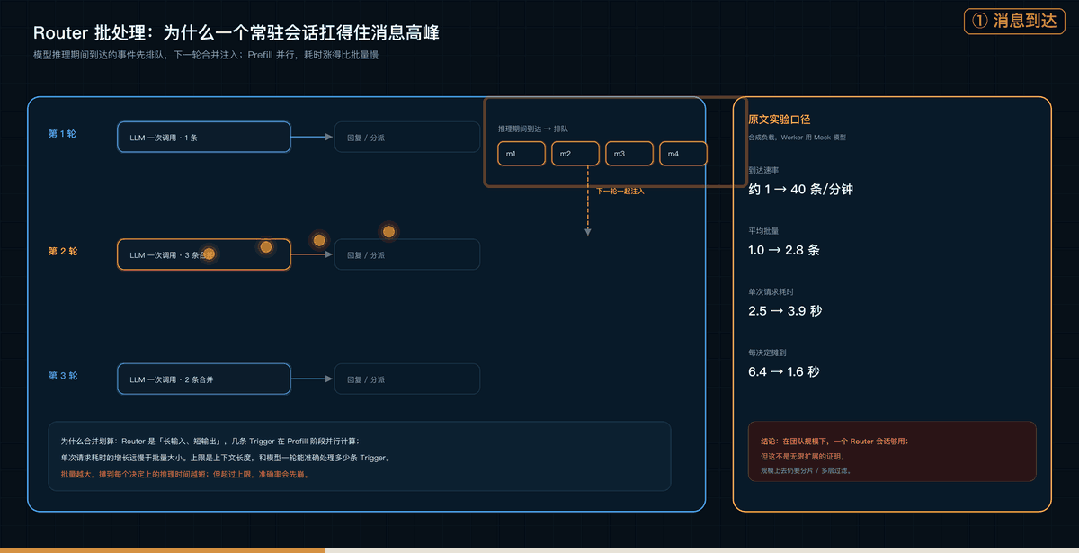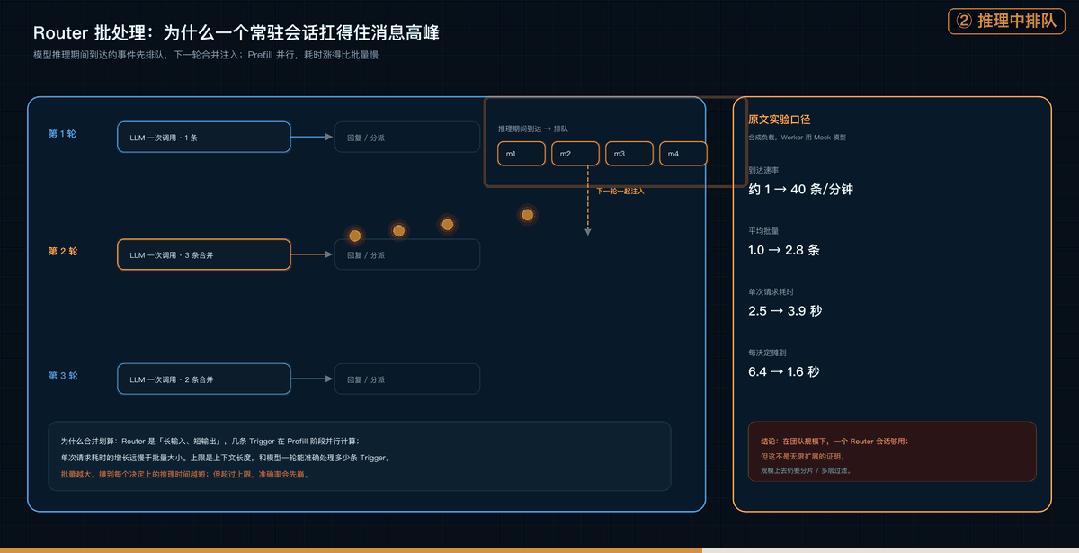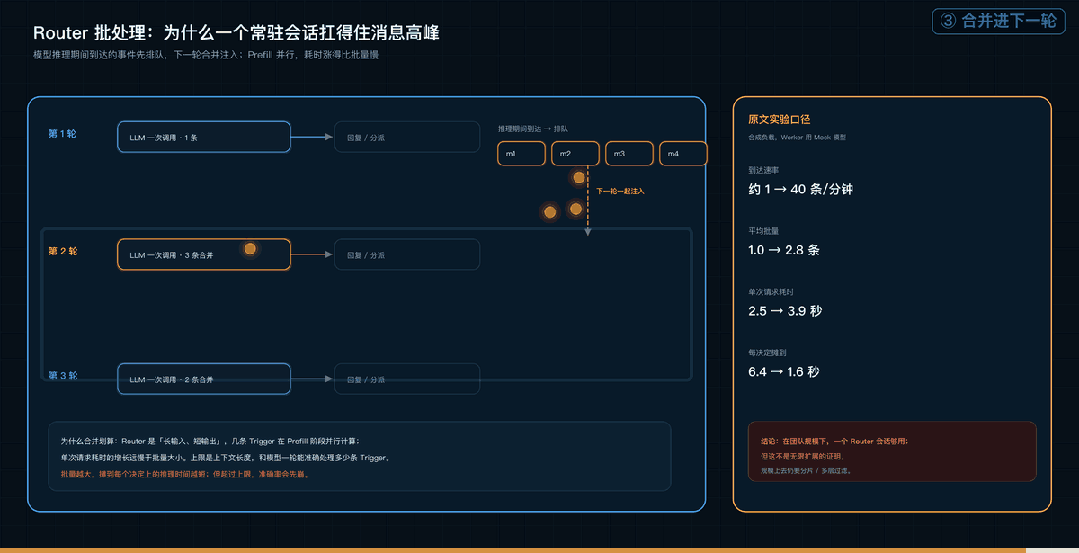
▲ 动图:m1–m4 先排队,再一起汇入第 2 轮批次;批量越大,摊到每个决定上的时间越短。
直觉上,一个常驻 Session 会被消息高峰压垮。DeepSeek 的实测给出了相反的结果,关键在批处理。
Router 只做轻量交互和分派,每一步通常是长输入、短输出。上一轮推理还在跑的时候,新到的 Trigger 先攒着;下一轮 LLM 调用时一起注入。几条 Trigger 在 Prefill 阶段并行计算,单次请求的耗时增长,远慢于批量大小的增长。
公开拆解记录的 Router 压测里,到达速率从每分钟约 1 条加到约 40 条:
- • 平均每批从 1.0 条涨到 2.8 条;
- • 单次请求耗时只从 2.5 秒涨到 3.9 秒;
- • 摊到每个决定上的推理时间,从 6.4 秒降到 1.6 秒。
也就是说,在一定范围内,越忙,单个决定反而越便宜。这是批处理带来的摊薄效应,不是模型变快了。
但上限有两个:上下文长度,以及模型一轮里能准确处理多少条 Trigger。超过上限,吞吐不会继续涨,准确率会先崩。所以“一个 Router 够用”是有适用范围的:团队当前规模下够用,不代表组织规模扩大后还够用。规模再往上,Router 层要做的不是“换个更大的模型”,而是多层过滤或水平切分;一切分片,连续性和吞吐量的权衡又会回来。
Trigger 决定什么时候醒
Super-agent 的「主动」,不是让模型每隔几秒问一句「有事吗」,而是事件驱动。
事件源可以很杂:聊天消息、邮件、日历、代码评审、CI 失败、监控告警、订单回报、行情跳空。每个事件先过一个程序规则,再过一个 LLM 判断。
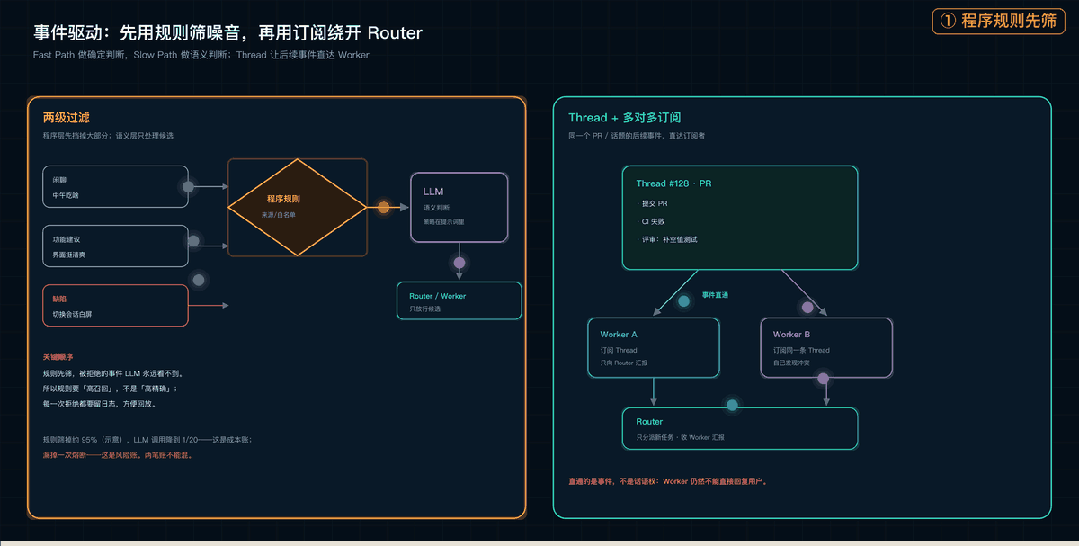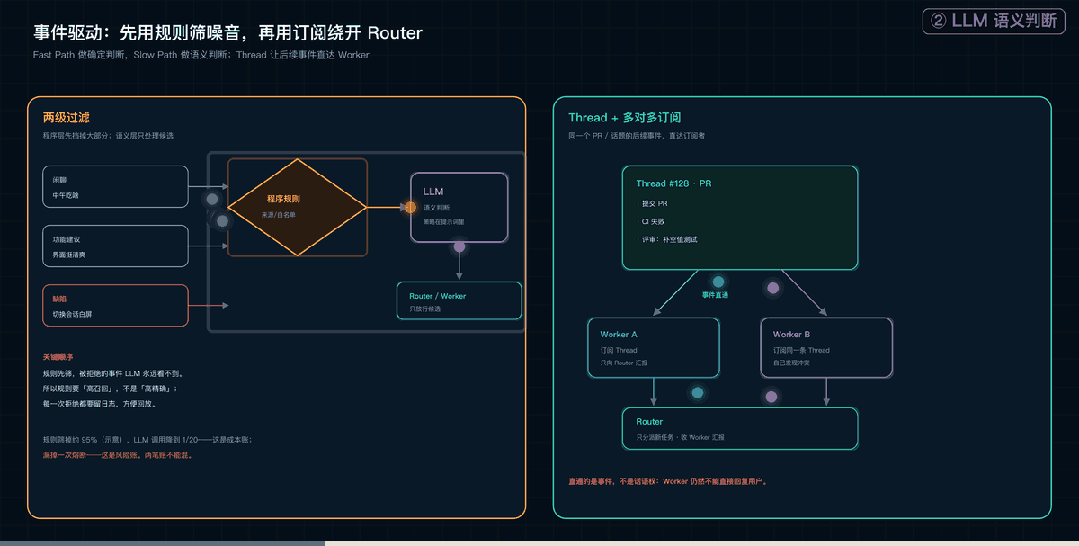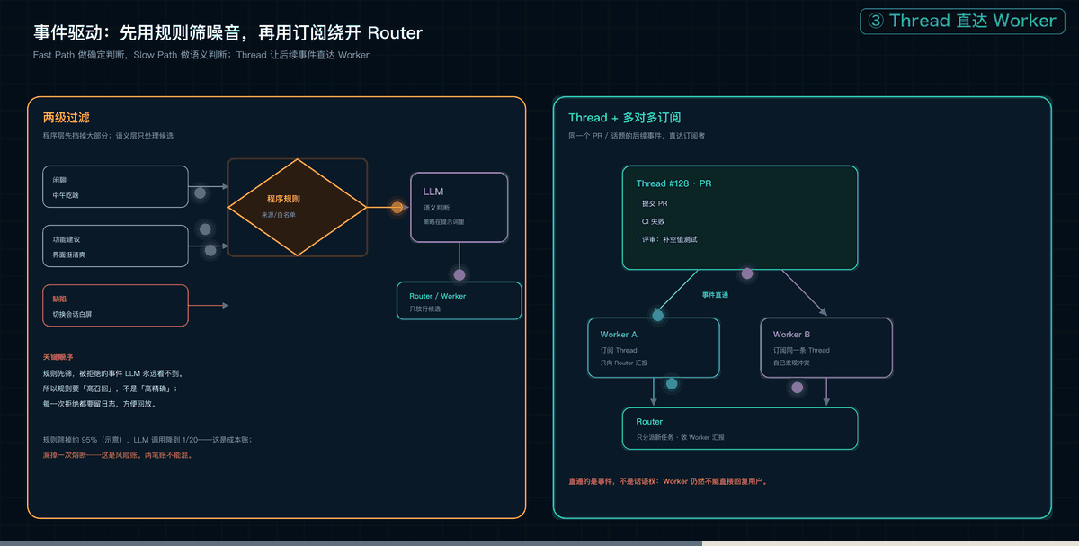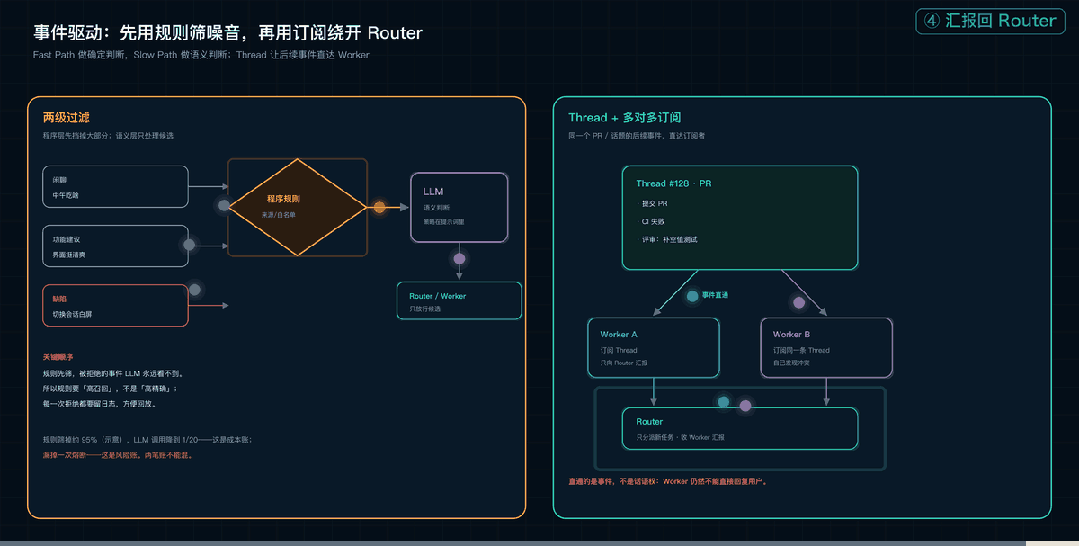
▲ 动图:事件点先穿过程序规则和 LLM;右侧 Thread 的后续事件跳过 Router,直接落到订阅它的 Worker。
DeepSeek 借的是 Fast Path / Slow Path 的思路:
程序层(Fast Path):按事件来源、群组范围、用户或机器人白名单这些确定条件,直接用代码做准入检查。给不同来源分别设成「只响应明确请求」「作为候选事件」或「直接忽略」,在调模型之前就筛掉大部分无关消息。
语义层(Slow Path):过了程序层的候选事件,交给 LLM,按提示词里的策略和上下文判断要不要行动。语义层同时是给人用的自然语言扩展点:想开关某条策略、加一条新策略,改提示词就行。
顺序很重要,因为被规则拒绝的事件,LLM 永远看不到。所以规则的目标不是精确,而是高召回——宁可多放进来一些,让 LLM 去否,也不要把可能重要的事件静默丢掉。
成本和风险要分开算:
- • 成本账:一天 1000 个事件,规则筛掉约 95%,LLM 只剩 50 次判断,调用量降到 1/20。
- • 风险账:规则太紧,漏掉一次熔断,损失不是 token 能衡量的。
一句话:规则决定召回率的上限,LLM 决定精确率能拉多高。 对量化场景,你可以接受 LLM 误判 50 次,但不能接受规则漏掉一次风控事件;所以规则要写得「宽」,并且每一次拒绝都要留日志,方便事后回放。
订阅直通:省的是 Router,不是端到端
实际工作里,同一个 GitHub PR、同一个群聊话题、同一串往来邮件下的连续事件,构成一条Thread。
Router 根据某个 Thread 的第一条事件开出一个 Worker 之后,这个 Worker 会直接订阅这条 Thread。事件路由从此分成两条:
- • 已订阅(Fast Path):同一个 Thread 里的后续事件,由程序直接送到订阅它的 Worker;如果新事件超出当前任务范围,Worker 可以退订,或者交回 Router 重新分派。
- • 未订阅(Slow Path):Router 仍然能看到所有事件,掌握全局状态,但只负责判断、分派还没人订阅的新事件。
订阅是多对多的:一个 Worker 可以订好几条相关 Thread,一条 Thread 也可以被好几个 Worker 订阅。几个 Worker 在同一个 PR 里碰上时,Thread 的新事件会同时送到所有订阅者手里,它们各自就能看到对方做了什么,自己解决冲突;少数需要跨任务协同的,由 Router 中转。
这里有一个容易被忽略的结论:直通优化的是 Router 的成本,不是端到端延迟。
同一组实验里,把直通去掉后:
- • 任务完成时间基本不变:P50 从 12.4 到 12.6 分钟,P95 从 15.7 到 15.5 分钟;
- • Router 要做的决定多了约 30%;
- • 单次实验读缓存 token 从 2323 万涨到 3177 万,多了约 37%。
所以直通的价值,是在消息高峰时把 Router 从「每条后续消息都要看一眼」里解放出来,让它专心处理新任务和跨任务协调。它不是让任务跑得更快,而是让系统在同样的 Router 容量下扛更多事。
触发器不是定时任务
Cron 是「到点就看一眼」,Trigger 是「有事才醒」。前者会产生大量空转,后者要求事件源可靠。
真实系统通常是混合的:
- • 行情、订单、CI:事件推送;
- • 邮件、日历、公告:轮询 + 变更检测;
- • 长任务:心跳 + 超时。
Trigger 的工程难点不在「接事件」,在去重、乱序、迟到和风暴。同一件事被三个源同时报告,Router 要能合并;事件晚到 10 分钟,Worker 要能判断它是否还有效;一次故障产生 10 万条告警,Trigger 要能限流。
这些问题,比「让 LLM 判断要不要处理」难得多。
同一个骨架,换事件源就是另一个应用
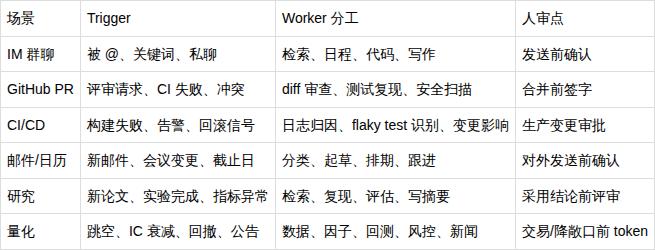
骨架一样,变的是三件事:事件源、Worker 的工具集、人审的权限边界。 不要为每个场景重写一套 Agent;先问这三个问题,再决定要不要加 Worker。
异步 ReAct:start 和 stop 都是动词
传统 ReAct 是同步的:用户提问 → 模型思考 → 调工具 → 观察 → 再思考 → 回复。用户一直等着。
Super-agent 把它改成面向人的异步循环:
class Worker:
    async def start(self, event):
        ...

    async def stop(self):
        ...
start() 之后,Worker 在后台跑;人可以继续做别的事。stop() 是正式接口,不是 kill -9。
团队说得很清楚:这个异步 ReAct 循环已经在 DeepSeek Harness 里实现,但不是默认开启。这是一个很诚实的限定——能力有了,产品化还没到。
为什么 stop() 重要?因为「自主」的反面不是「不自主」,是「停不下来」。
一个能跑三天的 Agent,如果只能等它自己结束,那它不是员工,是事故。停止可以来自三个地方:
- • 人:用户说「别查了」;
- • Router:任务目标变了,或者另一个 Worker 已经给出结论;
- • Watchdog:检测到死循环、超时、目标漂移。
三个来源,三种权限。人的停止优先级最高,Watchdog 的停止要留证据,Router 的停止要通知相关 Worker。停止不是异常处理,是正常控制流。
全双工:等工具的时候,还能接着聊
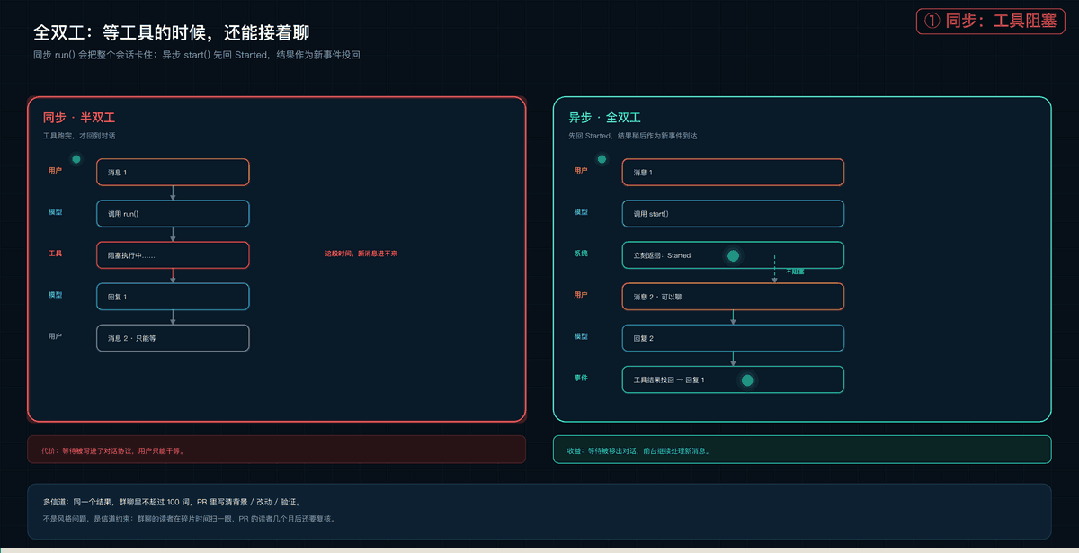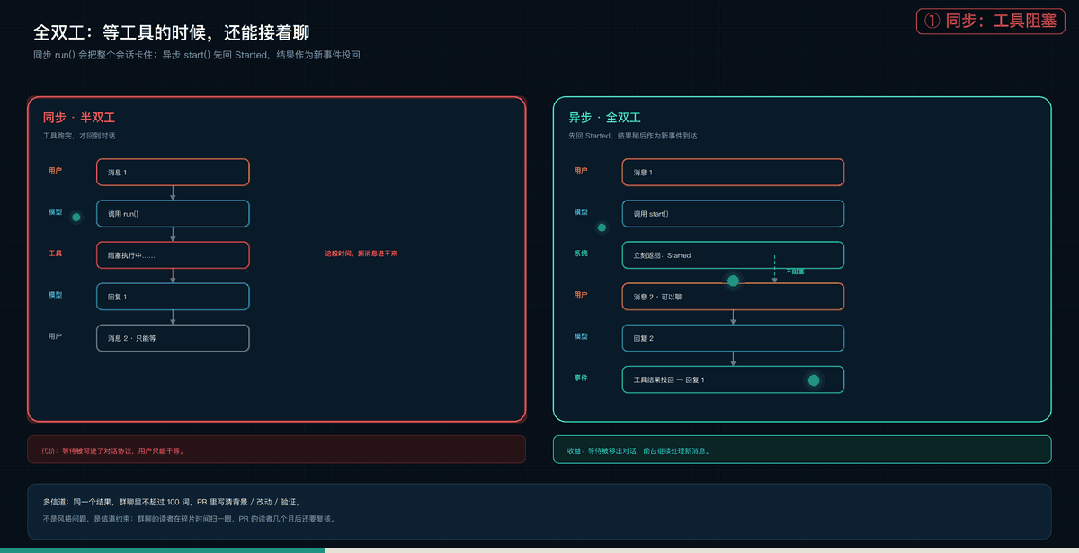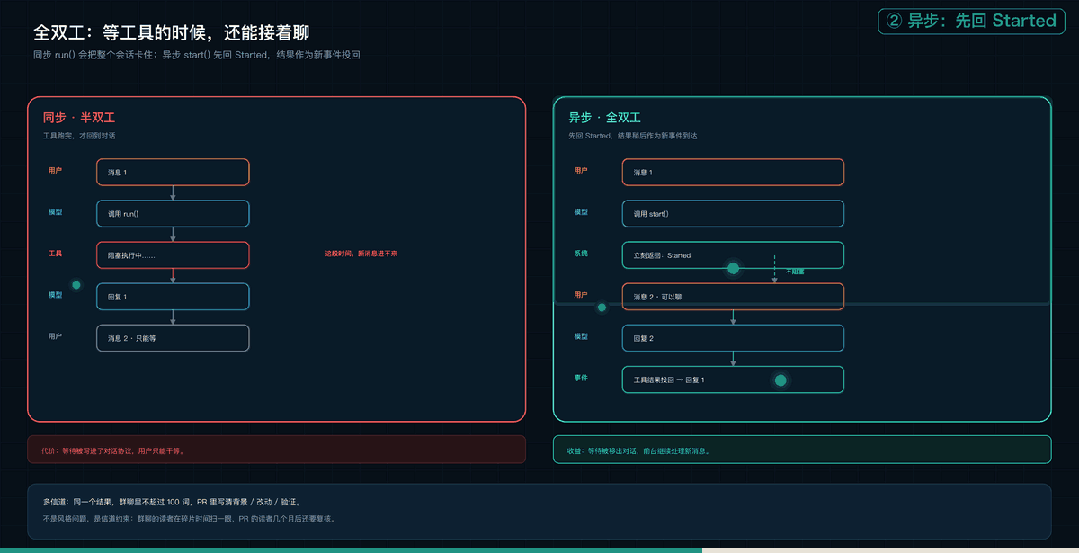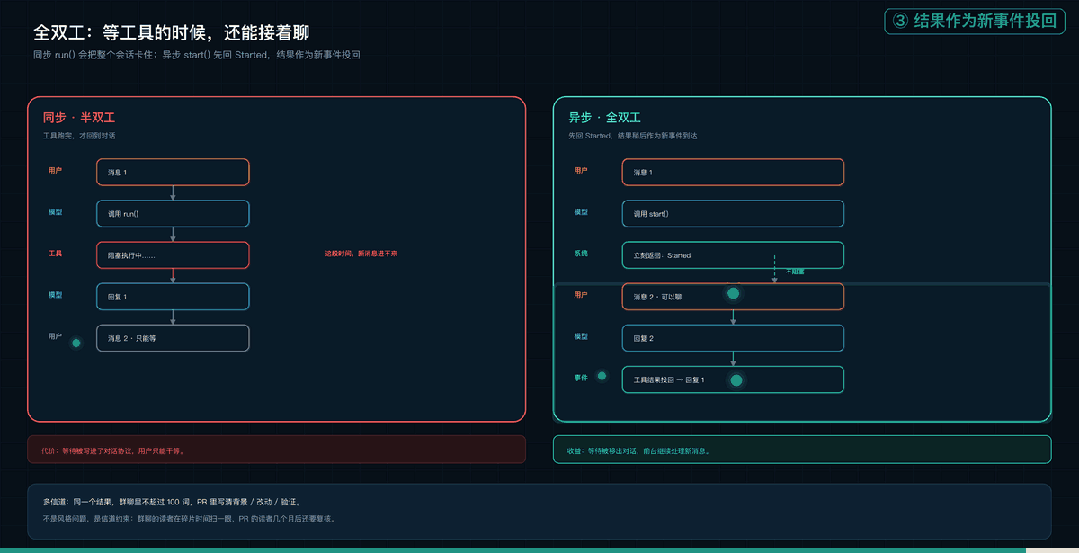
▲ 动图:左右两条时间线同步推进;左边卡在工具阻塞,右边在工具未完成时已经回复了消息 2。
把 ReAct 从半双工改成全双工,时序是这样的:
- 1. 用户发消息 1,模型决定调用一个耗时工具;
- 2. 模型调
start(),立刻收到「已启动(Started)」,循环继续往下走; - 3. 后台工具在跑,用户发来消息 2,模型可以先回消息 2;
- 4. 工具跑完,结果作为一条新的事件消息投回会话,模型再回复消息 1。
前台对话和后台任务就此解耦。模型也可以根据上下文调 stop(),主动终止跑得太久的后台命令。
这套异步任务机制,DeepSeek Harness 里已经实现,只是还没默认开启。能力有了,产品化还没到——这句话很重要,后面冷水还会提。
多信道:同一个结果,群里和 PR 里不能一个写法
不同工作信道的信息密度和交互习惯不一样。把给单人终端设计的交互方式原样搬进群聊,冗长的推理、密集的工具调用一股脑往外倒,多人协作的群很快就信息过载。
DeepSeek 的做法是用提示词给不同信道定制交互规范:
- • 群聊这类即时通讯信道:少打扰、轻量沟通。只在需要决策或验收时发通知,只问直接的问题,只给简短的结论。他们验证过一条简单有效的硬规定:单次回复不超过 100 词。
- • GitHub、邮件、文档这类异步信道:结构化、高信息密度的交付。创建或更新 PR 时,按项目规范写清问题背景、改动说明和验证结果。
同一个结果,群里可能只有三行,PR 里要写完整的前因后果。这不是“风格问题”,是信道约束:群聊的读者在碎片时间里扫一眼,PR 的读者要在几个月后复核。
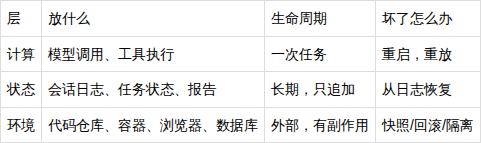
计算、状态、环境三分
这是整篇设计里最「工程」、也最容易被忽略的一部分。
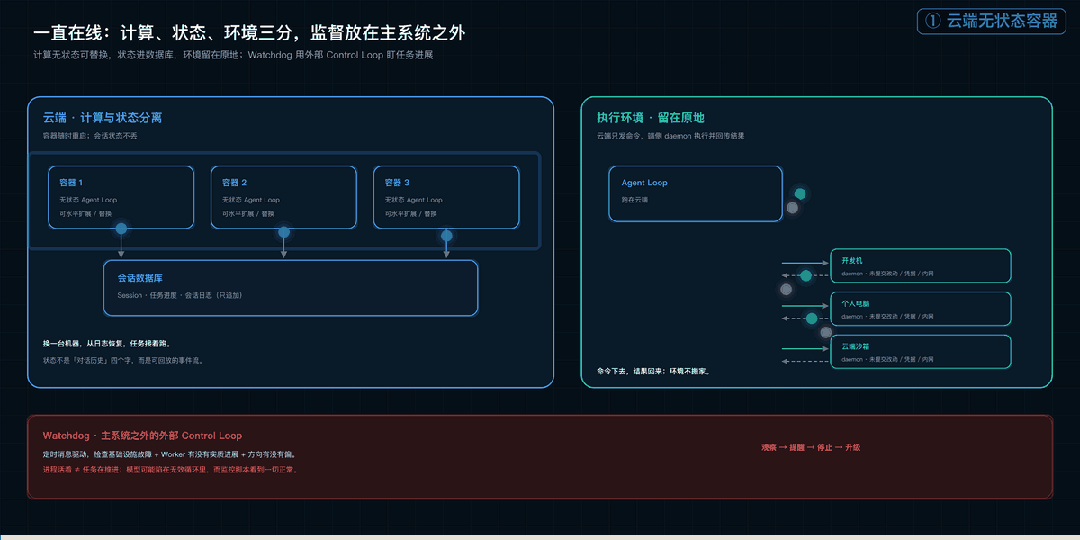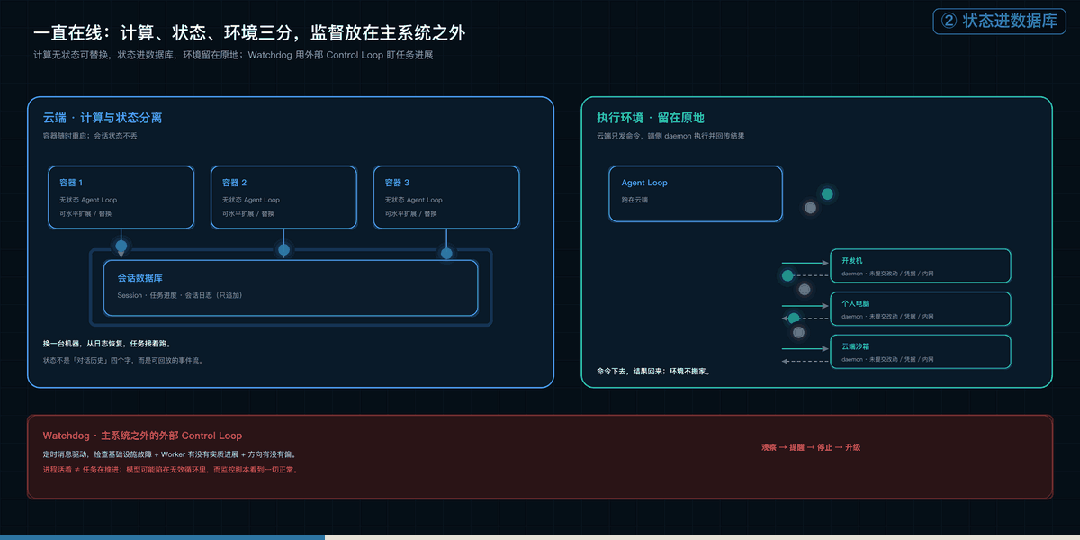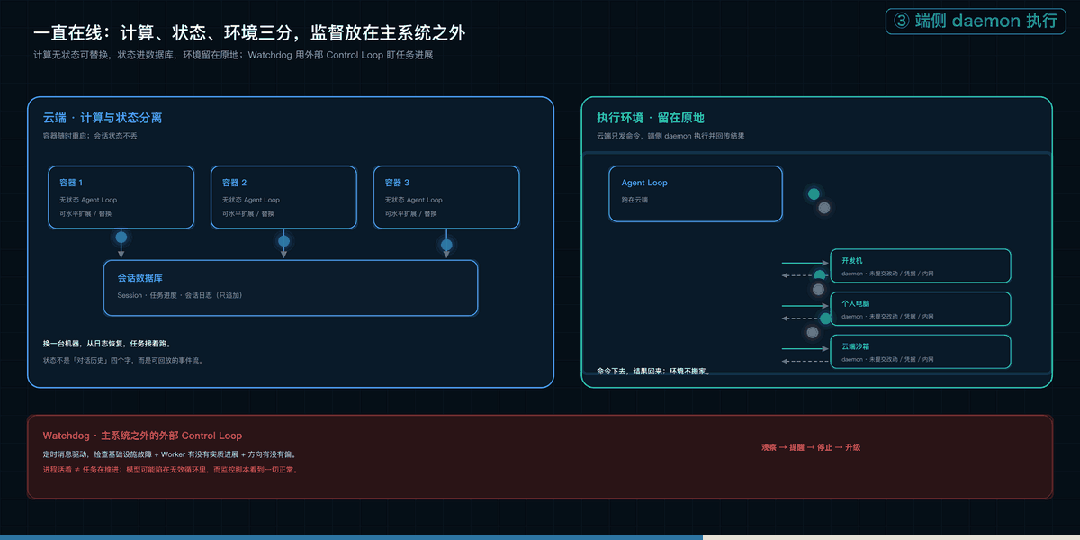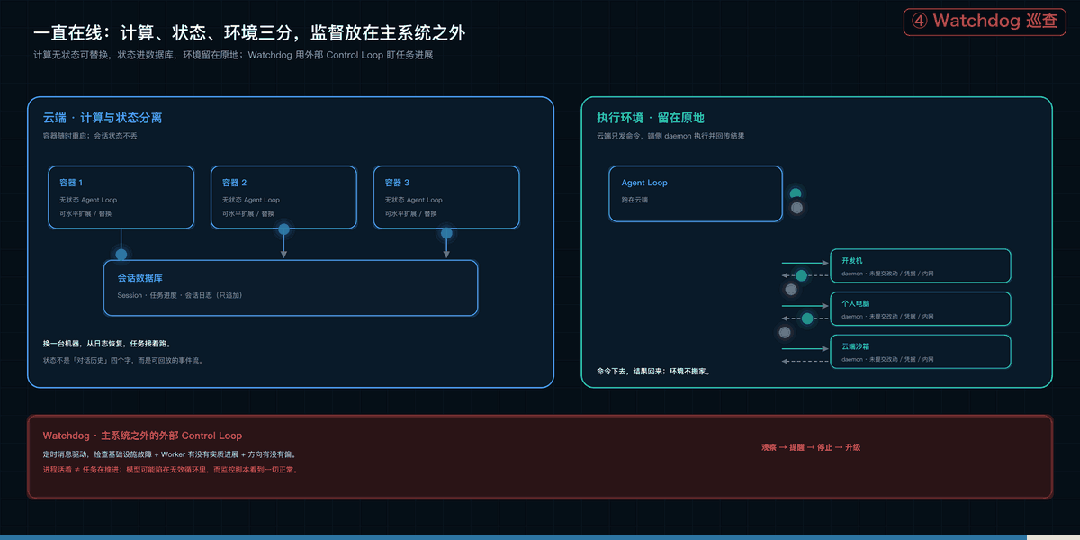
▲ 动图:命令从云端容器流向端侧 daemon,结果再回流;Watchdog 在下方独立扫描,不跟主循环共命运。
计算无状态:Worker 不把「我是谁、我做到哪了」放在内存里。它随时可以被替换。
状态进日志:所有事件、决策、工具结果,追加到会话日志。只追加,不改写。这样能回放、能审计、能在另一个 Worker 上恢复。
环境进沙箱:代码仓库、容器、浏览器是外部资源,有副作用。Worker 不能随便 git push、不能直接下单、不能改生产数据库。环境要隔离,操作要幂等,关键动作要人审。
落到实现上,DeepSeek 分两步解开本地绑定:
第一步,计算与状态分开。 推进 Agent Loop 的计算做成无状态,放进云端弹性容器;Session、任务进度、会话记录存进数据库。容器可以水平扩展、随时重启或替换,会话的连续性由持久化存储兜着。跑 Agent 的机器坏了,换一台就能接着跑。
第二步,计算与执行环境分开。 模型干活需要的上下文,很大一部分要从代码仓库、本地文件、依赖服务里取。真实工作环境里往往有没提交的本地修改、私有凭据、内网服务、特定硬件和工具链——把这些同步到云端,成本高,还容易漏。
所以 DeepSeek 让执行环境留在原地:Agent Loop 在云端跑,端侧只部署一个轻量 daemon,负责执行命令、返回结果。这套设计既支持 BYOM(Bring Your Own Machine,把日常开发机接给云端 Agent),也支持云端托管机器、按需创建的计算环境。一个 Agent 可以在不同执行设备之间切换;某台个人电脑重新上线后,云端还能自动触发,把等它的任务派过去。
代价是安全边界变大了:云端 Agent Loop 一直在接外部事件,端侧又放着私有代码和本地凭据。云端一旦被入侵或提示词注入攻破,连着的所有端侧设备都有风险。所以生产系统还要加一层:凭据不进模型上下文,由独立的 credential broker 按最小权限签发短期凭证;端侧 daemon 只执行白名单命令;不可逆动作双重确认。
这套思路不新,事件溯源(Event Sourcing)和 Actor 模型都讲过。但把它落到 Agent 上,解决了一个真实问题:Agent 会犯错,而且经常犯「不可逆」的错。
计算错了,重跑;状态错了,回放;环境错了,可能是真金白银。所以三层的防护等级要不一样。
一个反例:很多 Agent 框架把「对话历史」当状态,把「工具调用」当计算,把「文件系统」当环境,三者混在一个进程里。进程一崩,历史没了,文件改了一半,任务无法恢复。Super-agent 的三分法,本质上是把「可恢复性」设计进去。
Watchdog:外部监督
Watchdog 不在主链路上,但它决定系统能不能长期运行。
它看三件事:
- 1. 心跳:Worker 还活着吗?最后一次工具调用是多久前?
- 2. 死循环:是不是在重复同一个动作?比如
search → read → search → read。 - 3. 目标漂移:它还在解决原来的问题吗?还是跑去做一件更简单、更容易交差的事?
干预分四级:
- • 观察:记录,不打断;
- • 提醒:给 Worker 注入一条约束(「你已经在重复,换个工具或停止」);
- • 停止:取消当前 Worker,保留日志;
- • 升级:交给 Router 或人。
我们的最小实现里,Watchdog 抓到了一次典型的 2-cycle 循环:
[W-news] step 3/4 search_news -> 3 headlines, same source
[WATCHDOG] loop pattern ['search_news', 'read_news', 'search_news', 'read_news'] -> intervene
[W-news] constraint injected: loop detected; change tool or stop
[W-news] stop after watchdog intervention, report partial注意最后一句:report partial。停止不是把结果全丢掉,而是把已经得到的部分交回去。这很重要——长任务被停时,前面的工作不能白做。
为什么 Watchdog 必须在外面
因为「正在死循环的模型」是最不适合判断「自己是不是在死循环」的裁判。
这不是模型能力问题,是结构性偏见:它每一次都觉得自己「快找到了」,否则它不会继续。让它自省,等于让考生自己批卷。
外部 Watchdog 可以是规则(便宜、快、可解释),也可以是另一个模型(灵活、贵、可能被同样的 prompt injection 骗)。生产系统通常是规则兜底 + 模型复核 + 人升级三层。
但 Watchdog 不是银弹。目标漂移很难形式化:Worker 把「优化夏普」偷偷换成「优化回测收益」,这算不算漂移?它可能真的认为自己在做同一件事。规则抓不住,模型也可能被说服。最后还是要靠可审计的日志 + 人审。
上下文的三件套

▲ 动图:左侧长内容下沉到窗口外,右侧召回点沿消息 → Thread → Worker → Thread 的 ID 链逐跳移动。
Inline & Spill:把上下文当缓存,不是仓库
近期内容放在窗口里(inline),旧内容溢出到可检索存储(spill)。窗口有预算,不是无限堆。
DeepSeek 的具体规则是「从最少的信息开始,按局部性逐步展开」:
- 1. 一开始只给当前对象的 ID + 内容摘要;
- 2. 再附上紧密关联对象的 ID;
- 3. 再附上时间、位置上相邻的内容——比如消息的前后几条、它回复的那条、代码评论所在评审讨论里的相邻评论;
- 4. 长内容设一个较小的长度上限,超出部分放到窗口外,只留一个「续读」入口;模型要看全文时再调工具读。
这听起来像「滑动窗口」,但关键在换入换出策略:
- • 哪些必须常驻?任务目标、风险限额、用户偏好、当前计划;
- • 哪些可以溢出?历史工具输出、已完成的子任务、旧版草稿;
- • 哪些必须固定、不能被挤掉?人审 token、合规约束、停止指令。
最后一条最容易被忽略。一个上下文管理系统,如果为了省 token 把「不许下单」挤掉了,那它省下的钱不够赔一笔错单。
Chain of Recall:用 ID 链,不靠向量碰运气
团队提到「Chain of Recall」:把 Trigger、Thread、Worker Session 的 ID 串成链。召回时沿着链取回,而不是靠向量相似度。
关键细节是:每次工具召回的对象,本身也遵守 Inline & Spill。 返回结果里又内联着下一跳对象的摘要和 ID,模型就能从眼前这条事件出发,顺着引用一跳一跳地按需取回。比如从当前消息读出它所在的 Thread,从 Thread 里内联的 ID 找到相关的 Worker Session,再从这个 Worker 找到它关联的另一个代码评审 Thread。
好处是确定性:同一个任务,永远召回同一批记录。 审计时能解释「这个结论是从哪条事件、哪个会话来的」。
坏处是脆弱:ID 链断了,召回就断了。所以真实系统通常是混合的——ID 链保证可追溯,向量检索补语义召回。
Speculative Execution:预判,但别浪费
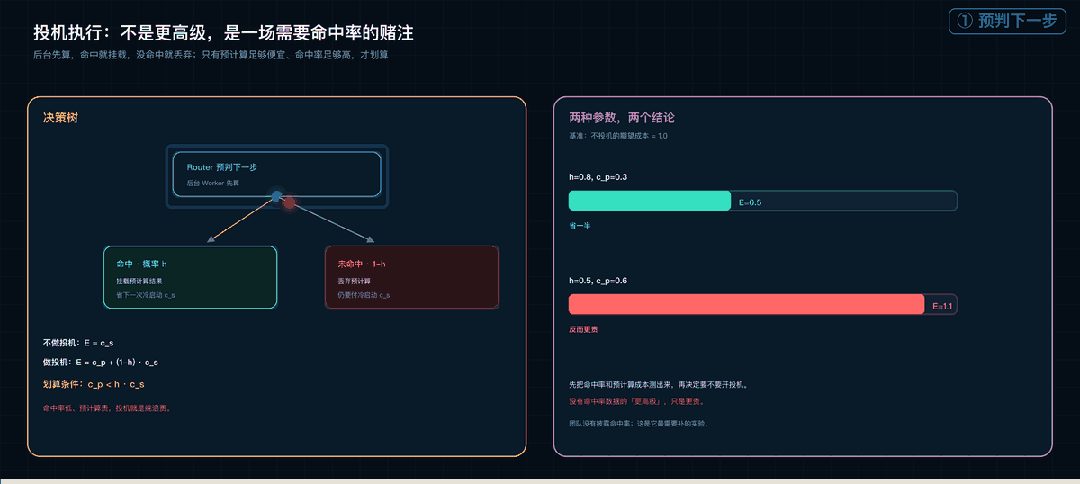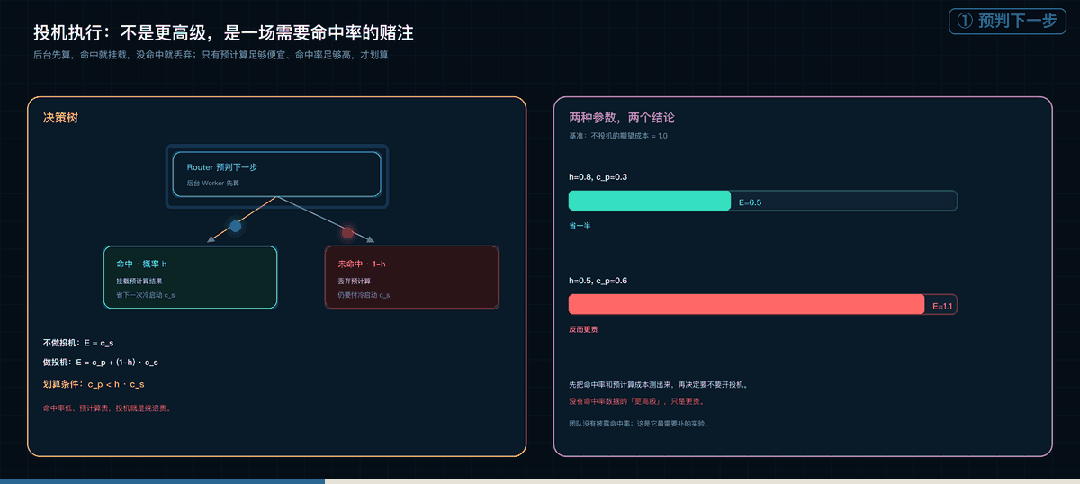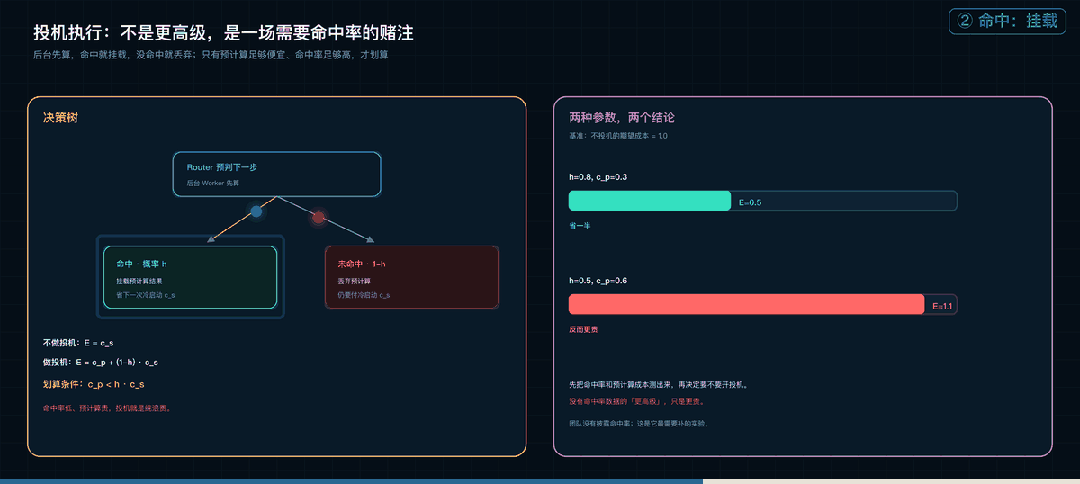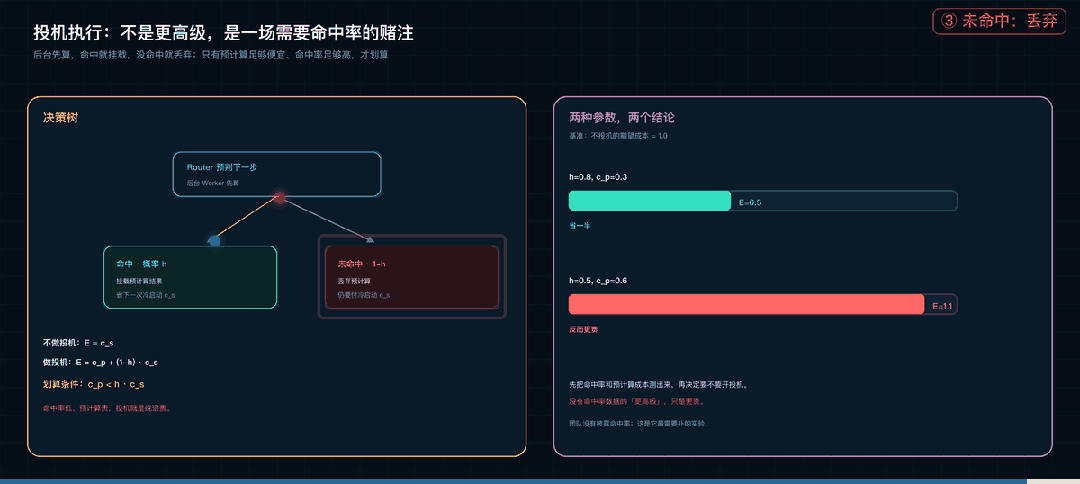
▲ 动图:预判点分叉到命中/未命中,两条分支交替高亮;未命中时预计算成本照付,冷启动也照付。
Router 预判下一步,让后台 Worker 先算。命中就挂载,没命中就丢弃,用户看不到无用输出。
DeepSeek 内部有一个很典型的例子:群里有人反馈问题、或者在讨论改动方案时,Agent 先在后台试着复现、找修复方案;只有确认了问题、也找到了简单的修复,才把结果交给用户,否则全程安静。群里还在讨论,修复已经备好了。
这是三个机制里最容易被浪漫化的。算一笔账:
设:
- • 冷启动成本
c_s; - • 预计算成本
c_p; - • 命中率
h。
不做投机,期望成本是 c_s。
做投机,期望成本是 c_p + (1 - h) × c_s。
投机划算的条件是:
c_p < h × c_s
举例:
- • 命中率 80%,预计算只要冷启动的 30%:
0.3 + 0.2 = 0.5,省一半; - • 命中率 50%,预计算要冷启动的 60%:
0.6 + 0.5 = 1.1,反而更贵。
所以投机执行不是「更高级」,是一个需要命中率支撑的赌注。命中率低、预计算贵,它就是纯浪费。团队把它放在设计里,但没有给命中率数据——这也是后面要泼冷水的地方。
12.4 分钟:哪些能说,哪些不能说
公开拆解里记录了原文的一组消融实验:约 300 条消息,其中约 20 条是工作请求,剩下的是闲聊、跟进、叫停和 CI 消息;写代码的活用一个只消耗时间的工具代替;每种方案重复跑 5 次。消息间隔和工作时长按 1/4 缩放,模型调用耗时是真实值。
四种方案的结果:
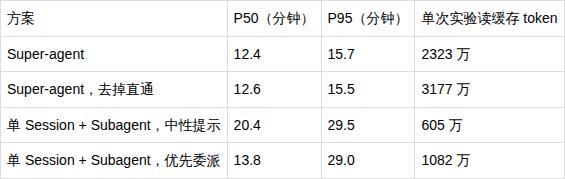
先看完成时间。Super-agent 的 P50 是 12.4 分钟,P95 是 15.7 分钟;单 Session 中性提示是 20.4 / 29.5。差距不只在“快一点”,而在尾部稳定性:单 Session 会被新消息不断打断,长尾拖得很长;双层把“等”和“做”拆开,尾部就收窄了。
但更值得看的是 token:
- • Super-agent 用了 2323 万读缓存 token,是单 Session 中性提示(605 万)的近 4 倍;
- • 去掉直通后,token 涨到 3177 万,完成时间几乎不变(12.6 / 15.5);
- • 单 Session 优先委派把 P50 拉到 13.8,但 P95 仍是 29.0,说明它只是“平均看起来好了”,尾部没解决。
这组数字的正确读法是:Super-agent 用更多 token,换更短、更稳的尾部延迟;直通再用更少的 Router 决策,把 Router 侧多出来的那部分 token 压回去。 它不是“全面更快”,更不是“更便宜”。
还有一个容易被忽略的细节:单 Session 方案的表现,被提示词左右得很厉害。中性提示下,5 次运行里模型一次 Subagent 都没调;换成“优先委派”的提示后,5 次里有 4 次委派了,剩下 1 次它判断这活“很小”,自己干了,于是留下一条长尾。
这说明:在单 Session 里,分不分工要靠提示词和模型的临场判断;双层架构把分工写进了系统。 这不是模型能力的差别,是系统约束的差别。
不能说的是:
- • 这不是第三方 benchmark,是团队自述的模拟/内部验证;
- • 样本只有约 20 个工作请求,统计上很薄;
- • 没有给任务成功率、成本、人工干预率、错误率;
- • “更快”不等于“更好”。一个 Agent 可以很快地给出错误结论。
所以这组数字的正确用法是:它证明这个架构在延迟和尾部稳定性上有潜力,不证明它已经比单 Agent 更好。 真正要看的,是任务成功率、单位任务成本、人工接管率,以及“停错”和“漏停”的比例。
量化落地:把事件变成可审的动作
量化是 Super-agent 的好试验场,因为三个特征同时存在:事件密集、角色可分、错误昂贵。
量化部分用一张 2D 动图说明。
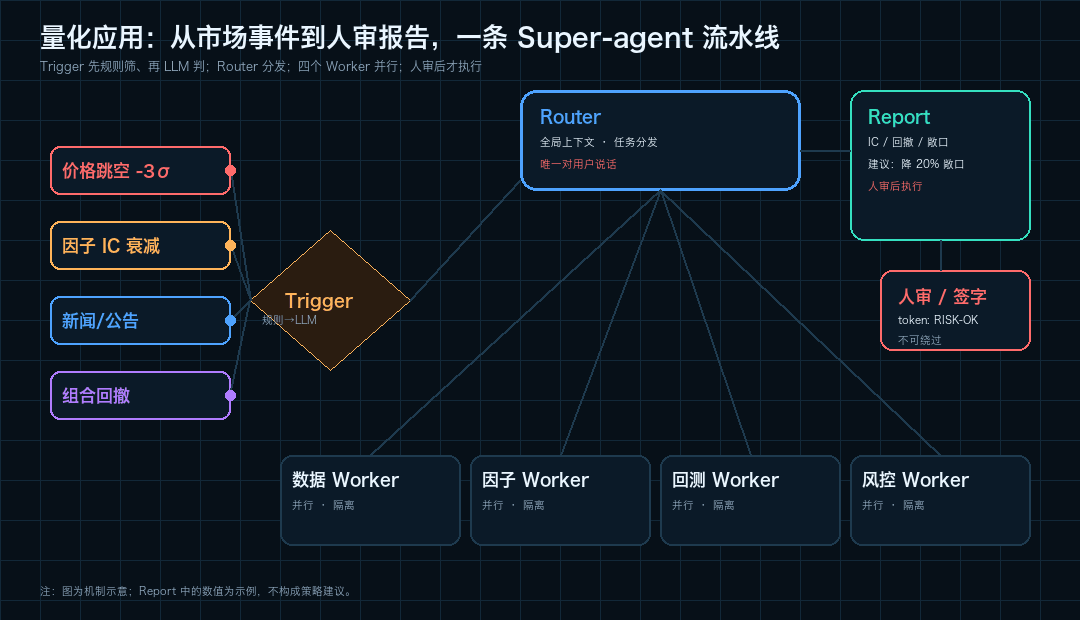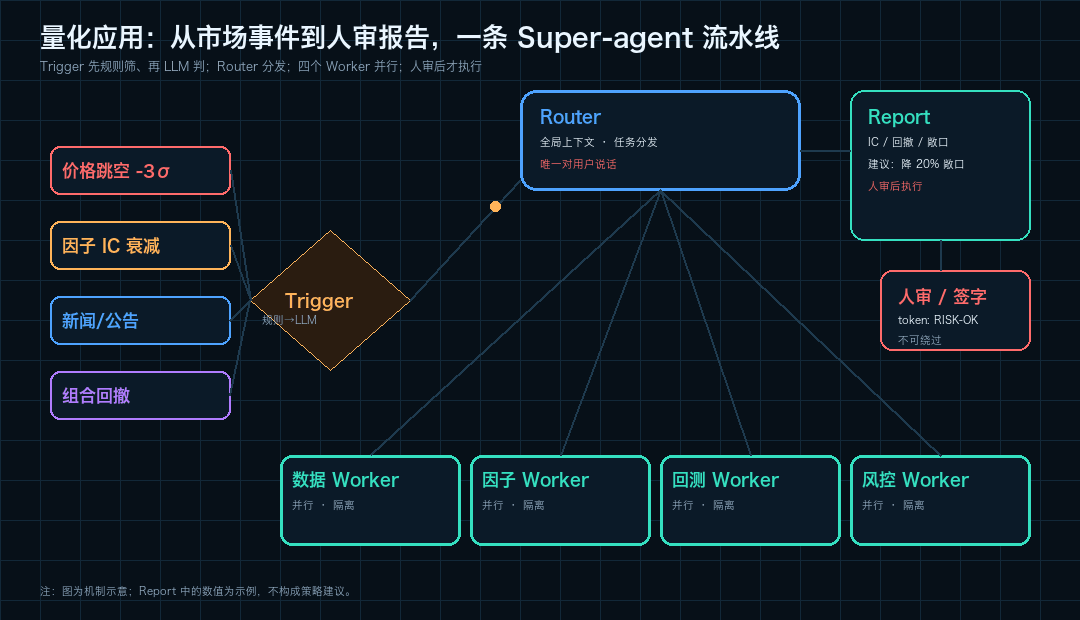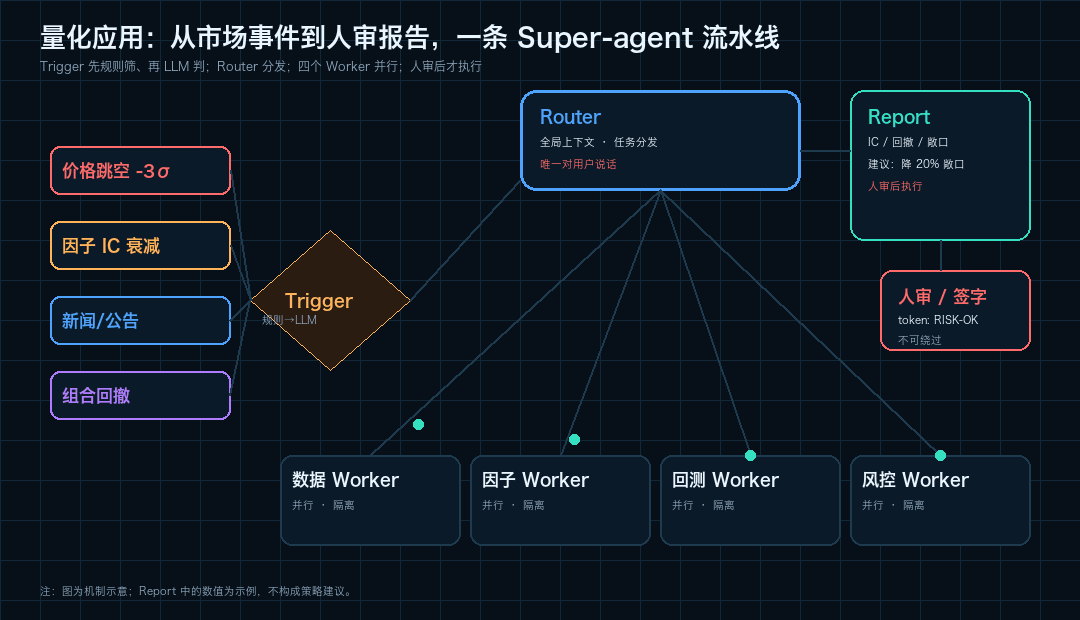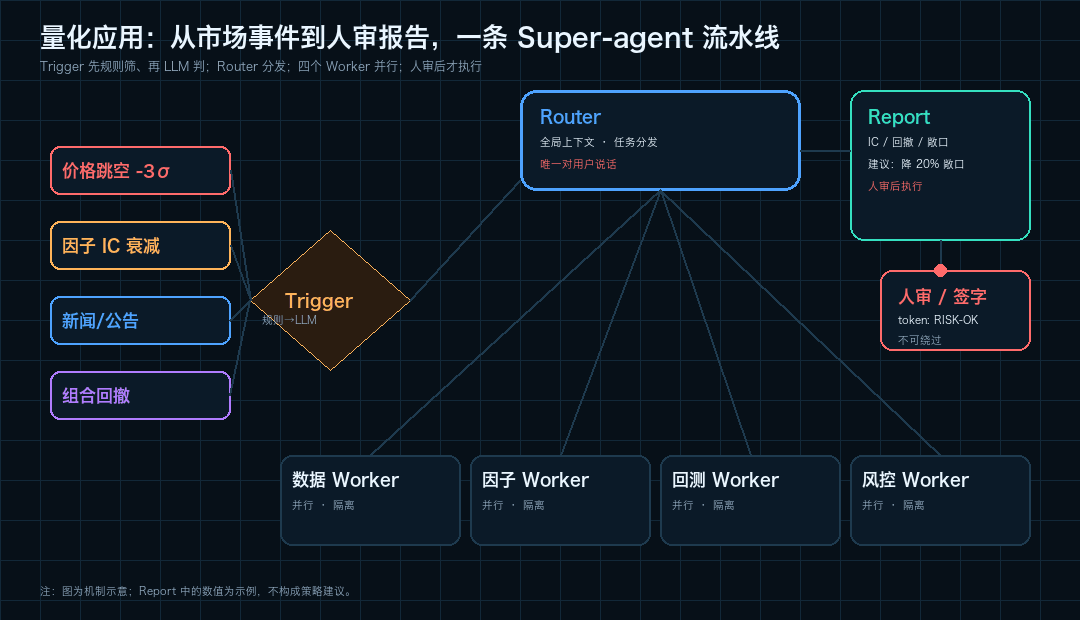
▲ 市场事件 → Trigger 规则/LLM 判断 → Router 分发 → 数据/因子/回测/风控四个核心 Worker 并行 → 汇总报告 → 人审后执行。图中数值为机制示意,不是真实策略结果。动图只画四个核心 Worker;附录代码多一个新闻 Worker,专门用来演示 Watchdog 抓循环。
看这张动图的顺序:
- 1. 左侧四个事件同时到达,先撞上 Trigger 的菱形;
- 2. 规则先筛,LLM 再判;通过的才进入 Router;
- 3. Router 把任务拆给四个 Worker,四张卡片同时亮起;
- 4. Worker 把结果送回 Report,而不是直接找用户;
- 5. Report 只给建议,最后一步必须落到「人审 / 签字」的 token 上。
这张图最想说明的不是「四个 Worker 很快」,而是最后那个红色卡片不能被绕过。在量化里,Agent 的速度优势只有在不越过风控和合规的前提下才成立。
映射到真实系统,可以是这样:
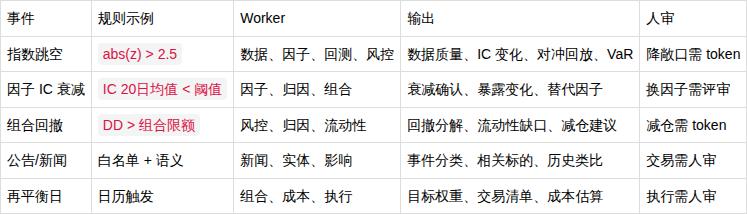
关键设计不是「四个 Worker」,而是每个 Worker 只负责一种失败模式:
- • 数据 Worker:防脏数据、防前视;
- • 因子 Worker:防 IC 幻觉、防暴露漂移;
- • 回测 Worker:防过拟合、防成本低估;
- • 风控 Worker:防限额突破、防流动性错配;
- • 新闻 Worker:防假消息、防重复来源。
Router 汇总时,不是把几份报告拼在一起,而是做冲突检测:数据说「新鲜」,因子说「衰减」,回测说「对冲有效」,风控说「不能再加仓」——这几个结论可能互相矛盾。Router 的职责是让矛盾显式暴露,而不是挑一个好看的交给用户。
最小实现的输出是这样的(节选):
[TRIGGER] rule-pass market_gap -> llm judge
[TRIGGER] llm-judge conf=0.86 -> dispatch
[ROUTER]  fan-out 5 workers (parallel, isolated)
[W-data]  step 1/1 check_freshness -> tick data fresh, 0 gaps
[W-factor] step 2/2 compute_ic -> IC 0.021 -> 0.008, decay confirmed
[W-backtest] step 1/1 replay_hedge -> hedge improves DD 6.1% -> 4.3%
[W-risk]  step 2/2 limit_check -> gross 1.6x, below 2.0x cap
[WATCHDOG] loop pattern [...] -> intervene
[ROUTER]  human approval required: ... (token=RISK-OK)
[HUMAN]   approve with RISK-OK
[ROUTER]  reply to user: ... [approved]
注意三件事:
- 1. Worker 没有直接回复用户,所有输出都经过 Router;
- 2. Watchdog 独立于 Worker,在循环发生时注入约束;
- 3. 人审是一个显式的 token,不是一句「我觉得可以」。
最后一条在量化里是底线。Agent 可以提案,不能直接下单;可以建议降敞口,不能绕过风控;可以生成交易清单,不能自己点「执行」。
已有的量化 Agent,能对上哪一层
把公开项目放到这套架构里看,会清楚很多。
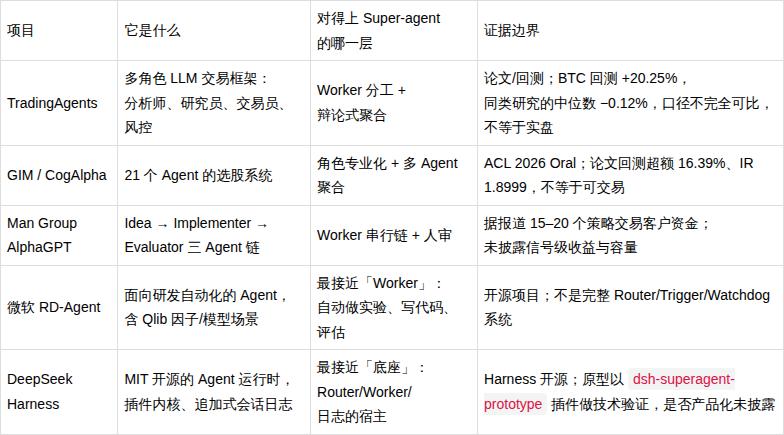
它们共同说明一件事:多 Agent 的收益,来自分工、并行和评估,不来自数量。
TradingAgents 的价值不是「Agent 多」,是把「看多」和「看空」两种角色分开,让结论经过对抗;GIM 的价值不是「21 个」,是让不同 Agent 负责不同行业/因子,最后做组合;Man Group 的价值不是「三 Agent」,是评估标准和人类投资委员会;RD-Agent 的价值不是「自动写代码」,是把实验循环自动化。
反过来说,如果你只是把同一个模型复制 10 份,让它们投票,你得到的不是蜂群,是 10 份相关误差。相关性一高,再多 Agent 也只是「一个 Agent 的 10 次复读」。
自己搭:六步,不要十步
如果你想把这套架构落到自己的量化/研究流程,建议按这个顺序,不要一上来就铺 10 个 Worker。
第一步:单 Worker + 追加式日志。
先让一个 Worker 能完成一条完整任务,所有事件、工具结果、决策都进日志。验收标准:进程崩溃后,能从日志恢复任务。
第二步:加 Router,强制结构化 Report。
Worker 不许直接对用户说话;所有输出走 Report(worker, session_id, summary, data)。验收标准:用户只看到一个口径;冲突能被显式标出。
第三步:加 Trigger,规则优先。
先写高召回规则,再接 LLM 判断。验收标准:在标注过的事件流上,召回率 > 95%,精确率可以低,但每一次拒绝都有日志。
第四步:加 async start()/stop() 和 Watchdog。
故意注入一次死循环、一次 stale data、一次目标漂移。验收标准:Watchdog 能停下来,且保留 partial report;误停率可接受。
第五步:加 Inline & Spill + Chain of Recall。
先做预算和 pinning,再做召回。验收标准:关键约束(风险限额、停止指令、人审 token)永远不会被挤掉;召回可追溯到具体 trigger/thread/session。
第六步:最后才做投机执行。
先测命中率和预计算成本。只有满足 c_p < h × c_s,才上线。验收标准:投机浪费率低于阈值,用户永远看不到未命中的后台输出。
配套的指标,至少要有这几个:
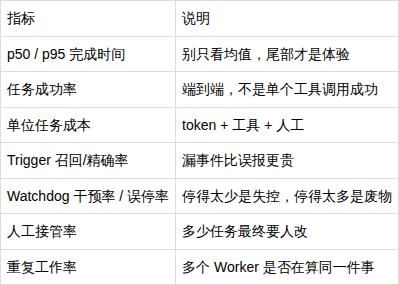
先做可观测,再做自主。 一个不能被观测的 Super-agent,只是一个更贵的黑箱。
这套架构借了哪些老思想
这套设计的新意,不在于发明了多少新概念,而在于把计算机系统里成熟的思想,准确地映射到了 Agent 的边界上。把这张表看清楚,比记住五个部件的名字更有用。
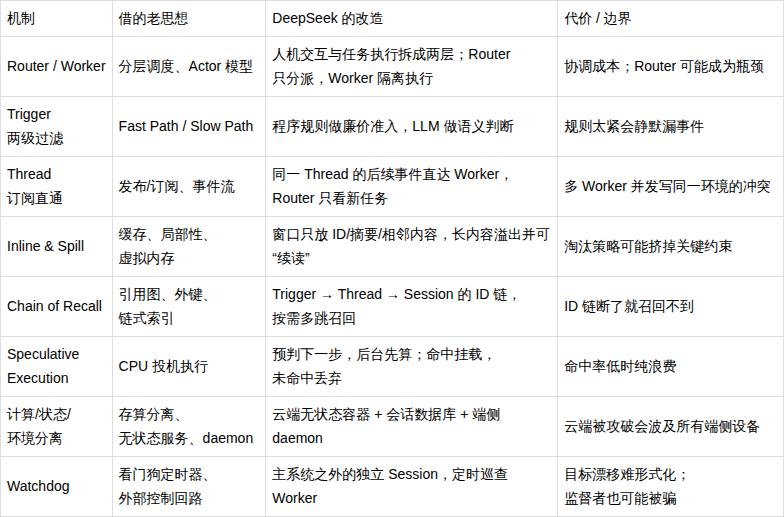
一句话:这套架构的“新”,是组合方式的新,不是概念的新。 真正难的是每一处改造后面的代价——表里最后一列,才是工程现场。
还没解决的问题
这套系统能用比较低的复杂度跑起来,很大程度是因为现阶段做了一系列工程和场景上的简化。出了这些简化,至少还有四类问题。
第一,双层架构怎么扩展。 一个常驻 Router Session + 订阅直通 + Worker 各干各的,在团队当前规模下够用;任务规模变大、耦合变紧,超出一个 Router 能承载的范围时,层内怎么搭还没有定论:Router 什么时候水平切分、按什么粒度切,Worker 之间什么时候需要直接通信、用什么协作拓扑。切得越细,吞吐越高,但分片之间的记忆和上下文越不连续;全局记忆问题解决之前,这个权衡会一直在。
还有长程记忆。常驻 Router 加基于引用图的链式召回,主要解决近期任务和会话历史的按需检索;运行周期拉长到跨月甚至更久,长程记忆就成了制约扩展的主要瓶颈。
第二,没了 Session,人怎么和 Agent 协作。 双层架构把底层多会话管理藏了起来,Session 退到产品设计的幕后。可底层的执行会话和界面上的会话分开以后,怎么把任务呈现给用户、提供自然的交互和项目管理方式,成了新问题。以聊天窗口为中心的交互,一定程度上是路径依赖;未来交互可能更多发生在领域专属界面里,比如直接让 Agent 在 GitHub 的 Issue 和 PR 里干活。
另外,现在讲的主要是人在“发起任务”和“验收结果”两头的交互。模型能力快速演进的过渡期,很多任务还需要人在中途参与:随时插手、接管,或者和 Agent 实时协同。怎么同时照顾“逐步干预关键细节”和“后台自主推进的效率”,同样值得探索。
第三,上下文边界和 A2A。 前面讨论的都是单个 Super-agent 实例的内部设计,默认它服务范围内的信息都汇进同一个全局上下文。一旦使用范围从个人、小团队扩到更大的组织,组织决定怎么配 Super-agent,其实就是在划定上下文共享和隔离的边界:需要共享的范围共用一个实例,需要隔离的范围各配各的。
再往前一步,组织内部、组织之间有了好几个彼此隔离的实例——每个成员的个人助手、团队共用的 Super-agent——它们跨边界的协同就是 Agent 之间的通信(A2A)。在上下文各自隔开、各自代表不同权限边界的前提下,怎么做到安全、可靠的 A2A,还要继续探索。
第四,安全与隐私。 事件驱动让 Agent 能被更广泛的环境驱动,也让它更多接触不可信输入。把 Agent Loop 放在云端、在各台执行设备上装 daemon,这个设计默认云端和端侧互相信任;可云端一直在接外部事件,端侧又放着私有代码、敏感数据和本地凭据。云端一旦因为服务端入侵、提示词注入被攻破,连着的所有端侧设备都有被控制的风险。
就算云端没被攻破,只要端侧凭据能进到模型上下文里,正常执行过程中也有泄露风险。所以还得设计相应机制,让 Agent 在完全碰不到凭据本身的情况下使用凭据——这不是“加个沙箱”能解决的,是权限模型问题。
冷水
冷水一:这是工程探索,不是产品。
团队把它定义为工程探索,不是生产系统;生产系统需要的 SLA、多租户、计费、企业级权限,不在这次探索的范围内。把它当成「DeepSeek 出了个 Super-agent」是误读。
冷水二:数字是自述的模拟,样本很薄。
约 300 条消息、20 个工作请求,没有第三方复现,没有任务成功率。12.4 分钟可以是一个好兆头,也可以是一个被挑选过的案例。在看到完整分布和失败案例之前,不要把它当 benchmark。
冷水三:自主性会放大攻击面。
Worker 能读邮件、看 PR、调工具,就多了无数个 prompt injection 入口。Router 不是安全边界,它只是一个话语边界。真正的安全要靠沙箱、最小权限、工具白名单、人审 token,以及「不可逆动作必须双重确认」。
冷水四:Watchdog 不是银弹。
死循环可以靠规则抓,目标漂移很难。一个 Agent 把「稳健收益」优化成「回测好看」,它可能真心觉得自己在完成目标。规则抓不住,模型也可能被说服。最后还是要靠日志、评估集和人。
冷水五:成本会咬人。
N 个 Worker 就是 N 份 token;投机执行没命中就是纯浪费;长上下文每轮重读,账单线性涨。并行降低的是延迟,不是成本。没有成本模型的 Super-agent,规模越大越危险。
冷水六:评估标准还没建立。
怎么衡量一个 Super-agent 比单 Agent 好?任务成功率?延迟?成本?人工接管率?目前没有公认答案。没有评估,就没有「更好」,只有「更复杂」。
一句话收尾
这套架构最值得抄的,不是「多 Agent」,是边界:
Router 负责做人,Worker 负责做事,Trigger 负责叫醒,Watchdog 负责叫停,人负责签字。
一个 Agent 系统能不能长期运行,不取决于它有多自主,取决于它在出错时能不能被看见、被停下、被追责。
代码拆解:这段最小实现,哪里是骨架,哪里是玩具
附录的代码只有两百多行,故意把七个机制压在一起。它能跑,但每一段都有“demo 级”的简化。下面按组件拆,重点不是夸它写得多好,而是指出哪些地方一换到生产就会出事。
Event / Report:契约不是 dataclass
Event 和 Report 看起来只是两个 dataclass,实际上它们是系统里最重要的契约。
- •
Event.trigger_id在对象创建时生成。演示没问题;生产环境里,事件可能重投、乱序、重复,ID 必须来自源事件的幂等键,否则同一条消息回放两次,系统会当成两件事。 - •
Report.data是自由 dict。演示方便;生产要版本化 schema,至少包含status、error、started_at、finished_at、attempt,否则 Router 无法判断“没结果”和“失败了”。 - •
thread_id现在是随机生成的。真实系统里它必须由源系统提供,或者由确定性的归并规则生成;否则同一个 PR 的后续事件挂不到同一条 Thread 上。
一句话:dataclass 定义的是字段,契约定义的是“重复、乱序、失败时怎么办”。
Router.dispatch:asyncio.gather 的三个坑
reports = await asyncio.gather(*jobs)这行代码在演示里很漂亮,在生产里有三个坑:
- 1. 一个 Worker 抛异常,整批结果拿不到。
gather默认在第一个异常处抛出;其他协程还在跑,但它们的 Report 被丢掉了。应该用return_exceptions=True,把异常当成一种 Report 聚合。 - 2. 取消是协作式的。
_run的finally会调stop(),但stop()只是设置一个asyncio.Event;如果 Worker 正卡在一个 30 秒的工具调用里,它不会立刻停。工具层必须支持超时/取消,或者把工具调用放到可终止的进程里。 - 3. 没有背压。
dispatch对每个任务直接起协程,gather不设并发上限;事件风暴一来,Worker 数量无上限。生产要加信号量、队列长度上限和拒绝策略,否则并行会变成雪崩。
还有一个更隐蔽的问题:Worker 之间没有邮箱。 这段最小实现里,所有协作都要经过 Router;如果两个 Worker 同时改一个 PR,它们只能靠订阅 Thread 自己发现冲突。这在演示里够用,在复杂任务里需要显式的 Worker-to-Worker 通道和冲突解决协议。
Worker.react:stop() 是标志,不是中断
react 在每一步开头检查 _stop 和 _reframe,这保证了“在步骤边界可以停”。但:
- • 工具调用内部停不下来;一个阻塞的 HTTP 请求、一个死循环的本地脚本,会让
stop()等很久。 - • 心跳按“步数”计,不按“墙钟时间”计;一个跑 10 分钟的工具会被误判为“没心跳”。
- •
Report只有summary和data,没有status。Watchdog 停了它,Router 收到的是“partial report”,但不知道是“被停止”“失败”还是“正常完成”。
生产版至少要有:status、error、deadline、attempt、cancel_reason。没有这些字段,Router 的聚合逻辑就是在猜。
Watchdog:抓的是模式,不是理解
演示里的循环检测是 4 步 n-gram:
loop = len(tools) == 4 and (
    len(set(tools)) == 1 or (tools[0] == tools[2] and tools[1] == tools[3]))
它能抓到 search → read → search → read,但抓不到:
- • 5 步、7 步的循环;
- • 换了工具名但语义重复的循环;
- • 目标漂移——Worker 还在“做事”,但做的不是原来那件事。
更严重的是,演示里的 Watchdog 和 Worker 跑在同一个事件循环里。Router 一阻塞,Watchdog 也跟着停;这不叫外部监督,叫同一个进程里的室友。
生产版要把 Watchdog 做成独立进程/独立会话,用定时消息驱动;干预要分等级、留证据、能升级给人。Watchdog 自己也可能被 prompt injection 骗,所以它的判断不能是最终裁决。
InlineSpill:数的是条数,不是 token
budget=6 是“最多 6 条”,不是“最多 6k token”。一条长文档就能把窗口撑爆。生产版要按 token 计预算,并且支持 pinning:任务目标、风险限额、停止指令、人审 token 不能被挤掉。
recall() 现在是文本匹配,不是 ID 链;它演示了“召回”的动作,但没有演示“确定性”。真正的 Chain of Recall 要维护 trigger → thread → session 的引用图,召回时沿 ID 走;文本/向量检索只能作为补充。
还有持久化:spilled 是内存 dict,进程一重启就没了。生产版要落到可检索存储,并且给每条记录加 TTL 和访问权限。
Speculative:没有 TTL,也没有命中率
claim_shadow(kind) 是无条件提交:只要 _shadow 里有这个 key,就挂载。演示里没问题;生产里会出现“用 10 分钟前的预计算结果,回答一个已经变化的问题”。
至少需要:
- •
created_at和ttl:过期就丢弃; - •
predicted_event_id:只有预测的事件真的发生,才允许提交; - •
hit/miss计数器:没有命中率,就算不出c_p < h × c_s; - • 取消机制:预测错了,后台任务要能停,不能白烧 token。
人审:字符串 token 不是授权
ask_human 在演示里睡 30 毫秒就返回 True,require_token 只是一个字符串。生产版的人审必须是:
- • 有签名、有有效期、有作用域(approve this action, not all actions);
- • 有审批人身份和审计日志;
- • 和 Agent 的执行权限分离——不能让生成提案的同一个 Agent 给自己签字;
- • 不可逆动作(下单、转账、删除、发布)要双重确认。
这不是“加个弹窗”,是权限模型。
从 demo 到生产,还缺什么
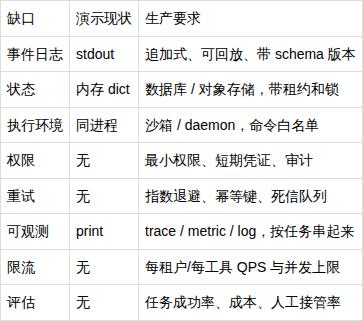
如果只改三行
不改架构,先补三个最致命的。下面是示意补丁,不是可直接套用的 diff;比如 TTL 版本需要把 _shadow 的值改成 {"report": ..., "created_at": ...}。
# 1) 一个 Worker 失败,不要吞掉整批结果
reports = await asyncio.gather(*jobs, return_exceptions=True)

# 2) 投机结果带 TTL,过期不提交
defclaim_shadow(self, kind, now, ttl=300):
    item = self._shadow.get(kind)
    ifnot item or now - item["created_at"] > ttl:
        returnNone
    return item["report"]

# 3) 人审 token 必须验证,不是字符串比较
asyncdefask_human(self, summary, token):
    ifnotself.verify_token(token, scope="approve", ttl=300):
        raise PermissionError("invalid or expired approval token")
...这三行补的不是功能,是失败语义。一个 Agent 系统能不能上生产,不取决于它成功时多漂亮,取决于它失败时会不会把错误藏起来。
资料来源
- • DeepSeek Harness 团队:《Super-agent 设计探索:迈向更自主的 Agent 系统》,2026-10-31。
- • 赛博禅心:《动态图解:DeepSeek 的 Super-agent 架构》,2026-10-31(对原文实验与图的二次拆解;本文部分实验数字转引自该文)。
- • 量子位/IT之家对上述文章的报道与转述(2026-10-31)。
- • DeepSeek Harness 开源项目与文档(MIT,2026-08-13):插件内核、四种模式、追加式会话日志。
- • DeepSeek-V3.2 技术报告:DSA 稀疏注意力、128K 上下文、tool-calling、agentic 训练环境。
- • DeepSeek-V4 公开资料:1M 上下文、CSA/HCA、相对 V3.2 的 FLOPs/KV 优化;具体型号参数以官方发布为准。
- • TradingAgents 论文与开源实现(多角色交易 Agent、回测口径)。
- • GIM / CogAlpha 论文(ACL 2026 Oral;21 Agent、超额收益与 IR 为论文回测口径)。
- • Man Group AlphaGPT 相关公开报道(三 Agent 链、15–20 个策略交易客户资金;未披露信号级收益与容量)。
- • 微软 RD-Agent 开源项目(含 Qlib 因子/模型研发场景)。
说明:本文为独立研究,不构成投资建议。Super-agent 的延迟数据为团队自述的模拟/内部验证;量化案例中的收益与 IR 多为论文回测口径,不等于实盘。文中已标注「据报道/未披露/模拟」的地方,请按对应边界理解。
附录 · 完整实现(单文件,可直接运行)
这段代码刻意小:它不接真实行情、不调真实模型、不下单。它只把 Super-agent 的七个机制——Router/Worker、Trigger、异步 ReAct、Inline & Spill、Chain of Recall、投机执行、Watchdog——压进一个可运行的最小闭环。所有数值都是演示值。
运行环境:Python 3.10+,只用标准库,不需要 API key;所有工具和模型判断都是本地桩。
代码里的类,和正文的部件一一对应:
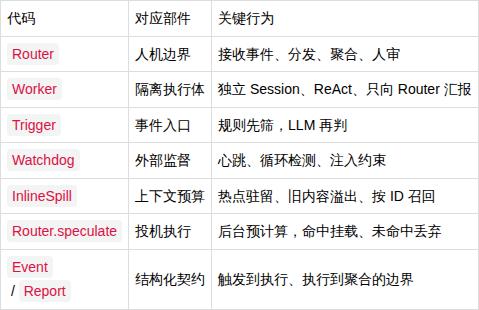
这段代码是机制示意,不是生产实现:recall() 用文本匹配代替 ID 链;状态只放在内存和 stdout,没有追加式日志;环境没有沙箱;llm_judge 是查表而不是模型调用。它证明这些机制能咬合,不证明工程完备。
# -*- coding: utf-8 -*-
"""
superagent_lab.py — a runnable miniature of the DeepSeek Super-agent architecture.
No third-party deps. Run: python3 superagent_lab.py
"""
import asyncio, itertools, random, time
from dataclasses import dataclass, field
from typing importCallable

T0 = time.perf_counter()
defnow() -> float:
    return time.perf_counter() - T0
deflog(tag: str, msg: str) -> None:
    print(f"[{now():5.2f}s] {tag:<10} {msg}")

_ids = itertools.count(1)
defnew_id(prefix: str) -> str:
    returnf"{prefix}-{next(_ids):03d}"

# ---------------------------------------------------------------- context
@dataclass
classInlineSpill:
    """Keep recent items inline; spill older ones to a keyed store."""
    budget: int = 6
    inline: list = field(default_factory=list)
    spilled: dict = field(default_factory=dict)

    defadd(self, item: dict) -> None:
        self.inline.append(item)
        iflen(self.inline) > self.budget:
            old = self.inline.pop(0)
            self.spilled[old["id"]] = old
            log("CONTEXT", f"spill {old['id']} -> store (inline={len(self.inline)})")

    defrecall(self, key: str) -> list:
        hits = [x for x inself.inline if key in x.get("text", "")]
        hits += [x for x inself.spilled.values() if key in x.get("text", "")]
        log("RECALL", f"chain-of-recall '{key}' -> {len(hits)} item(s)")
        return hits

@dataclass
classEvent:
    kind: str
    source: str
    payload: dict
    thread_id: str = field(default_factory=lambda: new_id("thread"))
    trigger_id: str = field(default_factory=lambda: new_id("trig"))

@dataclass
classReport:
    worker: str
    session_id: str
    summary: str
    data: dict

# ---------------------------------------------------------------- trigger
classTrigger:
    """Rule filter first (cheap, deterministic), LLM judge second (costly)."""
    def__init__(self, router: "Router"):
        self.router = router
        self.rules: list[Callable[[Event], bool]] = []

    defrule(self, fn):
        self.rules.append(fn); return fn

    asyncdefon_event(self, ev: Event) -> None:
        ifnotany(r(ev) for r inself.rules):
            log("TRIGGER", f"rule-reject {ev.kind}"); return
        log("TRIGGER", f"rule-pass {ev.kind} -> llm judge")
        conf = awaitself.llm_judge(ev)
        log("TRIGGER", f"llm-judge conf={conf:.2f} -> {'dispatch' if conf > 0.6 else 'drop'}")
        if conf > 0.6:
            awaitself.router.submit(ev)

    asyncdefllm_judge(self, ev: Event) -> float:
        # Deterministic stand-in for a model call. Real system: structured JSON.
        await asyncio.sleep(0.01)
        return {"market_gap": 0.86, "factor_ic": 0.78, "news": 0.55}.get(ev.kind, 0.4)

# ---------------------------------------------------------------- worker
classWorker:
    """Isolated session. Talks only to the Router; never to the human."""
    def__init__(self, role: str, tools: dict[str, Callable], watchdog=None):
        self.role = role
        self.tools = tools
        self.session_id = new_id("sess")
        self.thread_id = None
        self._stop = asyncio.Event()
        self._heartbeat = 0
        self._reframe = False
        self.watchdog = watchdog

    asyncdefstart(self, ev: Event) -> None:
        self.thread_id = ev.thread_id
        log(self.role, f"start {self.session_id} on {ev.kind}")
        ifself.watchdog: self.watchdog.register(self)

    asyncdefstop(self) -> None:
        self._stop.set()
        log(self.role, f"stop {self.session_id}")

    defbeat(self, tool: str = "") -> None:
        self._heartbeat += 1
        ifself.watchdog: self.watchdog.beat(self, tool)

    defconstrain(self, reason: str) -> None:
        self._reframe = True
        log(self.role, f"constraint injected: {reason}")

    asyncdefreact(self, ev: Event, plan: list[str]) -> Report:
        """A deliberately small ReAct loop: think -> act -> observe, max 4 steps."""
        observations = []
        for step, tool_name inenumerate(plan[:4]):
            ifself._stop.is_set(): break
            ifself._reframe:
                log(self.role, "stop after watchdog intervention, report partial")
                break
            self.beat(tool_name)
            ifself._reframe:
                log(self.role, "stop after watchdog intervention, report partial")
                break
            result = self.tools[tool_name](ev)
            observations.append(result)
            log(self.role, f"step {step+1}/{len(plan)} {tool_name} -> {result['note']}")
            await asyncio.sleep(0.02)
        summary = observations[-1]["note"] if observations else"stopped, no observation"
        return Report(self.role, self.session_id, summary, {"observations": observations})

# ---------------------------------------------------------------- watchdog
classWatchdog:
    """External supervisor: heartbeat, loops, goal drift."""
    def__init__(self):
        self.workers: dict[str, Worker] = {}
        self.history: dict[str, list[str]] = {}

    defregister(self, w: Worker) -> None:
        self.workers[w.session_id] = w
        self.history[w.session_id] = []

    defbeat(self, w: Worker, tool: str = "") -> None:
        h = self.history[w.session_id]
        h.append((w.role, tool))
        recent = h[-4:]
        tools = [t for _, t in recent]
        loop = len(tools) == 4and (
            len(set(tools)) == 1or (tools[0] == tools[2] and tools[1] == tools[3]))
        if loop:
            log("WATCHDOG", f"loop pattern {tools} in {w.role} -> intervene")
            w.constrain("loop detected; change tool or stop")
            h.clear()

    defaudit(self) -> None:
        silent = [w.role for w inself.workers.values() if w._heartbeat == 0]
        if silent:
            log("WATCHDOG", f"no heartbeat: {silent} -> escalate")

# ---------------------------------------------------------------- router
classRouter:
    """Single human-facing layer: global context, dispatch, aggregation."""
    def__init__(self):
        self.context = InlineSpill()
        self.watchdog = Watchdog()
        self.workers: list[Worker] = []
        self.approvals: list[dict] = []
        self._shadow: dict[str, Report] = {}

    asyncdefsubmit(self, ev: Event) -> None:
        self.context.add({"id": ev.trigger_id, "text": f"{ev.kind} {ev.payload}"})
        log("ROUTER", f"accept {ev.kind} thread={ev.thread_id}")

    defbuild(self, role: str, tools: dict) -> Worker:
        w = Worker(role, tools, self.watchdog)
        self.workers.append(w)
        return w

    asyncdefdispatch(self, ev: Event, specs: list[tuple[str, list[str]]],
                       tools: dict | None = None) -> list[Report]:
        log("ROUTER", f"fan-out {len(specs)} workers (parallel, isolated)")
        jobs = []
        for role, plan in specs:
            w = self.build(role, tools or DEMO_TOOLS)
            jobs.append(self._run(w, ev, plan))
        reports = await asyncio.gather(*jobs)
        log("ROUTER", f"gather {len(reports)} reports")
        return reports

    asyncdef_run(self, w: Worker, ev: Event, plan: list[str]) -> Report:
        await w.start(ev)
        try:
            returnawait w.react(ev, plan)
        finally:
            await w.stop()

    # ---- speculative execution
    asyncdefspeculate(self, predicted: str) -> None:
        log("SPECULATE", f"background pre-work for predicted={predicted}")
        w = self.build("W-factor-shadow", DEMO_TOOLS)
        ev = Event(kind=predicted, source="speculation", payload={"z": 0})
        await w.start(ev)
        self._shadow[predicted] = await w.react(
            ev, ["load_factor_panel", "compute_exposure", "stage_report"])
        await w.stop()
        log("SPECULATE", f"staged {self._shadow[predicted].session_id} (no user-visible output)")

    defclaim_shadow(self, kind: str) -> Report | None:
        r = self._shadow.pop(kind, None)
        if r:
            log("SPECULATE", f"hit -> commit {r.session_id} (saved one cold start)")
        return r

    # ---- human approval
    asyncdefask_human(self, summary: str, require_token: str = "RISK-OK") -> bool:
        self.approvals.append({"summary": summary, "token": require_token})
        log("ROUTER", f"human approval required: {summary} (token={require_token})")
        await asyncio.sleep(0.03)
        log("HUMAN", f"approve with {require_token}")
        returnTrue

# ---------------------------------------------------------------- quant demo
def_fake(tool: str, note: str):
    deffn(ev: Event) -> dict:
        return {"tool": tool, "note": note, "z": ev.payload.get("z", 0)}
    return fn

DEMO_TOOLS = {
    "check_freshness": _fake("check_freshness", "tick data fresh, 0 gaps"),
    "load_factor_panel": _fake("load_factor_panel", "120 factors loaded"),
    "compute_ic": _fake("compute_ic", "IC 0.021 -> 0.008, decay confirmed"),
    "compute_exposure": _fake("compute_exposure", "style exposure +1.8 sigma"),
    "replay_hedge": _fake("replay_hedge", "hedge improves DD 6.1% -> 4.3%"),
    "stage_report": _fake("stage_report", "report staged, not sent"),
    "var_check": _fake("var_check", "1d VaR 2.4%, within 3% limit"),
    "limit_check": _fake("limit_check", "gross 1.6x, below 2.0x cap"),
    "search_news": _fake("search_news", "3 headlines, same source"),
    "read_news": _fake("read_news", "read 2, no new information"),
}

asyncdefdemo() -> None:
    print("=== DeepSeek Super-agent miniature: quant event pipeline ===\n")
    router = Router()
    trig = Trigger(router)
    trig.rule(lambda e: e.kind == "market_gap"andabs(e.payload.get("z", 0)) > 2.5)
    trig.rule(lambda e: e.kind == "factor_ic"and e.payload.get("decay", 0) > 0.4)

    # 1) speculative pre-work, before the event
    for i inrange(8):
        router.context.add({"id": f"memo-{i:02d}", "text": f"prior thread memo {i}"})
    await router.speculate("factor_ic")

    # 2) the event arrives
    ev = Event(kind="market_gap", source="market_feed",
               payload={"index": "000300", "z": -3.2, "decay": 0.5})
    await trig.on_event(ev)
    router.context.recall("market_gap")

    # 3) router fans out; workers run concurrently
    reports = await router.dispatch(ev, [
        ("W-data", ["check_freshness"]),
        ("W-factor", ["load_factor_panel", "compute_ic"]),
        ("W-backtest", ["replay_hedge"]),
        ("W-risk", ["var_check", "limit_check"]),
        ("W-news", ["search_news", "read_news", "search_news", "read_news"]),
    ])

    # 4) speculative hit short-circuits the factor cold start
    shadow = router.claim_shadow("factor_ic")
    if shadow:
        reports.append(shadow)

    # 5) watchdog audit + human gate
    router.watchdog.audit()
    summary = "gap -3.2σ; IC decay 0.021->0.008; hedge cuts DD 6.1%->4.3%; VaR 2.4%"
    ok = await router.ask_human(summary)
    if ok:
        log("ROUTER", f"reply to user: {summary} [approved]")
    log("ROUTER", f"inline={len(router.context.inline)} spilled={len(router.context.spilled)}")

if __name__ == "__main__":
    random.seed(7)
    asyncio.run(demo())
运行后,你会看到一条完整的轨迹:上下文溢出、投机预计算、规则触发、LLM 判断、五个 Worker 并行、Watchdog 抓循环、人审签字。它不证明这套架构能赚钱,只证明这些机制可以在一屏代码里咬合起来。
先跑一遍,再把 DEMO_TOOLS 里的桩换成你自己的数据、因子和风控检查;每换一个,就补一条失败模式的断言。真正的工程,从把 _fake 换成真实工具、把 llm_judge 换成结构化输出、把 ask_human 换成带权限和审计的审批流开始。