开源中小模型+Skills也性能暴增!卢森堡大学探索了小模型驾驭Skills的边界 Оригинал на китайском
Agent Skills 让顶尖大模型进化到了能直接交付结果,那在小模型上效果如何呢?
卢森堡大学等多所顶级高校与工业机构的最新研究,探索了小模型驾驭Skills的边界。
工业界对数据安全极度渴望,开源小语言模型凭借智能体 Skills 框架终于找到了挑战闭源巨头接口的隐秘路径。
研究人员系统拆解了小语言模型在处理复杂工业任务时,如何通过静态 Skills 降低显存消耗并提升准确率。
并发现了代码专用模型在真实业务场景中的巨大商业潜力。
智能体 Skills 框架近年来在各大主流开发平台中迅速普及。
开发者习惯将大型闭源模型接入系统并赋予调用外部工具的能力。
现实工业场景往往有着严苛的数据隐私和预算限制。
金融或军事等核心行业无法持续依赖外部公开接口传递敏感信息。
企业更倾向于在本地部署开源的小语言模型来处理高度定制化的业务流。
小语言模型在复杂的专有场景中往往表现出泛化能力不足的短板。
传统的上下文工程致力于解决模型面对海量信息时产生的记忆衰退现象。
过去开发者喜欢把所有参考资料一股脑塞给模型。这种方式极其消耗算力且容易诱发大面积的幻觉错误。
检索增强生成 RAG 技术将文本固化到向量数据库中进行匹配。
智能体 Skills 框架另辟蹊径,它更像是一份精心设计的静态小抄。模型通过自身涌现的逻辑推演能力,动态挑选最相关的背景知识和行动指令。
这种渐进式的信息暴露机制把有效上下文长度控制在极小的范围内。
模型不再被冗长的无关信息干扰,注意力得以高度集中。
工具选择的成功率和最终任务的准确度均获得了极大的跃升。
渐进式披露平衡决策成本
我们可以用部分可观察马尔可夫决策过程 POMDP 来对这种智能体行为进行严格的数学建模。
系统就像一个在迷宫中摸索的探险者,无法直接看清终点。探险者必须依靠历史交互记录在脑海中维持一个信念状态。
每一次行动前,智能体都要在推进任务进度与消耗注意力之间做出权衡。
它需要决定是直接执行某项 Skills,还是花费额外成本去揭示更多关于该 Skills 的隐藏细节。这种决策本质上是在用增加的计算成本换取更清晰的视野。
当智能体对当前状况感到迷茫时,它会主动索要更多上下文信息。
此时获取新信息的价值远大于揭示信息所消耗的代价。一旦收集到足够的证据建立起高度确定的信念,系统便会干脆利落地执行预定工作流。
为了验证不同策略的有效性,研究人员设计了三种截然不同的指令模式。
直接指令(DI)模拟用户最原始的简短输入。全 Skills 指令(FSI)将整个 Skills 库打包塞入提示词,考验模型在信息轰炸下的甄别能力。
智能体 Skills 指令(ASI)则赋予模型按需加载信息的特权。模型自己判断是否需要阅读详细说明,进而根据提取到的精准知识生成最终答案。
智能体 Skills 指令则赋予模型按需加载信息的特权。模型自己判断是否需要阅读详细说明,进而根据提取到的精准知识生成最终答案。
研究团队精选了三个难度递进的数据集来全面摸底模型的能力边界。
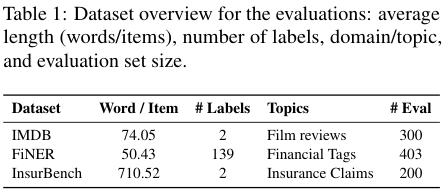
简单级别的电影评论数据集 IMDB(互联网电影资料库)用于测试基础的情感分类。
金融领域的开源数据集 FiNER(金融命名实体识别)布满了复杂的专业标签,考验系统的逻辑严密性。
工业级专有数据集 InsurBench(保险基准)直接取自真实的保险索赔邮件记录。
这些邮件内容冗长且夹杂着多种语言和通信错位信息。智能体必须综合前后文语境给出明确的案件处理建议,极具实战挑战性。
参数规模决定Skills路由成败
工业部署环境对模型的硬件资源消耗极其敏感。
研究人员挑选了参数量从 2 亿到 800 亿不等的多个主流开源模型进行横向对齐。对标的参考基准则是业界公认的高效闭源模型。
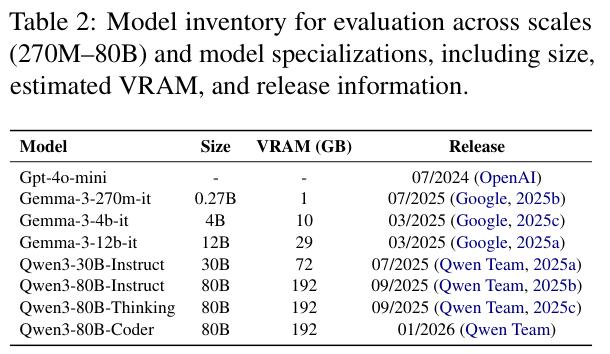
模型家族内部又细分为侧重多步验证的推理版和专精结构化生成的代码版。
这种细致的切分有助于我们看清训练目标对最终 Skills 调用能力的深层影响。
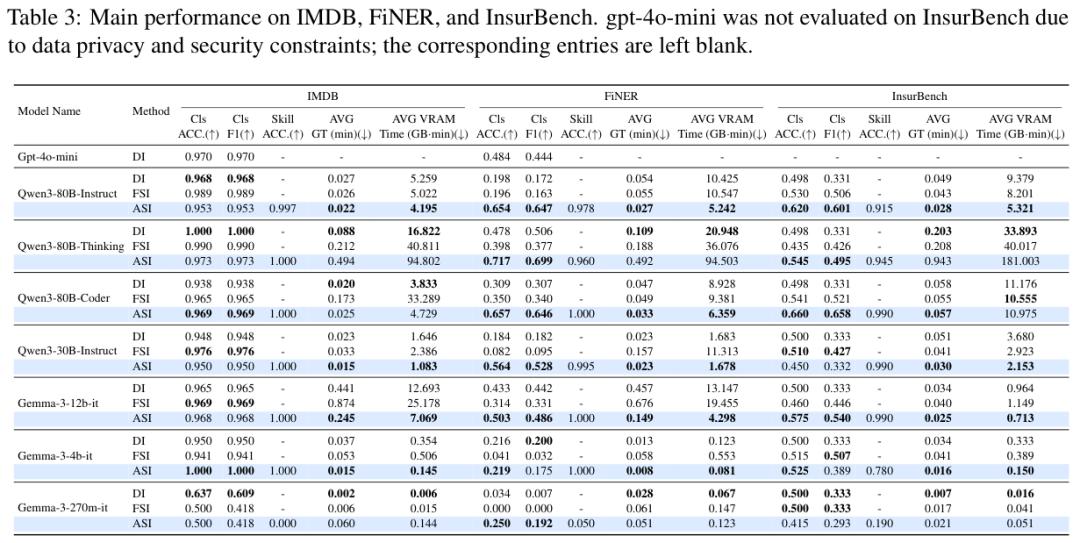
多数中等规模的小语言模型在引入智能体Skills框架后迎来了业绩的全面爆发。
特别是在处理金融和保险等高难度基准测试时,能力提升幅度令人惊艳。
中等体量的开源模型完全可以在特定垂直领域胜任原本需要巨型模型才能完成的工作。
极小参数规模的模型在这个框架下暴露出了严重的智力瓶颈。
面对仅仅掺杂了少数几个干扰项的 Skills 选择题,参数量在 40 亿以下的微型模型常常迷失方向。
它们甚至无法准确抽取出目标 Skills 的名称,后续的复杂推理更是无从谈起。
代码专用模型突破显存瓶颈
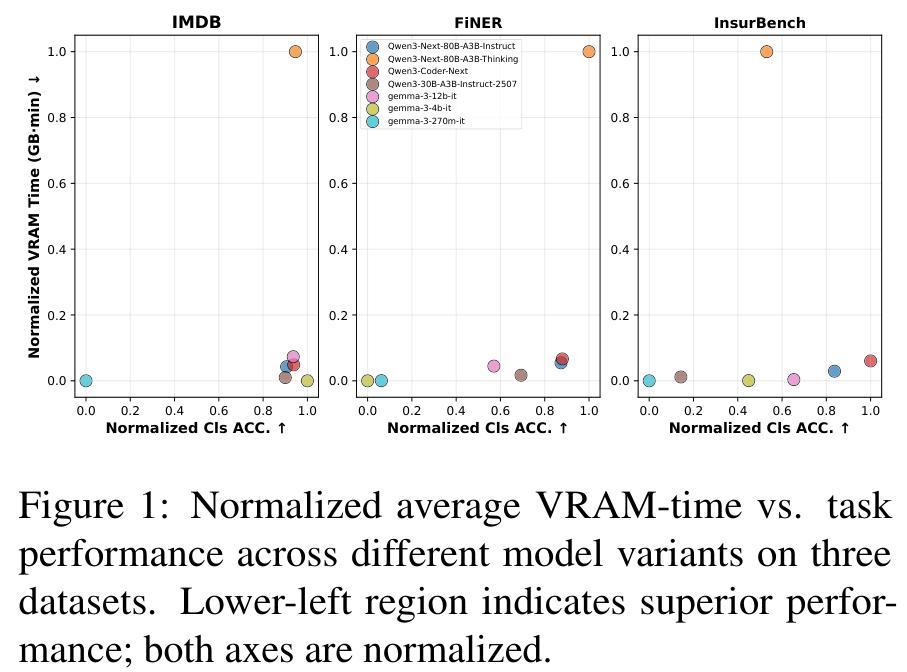
同等参数规模下,专为编写代码优化的语言模型在准确率上大幅度甩开了普通的指令微调模型。
代码模型天生擅长捕捉层次结构和逻辑关联。在执行保险索赔这种长篇幅的复杂判断时,它的表现甚至超越了那些被刻意强化过深层思考能力的变体。
引入显存时间这个独特的衡量维度后,代码模型的工业部署优势展露无遗。
显存占用率和端到端延迟时间的双重下降直接抹平了高昂的算力开销。对于精打细算的企业技术高管来说,智能体 Skills 框架结合代码大模型成为了控制成本的完美配方。
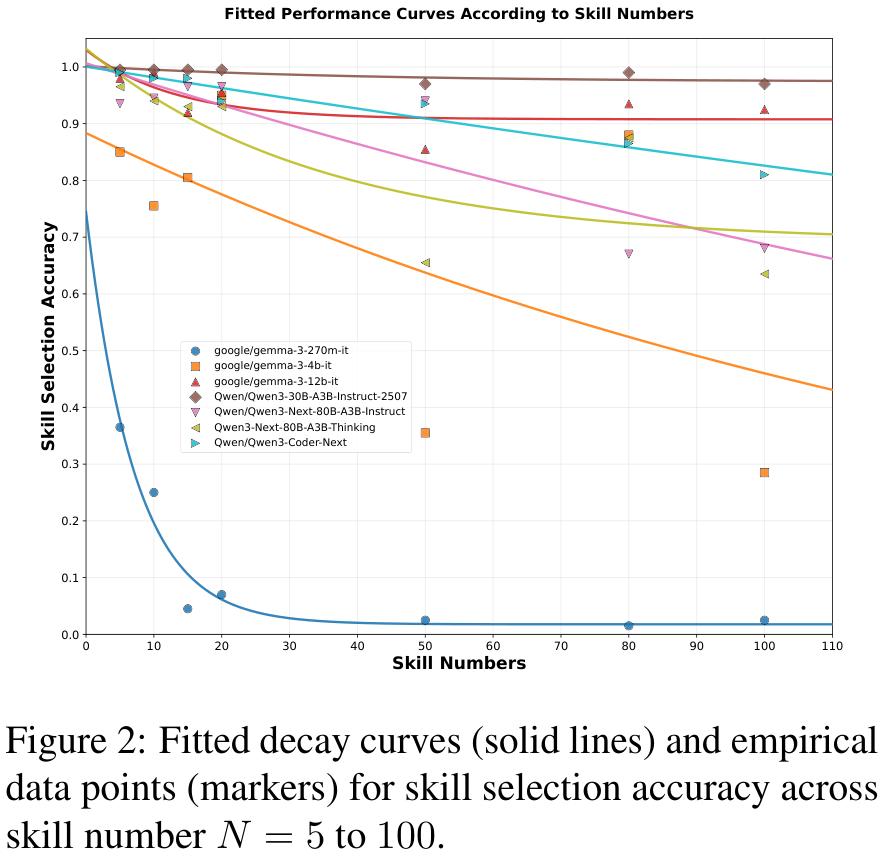
真实的系统往往包含 50 到 100 个庞大的功能模块。研究团队不断往 Skills 池中添加干扰项来探测模型的心理素质。
微型模型在面对两位数的 Skills 列表时迅速崩溃,如同被海量选择题淹没的差生。
超过 120 亿参数的中型模型展现出了极强的抗压能力。
面对 100 个候选项依然能做到百步穿杨精准定位。代码版大模型更是能够轻松理顺嵌套层级,在海量干扰中准确识别出最核心的执行路径。
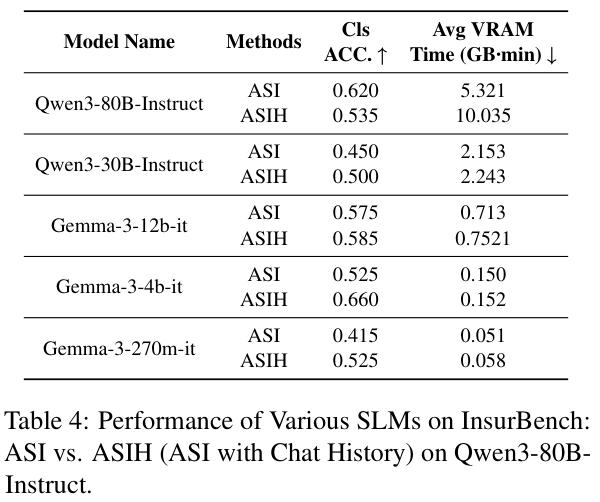
给模型保留对话历史常常是一把双刃剑。微型小模型非常依赖历史聊天记录来寻找解题线索。
庞大的 800 亿参数模型在加载历史对话后,其显存成本会瞬间暴涨近一倍且准确率收益微乎其微。
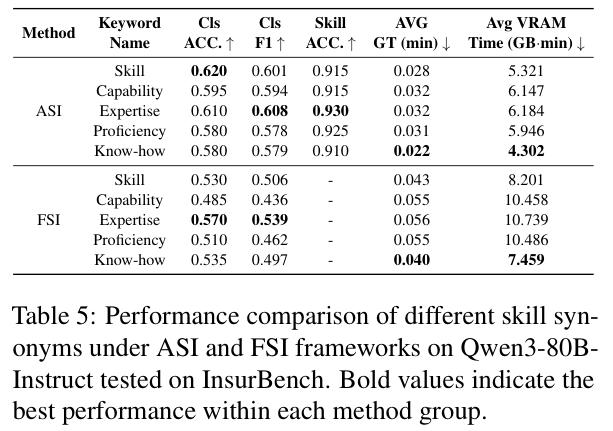
研究人员还做了一个饶有趣味的文字游戏。他们把系统提示词里的核心触发词 “Skills” 替换成了 “Expertise” 或是 “Know-how” 等,性能和显存资源的消耗竟发生了变化。
数据安全与算力成本,构成了工业智能落地的双重锁链,而代码类小语言模型配上智能体渐进式框架,正好打造了一把精准开锁的钥匙。
参考资料:
https://arxiv.org/pdf/2602.16653