MMEB国际多模态表征新标杆:阿里 Qwen3-VL-Embedding & Reranker Оригинал на китайском
当文本、图像、视频、视觉文档等多模态数据在互联网中呈指数级增长,传统检索系统面临着模态割裂、语义对齐不足、长序列处理能力有限等核心挑战。如何让检索系统跨越模态边界,实现 “以文搜图”“以图搜视频”“跨语言跨模态精准匹配”?阿里通义实验室最新发布的 Qwen3-VL-Embedding 与 Qwen3-VL-Reranker 模型系列,基于 Qwen3-VL 基础模型构建了端到端多模态检索解决方案,在多项权威基准测试中实现性能突破,为多模态检索技术开辟了新路径。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
一、多模态检索的3大核心痛点
现在互联网上的内容早就不是纯文本天下了——电商里的产品视频、科研中的PDF图表、社交媒体的图文动态,多模态数据呈爆炸式增长。但现有检索系统始终绕不开三个坎:
模态“语言不通”:文本、图片、视频的语义很难统一映射——比如“流畅的动态设计”这个文本描述,既对应舞蹈视频的动作,也对应UI设计图的布局,但传统模型要么只能处理两种模态,要么跨模态匹配时抓不住核心语义。
落地成本居高不下:高性能模型的嵌入向量维度固定(比如1024维),存储海量数据时硬盘压力山大;而且量化压缩后性能暴跌,有些模型从float32量化到int8,检索精度直接掉了15%。
长输入与多语言适配差:学术PDF、长视频这类超过10k tokens的内容,传统模型处理时会截断关键信息;而跨境场景需要支持多语言检索,但多数模型只擅长英文,中文等小语种表现拉胯。
这些问题不是孤立的——模态对齐不准会导致检索召回率低,高存储成本让中小团队望而却步,长输入和多语言支持不足则限制了应用场景。传统方案要么偏科(比如CLIP只擅长图文匹配,处理视频和文档就乏力),要么顾此失彼(比如追求精度就牺牲存储,优化速度就丢了泛化性)。
二、模型核心定位与整体架构
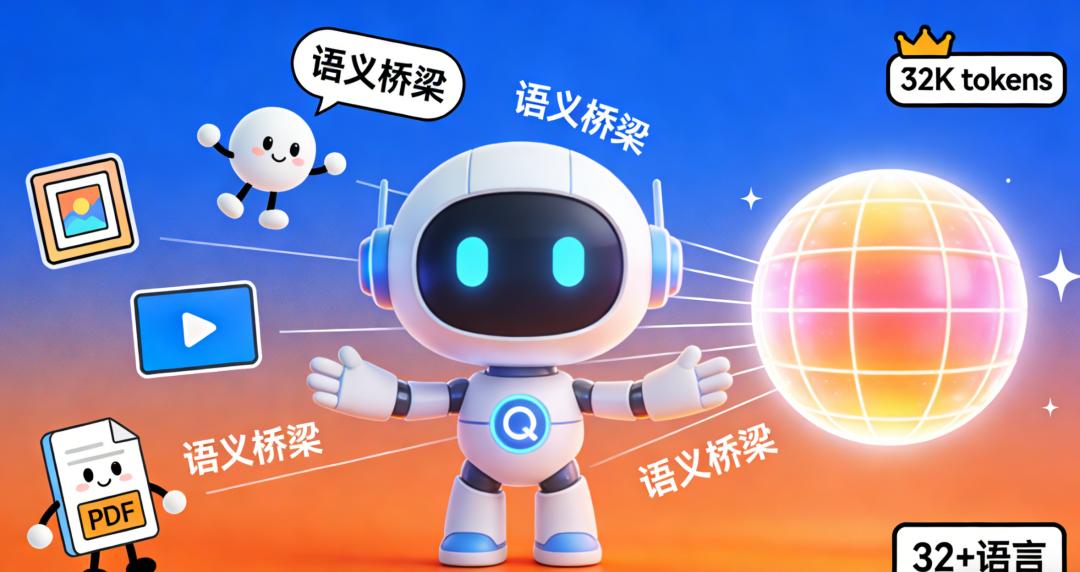
Qwen3-VL-Embedding与Qwen3-VL-Reranker是Qwen家族针对多模态检索场景的专项扩展,二者协同构成“表征-重排”两阶段检索 pipeline,核心目标是将文本、图像、视频、视觉文档(如信息图表、截图)等异构数据映射到统一语义空间,实现高精度跨模态相关性匹配。
1. 核心定位与关键特性
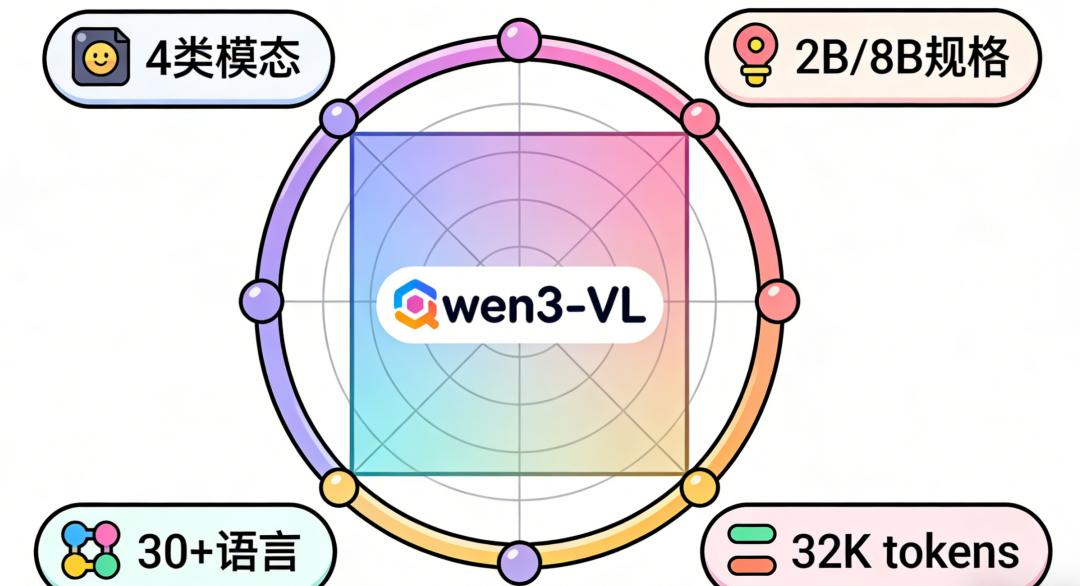
多模态覆盖:支持文本、图像、视频、视觉文档四类核心模态,可处理单一模态或多模态混合输入;
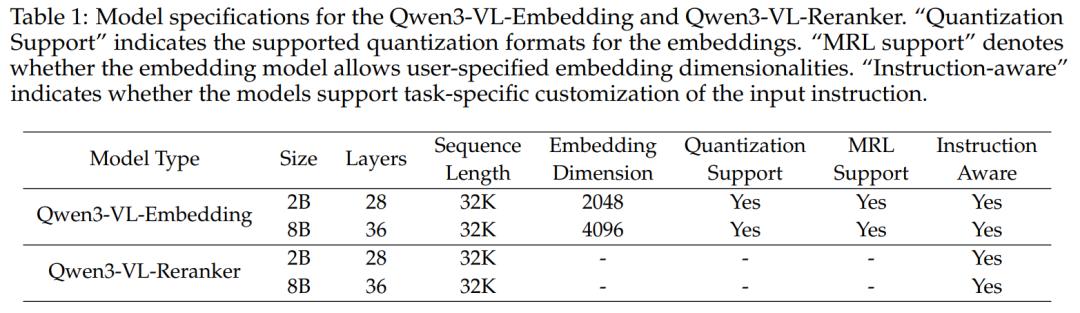
灵活部署:提供2B(20亿参数)和8B(80亿参数)两种规格,适配不同算力需求场景;
多语言支持:继承Qwen3-VL的multilingual能力,精准支持30种以上语言的多模态检索;
长序列处理:最大支持32768(32K)tokens输入,可完整处理长文档、长视频等复杂数据。
2. 整体架构设计
两个模型均基于Qwen3-VL基础模型的因果注意力架构,保留其世界知识与多模态感知能力,同时针对检索任务进行专项优化:
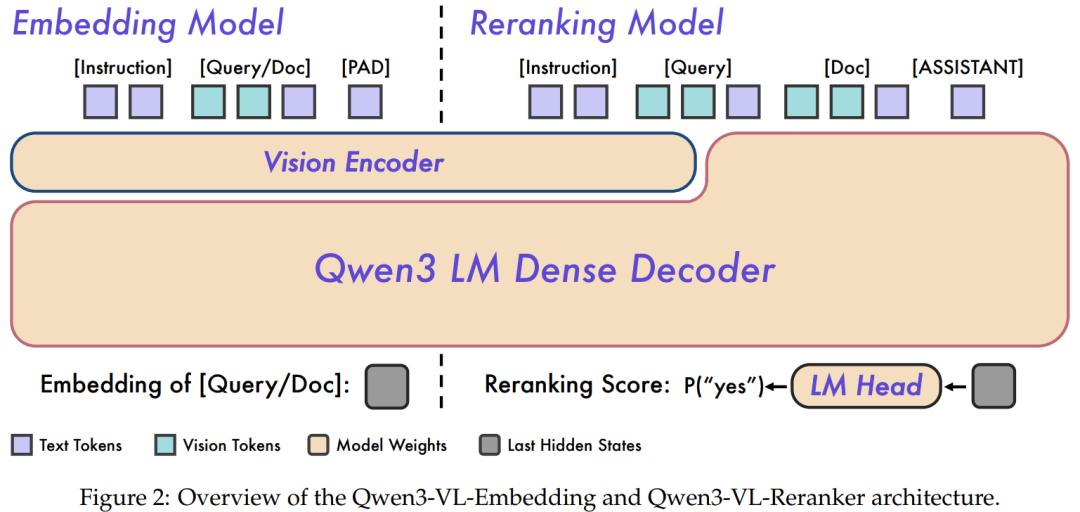
Qwen3-VL-Embedding:采用双编码器(bi-encoder)架构,通过余弦相似度衡量相关性,输出高密度语义向量;
Qwen3-VL-Reranker:采用交叉编码器(cross-encoder)架构,通过深度交叉注意力捕捉查询与文档的细粒度交互,输出精准相关性评分。
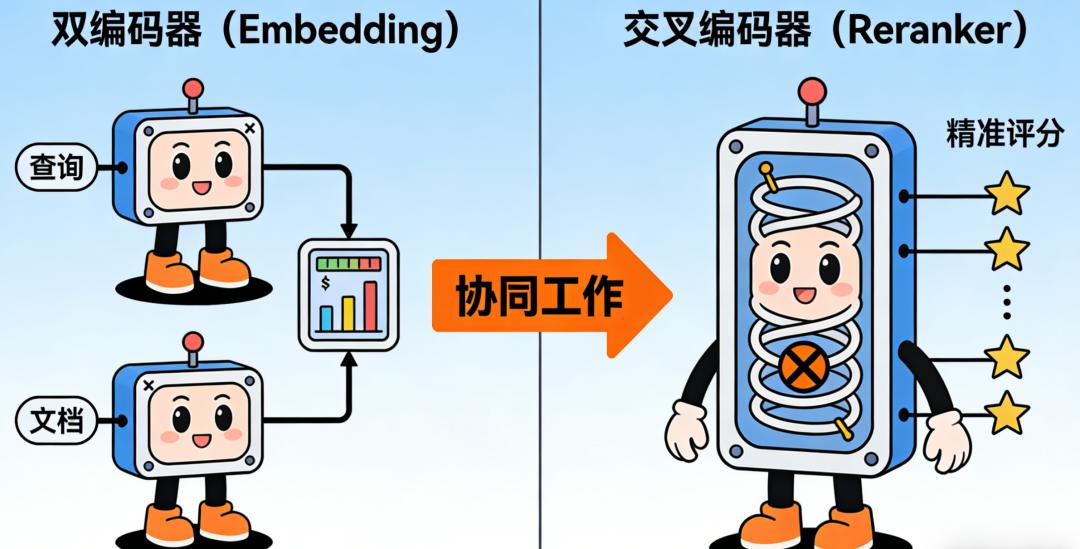
二者协同工作时,先由Embedding模型快速筛选候选集,再由Reranker模型进行精细化排序,在检索效率与精度之间实现最优平衡。
三、关键技术原理深度解析
1. 统一多模态表征空间构建
多模态检索的核心难题是“模态鸿沟”——不同模态数据的底层特征差异巨大,难以直接比较。Qwen3-VL-Embedding通过跨模态语义对齐技术,将四类模态数据映射到统一表征空间(如图1所示),其核心逻辑是:
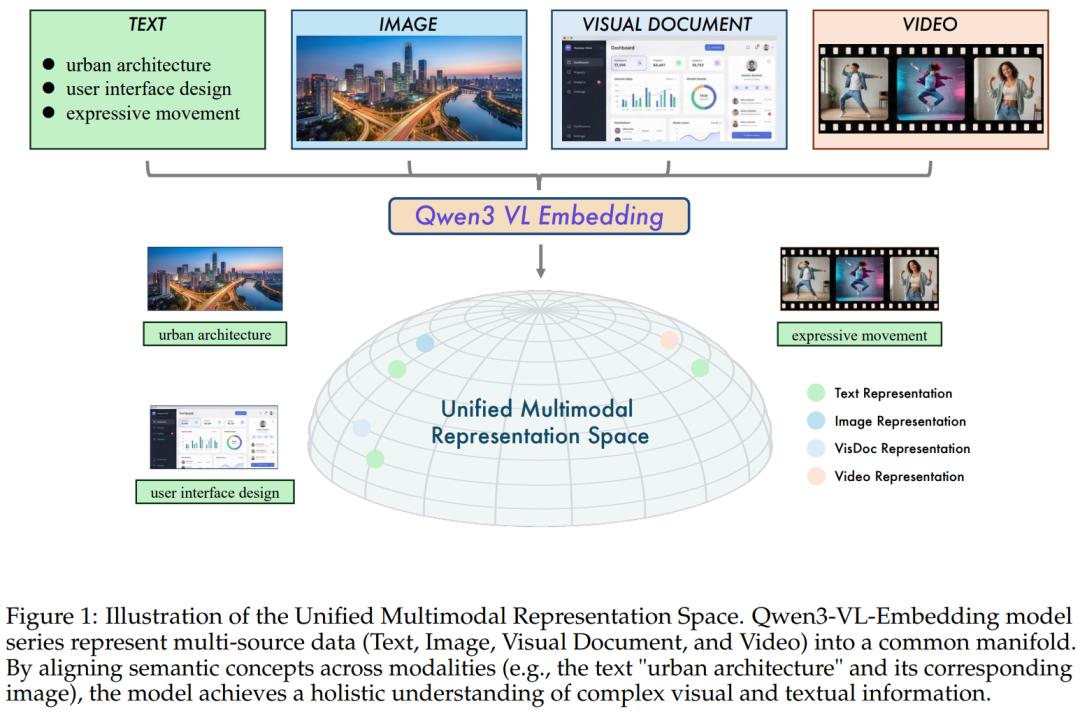
对文本数据采用Transformer文本编码器进行token级语义编码;
对图像/视觉文档采用视觉编码器提取空间特征,并与文本编码器输出进行跨模态融合;
对视频数据采用帧采样策略(1FPS,最大64帧),聚合帧级特征形成视频全局表征;
通过大规模跨模态对比学习,让“文本描述-对应图像-相关视频”在表征空间中形成语义聚类,实现跨模态语义对齐。
这种统一表征设计使得系统能够直接计算不同模态数据间的语义相似度,为跨模态检索提供基础。
2. 双模型核心技术细节
a. Qwen3-VL-Embedding:灵活高效的多模态表征生成
Matryoshka表示学习(MRL):突破固定嵌入维度限制,支持用户根据存储/算力需求灵活选择嵌入维度(如128、256、512、1024等),无需重新训练。训练时同时优化全维度嵌入与低维前缀,确保中间维度仍保持高检索性能;
量化感知训练(QAT):采用Learned Step Size Quantization(LSQ)策略,在训练过程中同时优化全精度与低精度(int8)嵌入,使模型生成的向量在量化后仍保持性能稳定,存储成本降低75%(int8 vs float32);
输入处理流程:采用Qwen3-VL上下文格式,通过系统指令指定任务目标(默认指令为“表征用户输入”),用户输入支持多模态组合,最终通过<<|endoftext|>token的最后隐藏状态生成嵌入向量。
b. Qwen3-VL-Reranker:细粒度相关性评估
点式排序方法:将重排任务转化为二分类问题,针对“查询-文档”对预测“相关(yes)”或“不相关(no)”,通过计算两个token的logits差异并应用sigmoid函数得到最终相关性评分;
交叉注意力机制:直接将查询与文档的多模态特征进行交叉编码,捕捉细粒度语义交互,相比双编码器架构更能识别“表面相似但语义无关”的负样本;
输入模板设计:通过系统指令明确相关性判断规则,用户输入包含任务指令、查询内容、文档内容三部分,支持多模态组合查询与文档输入。
c. 多阶段训练策略与数据优化
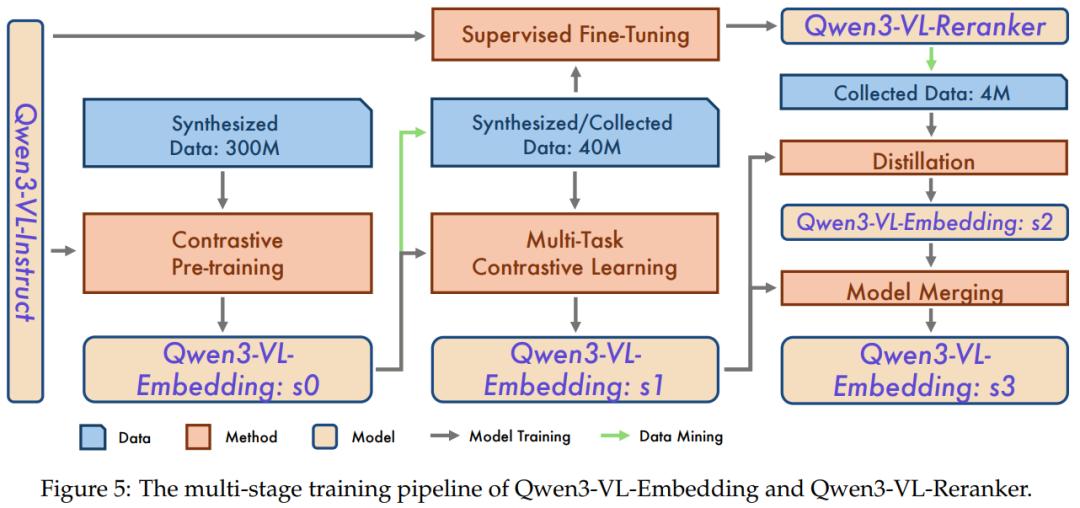
模型性能的突破离不开精细化的训练流程与高质量数据支撑,其核心训练框架分为三阶段:
1. 训练流程设计
阶段一:对比预训练:基于3亿规模多模态合成数据进行对比学习,采用InfoNCE损失函数,引入批量内负样本、硬负样本等多种负样本类型,初步构建跨模态语义对齐能力,得到基础模型s0;
阶段二:多任务对比学习与有监督微调:融合公开数据集、私有数据与抽样合成数据,针对检索、分类、语义文本相似度(STS)等任务设计专属损失函数,同时训练Embedding模型(得到s1)与Reranker模型,其中Reranker专注于检索类任务优化;
阶段三:蒸馏与模型融合:将Reranker的细粒度相关性判别能力通过知识蒸馏迁移至Embedding模型(得到s2),再通过模型融合技术将s2与多任务优化的s1合并,得到最终模型s3,平衡检索任务与分类、问答等任务的性能。
2. 数据质量保障机制
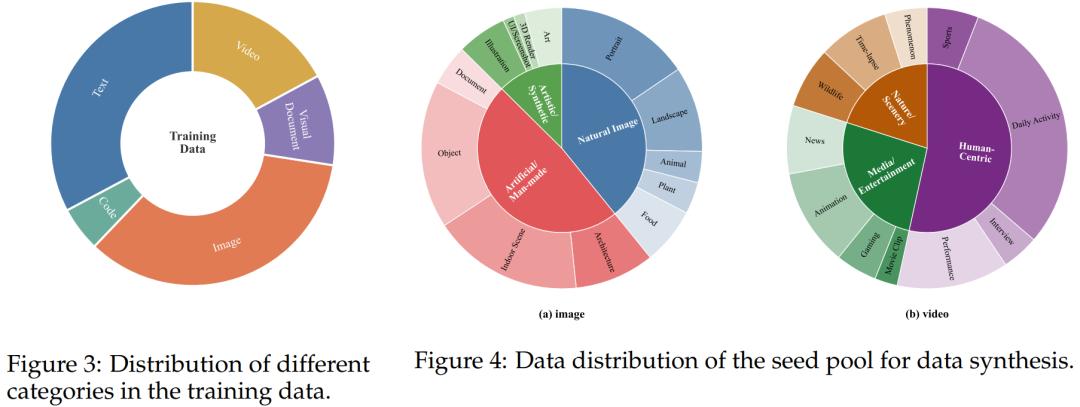
数据合成:基于Qwen3-VL-32B构建种子池(包含图像、视频高质量数据),针对图像分类、图像问答、视频检索、时刻检索等8类任务生成标注数据,确保模态与任务覆盖均衡;
正负样本挖掘:通过“召回-相关性过滤”两阶段流程,保留高置信度正样本(相似度得分高于阈值t⁺),筛选硬负样本(得分接近正样本平均得分但不相关),减少噪声数据对训练的影响。
四、技术创新亮点
1. 模态无关的统一表征方案
不同于传统“单模态表征+跨模态映射”的分段式设计,Qwen3-VL-Embedding从训练之初就采用多模态混合数据训练,使模型天然具备跨模态语义对齐能力,无需额外构建模态转换模块,大幅提升检索效率与精度。
2. 兼顾灵活性与效率的工程优化
Matryoshka表示学习与量化感知训练的结合,解决了多模态嵌入“存储成本高、部署难度大”的行业痛点。例如,在文本检索任务中,将嵌入维度从1024降至512时,性能仅下降1.4%,但存储成本降低50%,检索速度提升1倍。
3. 多阶段训练与知识蒸馏的协同优化
通过“预训练-微调-蒸馏-融合”的四步训练流程,既利用了大规模弱监督数据提升泛化能力,又通过强监督微调与知识蒸馏提升检索任务精度,同时通过模型融合避免单一任务优化导致的性能偏科。
4. 原生支持长序列与复杂模态
32K tokens的超长序列处理能力,使其能够直接处理长文档(如学术论文)、长视频(如64帧完整片段)等复杂输入,无需分段处理,避免语义信息丢失。
五、性能验证
Qwen3-VL系列模型在多项国际权威基准测试中展现出state-of-the-art(SOTA)性能,核心结果如下:
1. 多模态检索综合性能
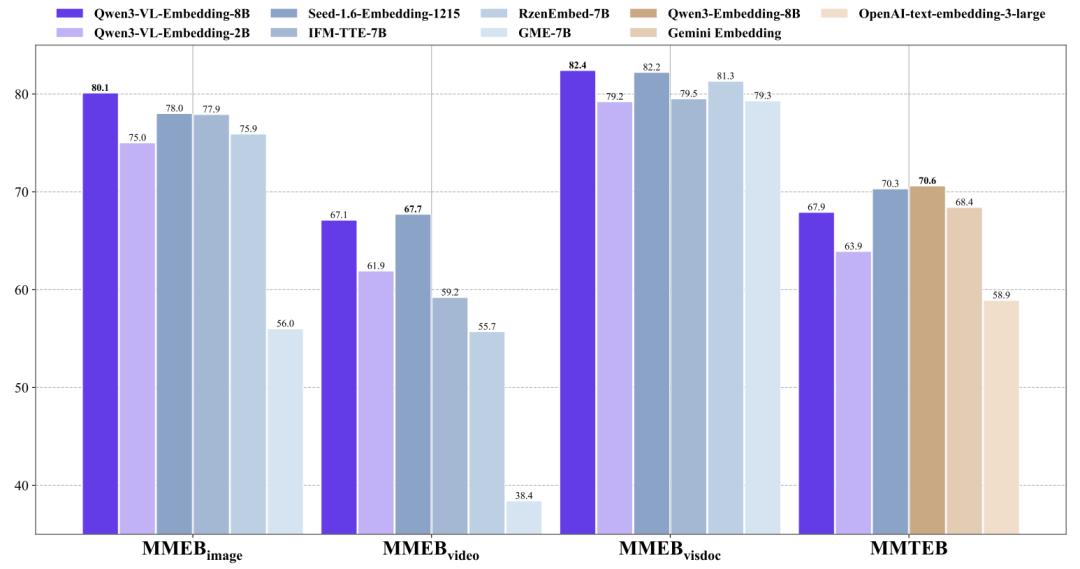
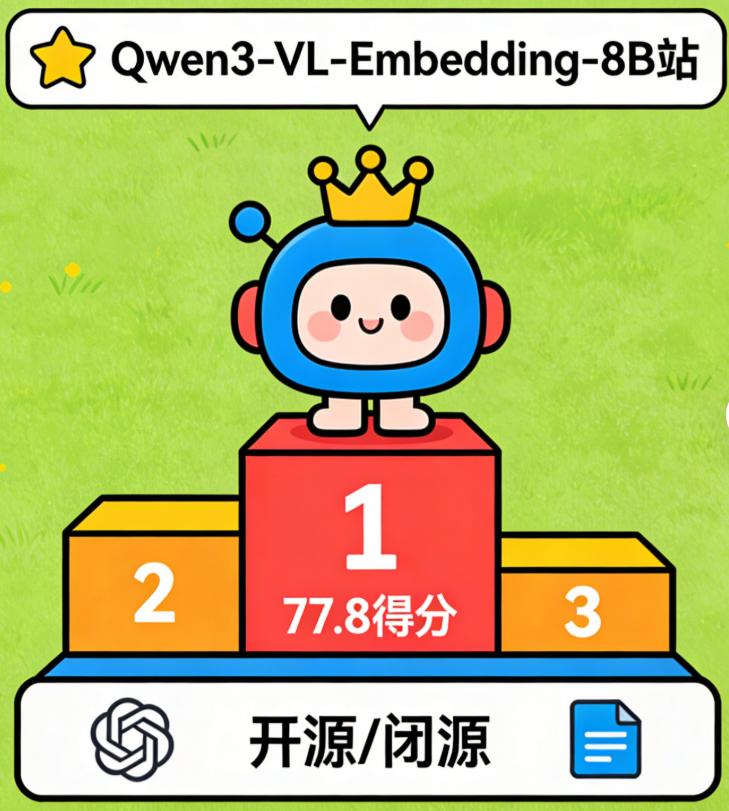
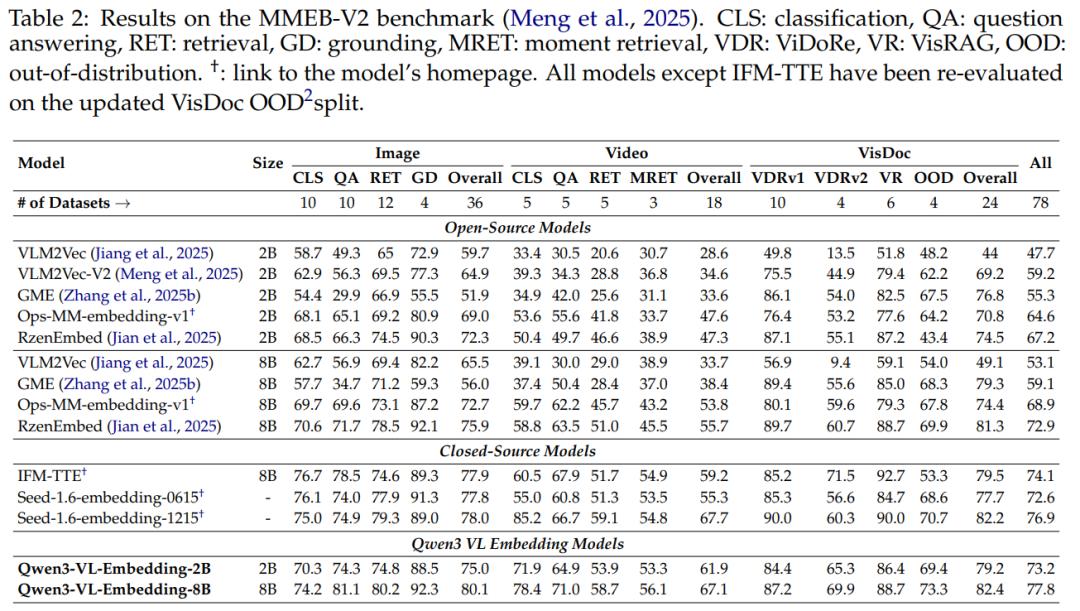
在MMEB-V2基准测试(涵盖图像、视频、视觉文档三大领域,78个数据集)中,Qwen3-VL-Embedding-8B取得77.8的综合得分,超越所有开源模型与闭源API服务(如IFM-TTE、Seed-1.6-Embedding),其中图像领域得分80.1,视频领域得分67.1,视觉文档领域得分82.4,展现出全场景优势。
2. 文本检索性能
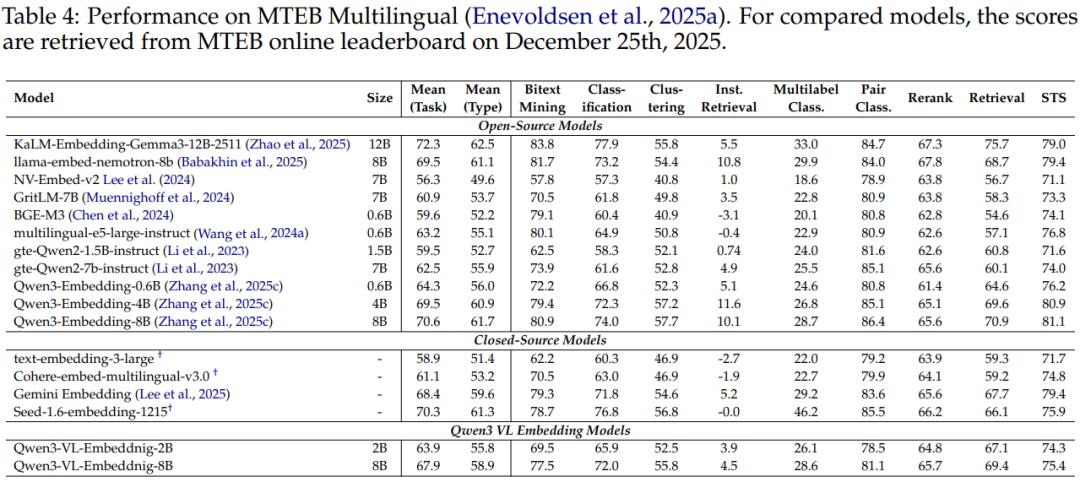
在纯文本检索基准MMTEB(多语言文本嵌入基准)中,Qwen3-VL-Embedding-8B取得67.9的平均得分,与同规模纯文本嵌入模型(如Qwen3-Embedding-8B)性能接近,证明其在保留多模态能力的同时,未牺牲文本检索精度。
3. 重排模型性能
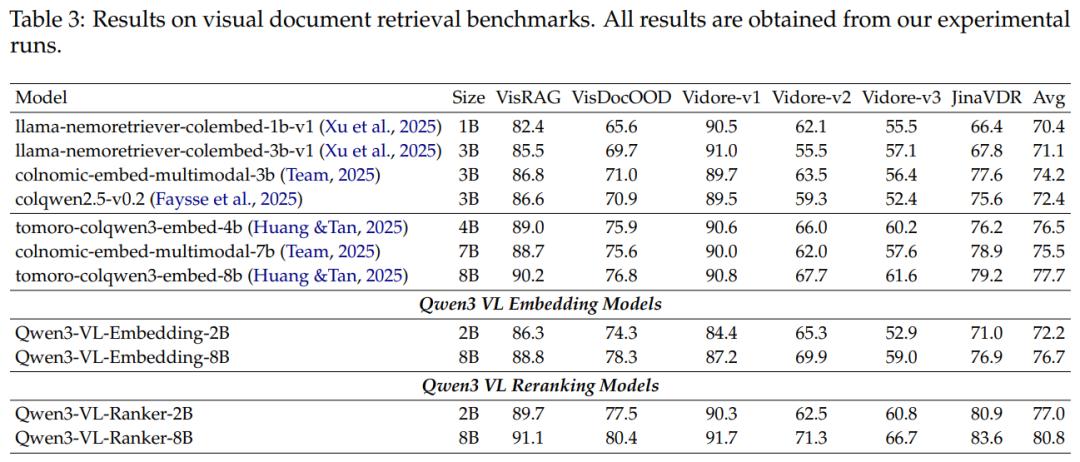
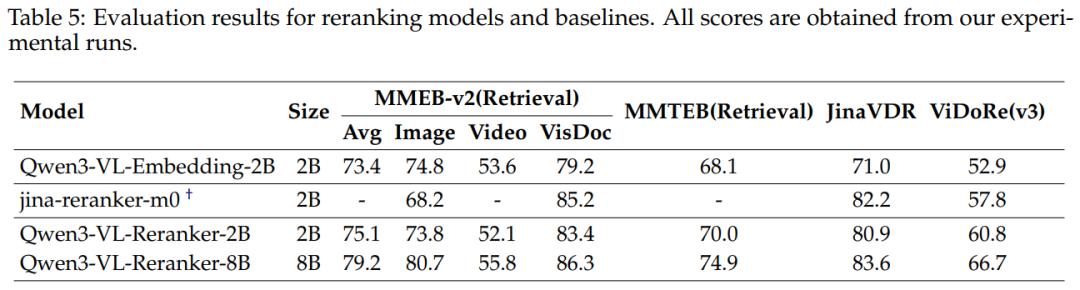
Qwen3-VL-Reranker-8B在MMEB-V2检索重排任务中取得79.2的综合得分,相比2B版本提升4.1个百分点,在视觉文档检索基准JinaVDR与ViDoRe-v3中,性能显著超越同参数规模的ColPali风格模型,展现出强大的细粒度相关性判别能力。
六、实际应用场景与价值
Qwen3-VL双模型系列的技术突破已在多个实际场景中展现应用价值:
电商产品检索:支持“文本描述搜商品图”“商品图搜相似视频”,提升跨模态商品匹配精度;
科学文献探索:实现学术论文(文本)与实验图表(视觉文档)、补充视频的跨模态关联检索,加速科研效率;
社交媒体导航:支持基于文本关键词检索相关图像、短视频,优化内容推荐与搜索体验;
企业文档管理:对企业内部的混合模态文档(如PDF报告、演示文稿截图、会议视频)进行统一检索,提升知识管理效率。
七、总结与展望
Qwen3-VL-Embedding与Qwen3-VL-Reranker通过统一多模态表征空间、灵活嵌入维度设计、多阶段训练策略三大核心创新,解决了多模态检索中的模态鸿沟、效率与精度平衡、复杂数据处理等关键问题,为多模态检索技术的工业化应用提供了成熟方案。
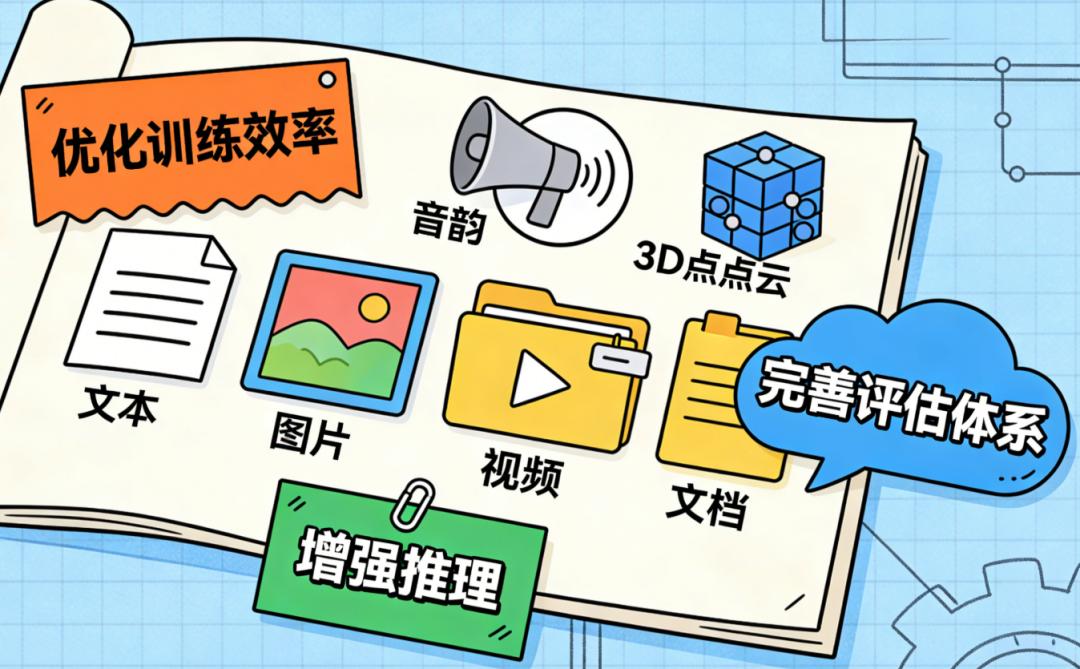
未来,该系列模型有望在以下方向进一步突破:扩展更多模态(如音频、3D点云)支持、优化训练效率以降低算力成本、增强组合推理能力、构建更全面的多模态检索评估体系。随着技术的持续迭代,多模态检索将在更多行业场景中实现规模化落地,推动信息检索从“文本主导”向“多模态融合”转型。
这篇论文最打动我们的,是它没有追求“炫技式创新”,而是从科研和产业的实际需求出发,解决了多模态检索中最核心的“对齐不准”和“落地成本高”两大痛点。多阶段训练让模型兼顾泛化性和精度,MRL+QAT设计让高性能模型能真正部署落地,统一表示空间则打通了四种模态的语义壁垒。
对于科研人员来说,它提供了一套可复现的多模态检索框架——从数据合成、硬负样本挖掘到模型蒸馏,每一步都有详细的实验设计,尤其是用合成数据解决数据不平衡的思路,值得低资源场景研究借鉴。对于产业界来说,2B和8B两种参数规模、灵活的嵌入维度、量化友好的特性,让不同资源的团队都能找到适合自己的方案,不用再为“性能”和“成本”做两难选择。
最后想问大家:你们在做多模态检索时,是否遇到过模态对齐不准或存储成本过高的问题?欢迎在评论区分享你们的解决思路,也可以交流这篇论文的复现经验~
参考资料
标题:Qwen3-VL-Embedding and Qwen3-VL-Reranker: A Unified Framework for State-of-the-Art Multimodal Retrieval and Ranking
作者:Mingxin Li, Yanzhao Zhang, Dingkun Long, Keqin Chen, Sibo Song, Shuai Bai, Zhibo Yang, Pengjun Xie, An Yang, Dayiheng Liu, Jingren Zhou, Junyang Lin
单位:Tongyi Lab, Alibaba Group
链接:https://arxiv.org/pdf/2601.04720