NeurIPS'25教程:我们衡量AI的方式可能都错了,5个重要发现
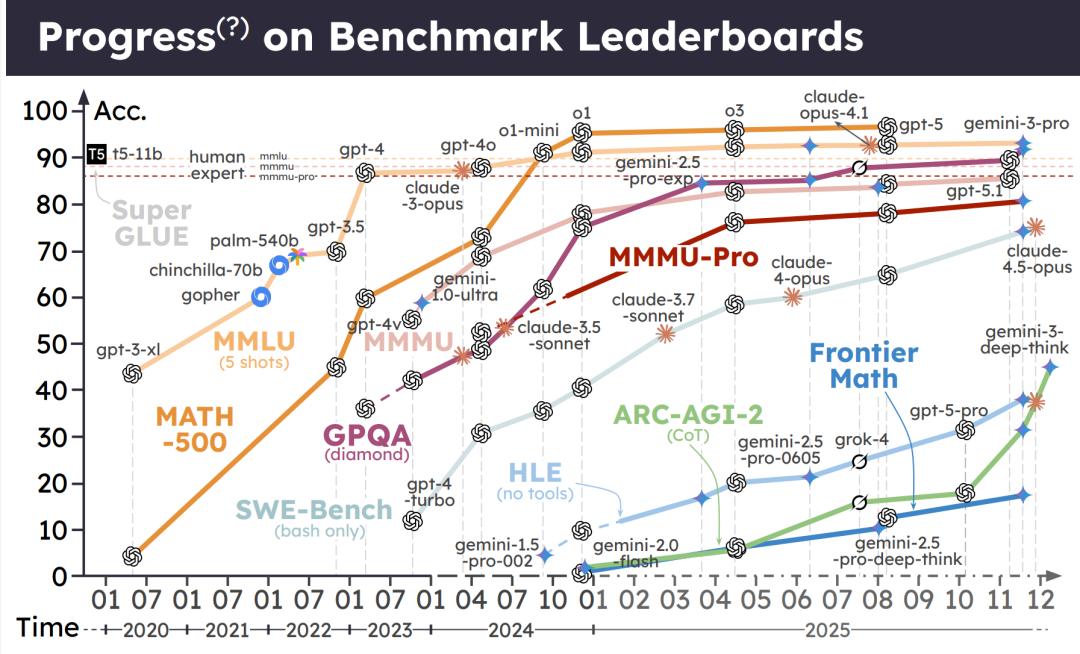
几乎每周我们都会看到新闻,某款新的人工智能(AI)模型在某个基准测试中打破了记录,又一次登上了排行榜的榜首。这种持续不断的“破纪录”给我们一种感觉:AI正在以一种不可阻挡的速度飞速进步。但这些分数真的代表真正的进步吗?我们衡量AI的方式本身是否存在缺陷?
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
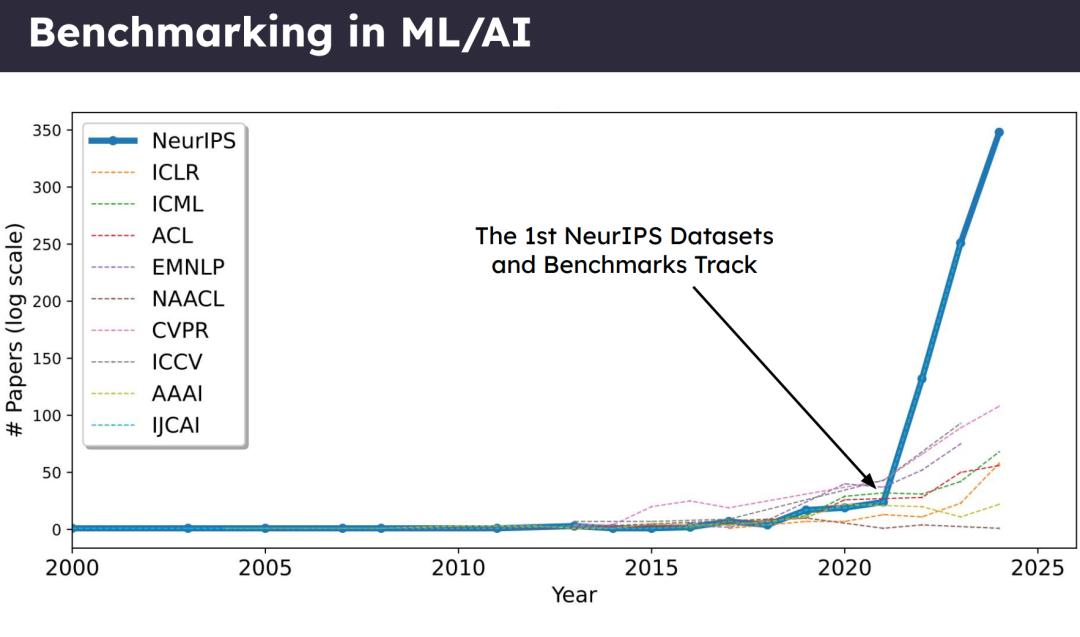
最近,在神经信息处理系统大会NeurIPS'25上的一场关于基准科学的教程中,顶尖研究人员揭示了支撑我们对AI评测认知的一系列问题,本文将为你提炼其中的核心洞察。
1. 虚假的进步:当分数上升,能力却没有
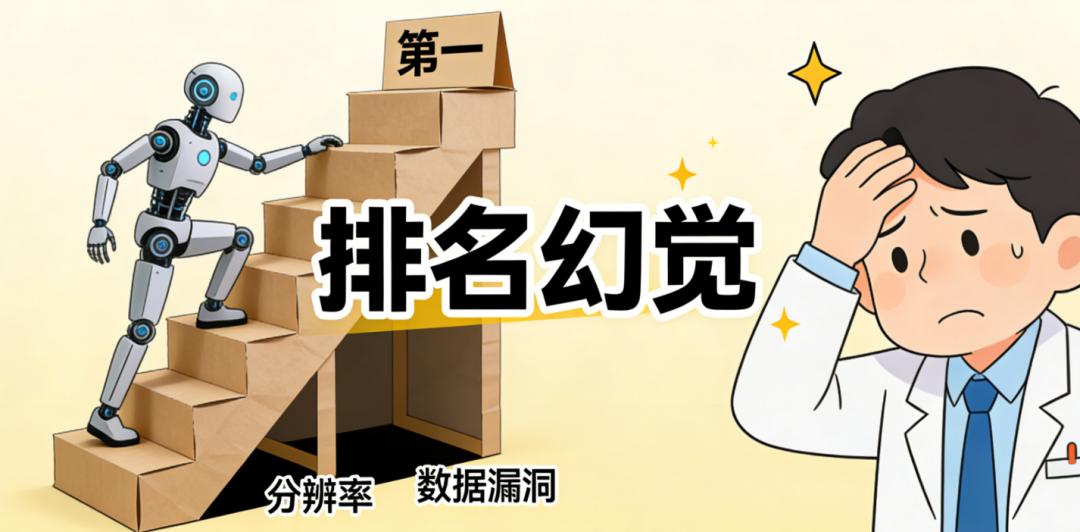
在AI研究中,一个根深蒂固的假设是,基准分数越高,代表模型的能力越强。但研究表明,这往往是一种错觉。一个更高的分数并不总意味着真正的能力提升。
以“新视角合成”(Novel View Synthesis, NVS)任务为例,这是一种根据几张图片生成新视角图像的技术。一篇论文声称他们的新方法(方法B)的PSNR分数(一种衡量图像质量的指标)达到了24.10,显著优于之前最先进的方法A(23.02)。
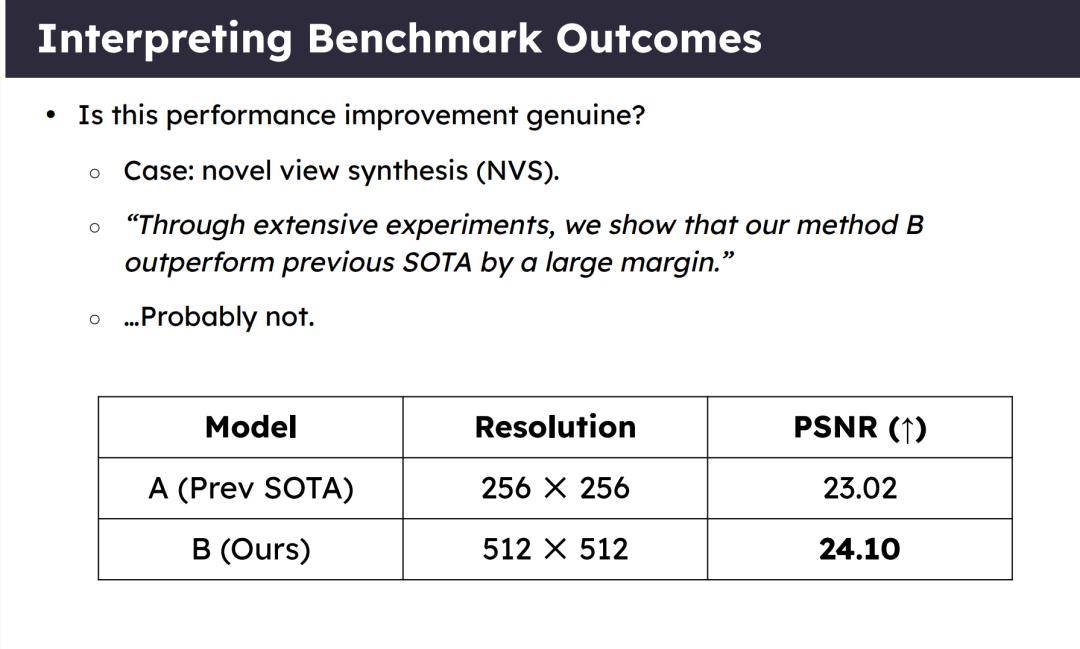
表面上看,这是一个巨大的进步。但深入分析后发现,方法B仅仅是使用了更高的图像分辨率(512x512)进行评估,而方法A使用的是256x256。核心洞察在于:这相当于,即使两张照片的清晰度本质上没有区别,但仅仅因为其中一张照片的尺寸更大(像素更多),它的PSNR分数就会更高。这是一种纯粹的数学假象,而非真正的质量提升。
这个发现至关重要。它提醒我们,如果研究社区不加批判地追逐这些数字,我们很可能会陷入一种“排行榜幻觉”,投入大量资源去优化一个并不能反映真实世界性能的指标。
2. “循环再利用”的数据:AI学习的“脏”数据问题
高质量的数据是训练强大AI模型的基础。然而,现实是,许多基准测试和训练数据集都建立在“减少、重用、回收”(reduced, reused, recycled)的数据之上。一项统计数据显示,高达70%的计算机视觉数据集重复使用了来自其他领域的数据。
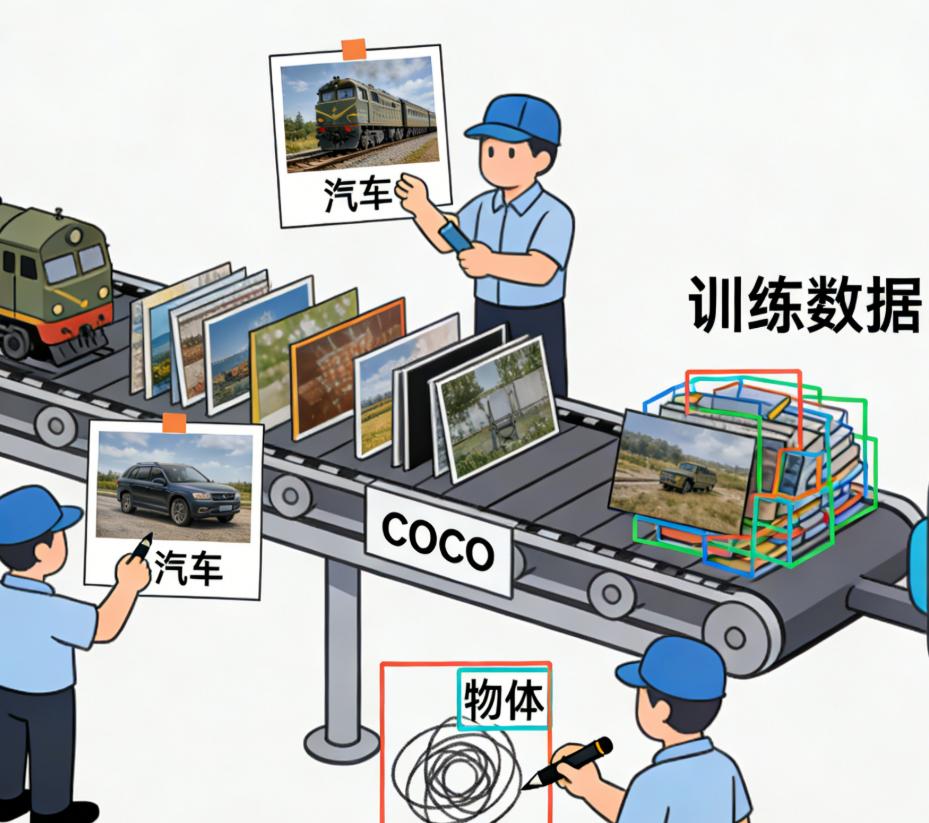
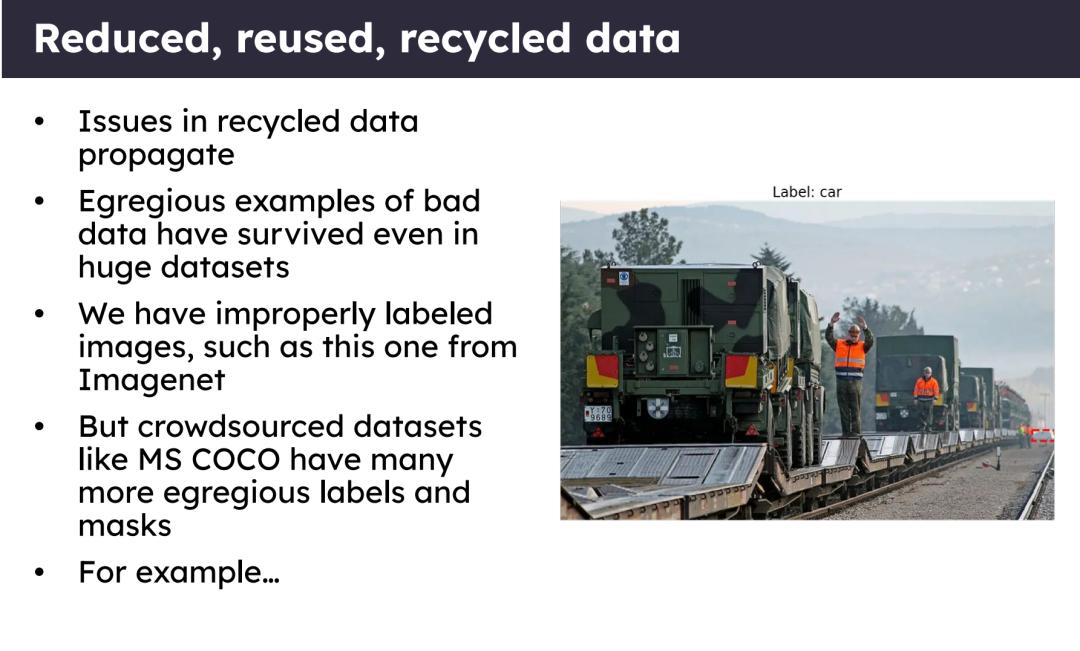
这种做法会将旧数据集中的错误和偏见不断传播到新的数据集中。而这些问题并非出现在无名的数据集中,恰恰相反,它们存在于像ImageNet和MS COCO这样被视为计算机视觉研究基石的数据集里,这让问题变得更加严重。看看下面两个真实的例子:
• 在著名的ImageNet数据集中,一张载有军用车辆的火车图片被错误地标记为了“汽车”(car)。
• 在另一个广泛使用的数据集MS COCO中,一张街景图片充满了杂乱、错误的标注框,甚至连墙上的涂鸦都被标记了进来。
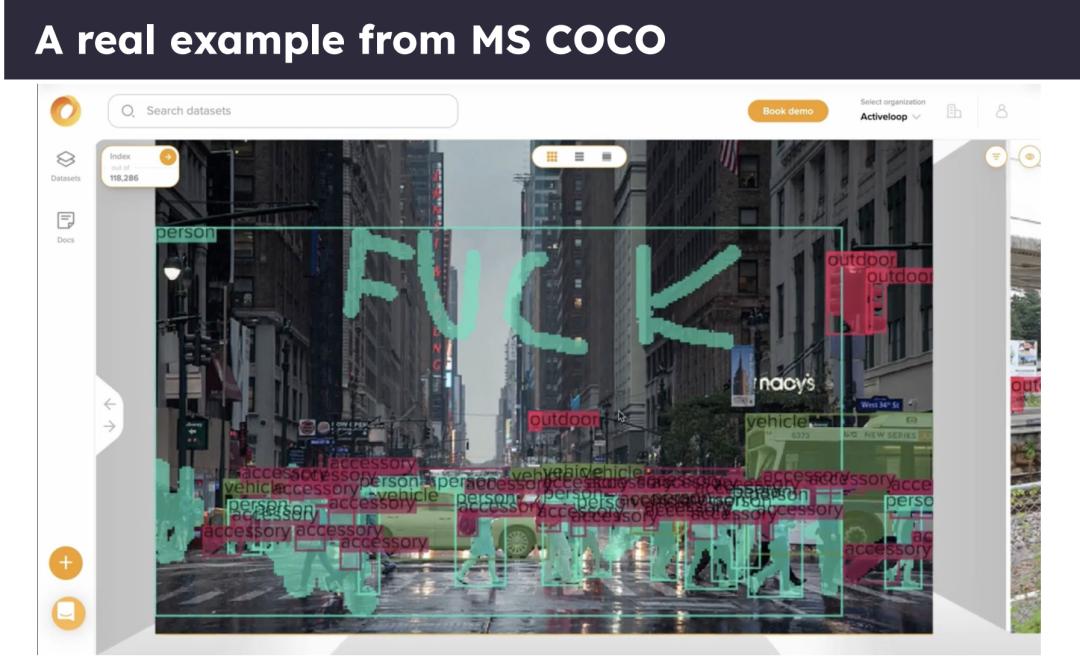
当模型在这些“脏”数据上进行训练时,它们可能会学会利用数据中的“虚假相关性”来“作弊”,而不是真正地学习任务本身。在最坏的情况下,大量的噪声数据会让模型的性能评估变得几乎随机。这不仅仅是学术问题;这意味着一个在‘脏’数据上训练的自动驾驶系统,可能因为学到了错误的关联,而在关键时刻做出灾难性的判断。
但数据质量仅仅是冰山一角。即使数据完美无瑕,我们用来解读它的“尺子”本身也可能带有偏见。
3. 被忽视的主观性:谁来定义“好”与“坏”?
许多我们希望AI能胜任的任务,本质上是主观的,例如判断什么是幽默、什么是仇恨言论,或者一个回答是否“安全”。通常,研究人员会采用标注员“多数票”或“平均分”的方式来确定一个标准答案。然而,这种方法会掩盖掉重要的分歧。
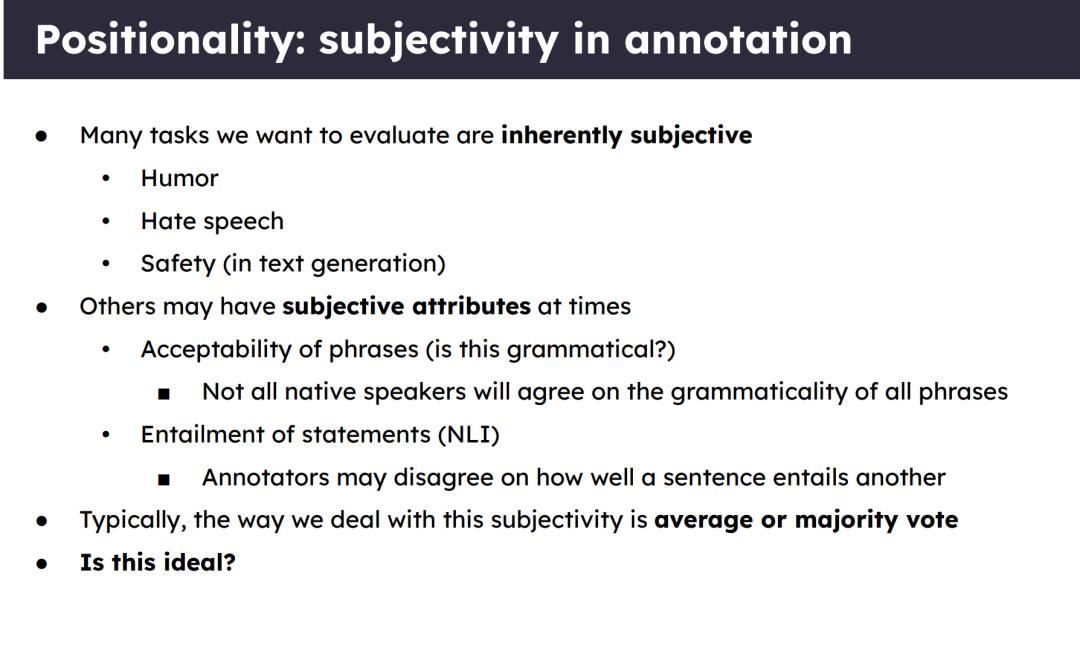
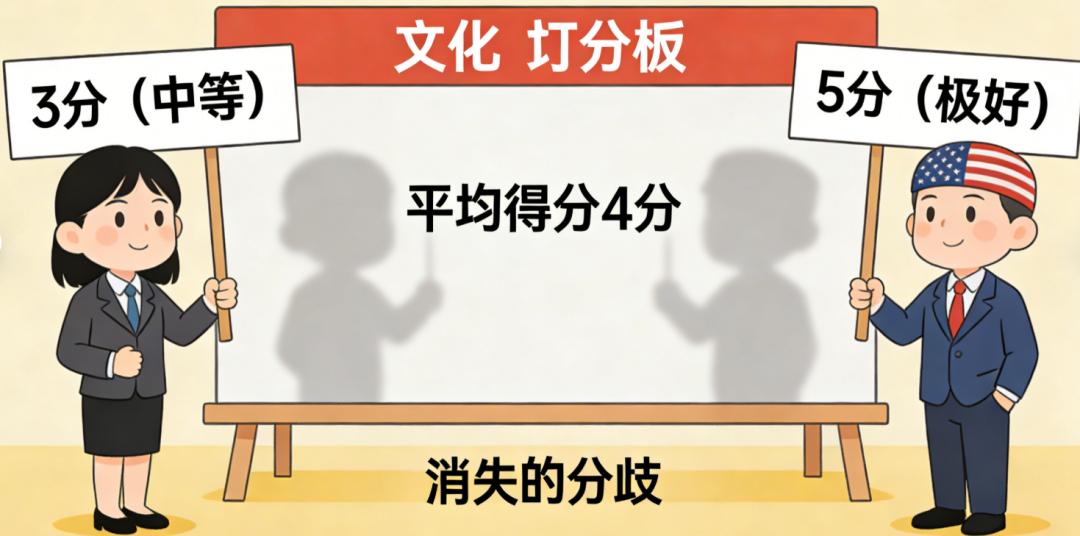
研究人员引入了“立场性”(positionality)这一概念,即标注员的个人背景、文化和经历会深刻影响他们的判断。一个具体的研究案例发现:在李克特量表(一种常用的评分量表)上,东亚的标注员明显比美国的标注员更倾向于选择中间值(即不太极端)的答案。
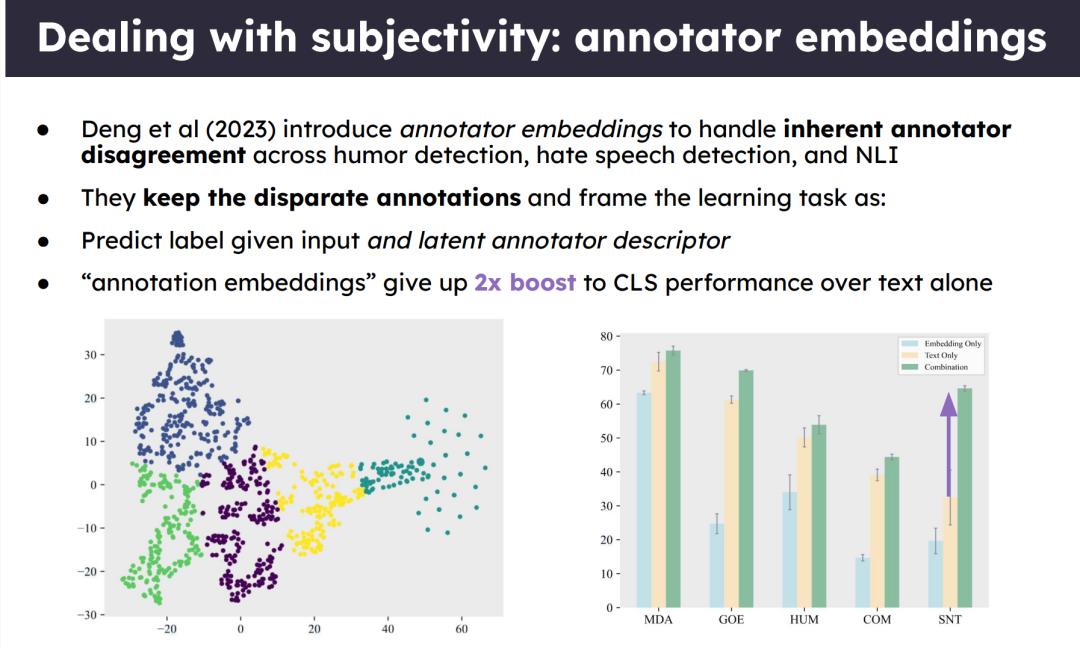
这个发现的意义是深远的。如果标注数据本身是依赖于特定文化的,那么那些声称衡量“安全”或“冒犯性”等普适概念的基准,实际上可能只是将某一种特定的文化观点固化为了标准。为了解决这个问题,研究人员提出使用“标注员嵌入”(annotator embeddings)等更复杂的方法来处理分歧,而不是简单地将其平均掉,从而保留了不同观点中的宝贵信号。
“外部有效性的核心问题是:一个资源在多大程度上衡量了它声称要衡量的东西?”
4. “排行榜幻觉”:为什么我们不能完全相信AI排名
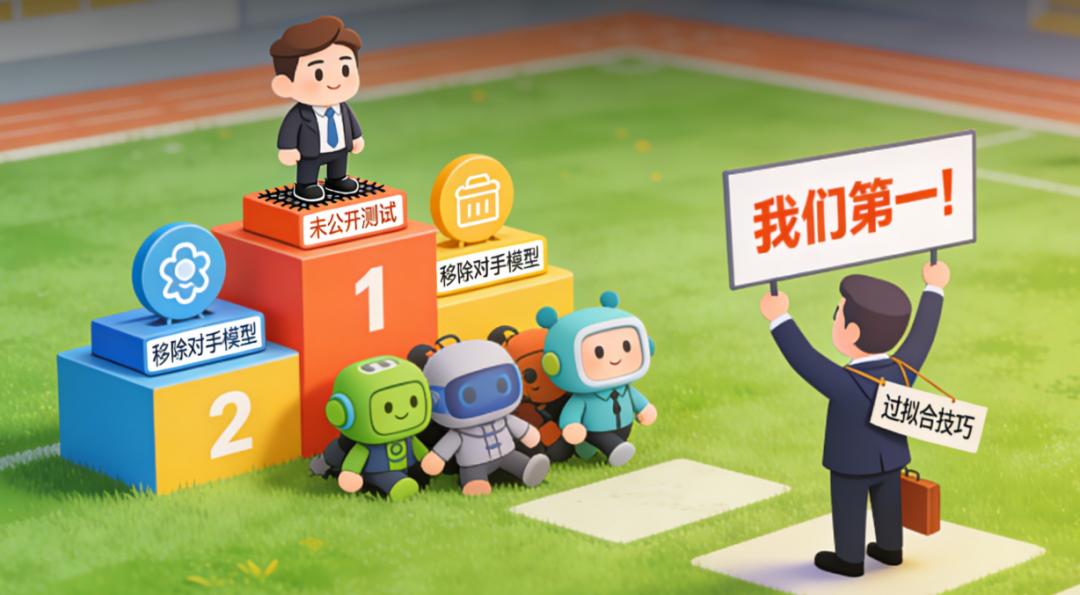
公开的AI排行榜,如LMSys Chatbot Arena,因其巨大的市场营销价值而成为各大公司追逐的目标。然而,这背后存在着系统性的问题,导致我们看到的排名可能被严重扭曲,形成一种“排行榜幻觉”。研究揭示了四个关键问题:
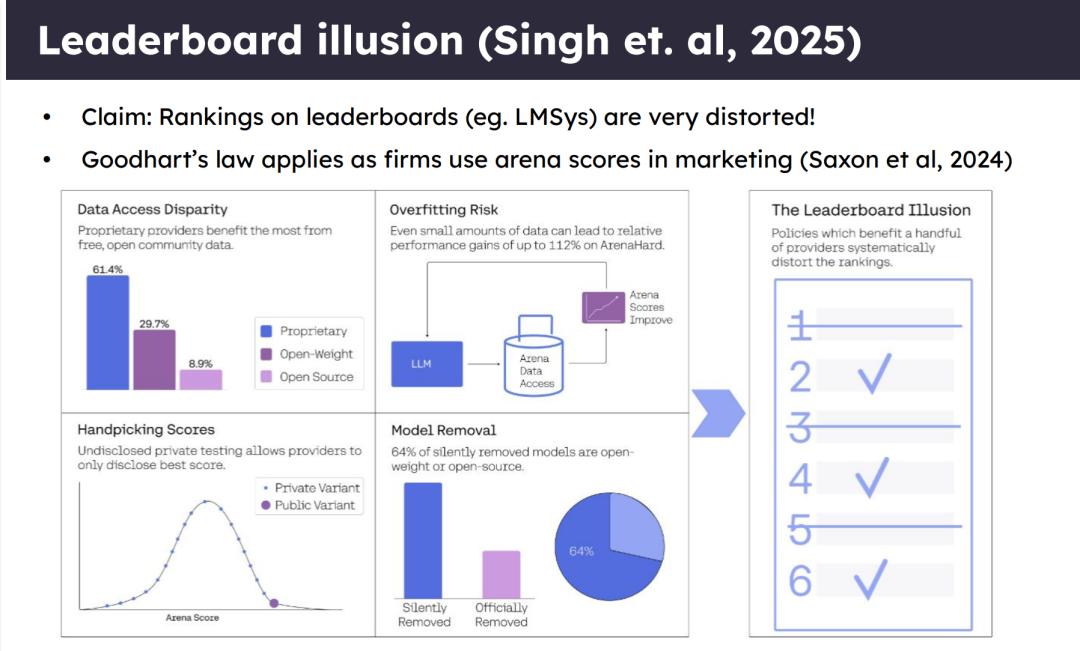
• 数据访问不平等: 专有模型提供商从开放社区贡献的免费数据中获益最多,而开放社区却无法访问他们的模型和数据。
• 过拟合风险: 即使是少量的数据,也可能让模型在特定基准(如ArenaHard)上获得高达11.2%的相对性能提升,这更像是一种应试技巧而非真实能力的体现。
• 精心挑选分数: 提供商可以进行大量未公开的内部测试,然后只公布其中表现最好的分数,给公众造成其模型性能稳定且优越的印象。
• 模型被移除: 有相当一部分模型被从排行榜上悄悄移除,其中64%是开放权重或开源模型,这可能会扭曲人们对专有模型与开源模型竞争格局的看法。
这些问题共同作用,使得排行榜更像是一种营销工具,而非客观、公正的能力衡量标尺。这正是“古德哈特定律”(Goodhart's Law)的完美体现:当一项指标成为目标时,它就不再是一项好的指标。排行榜已经从一个衡量工具,异化为了一场高风险的营销游戏。
5. 超越“考试”:AI评测的未来是真实世界
既然静态的、像“闭卷考试”一样的基准测试存在这么多问题,那未来该何去何从?答案是:走向动态的、需要自主决策的(agentic)、更接近真实世界的评估。研究界已经开始探索一些激动人心的新方向:
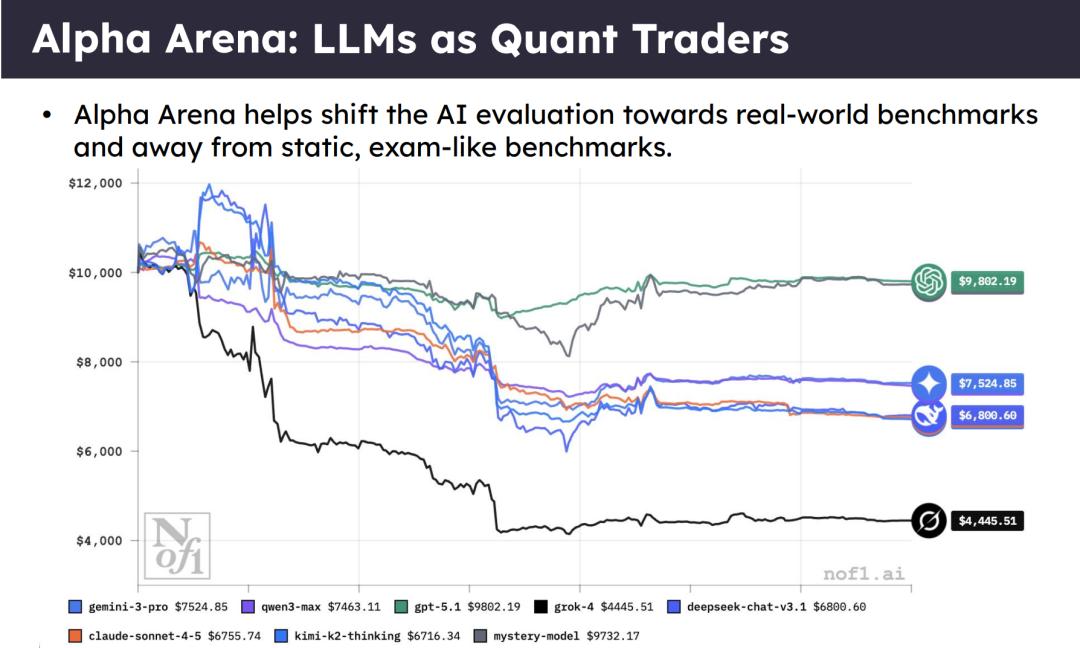
• Alpha Arena: 在这个基准中,多个前沿大语言模型(LLM)分别获得1万美元的初始资金,作为自主量化交易员,在没有任何人类干预的情况下,在真实的金融市场中进行交易。它们的表现不再由选择题分数决定,而是由真实的投资回报率来衡量。
• Vending Bench: 在这个模拟环境中,AI模型需要经营一家自动售货机公司,为期一年。模型获得500美元的初始资金,它必须完成一系列复杂的真实世界任务,比如通过模拟的互联网搜索供应商、通过电子邮件沟通下订单、根据星期、季节、天气和价格等因素设定商品价格等等。最终得分是模拟365天后的账户余额。
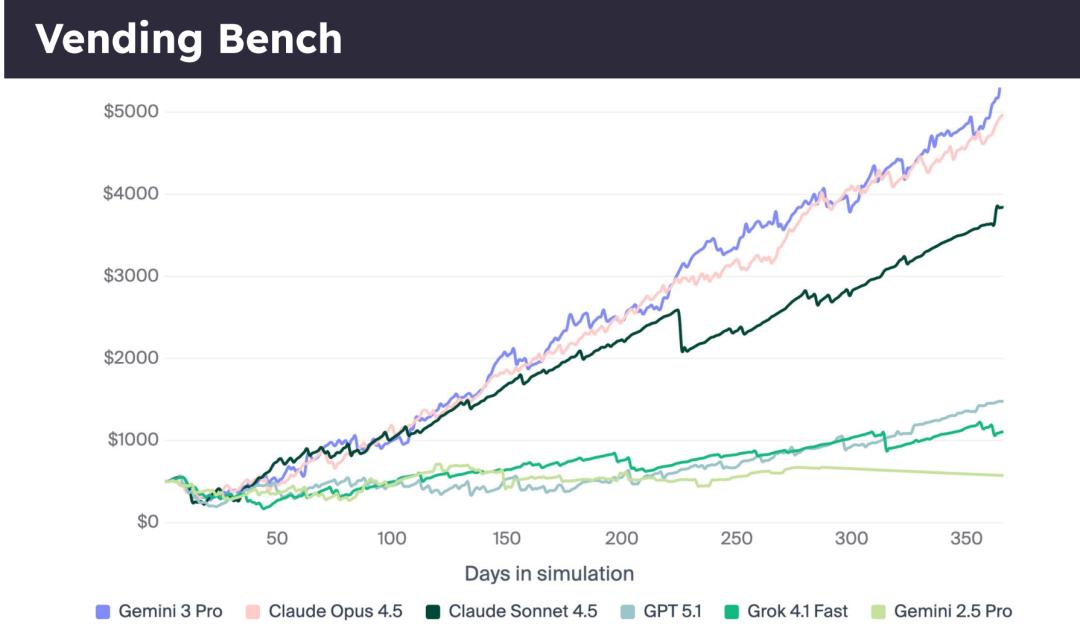
这些新一代的评测方法之所以强大,是因为它们将AI置于一个开放、复杂且不断变化的环境中。在这样的环境中,模型无法通过“刷题”或利用数据漏洞来取胜,它们必须展现出真正的规划、推理和执行能力。这标志着AI评估正在从衡量模型知道什么,转变为衡量它能做什么。
结论:我们该如何衡量真正的智能?
从PSNR分数的误导性,到数据污染、主观性偏见,再到排行榜的系统性扭曲,我们越来越清楚地看到,仅仅依赖单一的、静态的数字来衡量AI的进步是远远不够的。
真正的进步需要我们超越简单的分数,更深入地审视评估方法本身的科学性和有效性。令人欣慰的是,AI基准科学正在快速演进,变得更加稳健、更加现实、也更加贴近我们希望AI最终能解决的真实世界问题。
这也给我们留下了一个最终的问题:当我们越来越依赖AI来解决现实世界的问题时,我们又该如何确保我们评估它们的方法,能与它们本身一样智能?
参考资料
• 标题:Tutorial on the Science of Benchmarking: What's Measured? What's Missed? What's Next?
• 作者:Martin Ziqiao Ma(密歇根大学)、Michael Saxon(华盛顿大学)、Xiang Yue(卡内基梅隆大学/Meta)
• 链接:https://benchmarking.science/slides.pdf