Science Robotics | 机器狗模仿昆虫“侧视”晃脑袋,17毫秒看穿草丛后的背景
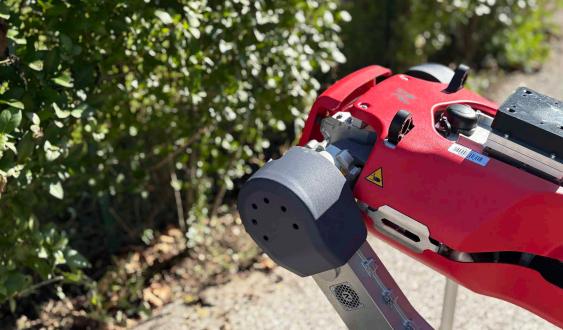
“ 不用昂贵的激光雷达,也不用相机阵列,只要让机器狗像蝗虫一样左右晃一晃,就能看清被枝叶挡住的背景。
在森林、灾害废墟、废弃厂房这类环境里,探索机器人常常要面对同一个麻烦:枝叶、栅栏、杂草这些前景遮挡物,会严重干扰机器人的视觉传感器,让它看不清背景里到底有什么。
在最近一期 Science Robotics 上,来自奥地利约翰·开普勒大学林茨分校、意大利博尔扎诺自由大学、特伦托大学以及英国萨塞克斯大学的联合团队给出了一个颇具启发性的思路:让四足机器人模仿昆虫,做出有节奏的左右晃动。
这个动作在生物学上有个专门名字,叫 "peering"(侧视)。论文标题也很直白——How robot dogs see the unseeable(机器狗如何看见看不见的东西)。
01.
从蝗虫的"侧视",到光学合成孔径
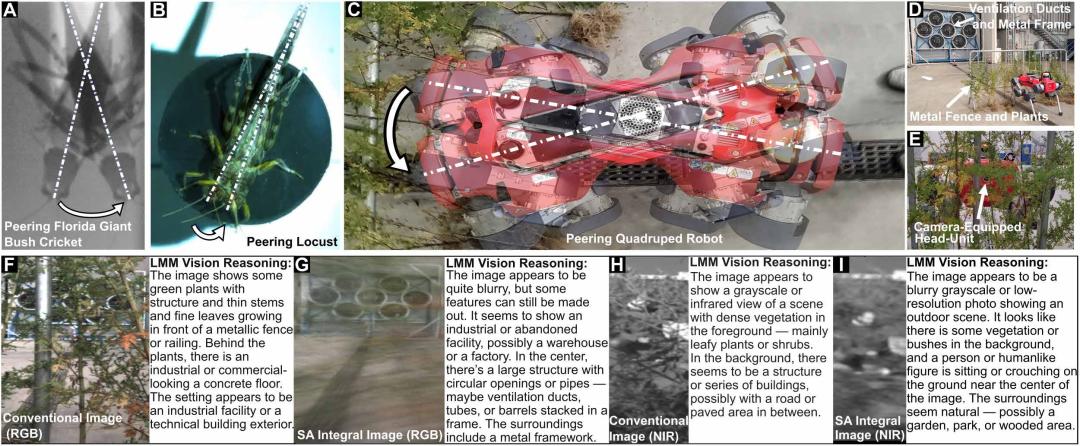
先说这个动作的来源。螳螂、马头蚱蜢、蝗虫、蟋蟀等昆虫在捕食或起跳前,会做出特征性的左右侧向身体运动。这些昆虫的立体视觉能力有限、作用距离短,它们靠这种运动制造"运动视差"——近处物体与远处物体产生相对位移,从而判断距离。以蝗虫为例,它的腿部运动会带动身体绕腹部转动,产生头部的侧向位移,同时头部反向旋转以保持眼睛朝向稳定。
不过论文明确指出,peering是否也能帮助动物看穿遮挡(比如透过树叶发现猎物),此前尚未被研究过。
研究团队所做的,是在视觉感知中的peering与光学成像中的合成孔径(Synthetic Aperture,SA)传感之间建立起联系。
原理是这样的:典型机器人相机的光圈通常不到1毫米宽,且为固定焦距,景深很大——这意味着近处和远处的物体会同样清晰。这一设计对视觉里程计等任务有利,却带来一个根本限制:前景中任何遮挡物都会和背景一样清晰,从而挡住背景目标。
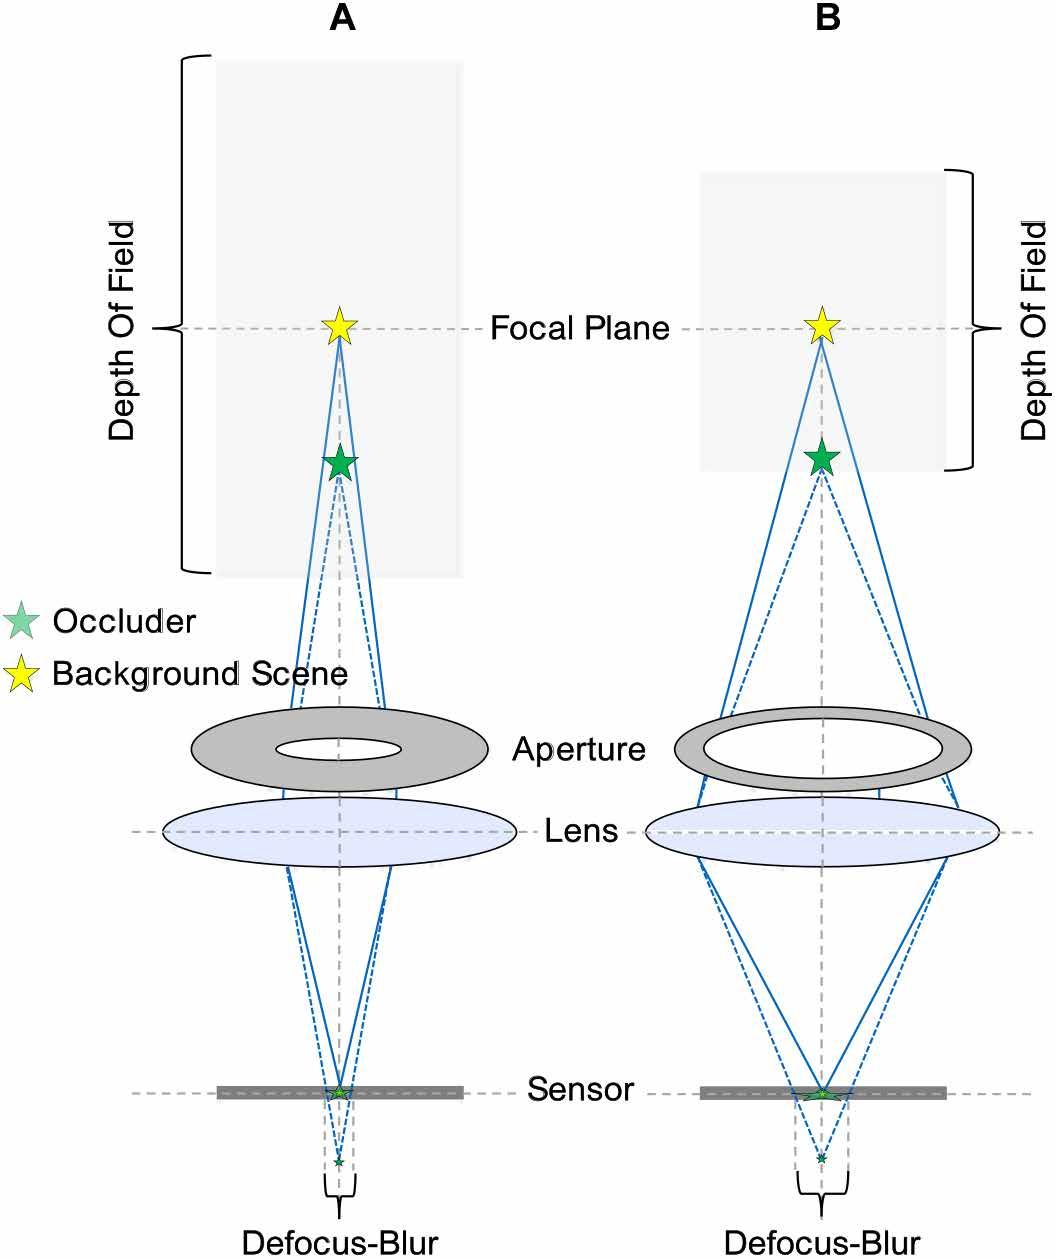
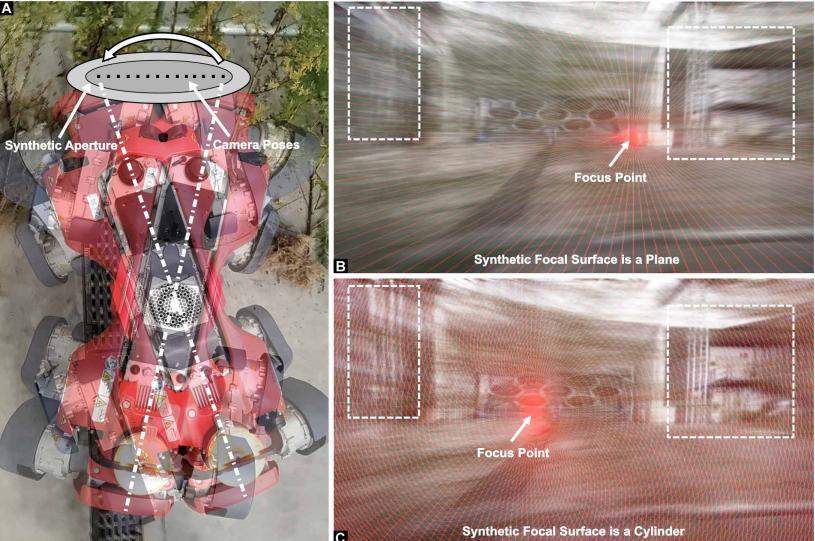
合成孔径传感的思路则相反:当相机在移动中,于不同位置连续采集一系列图像,再借助精确的相机位姿,把这些图像投影并平均到一个合成焦面上,就能在计算上合成出一个远大于物理光圈的"虚拟孔径"。
其结果是景深变得极浅:焦面附近的背景信号被增强,而不在焦面上的遮挡物则被叠加成失焦模糊而消失。论文说明,这个焦面可以是平面、圆柱面、球面等形状,能在三维空间里缩放、平移、旋转以贴合背景区域,也可以扫过所有深度以同时获得整个体积的对焦。
整个过程只需投影与平均,计算高效,可在移动处理器上实时运行,而且与波长无关,适用于可见光(RGB)、热红外(FIR)、近红外(NIR)等多种光谱。
论文同时援引此前的统计分析指出,合成孔径去遮挡的效果在约50%遮挡度时最佳,随遮挡密度升高而下降;合成孔径的尺寸不必很大,采样数量也不必极高,但都不能欠采样。
02.
为什么主流3D视觉方法在遮挡下会失效
一个自然的疑问是:既然三维重建方法如今已相当成熟,为何不直接用它们去遮挡?
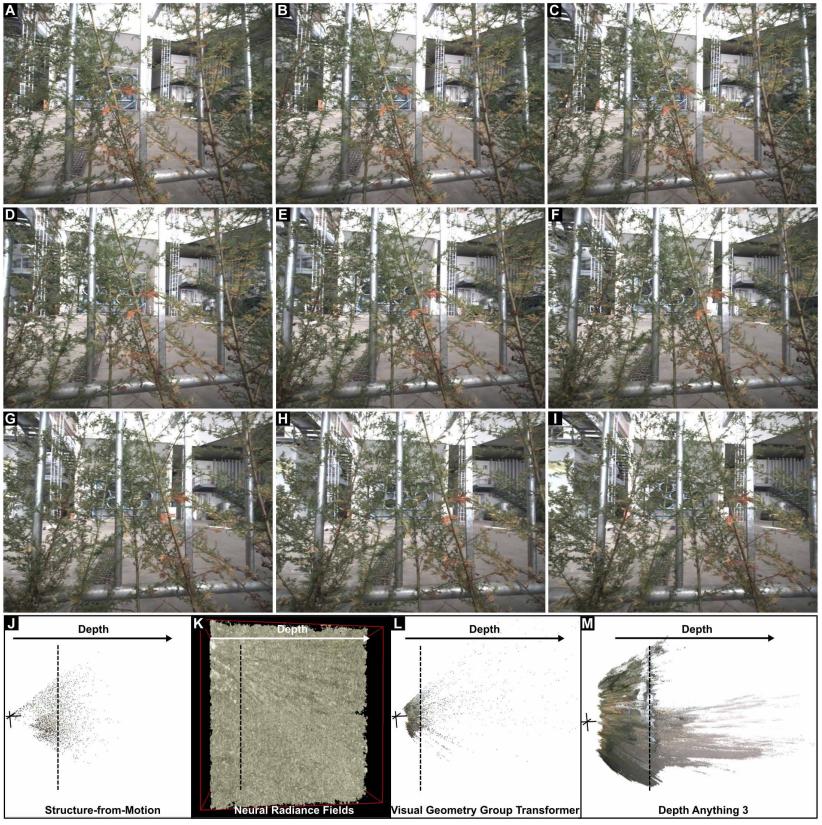
团队对此做了验证。他们把广角RGB peering实验采集的300张图像,分别输入四种当前最先进的3D视觉方法:Structure-from-Motion(SfM)、神经辐射场(NeRF)、VGGT,以及Depth Anything v3(DA3)。
结果显示,SfM、VGGT和DA3重建出的点云主要由前景遮挡物构成,NeRF则生成了大量不连贯的噪声,而被遮挡的背景(通风管道及支撑结构)在所有方法中都没能被恢复。论文分析,这是因为这些方法依赖图像之间一致的特征,而遮挡在多视图输入中随机出现,当特征被随机遮挡时,方法便告失败。
计算耗时的差距同样明显。SfM和NeRF需要数小时(实验中为5至6小时),VGGT和DA3即便在高端GPU上也需要数分钟(实验中为7至15分钟)。相比之下,peering合成孔径成像在实验中仅用17毫秒就完成,并能保持高分辨率。论文由此说明:与依赖深度重建的3D方法不同,合成孔径传感并不重建深度,而是在二维图像中抑制部分遮挡。
03.
左右晃、斜着晃,哪种更管用
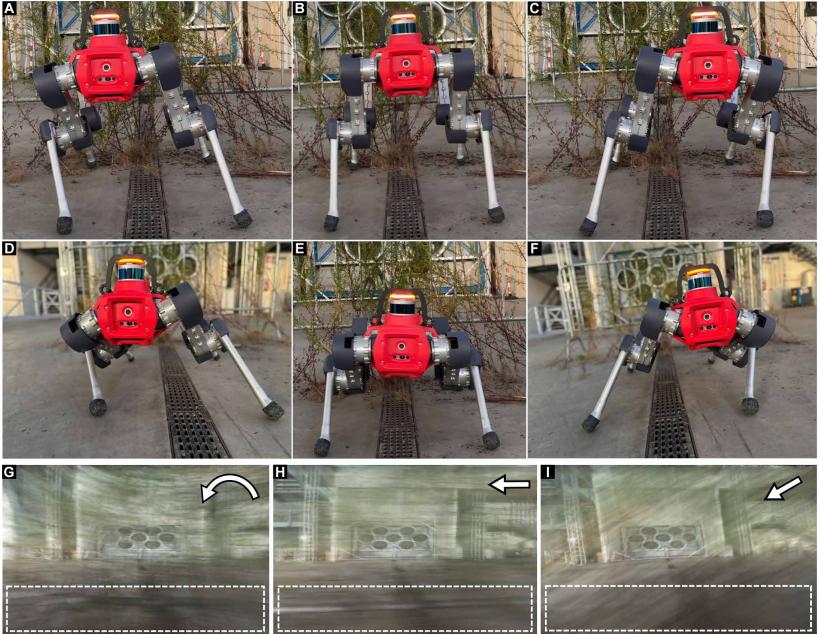
既然是侧向运动,具体怎么晃就有讲究了。团队在ANYbotics的ANYmal四足机器人上(其机械限位为水平30厘米、垂直20厘米),对比了三种运动:轴向旋转、水平平移和对角平移。
实验结论是:水平平移的效果优于轴向旋转,因为平移能最大化运动视差;但纯水平运动难以抑制横向排列的遮挡物(比如栅栏的金属横杆),因为这类遮挡物从多个视角都会挡住背景;这时对角平移表现更好,因为它同时利用了水平和垂直方向的运动视差。论文还指出,有效去遮挡可以用少一个数量级的样本数实现,这意味着即便相机帧率有限,也能采用较快的运动。
一个值得注意的细节是:旋转运动之所以能产生视差,是因为相机的光学中心与旋转中心并不重合;若两者重合,则不会产生视差,去遮挡也就无法实现。
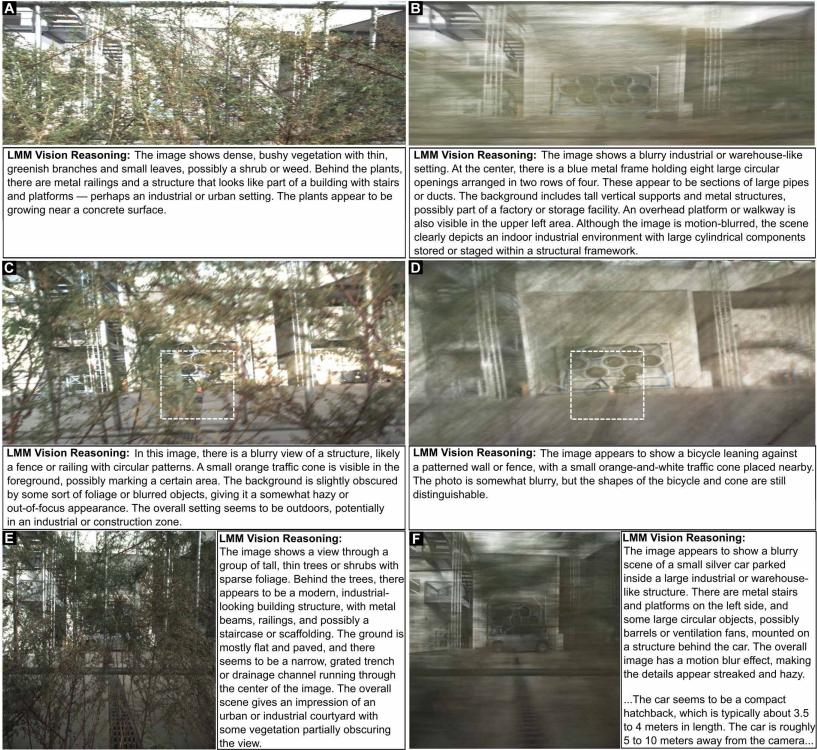
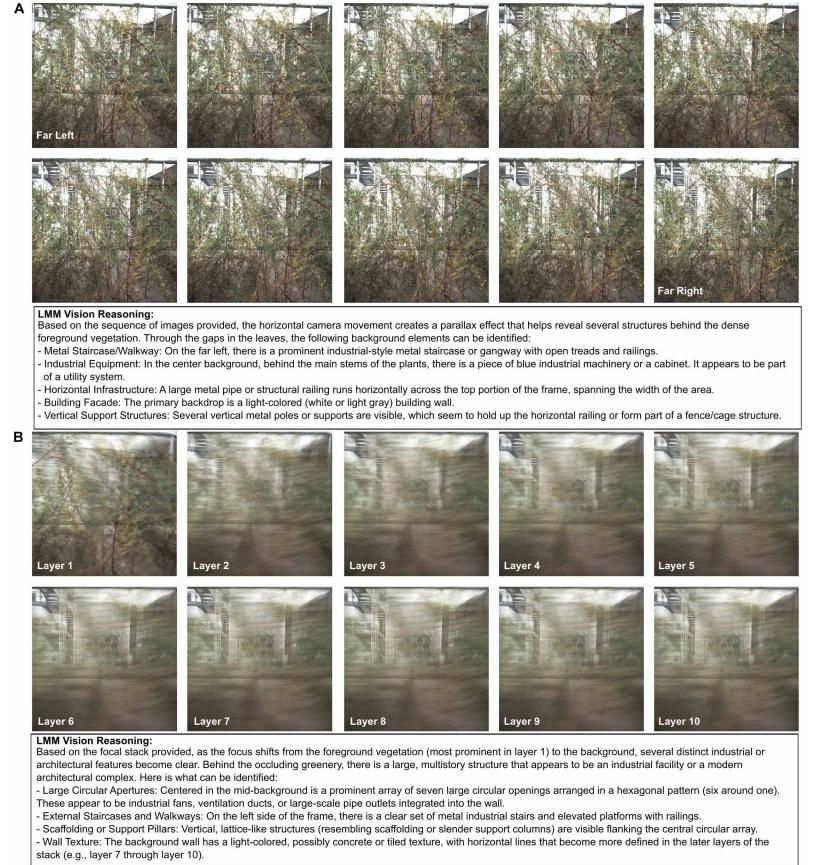
在与大模型的结合上,团队把常规图像与去遮挡后的合成孔径积分图像分别喂给 ChatGPT-5.0。结果显示,面对被植被遮挡的常规图像,模型的推理主要集中在前景遮挡物上,对背景解读并不充分;而当遮挡在合成孔径积分图像中被抑制后,模型能够识别出通风管道、金属框架,以及后续加入的自行车、交通锥,并对约5米外的汽车距离作出估计。论文也指出,视觉推理模型本身具有非确定性,同一图像多次查询结果会略有不同,但整体规律保持一致。
04.
掩膜提升画质,焦点堆栈摆脱"预知距离"
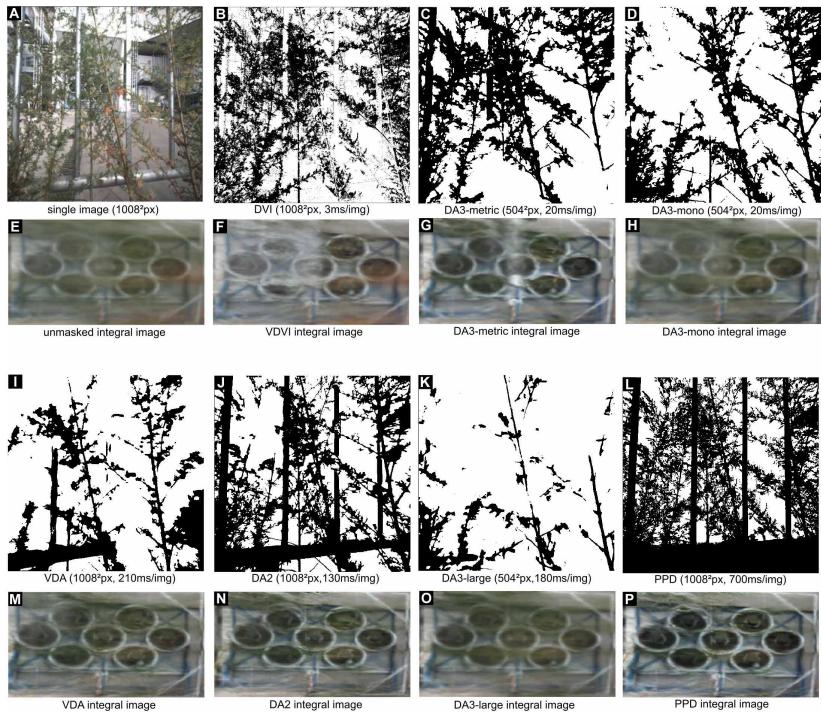
单纯平均所有像素会残留一些失焦模糊。为提升对比度和色彩重建,团队引入了遮挡掩膜:先识别各图像中的潜在遮挡物,只对未被遮挡的像素做平均。掩膜可基于植被指数(VDVI)或深度线索生成。文中评测了VDVI以及六种深度重建方法,其中 Pixel-Perfect Depth(PPD)效果最优,但计算耗时最长。论文还指出,深度学习类3D方法在灰度的NIR图像上表现弱于彩色图像,原因可能是训练数据偏向彩色。
针对"合成孔径需要事先知道背景距离"这一约束,团队提出快速计算焦点堆栈(一系列不同合成焦距的图像)。把焦点堆栈交给支持多图推理的 Gemini 3 分析,即使不知道目标距离也能完成识别;若在提示中编码各层已知距离,模型还能估计目标距离。论文举例说明,常规图像序列中未被识别出的七个通风口,在焦点堆栈的推理中被成功辨认。
05.
结语
这套方法的优势在于低成本、可即时部署:无需昂贵的相机阵列或激光雷达,任何配备摄像头的机器人都能用,且与波长无关。论文也客观说明了边界——去遮挡在约50%遮挡度时效果最佳,过密的遮挡仍难以处理。
实验目前在ANYmal四足机器人上完成,但作者指出,peering能力并不限于四足平台,同样适用于双足、六足、轮式或爬行平台。团队还提到,他们正基于波士顿动力Spot开发配备多光谱(尤其是热成像)传感器的新平台,以支持更全面的户外实验。论文最后强调,研究peering这类演化而来的动物行为可以启发机器人技术,而这种交流是双向的——机器人研究同样能反过来推动动物行为研究。