晓|NeurIPS'25厦大+国防科大 PlanU 重塑 LLM 不确定性决策范式
性能提升20%+!NeurIPS 2025新解法:当LLM遇上“随机”世界,PlanU教你如何稳操胜券
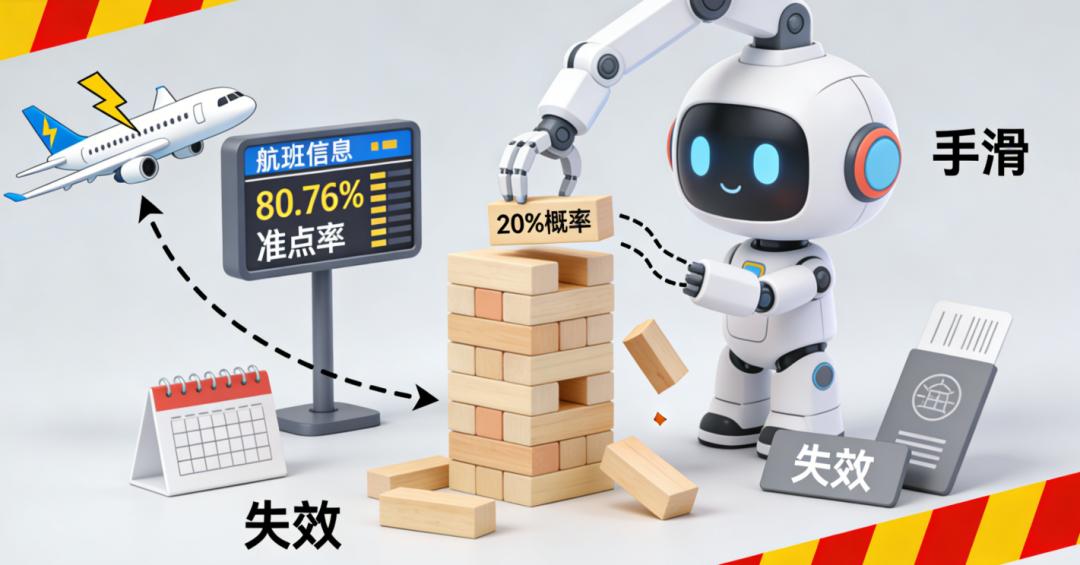
试想一下:你让AI规划一次跨国旅行,它算好了一切,却唯独没算到航班可能会延误;或者你让机器人叠积木,它规划得很完美,却不知道机械手有20%的概率会手滑。
这就是“不确定性”给LLM决策带来的降维打击。在这些充满了随机变量的真实世界中,原本聪明的LLM往往会因为一步算错而步步皆输,导致任务成功率惨不忍睹。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
如何让Agent在“混沌”中学会“运筹帷幄”? 这篇入选NeurIPS2025的PlanU论文给出了标准答案。通过引入MCTS(蒙特卡洛树搜索)结合分位数分布建模,PlanU能够精准捕捉环境与模型的不确定性。结果显示,它不仅能让Agent在随机场景下的决策更加“抗造”,还能带来20%以上的性能跃升。
一、AI 决策的核心痛点:两种“不确定性”交织的困境
在实验室的理想环境下,LLM Agent 往往能对答如流,但一旦投放到复杂现实中,性能就会遭遇“滑铁卢”。究其原因,是两种不可忽视的不确定性成了阻碍 Agent 进化的核心瓶颈。
1. 环境不确定性:现实世界的“非确定性动态”
现实世界并非一套严丝合缝的代码,而是充满了随机的变量。
• 物理执行的随机性: 比如机械臂执行“叠积木”动作,可能存在 20% 的物理失误率导致动作落空;
• 外部系统的波动性: 在旅行规划场景中,80.76% 的航班准点率意味着每 5 次飞行就可能面临一次延误,而这种单点扰动会产生连锁反应,让后续的酒店、景点预约全部作废。
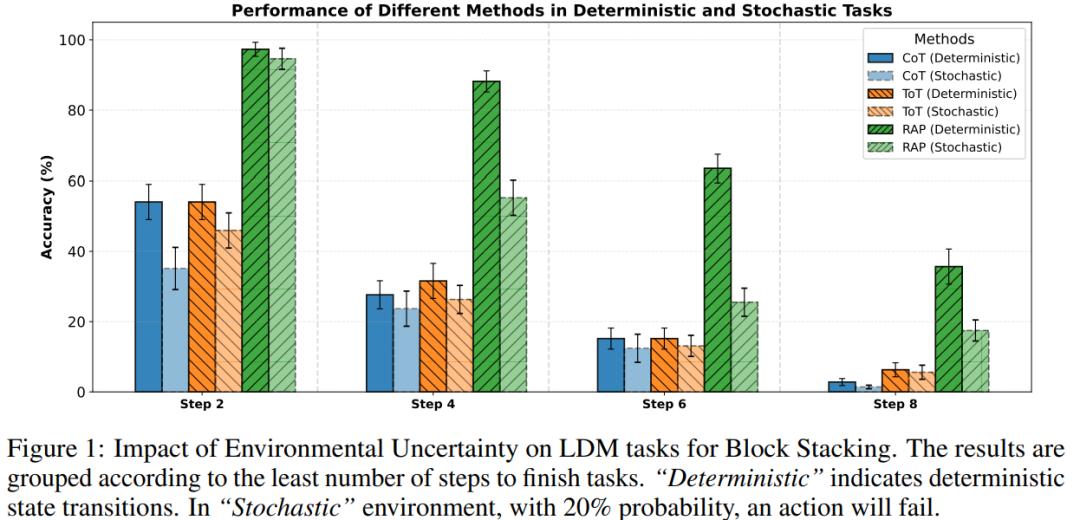
CoT(思维链)或 ToT(思维树)等传统决策方法,其底层逻辑大多基于 “确定性假设”——即认为动作 A 必然导致状态 B。面对随机环境,这些方法往往束手无策。实验数据显示,在 Blocksworld 任务中,当动作失败率仅为 20% 时,CoT 在 8 步任务中的成功率会迅速归零,而 ToT 也仅能维持 2.8% 的惨淡表现。
2. LLM 不确定性:表征漂移与自我幻觉
除了环境“善变”,LLM 模型本身的随机生成特性也给决策增加了噪音。
• 语义表征的漂移: 即使是同一个物理状态,LLM 在两次生成中可能会给出不同的描述(如“杯子在桌子左边”与“桌子在杯子右边”)。这种措辞的细微偏差,往往会导致决策路径在搜索空间中南辕北辙。
• 世界模型的幻觉: 当 LLM 充当“虚拟环境”来预测动作后果时,它极易产生逻辑偏差,给出错误的环境反馈。
之前有方案尝试过用“多次采样、多数投票”的方法来对冲随机性,但这不仅导致计算 Token 成本呈指数级暴涨,且依然无法区分“模型生成的随机性”与“环境固有的随机性”,属于是治标不治本。
二、传统方案的局限:要么顾此失彼,要么成本太高
在不确定性面前,现有的技术路径往往在两个极端之间反复横跳,难以兼顾:
一个残酷的实验事实: 曾有研究尝试在提示词(Prompt)里叮嘱LLM“考虑失败的可能性”,结果却适得其反——在投资决策任务中,这种“口头提醒”反而让AI变得畏首畏尾,表现甚至不如直接选择保底收益。这证明了:不确定性必须从算法底层进行硬核破解,而非仅仅依靠 Prompt Engineering。
三、PlanU的底层逻辑:重构 MCTS 的评价体系
PlanU的本质是给经典的蒙特卡洛树搜索(MCTS)做了两处关键改进,就像给探险者装备了“概率地图”和“好奇罗盘”,既知道哪里可能有风险,又不会错过潜在的最优路径。
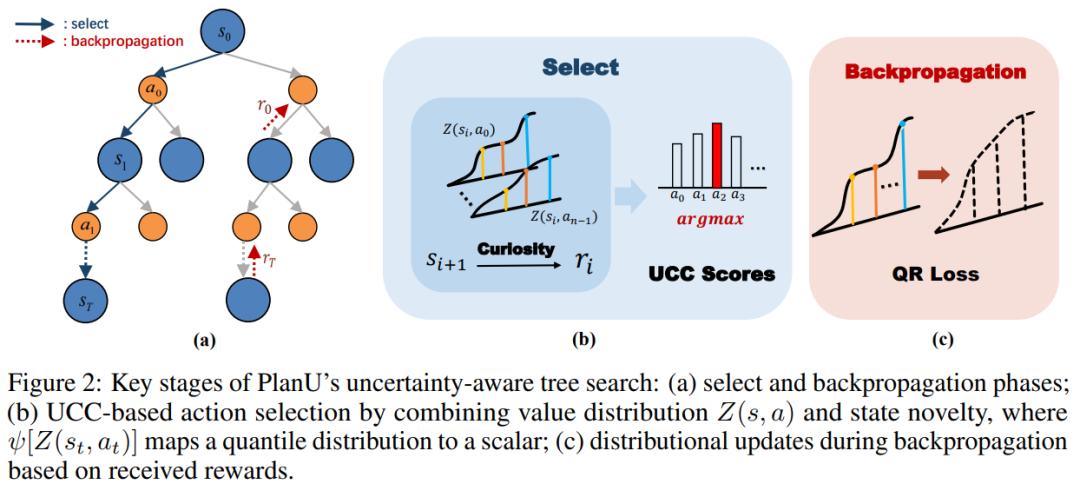
先简单解释下MCTS:可以把它理解为AI的“决策树探险”——每个节点代表当前状态(比如“积木A在桌子上,积木B在积木A上”),每条边代表一个动作(比如“把积木B搬到桌子上”),AI通过不断探索树的分支,找到能获得最大收益的路径。传统MCTS的问题是“信息太单一”,只看每条路径的平均收益,忽略了收益的波动(也就是不确定性)。
1. 神器1:分位数分布——给收益画“概率光谱”,不只看平均值
PlanU没有像传统方法那样,用“平均收益”来评估每个决策(比如“执行这个动作平均能得0.6分”),而是用“分位数分布”来建模收益。
这个概念听起来复杂,其实很简单:就像天气预报不说“明天平均气温25度”,而是告诉你“最低气温20度,最高30度,有60%概率在22-28度之间”,让你能全面了解温度的分布情况。PlanU给每个状态-动作对(比如“当前状态S,执行动作A”)的收益画了一张“概率光谱”,用一组分位数(比如20%、40%、60%、80%分位)来描述收益的分布范围。
这样做的好处是,AI能清楚知道“这个决策的最好情况和最坏情况是什么”:如果光谱很窄(比如所有分位数都在0.8-0.9之间),说明这个决策很稳定;如果光谱很宽(比如10%分位是0,90%分位是1),说明这个决策风险高但潜在收益大。这就完美解决了“环境不确定性”——AI不再假设动作会带来固定收益,而是能应对多种可能的结果。
2. 神器2:UCC分数——好奇驱动的“探索-利用”平衡术
MCTS的核心难题是“该继续探索未知路径,还是利用已知的高收益路径”(也就是探索-利用权衡)。传统的UCT分数只考虑“访问次数”和“平均收益”,面对LLM和环境的双重不确定性,很容易陷入“要么过度探索导致成本暴涨,要么过度利用导致错过最优路径”的困境。
PlanU设计的UCC分数(Upper Confidence Bounds with Curiosity)相当于给这个权衡加了“双保险”:
• 第一部分:基于分位数分布的收益评估,不是看平均值,而是综合考虑收益的分布特征(比如均值+分布宽度),确保“利用”的是真正靠谱的高收益路径;
• 第二部分:状态新奇度奖励,鼓励AI探索那些很少访问但可能有高价值的状态(比如旅行规划中,探索“高铁转飞机”的组合,可能比单纯坐飞机更稳定)。
更巧妙的是,UCC还解决了LLM的描述不确定性:它用文本编码器把LLM生成的状态描述转换成向量,只要语义相近(比如“杯子在桌子左边”和“桌子在杯子右边”),就会被判定为同一个状态,避免了LLM措辞变化导致的决策偏差。
四、PlanU的创新突破:三个关键改进,既提效又降本
PlanU之所以能在多个 benchmark 上超越SOTA,核心是三个创新点,每个都直击传统方案的痛点:
1. 统一建模两种不确定性,不再顾此失彼
这是PlanU最核心的突破。它没有分开处理“环境不确定性”和“LLM不确定性”,而是通过“分位数分布+文本编码”的组合,一次性搞定:
• 分位数分布捕捉环境的随机变化(比如动作失败、航班延误);
• 文本编码器统一LLM的描述差异,减少模型自身不确定性的影响。
2. 计算效率优化:用分位数替代均值,成本降3倍
传统的MCTS改进方案(比如RAP)为了减少不确定性,会多次查询LLM的世界模型,取最频繁的结果作为下一步状态,导致查询次数暴涨。PlanU用分位数分布建模后,不需要多次采样,一次探索就能捕捉收益的分布特征。
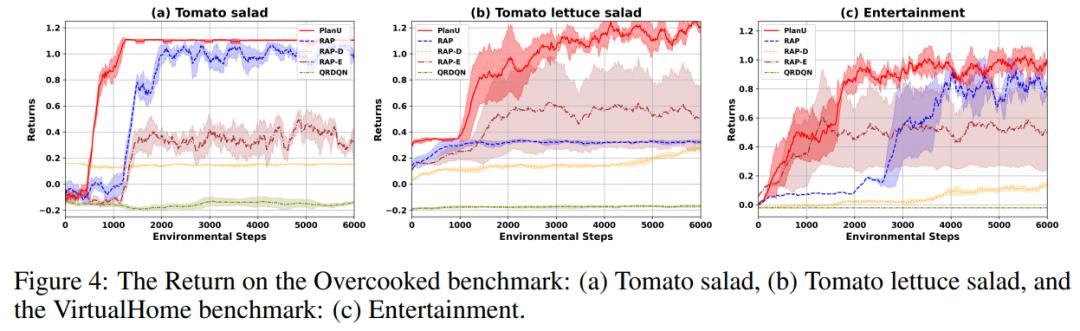
实验数据显示,在Tomato Lettuce Salad任务中,PlanU的token消耗量只有922.6k,查询次数1389.6次,而RAP的token消耗是2643.84k,查询次数4313次——PlanU的计算成本不到RAP的1/3,还能获得更好的性能。这对中小团队太重要了,毕竟不是所有人都有足够的GPU资源支持海量采样。
3. 多步决策适配:环境反馈闭环更新,适合复杂任务
之前的DeLLMa虽然考虑了不确定性,但不利用环境反馈,只能做单步决策(比如“买A股票还是B股票”),面对旅行规划、机器人操作这种多步任务完全没用。PlanU通过MCTS的回溯阶段,把环境反馈(比如动作是否成功、获得的奖励)实时更新到分位数分布中,让决策能随着环境变化动态调整。
比如在Overcooked的Tomato Lettuce Salad任务中(需要切番茄、切生菜、组合食材、交付,还存在动作失败),只有PlanU能成功完成任务,其他方法要么卡在“切菜失败后不知道重试”,要么在多步骤衔接中出错。
五、实验验证:5个benchmark全覆盖,性能碾压SOTA
PlanU的实验设计非常全面,覆盖了从简单到复杂的5个决策场景,还用了3种不同规模的LLM(Mistral-7B、Llama3.1-8B、DeepSeek-R1-Distill-Llama-8B),甚至包括GPT-4.1、Gemini-2.5-Pro等闭源大模型,结果都很有说服力:
1. 核心任务表现:复杂任务优势更明显
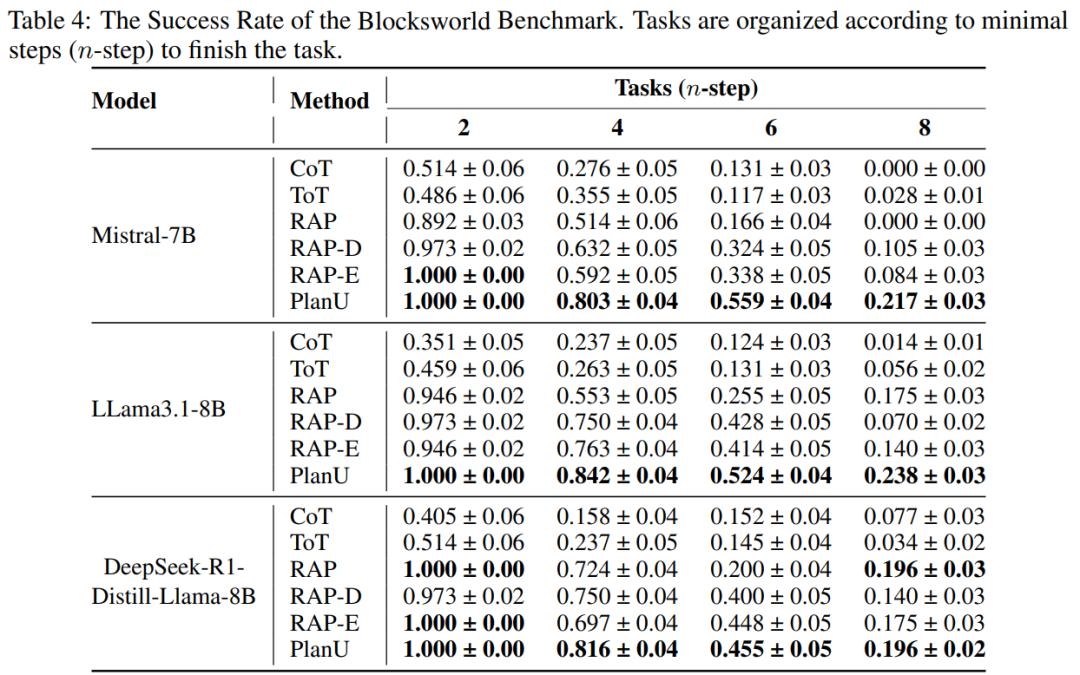
在Blocksworld任务中(动作失败率20%),随着任务步骤增加(从2步到8步),PlanU的优势越来越大:
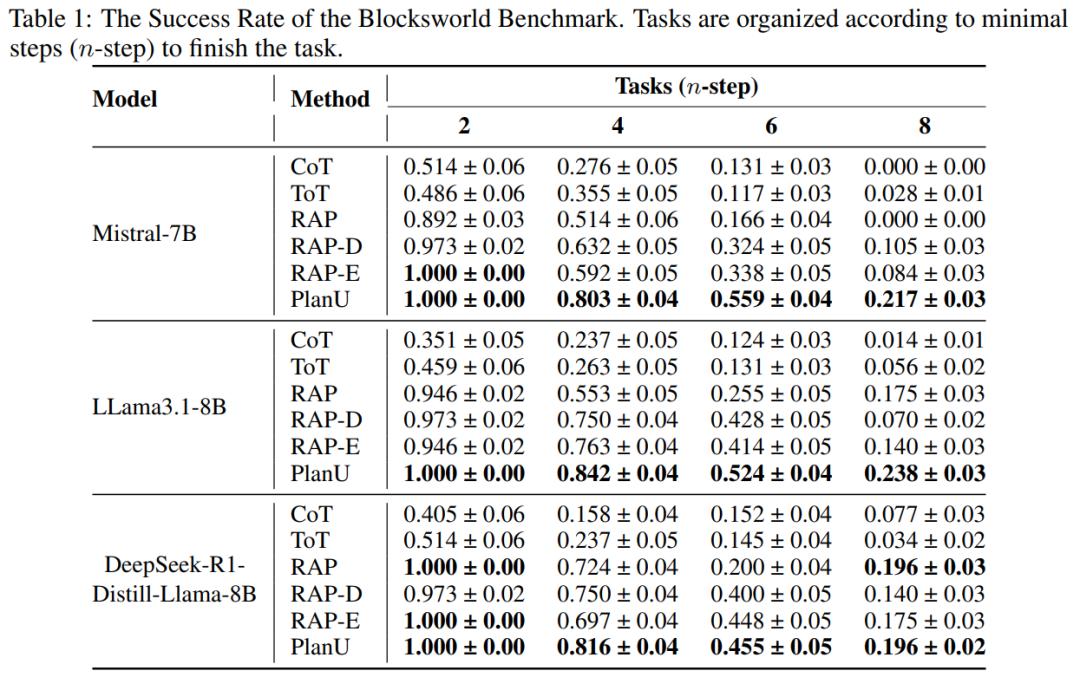
• 2步任务:PlanU在所有模型上的成功率都达到100%,和最优的RAP-E持平;
• 4步任务:PlanU用Llama3.1-8B的成功率是84.2%,比RAP-E高7.9个百分点;
• 8步任务:PlanU的成功率是23.8%,而第二好的RAP-E只有14%,CoT更是只有1.4%。
这说明PlanU在长序列、高不确定性的复杂决策中,稳定性远超传统方法——这正是实际场景最需要的能力,毕竟没人会只让AI做2步就能完成的简单任务。
2. 真实场景适配:从厨房做饭到旅行规划都能用
PlanU在更贴近现实的场景中表现同样出色:
• Overcooked(厨房做饭):在Tomato Lettuce Salad任务中,PlanU是唯一能稳定完成的方法,其他方法要么切菜失败后无法恢复,要么把干扰食材(洋葱)加入菜品导致任务失败;
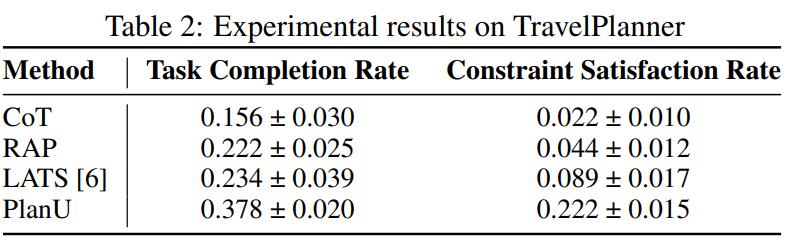
• TravelPlanner(旅行规划):任务完成率达到37.8%,是CoT的2.4倍,约束满足率(比如遵守行程时间、预算限制)达到22.2%,是RAP的5倍;
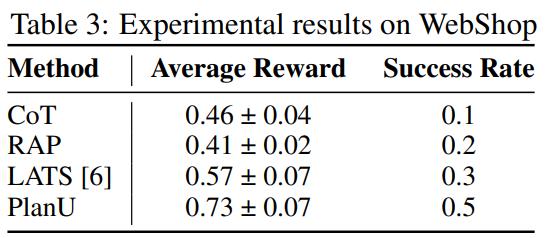
• WebShop(电商购物):平均奖励73%,成功率50%,比LATS高16个百分点,意味着能更好地满足用户的品牌、价格、尺寸等多重需求,还能应对网络延迟导致的动作失败。
3. 消融实验:两个核心模块缺一不可
PlanU的消融实验很能说明问题,也验证了之前的判断:
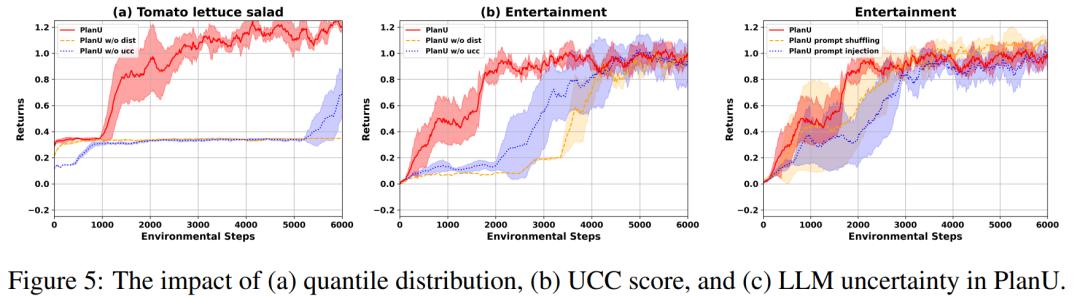
• 去掉分位数分布(PlanU w/o dist):用均值替代分位数,在Tomato Lettuce Salad任务中直接无法完成,因为没法捕捉动作失败的风险;
• 去掉UCC分数(PlanU w/o ucc):用传统UCT替代,探索效率大幅下降,在Entertainment任务中需要更多步骤才能找到最优路径,计算成本增加40%。
这说明分位数分布和UCC分数是PlanU的“双核心”,少了任何一个都达不到最优效果——这也给后续的研究提了醒:做改进不能只加模块,还要确保模块之间的协同性。
六、落地前景与挑战:哪些场景能用,还有哪些坑要填
1. 落地场景:这些领域能直接受益
PlanU的适用场景非常广泛,尤其是需要在不确定环境中做多步决策的领域:
• 机器人操作:工业机器人装配、家庭服务机器人(应对动作失败、环境变化);
• 智能规划:旅行规划、会议安排、项目管理(处理延误、资源变动);
• 电商/客服:智能导购(应对商品库存变化、物流延迟)、自动售后处理(处理用户需求变化、售后政策调整);
• 金融决策:股票投资、基金配置(应对市场波动、政策变化)。
2. 现存挑战:这两个问题需要后续优化
PlanU不是完美的,原文也坦诚地指出了两个局限性,这也是后续可以跟进的研究方向:
• 高维动作空间适配差:如果动作数量太多(比如有100个可选动作),PlanU的MCTS会难以在有限时间内探索足够路径,导致性能下降。原文计划用“分层MCTS”解决,把复杂动作拆解成子动作(比如“做饭”拆成“切菜”“炒菜”“装盘”);
• 缺乏外部工具调用:面对需要实时信息的场景(比如旅行规划中查询实时航班动态、电商购物中查询商品库存),PlanU没法调用外部工具,只能依赖内部知识。后续可以结合ReAct的思路,让PlanU在需要时触发web搜索等工具。
七、总结:PlanU的核心价值的——给不确定性决策提供“可复现范式”
PlanU最值得学习的不是某个单一技巧,而是它“用简单方法解决复杂问题”的思路:没有引入复杂的贝叶斯模型或海量参数,只是在MCTS的基础上做了“分位数分布建模”和“UCC分数设计”,就同时搞定了环境和LLM两种不确定性,还降低了计算成本。
对科研人员来说,它提供了一套可复现、可扩展的研究范式,你可以在此基础上结合外部工具、分层决策等方向做进一步创新;对工程人员来说,它的计算效率高,不需要依赖超大模型,在普通GPU上就能运行,落地门槛低。
最后想问下:你们在做Agent决策相关研究时,是否也遇到过不确定性导致的性能瓶颈?是用什么方法解决的?欢迎在评论区交流,也可以分享你们的复现经验~
参考资料
• 标题:PlanU: Large Language Model Reasoning through Planning under Uncertainty
• 作者:Ziwei Deng, Mian Deng, Chenjing Liang, Zeming Gao, Chennan Ma, Chenxing Lin, Haipeng Zhang, Songzhu Mei, Siqi Shen, Cheng Wang
• 单位:厦门大学,国防科技大学
• 链接:https://openreview.net/pdf?id=r3LYE0Ct3G