阿里:分阶段奖励让AI画师更聪明,复杂图像描述再也不是难题
当你问AI“帮我画一张法国大教堂的照片,要有两扇彩绘玻璃窗,曾经出现在雨果著名小说中的画面",你期待什么?如果AI能准确生成巴黎圣母院的图像,带着两扇精美的彩绘窗户,那这确实令人惊喜。然而现实是,大多数AI图像生成模型在面对这种多重要求的复杂描述时往往力不从心,要么忽略某些细节,要么生成的图像与描述相去甚远。
研究团队发现,现有的文本到图像生成模型虽然在一些简单场景下表现不错,但在处理包含多种属性要求(如颜色、数量、位置等)和需要推理的模糊描述时经常失败。传统方法通常只在最终生成阶段提供反馈,这就像只在考试结束后才知道答案对错,无法在过程中及时调整方向。研究人员意识到,如果能像人类艺术家那样,在创作的每个关键步骤都获得指导和反馈,AI的创作能力必然会显著提升。
为了解决这些问题,阿里研究团队开发了一套名为Visual-CoG的新方法。这个方法最大的特点是把AI绘画变成了一个三步走的过程,就像一个专业画家的创作流程一样。
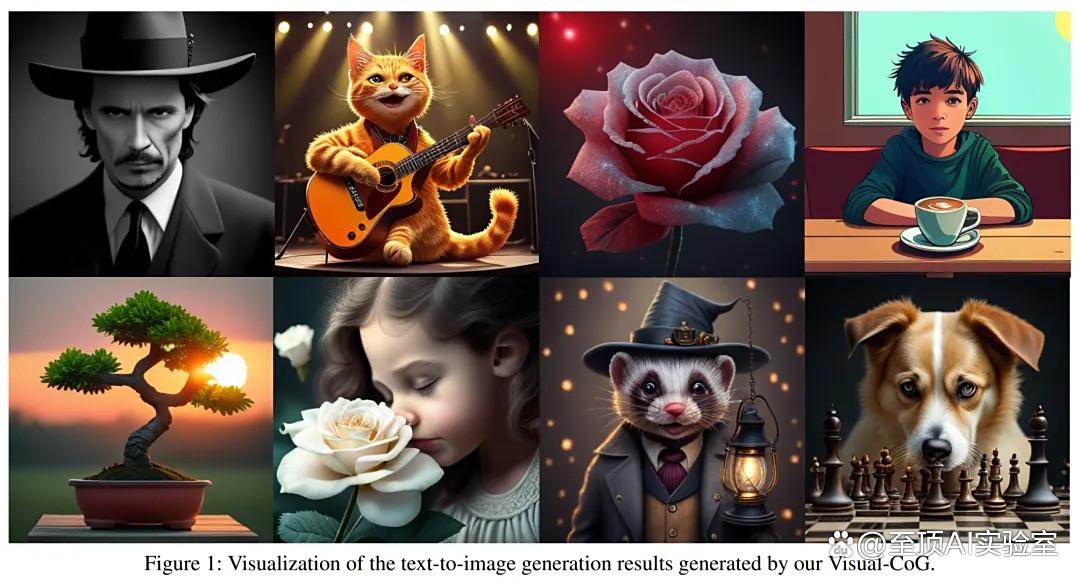
这项研究彻底改变了我们对AI图像生成的理解,首次提出了分阶段奖励机制的概念,让AI像真正的艺术家一样按步骤创作。
像艺术家一样思考:三步曲创作法的诞生
考虑这样一个场景:当一位画家接到"画一只紫色的狗和一张黑色餐桌"的要求时,他不会立即动笔,而是会先在脑中构思整个画面的布局和元素。首先,他会进行语义推理,理解"紫色的狗"这个不寻常的组合意味着什么,以及如何将狗和餐桌和谐地安排在同一个画面中。接着,他会在画布上逐步细化每个元素,不断调整细节直到满意。最后,他会从整体上评估作品是否达到了预期效果。
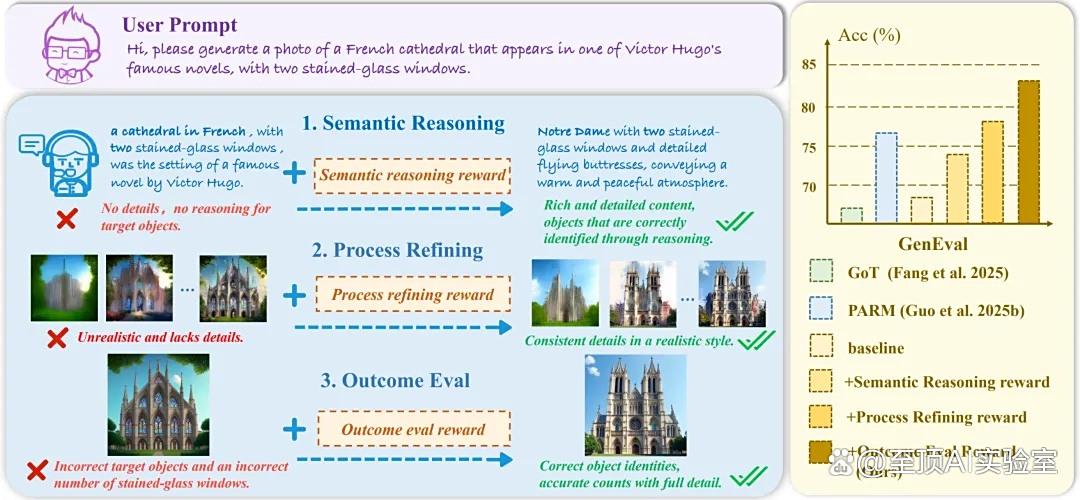
Visual-CoG框架正是模拟了这种人类艺术家的创作思路。研究团队将整个图像生成过程分解为三个关键阶段,每个阶段都有独立的奖励机制进行实时指导,这种方法被称为"视觉指导链"。
第一阶段是语义推理,这相当于艺术家的构思过程。系统首先会深入理解用户的文本描述,特别是那些含糊或需要推理的部分。回到前面的例子,当用户说"法国大教堂出现在维克多·雨果著名小说中"时,系统需要推理出这指的是《巴黎圣母院》,因此目标建筑是巴黎圣母院。这个阶段会生成一个更详细、更具体的推理描述,比如将原始描述扩展为"Notre Dame with two stained-glass windows and detailed flying buttresses, conveying a warm and peaceful atmosphere"。
语义推理阶段的奖励机制通过比较基于原始描述和推理描述生成的图像质量差异来计算。如果推理后的描述能产生质量更高、更符合要求的图像,那么这次推理就会获得正面奖励,系统就能学会做出更好的语义推理。
精雕细琢的过程:渐进式优化策略
第二阶段是过程细化,类似于画家在画布上逐步添加细节的过程。这个阶段最具创新性的地方在于,它不再等到图像完全生成后才进行评估,而是在生成过程中的每一步都提供即时反馈。
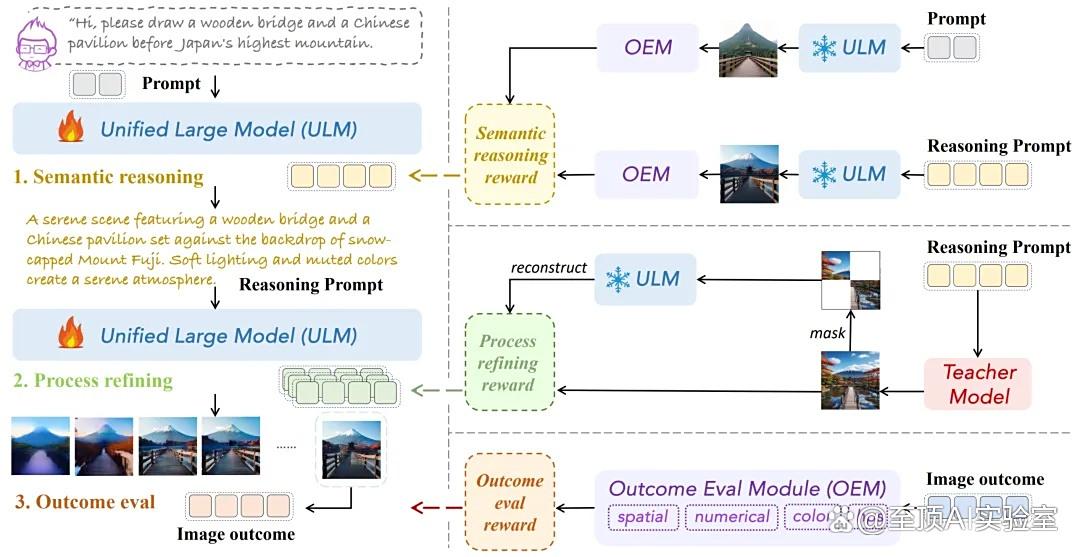
传统的图像生成模型采用掩码标记预测技术,就像在拼图游戏中逐步填入缺失的片段。然而,以往的方法只在整个拼图完成后才评判好坏,而Visual-CoG在每填入一小块拼图时就进行评估。这种做法面临的挑战是,中间过程产生的图像往往是模糊和不完整的,直接评估这些中间结果并不可靠。
研究团队的巧妙解决方案是引入"教师模型"的概念。系统会让一个经验丰富的教师模型来展示在某种掩码条件下应该如何填充,然后评估正在训练的模型是否能学会类似的填充方式。这种方法避免了直接评估模糊图像的问题,转而通过比较生成策略的相似度来提供反馈。
具体而言,过程细化奖励通过计算策略模型和教师模型在相同掩码条件下生成分布的差异来得出。当两个分布越相似时,说明策略模型学得越好,获得的奖励也越高。这种机制确保了模型能在生成过程中持续改进,每一步都朝着更好的方向发展。
全面评估的最终审查:多维度质量控制
第三阶段是结果评估,相当于艺术家完成作品后的全面检视。这个阶段不仅要评估图像的整体美学质量,还要详细检查是否满足用户描述中的各种具体要求。
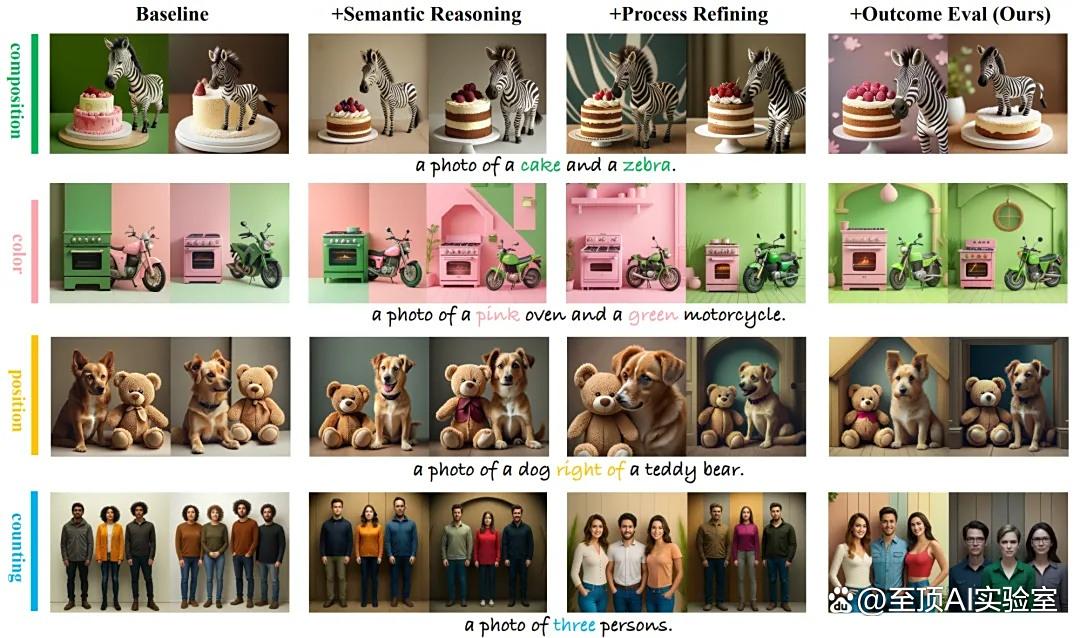
研究团队设计了一套全面的评估体系,包含四个核心维度的检查。空间一致性检查确保图像中物体的相对位置符合描述要求,比如"狗在泰迪熊右边"这样的位置关系是否准确。数量一致性检查验证物体数量是否正确,避免出现"三个人"变成两个人或四个人的情况。颜色一致性检查使用视觉语言模型来判断物体颜色是否与描述匹配。整体美学评估则关注图像的艺术质量和视觉吸引力。
这种多维度评估系统的威力在于它能够捕捉到传统方法容易忽略的细节错误。以前的模型可能生成一张整体看起来不错的图像,但仔细检查会发现位置不对、数量错误或颜色偏差。Visual-CoG的结果评估机制能够及时发现这些问题,并通过奖励机制指导模型改进。
分阶段奖励的威力:实验数据说话
为了验证这种分阶段奖励机制的有效性,研究团队在多个权威基准测试上进行了全面评估。在GenEval基准测试中,Visual-CoG相比基础模型Show-o实现了15%的整体性能提升,在计数任务上的提升更是达到了22%。在T2I-CompBench基准测试中,系统在颜色任务上达到了78.92%的准确率,在空间任务上达到了43.71%的准确率,均显著超越了现有最先进的方法。
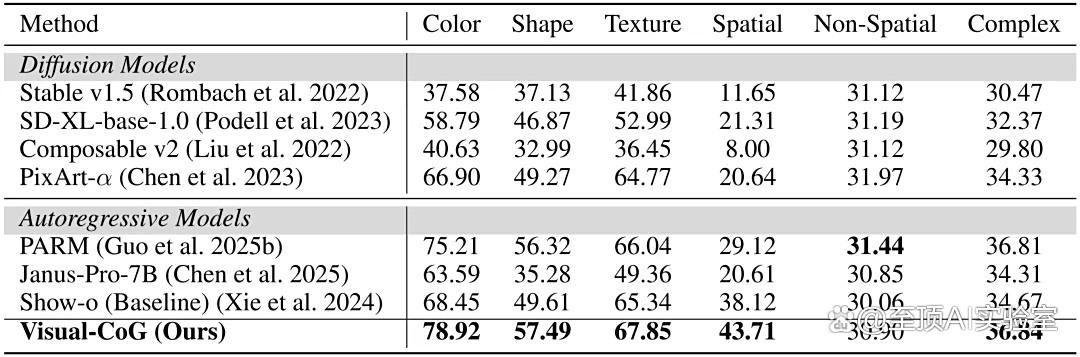
特别值得注意的是,在研究团队专门设计的VisCog-Bench基准测试中,Visual-CoG的表现更加突出。这个基准测试专门评估模型在处理不寻常和需要推理的场景时的能力,包括不寻常位置、不寻常组合、不寻常颜色和推理任务四个子任务。在推理任务中,Visual-CoG相比基础方法提升了48.75%,这充分证明了语义推理阶段的重要价值。
研究团队还进行了详细的消融实验来分析每个奖励组件的贡献。结果显示,语义推理奖励主要提升了位置准确性,改善幅度达到6.99%。过程细化奖励显著提高了计数准确性,提升了7.96%。结果评估奖励则在色彩准确性方面贡献最大,提升了9.53%。三种奖励机制的结合产生了协同效应,使整体性能达到最优。
技术创新背后的深层逻辑
Visual-CoG的成功不仅在于技术细节的精妙,更在于它对人工智能学习机制的深刻理解。传统的强化学习方法通常只在任务完成后提供一个总体评分,这就像学生只有在期末考试后才知道成绩,无法在学习过程中获得具体的改进指导。
Visual-CoG改变了这种做法,它在学习过程的每个关键节点都提供针对性的反馈。这种方法的优势是多方面的。首先,它能够更准确地识别问题所在,避免了"功过相抵"的情况,即使某一阶段表现不佳,也不会被其他阶段的优秀表现掩盖。其次,这种细粒度的反馈使得模型能够更快地收敛到最优策略,减少了训练时间和计算资源消耗。
研究团队在实现这套系统时还解决了许多技术难题。例如,如何在不稳定的中间生成结果上提供可靠的评估信号,如何平衡三个不同阶段的奖励权重,如何确保整个系统的稳定性和可扩展性等。这些技术创新的累积效应使得Visual-CoG不仅在实验室环境中表现优异,也具备了实际应用的潜力。
从实验室走向现实:应用前景展望
Visual-CoG技术的影响远远超出了学术研究的范畴。在内容创作领域,这项技术能够帮助设计师、艺术家和内容创作者更精确地表达自己的创意想法。当创作者需要生成具有复杂要求的图像时,比如"一个穿着维多利亚时代服装的女性,站在蒸汽朋克风格的飞船甲板上,背景是夕阳下的伦敦天际线",Visual-CoG能够准确理解和实现这种多层次的描述。
在教育领域,这项技术可以成为强有力的教学辅助工具。教师可以用自然语言描述历史场景、科学概念或文学情节,系统能够生成准确的可视化内容。比如在讲解古代历史时,教师可以描述"公元前5世纪的雅典集市,有穿着白色托加的哲学家在讨论,背景是帕特农神庙",系统能够生成符合历史准确性的场景图像。
在商业应用方面,Visual-CoG技术可以大大提升电子商务和广告行业的效率。商家可以通过描述来快速生成产品展示图像,比如"一款红色真皮沙发,放在现代简约的客厅中,旁边有绿植,阳光从大窗户洒进来"。这种能力不仅能节省大量的摄影和后期制作成本,还能实现个性化的商品展示。
然而,研究团队也意识到这项技术仍有改进空间。目前的系统在处理极其复杂的场景描述时偶尔还会出现细节遗漏,在生成人物面部特征时的一致性也有待提升。此外,训练过程的计算成本相比传统方法有所增加,这在一定程度上限制了技术的普及速度。
至顶AI实验室洞见
Visual-CoG代表了人工智能图像生成技术的一次重要跃进。它不仅解决了现有技术在处理复杂描述时的局限性,更重要的是提供了一种全新的思路来训练和优化AI系统。通过模拟人类艺术家的创作过程,将复杂任务分解为可管理的阶段,并在每个阶段提供针对性的指导,这种方法为人工智能的发展开辟了新的道路。
研究团队承诺将很快公开所有相关资源,包括代码、数据集和预训练模型,这将有力推动整个研究社区的进步。随着技术的不断完善和普及,我们有理由相信,未来的AI图像生成将变得更加智能、准确和富有创造力,真正实现人机协作的艺术创作新时代。
论文地址:
https://arxiv.org/pdf/2508.18032
END
本文来自至顶AI实验室,一个专注于探索生成式AI前沿技术及其应用的实验室。致力于推动生成式AI在各个领域的创新与突破,挖掘其潜在的应用场景,为企业和个人提供切实可行的解决方案。
Q&A
Q1:Visual-CoG的三个阶段分别是什么?它们如何协同工作?
A:Visual-CoG包含三个关键阶段:语义推理、过程细化和结果评估。语义推理阶段负责深入理解用户描述,特别处理模糊或需要推理的内容;过程细化阶段在图像生成过程中提供实时反馈指导;结果评估阶段对最终图像进行多维度质量检查。三个阶段各有独立的奖励机制,协同工作确保AI能像真正的艺术家一样按步骤创作高质量图像。
Q2:Visual-CoG在处理复杂文本描述时相比传统方法有什么优势?
A:Visual-CoG的最大优势在于分阶段奖励机制,能够在图像生成的每个关键步骤提供即时反馈,而不是像传统方法那样只在最终阶段评估。在GenEval基准测试中,Visual-CoG相比基础模型实现了15%的整体性能提升,在处理计数任务时提升更是达到22%。特别是在处理包含多重属性要求和需要推理的复杂描述时,这种方法能显著提高准确性。
Q3:VisCog-Bench基准测试是什么?为什么要专门创建这个测试?
A:VisCog-Bench是研究团队专门设计的视觉认知基准测试,包含不寻常位置、不寻常组合、不寻常颜色和推理任务四个子任务,总共100个测试样本。创建这个基准的目的是评估模型在处理需要深度理解和推理的场景时的能力,因为现有基准测试无法充分验证语义推理的重要性。在这个基准上,Visual-CoG在推理任务中相比基础方法提升了48.75%,充分证明了其在理解复杂语义方面的突破。