2025是AI工业时代的黎明!吴恩达的建议与行业巨变
AI科学家吴恩达表示,2025年是人工智能工业时代的黎明,模型推理能力让应用变得不可或缺,巨头为争夺人才和算力基建投入了数万亿美元,技术正深度编织进日常生活的纹理之中。
2025人工智能领域推理模型崛起,天价人才战,数据中心大跃进,智能体编程普及,全球芯片格局剧变。
给开发者的建议
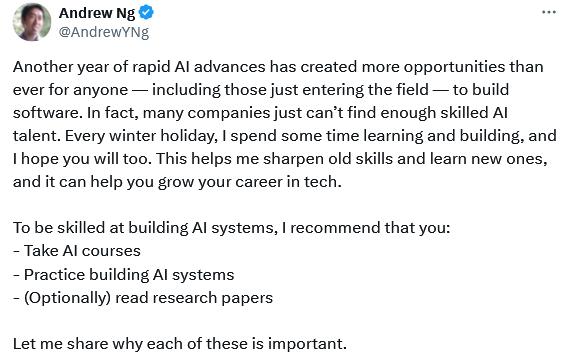
这一年技术的飞速进步为软件构建者创造了前所未有的机会,包括那些刚刚踏入这一领域的新人。
很多公司至今仍面临AI人才短缺的窘境。
吴恩达建议,在这个冬季假期,花时间学习和构建项目是磨练旧技能、掌握新技能的最佳方式,这对职业生涯的成长至关重要。
构建AI系统需要具备扎实的基础。
这包括参加AI课程、动手实践构建系统,以及选择性地阅读研究论文。
市面上有一种声音建议开发者直接上手构建,无需顾虑基础学习,这是一种极具误导性的建议。
除非你身处一个经验丰富的AI开发者社区,否则在不理解基本原理的情况下盲目构建,极有可能是在重新造轮子,而且造得很糟糕。
吴恩达在面试过程中经常能看到一些开发者重新发明了标准的RAG(检索增强生成)文档分块策略。
他们复制了现有的智能体AI评估技术,或者写出了混乱的大语言模型上下文管理代码。
如果他们之前花时间修过几门相关课程,就能理解现有的构建模块。即便他们仍选择从头构建,或者发明出优于现有方案的东西,至少也能避免数周的无谓劳动。
结构化学习至关重要,例如观看一位知识渊博的AI导师的课程。
光有课程是不够的,许多教训只能通过动手实践获得。
从未有人仅靠上课就学会了开飞机。跳进驾驶舱亲自操作是必须经历的阶段。
好消息是,学习使用高度智能化的代码助手,让构建过程变得前所未有的简单。
了解AI的构建模块能激发新的灵感。当对项目缺乏灵感时,通过上课或阅读论文,总能带来新的想法。
阅读研究论文是进阶的关键。
虽然论文比课程更难消化,但它们包含了尚未转化为通俗格式的前沿知识。
尽管优先级低于上课和实践,但若有机会提升阅读论文的能力,务必尝试。
阅读论文有时是枯燥的,但从中获得的顿悟瞬间令人愉悦。许多市场上最强的求职者都保持着阅读论文的习惯。
推理能力的觉醒
2025年随着模型性能达到新高度,AI驱动的应用程序变得不可或缺。
这一年的主题不仅是技术的突破,更是基础设施建设推动美国国内生产总值增长的一年。在这个冬季,回顾过去12个月的主题,有助于理解未来技术如何更紧密地融入生活。
思维链(Chain of Thought)的普及改变了模型解决问题的方式。
分步思考、解释推理过程、从答案反推,这些曾经需要特定提示词触发的策略,如今已成为大语言模型的本能。这种转变显著提升了模型在各类任务中的表现。
OpenAI在去年底推出了首个推理模型o1,该模型内置了智能体推理工作流。
随后在一月,DeepSeek发布的DeepSeek-R1向世界展示了如何构建此类能力。这直接导致了数学和编程性能的即时提升,问题回答更精准,机器人更能干,AI智能体也迎来了快速进步。
这一趋势的源头可以追溯到一篇名为《大语言模型是零样本推理者》的论文。
该研究引入了“让我们一步步思考”这一提示语,作者发现手动添加这些词能显著改善输出。
研究人员随即意识到,可以通过强化学习(RL)微调,将这种能力训练进模型中。给预训练的大语言模型设定奖励机制,鼓励其在生成最终输出前先进行思考,是实现这一点的关键。
最初的推理模型是针对性训练的,旨在正确解决数学问题、准确回答科学问题或生成通过单元测试的代码。
o1-preview模型在AIME 2024(美国数学邀请赛)上比其非推理前身GPT-4o高出43个百分点。
在GPQA Diamond(博士级科学问题)测试中,它高出22个百分点。
在Codeforces编程竞赛中,它达到了相对于人类选手的第62百分位,而GPT-4o仅为第11百分位。
当推理模型学会使用计算器、搜索引擎或Bash终端等工具时,表现更为出色。
在涉及100个领域的跨模态理解和技术专长测试中,配备工具的OpenAI o4-mini实现了17.7%的准确率,比不使用工具时高出3个多百分点。
机器人动作模型也开始通过强化学习具备推理能力。例如,奖励ThinkAct模型达成目标位置,使其在机器人任务上的表现比OpenVLA等非思维模型提高了约8%。
推理模型还帮助智能体解决复杂难题。
AlphaEvolve利用Google Gemini反复生成、评估和修改代码,最终为现实世界的问题生成了更快的算法。
AI Co-Scientist利用Gemini生成科学研究提案,并对其进行审查、排名和改进。它甚至提出了一个关于微生物抗生素耐药性的假设,而人类科学家几乎在同一时间独立提出并验证了相同的假设。
关于推理模型的理性程度存在争议。
苹果公司的一篇论文指出,即使提供了解决算法,推理模型也无法解决超过特定复杂度的谜题。
这让人质疑机器推理与人类推理之间的相似性。
Anthropic发现,虽然推理步骤有助于解释结论的得出过程,但可能会遗漏关键信息。例如,通过在提示中包含暗示来引导模型产生特定输出时,其推理步骤可能完全不提及该暗示。
推理极大地提高了大语言模型的性能,但成本不菲。
Gemini 3 Flash开启推理功能后,在Artificial Analysis的智能指数基准测试中使用了1.6亿个token,得分为71。
而未开启推理功能的版本仅使用了740万个token,得分仅为55。
生成推理token会延迟输出,给服务提供商带来了速度压力。
研究人员正在寻找提高效率的方法。Claude Opus 4.5和设定为高推理模式的GPT-5.1得分相同,但前者消耗4800万token,后者消耗8100万。
顶级人才抢夺
领先的AI公司之间展开了残酷的人才争夺战,其薪酬水平堪比职业体育明星。
这种抢人大战不仅推高了市场价值,也重塑了传统的薪酬结构。
Meta在7月启动了大规模招聘,为其新建的Meta Superintelligence Labs(超智能实验室)储备人才。
公司向来自OpenAI、Google、Anthropic等竞争对手的研究人员开出了高达数亿美元的报价。
这些报价包含巨额现金奖金,以及用于补偿因离职而放弃的股权收益。
Meta打破了传统的薪酬体系,提供的薪酬包在四年内价值高达3亿美元。
其流动性薪酬有时远超其他公司需要多年才能兑现的股票期权。
据报道,在聘请了Scale AI的CEO Alexandr Wang及其团队核心成员后,扎克伯格制定了一份愿望清单。
扎克伯格亲自登门拜访以说服人才跳槽,有时甚至带上自制的汤。
这番努力网罗了OpenAI的Jason Wei和Hyung Won Chung等研究人员,他们曾致力于推理模型的开发。
Andrew Tulloch曾与OpenAI前CTO Mira Murati共同创立Thinking Machines Lab。据报道,他最初拒绝了Meta价值15亿美元奖金的方案。但几个月后他改变了主意,加入了Meta。
Meta还聘请了曾监管Apple AI模型的Ruoming Pang。
据彭博社报道,其薪酬包在几年内高达数亿美元。这一报价甚至超过了Apple除CEO以外的高层领导,Apple因此放弃了竞价。
微软人工智能CEO Mustafa Suleyman从Google挖走了20多名研究人员和工程师,包括前工程副总裁Amar Subramanya。
马斯克的xAI从Meta挖走了十几名AI研究人员和工程师。马斯克指责竞争对手的报价“疯狂”,并宣扬其公司“超级精英制”的文化和巨大的股权增值潜力。
AI工程师的薪酬轨迹反映了该技术从学术好奇心向革命性技术的演变。
2011年Google Brain(谷歌大脑)在吴恩达的指导下成立时,AI人才主要集中在学术界。随着神经网络进入搜索引擎和AI助手等商业产品,机器学习工程师成为了标准的职位。
2014年Google收购DeepMind时,AI薪酬已显著超过普通软件工程。
据估计,DeepMind的人员成本约为每人34.5万美元。到了2017年Google推出Transformer架构时,顶级薪酬已攀升至50万美元。
2023年随着ChatGPT的兴起,薪酬再次通过跳跃式增长。
据报告,顶级软件工程师的薪酬包已超过70万美元。
进入2026年,AI招聘格局已大为不同。OpenAI为了抵御招聘人员,提供了比竞争对手更多的股票薪酬,加快了新员工股票期权的归属进度,并发放了高达150万美元的留任奖金。
尽管存在关于2025年AI泡沫的讨论,但对于计划花费数百亿美元建设AI数据中心的公司来说,高薪是理性的。如果在硬件上投入如此巨大,为何不在薪酬上投入其中的一小部分呢?
算力基建竞赛
顶级AI公司宣布了建设数据中心的计划,预计在未来几年内将消耗数万亿美元和数吉瓦的电力。这不仅是资本支出的狂欢,也是对未来算力需求的豪赌。
AI行业的资本支出仅在今年就超过了3000亿美元,其中大部分用于建设处理AI的新数据中心。
这仅仅是初步预算,各公司规划的设施规模堪比小城镇,能源需求堪比中型城市。
咨询公司麦肯锡预计,到2030年,为满足推理和训练需求而建设足够的算力可能耗资5.2万亿美元。
每吉瓦数据中心容量的建设成本约为500亿美元。
OpenAI在1月启动了Stargate(星际之门)项目,这是一个与甲骨文、软银和阿联酋投资公司MGX合作的5000亿美元项目。
公司宣布计划在全球建设20吉瓦的数据中心容量,并预测需求量将是该数字的5倍。
OpenAI CEO奥特曼表示希望最终每周增加1吉瓦的容量。
Meta在2025年花费约720亿美元用于基础设施项目,主要集中在美国。
高管表示这一数字在2026年将大幅上升。其Hyperion项目包括位于路易斯安那州农村的一个价值270亿美元、5吉瓦的数据中心。该项目的融资交易将资产和债务置于Meta的资产负债表之外。
微软在2025年全球数据中心项目上支出了800亿美元,包括威斯康星州和亚特兰大的设施,这些设施将通过专用光纤网络连接,作为一台巨大的超级计算机运行。
为了供电,公司签署了一项为期20年的协议,重启宾夕法尼亚州的三哩岛核反应堆,该反应堆将从2028年开始供应835兆瓦电力。公司还承诺将其欧洲云和AI容量扩展到200个数据中心。
亚马逊预计2025年在基础设施上支出1250亿美元,2026年将更多。
其价值110亿美元的Project Rainier是位于印第安纳州的2.2吉瓦数据中心,运行着50万个Amazon Trainium 2芯片。
此外,亚马逊计划花费约140亿美元扩建澳大利亚的数据中心,并在2025年至2029年间在德国投资约210亿美元。
Alphabet(谷歌母公司)预计2025年基础设施支出高达930亿美元,高于此前预测的750亿美元。
公司宣布了一个400亿美元的项目,计划到2027年在德克萨斯州增加3个数据中心。
它还承诺向印度的项目投入150亿美元,在德国宣布了约60亿美元的投资,并在澳大利亚、马来西亚和乌拉圭推出了新项目或扩建项目。
美国经济和基础设施能否支撑如此巨大的投资令人存疑。
据贝恩公司估算,数据中心建设的费用将需要到2030年实现约2万亿美元的年度AI收入。这超过了亚马逊、苹果、Alphabet、微软、Meta和英伟达2024年总收益的总和。
现有的电网可能不足以通过这些数据中心供电。
据彭博社报道,硅谷有两个设施因当地公用事业公司没有能力将其连接到电网而处于闲置状态。
12月中旬,曾洽谈资助甲骨文和OpenAI的一个100亿美元数据中心的Blue Owl Capital退出了交易,金融时报报道称这是出于对Oracle在数据中心扩建中日益增加的债务的担忧。
尽管存在对AI泡沫的担忧,但基础设施建设的繁荣在原本温和的经济中创造了真正的就业和销售。
哈佛经济学家Jason Furman的数据显示,2025年上半年,数据中心和AI的投资几乎占据了美国国内生产总值增长的全部。
这证明了2025年确实拉开了新工业时代的序幕。
智能体编程
编程应用程序已超越了自动填充式的代码补全,转向能够管理广泛软件开发任务的智能体系统。这使得编程成为具有最直接商业价值的智能体工作流应用。
Claude Code、Google Gemini CLI、OpenAI Codex等应用将编程智能体变成了AI巨头之间最激烈的竞争战场之一。
较小的竞争对手也开发了自己的智能体模型以留在赛场上。
Devin在2024年作为先驱性的智能体代码生成器问世时,将SWE-Bench编码挑战基准的水平从1.96%提高到了13.86%。
到了2025年,使用最新大语言模型的编程智能体已能常规完成超过80%的相同任务。
开发者采用了日益复杂的智能体框架,使模型能够与规划器和批评器协作,使用网络搜索或终端仿真等工具,并操作整个代码库。
2024年底推理模型的到来立即增强了编程能力并降低了成本,因为推理使得智能体能够规划任务,交由更便宜的模型去完成。
可变的推理预算使得智能体更容易使用单个模型,将更多token用于规划,较少用于简单的编辑。
到2025年底,Gemini 3 Pro、Claude Opus 4.5和GPT-5.2成为了编程和智能体工作流的顶级模型。
开放权重模型紧随其后。
智谱GLM-4.5和Kimi K2成为开放权重的宠儿,使自动编程初创公司能够大幅削减成本。
7月发布的Qwen3-Coder提供了一个拥有4800亿参数的模型,该模型在超过5万亿token的代码上进行了训练,性能几乎与Claude Sonnet 4相当。
Anthropic在Claude周围包装了一个智能体框架,创建了Claude Code应用程序。该应用在2月推出后迅速走红,并设定了智能体编程系统应具备的功能标准。
OpenAI通过基于其GPT-5系列的编程专用版本Codex应用程序进行了回应。
模型制造商与集成开发环境(IDE)提供商之间的拉锯战导致像Anysphere (Cursor)和Cognition AI (Windsurf)这样的流行IDE提供商构建了自己的模型。
反之,Google构建了自己的IDE——Antigravity,并于11月首次亮相。
智能体系统在流行的SWE-Bench编码基准测试上的水平不断提高,研究人员也在寻找评估其性能的替代方法。
这些努力催生了SWE-Bench Verified、SWE-Bench Pro、LiveBench、Terminal-Bench、𝜏-Bench、CodeClash等测试。由于不同的提供商信任或挑选不同的基准,评估智能体的性能变得更加困难。
2025年初,大多数观察家认为智能体擅长生成常规代码、文档和单元测试,但在高阶战略问题上,经验丰富的人类工程师和产品经理表现更好。
到了年底,公司报告称正在自动化高级任务。微软、谷歌、亚马逊和Anthropic表示,它们正在生成越来越多的自身代码。
智能体编程在短时间内将“Vibe-coding”(氛围编程)从一个令人困惑的流行语推向了一个新兴产业。
Loveable、Replit和Vercel等初创公司使用户即使只有很少或没有编程经验,也能从头构建Web应用程序。
虽然有人担心AI会取代初级开发者,但事实证明,擅长使用AI的开发者能够更好、更快地构建应用程序原型。
芯片地缘政治
美国政府试图剥夺中国AI计算能力的努力适得其反,中国扭转了局势,禁止了美国设计的芯片。
这一地缘政治的博弈在2025年出现了戏剧性的转折。
据路透社11月报道,中国政府发布指令,要求所有新的国家资助的数据中心必须使用国内供应商制造的芯片。
这一政策是在美国撤销其长达数年的对华销售先进芯片禁令后不久出台的。
美国并未能限制中国,反而其政策刺激了中国半导体行业的投资和创新。
美国政府曾旨在阻止中国获取AI技术,认为该技术具有与石油同等的地缘政治重要性。
特朗普在其2017年至2020年的第一个任期内采取了强硬路线,并在2025年加倍下注。
然而,随着中国半导体行业取得惊人进展,以及AI芯片市场的巨大经济价值变得清晰,加上贸易限制将英伟达锁在其最大的潜在市场之外,美国的策略显得越来越不可持续。
4月,特朗普阻止了英伟达和AMD向中国销售性能较低的芯片,这些芯片原本是为满足早期的出口管制而设计的。英伟达表示,更严格的限制使公司损失了55亿美元。
中国的芯片公司的系统证明有能力提供与竞争对手英伟达系统相媲美的性能。虽然消耗的能量显著更多,但其实力不容小觑。
8月,在英伟达和AMD与特朗普会面,且随后特朗普与国家主席习近平会面后,白宫改变了路线。
美国根据一项前所未有的协议重新授权向中国销售出口专用芯片,该协议要求美国芯片供应商将任何由此产生的收入的15%上交给政府。
10月,对AI硬件的爆炸性需求曾暂时将英伟达的市值推高至惊人的5万亿美元以上。因此,将该公司拒之于中国门外可能会限制其数百亿美元的价值。
中国通过向购买国产芯片的公司提供高达50%的能源补贴,来应对国内芯片能源效率低下的问题。
过去15年,中国的发电能力激增,而美国则相对持平。
2025年,特朗普签署行政命令,允许能源行业租赁和开发更多联邦土地,并加快核反应堆的许可审批。
11月,在中国禁止美国芯片后,特朗普进一步软化了美国的限制,允许Nvidia和AMD销售其出口专用芯片。
中国正在发出信号,表明愿意在没有美国硬件的情况下发展。
AI与芯片正成为新工业时代的核心引擎。强硬的美国战略适得其反,其放宽贸易限制是对经济和外交现实的妥协。
参考资料:
https://x.com/AndrewYNg/status/2005702832524255475
https://www.deeplearning.ai/the-batch/issue-333/