一文读懂DeepSeek多模态大模型Janus-Pro:数据、模型双升级!
研究背景是统一多模态理解和生成模型有进展,但存在问题,像用相同视觉编码器处理不同任务会影响多模态理解性能。Janus虽有成果,但因训练数据和模型容量有限存在不足。Janus-Pro的重要意义在于改进了这些问题,提升了模型性能,在多模态理解和文本到图像生成方面表现更好,为该领域研究提供了新方向和思路。
我们详细翻译解读最新论文,文末有相关信息。
作者:张长旺,图源:旺知识
文章提出Janus-Pro,这是Janus的进阶版本。Janus-Pro在架构上延续视觉编码解耦设计,优化训练策略,如调整各阶段训练内容和数据比例;扩展训练数据,涵盖多模态理解和视觉生成领域;扩大模型规模至7B。在多个基准测试中,Janus-Pro的多模态理解和文本到图像指令遵循能力表现优异,生成图像更稳定且细节丰富,但在输入分辨率和图像细节方面仍存在局限。
摘要&&解读
在这项工作中,我们介绍Janus-Pro,它是之前工作Janus的进阶版本。具体而言,Janus-Pro融入了:(1)优化的训练策略;(2)扩展的训练数据;(3)更大规模的模型扩展。通过这些改进,Janus-Pro在多模态理解和文本到图像指令遵循能力方面取得了显著进展,同时还增强了文本到图像生成的稳定性。我们希望这项工作能为该领域的进一步探索带来启发。代码和模型均已开源。
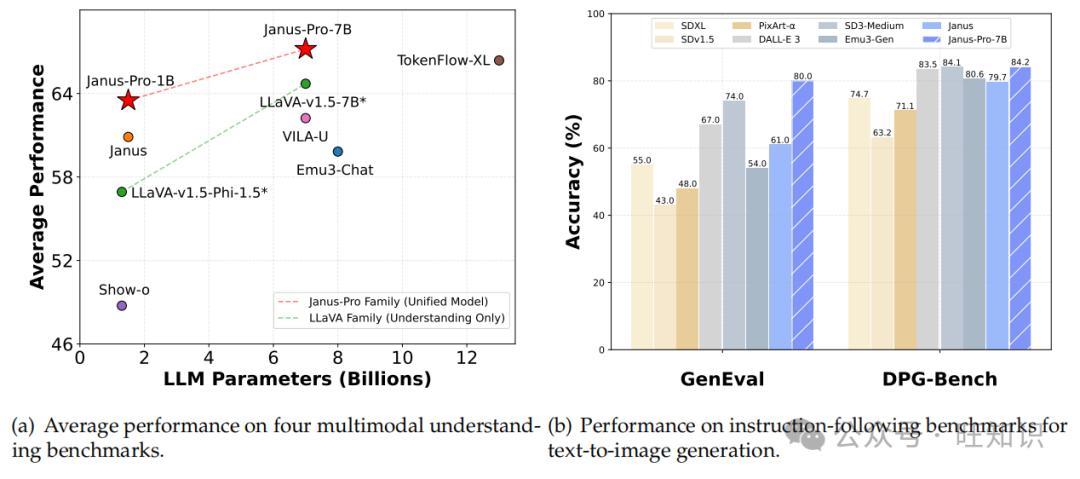
图1 Janus-Pro的多模态理解和视觉生成结果。对于多模态理解,我们取POPE、MME感知、GQA和MMMU的准确率平均值。MME感知的分数除以20以缩放到[0, 100]区间。对于视觉生成,我们在两个指令遵循基准测试GenEval和DPG-Bench上评估性能。总体而言,Janus-Pro优于先前的最先进统一多模态模型以及一些特定任务模型。建议在屏幕上查看以获得最佳效果。
研究背景: 统一多模态理解和生成模型虽有进展,但多数方法使用相同视觉编码器处理不同任务,导致多模态理解性能不佳。Janus作为先驱模型,在1B参数规模得到验证,但因训练数据量有限和模型容量较小,存在短提示图像生成性能欠佳、文本到图像生成质量不稳定等问题。
创新贡献: 提出Janus-Pro模型,通过优化训练策略,调整训练阶段的内容和数据比例,提高训练效率和性能;扩展训练数据,在多模态理解和视觉生成方面增加大量样本,提升模型能力;扩大模型规模至7B,验证了方法的可扩展性,使Janus-Pro在多模态理解和文本到图像指令遵循能力上显著提升,生成图像更稳定。
实现设计: 架构上延续视觉编码解耦,用SigLIP编码器处理多模态理解,VQ分词器处理视觉生成,经适配器映射后由统一自回归Transformer处理。优化训练策略,延长第一阶段训练,聚焦第二阶段训练并调整第三阶段数据比例。扩展多模态理解和视觉生成数据,引入大量合成美学数据。将模型规模从1.5B扩展到7B,增加模型参数和复杂度。
实验结果: 在多模态理解基准测试中,Janus-Pro-7B成绩优异,超过多数先进模型。在文本到图像生成的GenEval和DPG-Bench基准测试中,Janus-Pro-7B的总体准确率和得分均领先,生成的图像逼真、细节丰富,在遵循指令生成图像方面表现出色。
1. 引言
近期,统一多模态理解和生成模型取得了显著进展。这些方法已被证明可以增强视觉生成任务中的指令遵循能力,同时减少模型冗余。大多数此类方法使用相同的视觉编码器来处理多模态理解和生成任务的输入。由于这两个任务所需的表示不同,这通常会导致多模态理解性能欠佳。为了解决这个问题,Janus提出了解耦视觉编码,缓解了多模态理解和生成任务之间的冲突,在两个任务中都取得了出色的性能。
作为一个开创性的模型,Janus在10亿参数规模上得到了验证。然而,由于训练数据量有限和模型容量相对较小,它存在一些缺点,例如在短提示图像生成上性能欠佳,以及文本到图像生成质量不稳定。在本文中,我们介绍Janus-Pro,这是Janus的增强版本,在训练策略、数据和模型大小三个维度上进行了改进。Janus-Pro系列包括两种模型规模:10亿和70亿参数,展示了视觉编码解码方法的可扩展性。
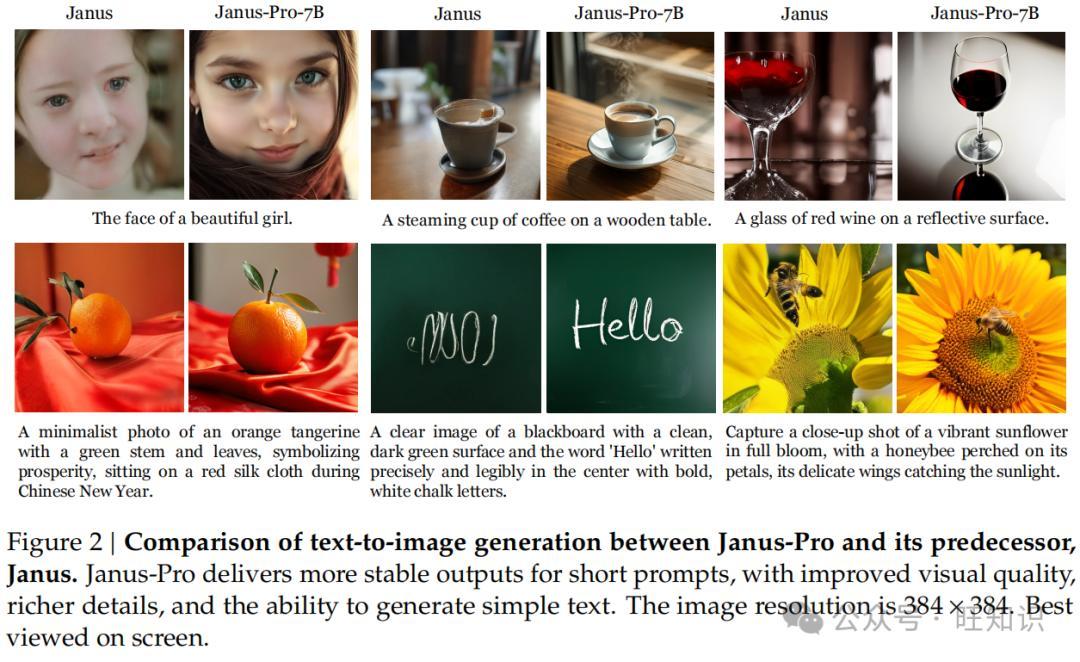
图2 Janus-Pro与其前身Janus在文本到图像生成方面的比较。Janus-Pro在处理短提示时输出更稳定,视觉质量有所提升,细节更丰富,并且能够生成简单文本。图像分辨率为384×384。建议在屏幕上查看以获得最佳效果。
我们在多个基准测试中对Janus-Pro进行评估,结果显示其具有卓越的多模态理解能力和显著提升的文本到图像指令遵循性能。具体来说,Janus-Pro-7B在多模态理解基准测试MMBench上获得了79.2分,超过了如Janus(69.4分)、TokenFlow(68.9分)和MetaMorph(75.2分)等最先进的统一多模态模型。此外,在文本到图像指令遵循排行榜GenEval上,Janus-Pro-7B得分0.80,超过了Janus(0.61)、DALL-E 3(0.67)和Stable Diffusion 3 Medium(0.74)。
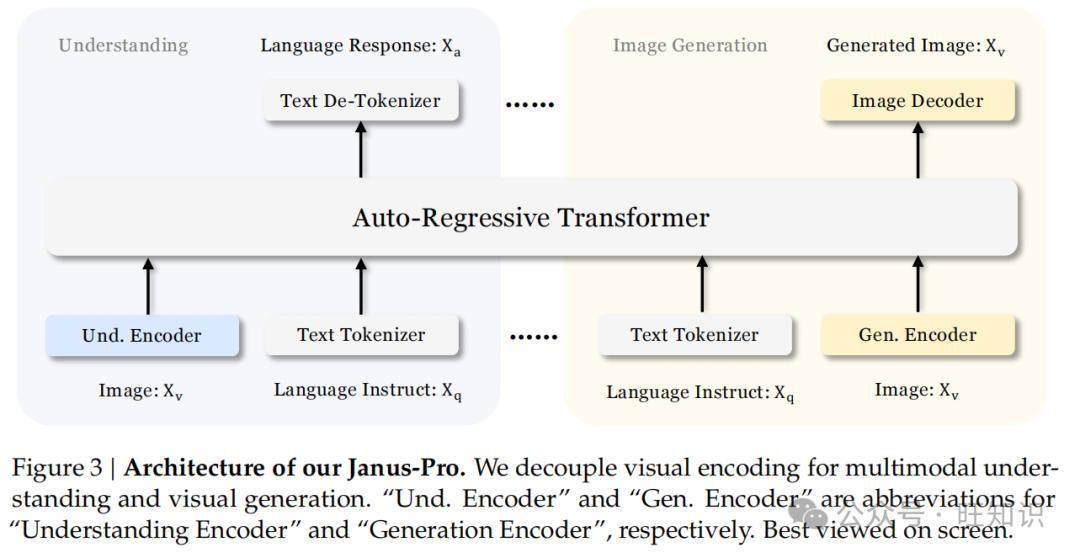
图3 Janus-Pro的架构。我们对多模态理解和视觉生成的视觉编码进行解耦。“Und. Encoder”和“Gen. Encoder”分别是“理解编码器”和“生成编码器”的缩写。建议在屏幕上查看以获得最佳效果。
2. 方法
2.1. 架构
Janus-Pro的架构如图3所示,与Janus相同。整体架构的核心设计原则是对多模态理解和生成的视觉编码进行解耦。我们应用独立的编码方法将原始输入转换为特征,然后由统一的自回归Transformer进行处理。对于多模态理解,我们使用SigLIP编码器从图像中提取高维语义特征。这些特征从二维网格展平为一维序列,并使用理解适配器将这些图像特征映射到语言模型(LLM)的输入空间。对于视觉生成任务,我们使用来自的VQ分词器将图像转换为离散ID。在将ID序列展平为一维后,我们使用生成适配器将每个ID对应的码本嵌入映射到LLM的输入空间。然后,我们连接这些特征序列以形成多模态特征序列,随后将其输入到LLM中进行处理。除了LLM中内置的预测头,我们还在视觉生成任务中使用一个随机初始化的预测头进行图像预测。整个模型遵循自回归框架。
2.2. 优化的训练策略
Janus的先前版本采用三阶段训练过程。第一阶段专注于训练适配器和图像头。第二阶段进行统一预训练,在此期间,除理解编码器和生成编码器外,所有组件的参数都会更新。第三阶段是监督微调,在第二阶段的基础上,在训练过程中进一步解锁理解编码器的参数。这种训练策略存在一些问题。在第二阶段,Janus按照PixArt的方法,将文本到图像能力的训练分为两部分。第一部分在ImageNet数据上进行训练,使用图像类别名称作为文本到图像生成的提示,目的是对像素依赖关系进行建模。第二部分在常规文本到图像数据上进行训练。在实际操作中,第二阶段中文本到图像训练步骤的66.67%分配给了第一部分。然而,通过进一步实验,我们发现这种策略并非最优,并且导致了显著的计算效率低下。
为了解决这个问题,我们进行了两处修改:
第一阶段延长训练:我们增加了第一阶段的训练步骤,以便在ImageNet数据集上进行充分训练。我们的研究结果表明,即使LLM的参数固定,模型也能够有效地对像素依赖关系进行建模,并根据类别名称生成合理的图像。
第二阶段聚焦训练:在第二阶段,我们舍弃ImageNet数据,直接使用常规文本到图像数据来训练模型,使其能够根据密集描述生成图像。这种重新设计的方法使第二阶段能够更有效地利用文本到图像数据,从而提高训练效率和整体性能。
我们还调整了第三阶段监督微调过程中不同类型数据集的数据比例,将多模态数据、纯文本数据和文本到图像数据的比例从7:3:10调整为5:1:4。通过略微降低文本到图像数据的比例,我们观察到这种调整能够在保持强大视觉生成能力的同时,提升多模态理解性能。
2.3. 数据扩展
我们在多模态理解和视觉生成两个方面扩展了Janus使用的训练数据:
多模态理解:对于第二阶段的预训练数据,我们参考DeepSeekVL2并添加了约9000万个样本。这些样本包括图像字幕数据集(例如YFCC),以及表格、图表和文档理解相关的数据(例如Docmatix)。对于第三阶段的监督微调数据,我们也纳入了来自DeepSeek-VL2的额外数据集,如MEME理解、中文对话数据以及旨在增强对话体验的数据集。这些新增数据显著扩展了模型的能力,丰富了其处理各种任务的能力,同时改善了整体对话体验。
视觉生成:我们观察到Janus先前版本中使用的真实世界数据质量欠佳且包含大量噪声,这常常导致文本到图像生成不稳定,生成的图像美学质量较差。在Janus-Pro中,我们纳入了约7200万个合成美学数据样本,在统一预训练阶段使真实数据与合成数据的比例达到1:1。这些合成数据样本的提示是公开可用的,例如中所示。实验表明,在合成数据上训练时,模型收敛速度更快,生成的文本到图像输出不仅更稳定,而且美学质量也有显著提升。
2.4. 模型扩展
Janus的先前版本使用15亿参数的LLM验证了视觉编码解耦的有效性。在Janus-Pro中,我们将模型扩展到70亿参数,15亿和70亿参数LLM的超参数详细信息见表1。我们观察到,与较小规模的模型相比,使用更大规模的LLM时,多模态理解和视觉生成的损失收敛速度显著提高。这一发现进一步验证了该方法的强大可扩展性。
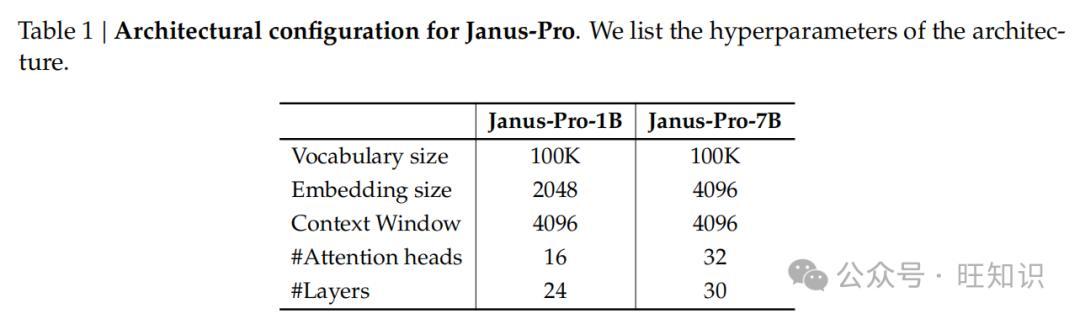
表1 Janus-Pro的架构配置。我们列出了架构的超参数。
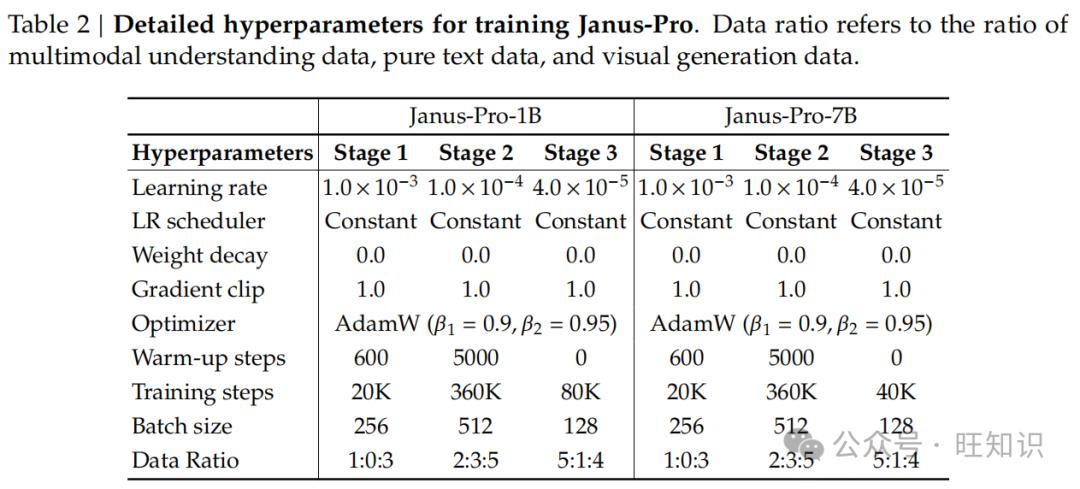
表2 Janus-Pro训练的详细超参数。数据比例指多模态理解数据、纯文本数据和视觉生成数据的比例。
3. 实验
3.1. 实现细节
在我们的实验中,我们使用最大支持序列长度为4096的DeepSeek-LLM(15亿和70亿参数)作为基础语言模型。对于理解任务中使用的视觉编码器,我们选择SigLIP-Large-Patch16-384。生成编码器的码本大小为16384,将图像下采样16倍。理解适配器和生成适配器均为两层多层感知器(MLP)。每个阶段的详细超参数见表2。所有图像均调整为384×384像素。对于多模态理解数据,我们调整图像长边大小,并使用背景颜色(RGB:127, 127, 127)填充短边至384。对于视觉生成数据,短边调整为384,长边裁剪为384。在训练过程中,我们使用序列打包来提高训练效率。我们按照指定比例在单个训练步骤中混合所有数据类型。我们使用HAI-LLM训练和评估Janus,HAI-LLM是一个基于PyTorch构建的轻量级高效分布式训练框架。整个训练过程在16/32节点的集群上进行,每个节点配备8个Nvidia A100(40GB)GPU,15亿/70亿参数模型的训练分别耗时约7/14天。
3.2. 评估设置
多模态理解:为了评估多模态理解能力,我们在广泛认可的基于图像的视觉语言基准测试中对模型进行评估,这些基准测试包括GQA、POPE、MME、SEED、MMBench、MM-Vet和MMMU。
视觉生成:为了评估视觉生成能力,我们使用GenEval和DPG-Bench。GenEval是一个具有挑战性的图像到文本生成基准测试,旨在通过对模型的组合能力进行详细的实例级分析,反映视觉生成模型的综合生成能力。DPG-Bench(密集提示图基准测试)是一个综合性数据集,由1065个冗长、密集的提示组成,旨在评估文本到图像模型复杂的语义对齐能力。
3.3. 与最先进模型的比较
多模态理解性能:我们在表3中将所提出的方法与最先进的统一模型和仅理解模型进行比较。Janus-Pro取得了总体最佳结果。这归因于对多模态理解和生成的视觉编码进行解耦,减轻了这两个任务之间的冲突。与规模明显更大的模型相比,Janus-Pro仍然极具竞争力。例如,Janus-Pro-7B在除GQA之外的所有基准测试中均优于TokenFlow-XL(130亿参数)。
表3 多模态理解基准测试与最先进模型的比较。“Und.”和“Gen.”分别表示“理解”和“生成”。使用外部预训练扩散模型的模型用†标记。视觉生成性能:我们在GenEval和DPG - Bench上报告视觉生成性能。如表4所示,我们的Janus - Pro - 7B在GenEval上获得了80%的总体准确率,超过了所有其他统一模型或仅生成模型,例如Transfusion(63%)、SD3 - Medium(74%)和DALL - E 3(67%)。这表明我们的方法具有更好的指令遵循能力。如表5所示,Janus - Pro在DPG - Bench上得分84.19,超过了所有其他方法。这表明Janus - Pro在遵循密集指令进行文本到图像生成方面表现出色。
表4 GenEval基准测试上文本到图像生成能力评估。“Und.”和“Gen.”分别表示“理解”和“生成”。使用外部预训练扩散模型的模型用†标记。
表5 DPG - Bench上的性能。此表中的方法除Janus和Janus - Pro外均为特定生成模型。
3.4. 定性结果
我们在图4中展示多模态理解的结果。Janus - Pro在处理来自各种上下文的输入时表现出令人印象深刻的理解能力,展示了其强大的性能。我们还在图4的下半部分展示了一些文本到图像生成的结果。Janus - Pro - 7B生成的图像高度逼真,尽管分辨率仅为384×384,但仍然包含许多细节。对于富有想象力和创意的场景,Janus - Pro - 7B能够准确捕捉提示中的语义信息,生成逻辑合理且连贯的图像。
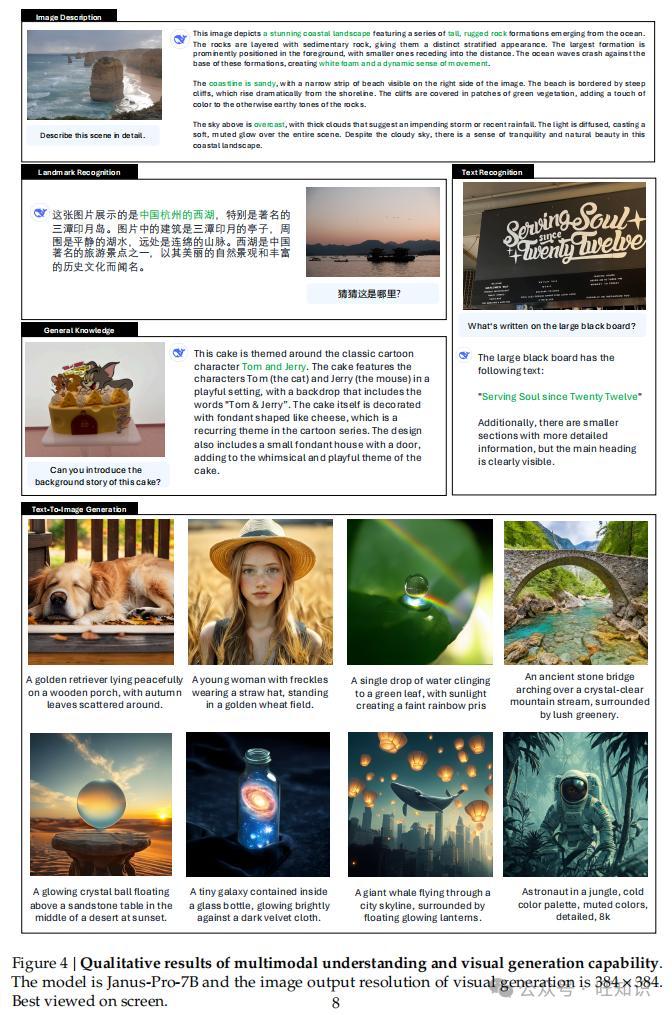
图4 多模态理解和视觉生成能力的定性结果。模型为Janus - Pro - 7B,视觉生成的图像输出分辨率为384×384。建议在屏幕上查看以获得最佳效果。
4. 结论
本文从训练策略、数据和模型大小三个方面介绍了对Janus的改进。这些增强在多模态理解和文本到图像指令遵循能力方面带来了显著进展。然而,Janus - Pro仍然存在一些局限性。在多模态理解方面,输入分辨率限制在384×384,这影响了其在诸如光学字符识别(OCR)等细粒度任务中的性能。对于文本到图像生成,低分辨率加上视觉分词器引入的重建损失,导致生成的图像虽然语义内容丰富,但仍然缺乏精细细节。例如,在有限图像空间中占据较小区域的面部可能看起来细节不足。提高图像分辨率可能会缓解这些问题。
作者:张长旺,图源:旺知识
参考资料
标题:Janus-Pro: Unified Multimodal Understanding and Generation with Data and Model Scaling
作者:Xiaokang Chen, Zhiyu Wu, Xingchao Liu, Zizheng Pan, Wen Liu, Zhenda Xie, Xingkai Yu, Chong Ruan
单位:DeepSeek-AI
标签:多模态模型、文本到图像生成、模型扩展、训练策略优化、数据扩展
概述: 本文介绍Janus-Pro,它通过优化训练策略、扩展训练数据和扩大模型规模,在多模态理解和文本到图像指令遵循能力上取得显著进展,还增强了文本到图像生成的稳定性。
https://github.com/deepseek-ai/Janus/blob/main/janus_pro_tech_report.pdf