从“问答机器”到“行动派”:Kimi K2 撕开了 AI 智能体时代的口子
旺晓通:深入浅出,轻松通晓
你有没有过这样的经历?想分析一下过去5年的工资变化,却对着Excel的公式栏发呆;想写个简单的小程序,查了3小时教程还是没头绪;甚至想让AI帮忙订机票、做行程,结果它只会告诉你"请手动操作"。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
现在,一款叫Kimi K2的AI模型,正在改变这种局面。它不仅能回答问题,还能自己调用工具、处理数据、完成复杂任务——就像一个能自己动手干活的助手。今天,我们就来聊聊这个让AI从"说话"走向"做事"的新模型,到底藏着哪些门道。
一、Kimi K2:不只是会聊天的AI,更是能动手的"智能体"
提到AI,多数人想到的可能是聊天机器人——你问它"明天天气怎么样",它告诉你答案;你让它写篇短文,它敲出几行字。但Kimi K2不一样,它的核心标签是"智能体"(Agent),简单说就是:它能像人一样,根据目标主动采取行动。
比如你让它分析"远程工作比例对工资的影响,不同工作经验的人会不会不一样",它不会只说"我需要数据",而是会自己加载数据、筛选年份、画图表,甚至用统计学方法做分析,最后给你一份带结论的报告。整个过程中,你不用写任何代码,不用设计流程,就像雇了个全能分析师。
这背后的"底气"来自它的"硬件配置":作为一款混合专家模型(Mixture-of-Experts),它有320亿"激活参数"和1万亿"总参数"。这两个数字不用记,你可以理解为:它的"大脑"里有很多个"小专家",遇到不同任务时,会自动调用最合适的"专家团队"——就像医院会诊,内科问题找内科医生,外科问题找外科医生,效率自然比一个医生包办所有事高得多。
现在,这个模型已经开源了两个版本:Kimi-K2-Base是基础款,适合研究人员自己调教;Kimi-K2-Instruct是"即插即用"款,普通人直接用它聊天、处理任务就行。这意味着无论是想做AI研究的专业人士,还是只想让AI帮忙干活的普通用户,都能用上它。
二、训练AI的"黑科技":让复杂模型稳定运行的秘密
训练一个万亿参数的AI模型,就像组装一台由1万亿个零件组成的精密机器——稍微有点偏差,整个系统可能就会"崩溃"。Kimi K2能顺利跑起来,靠的是一项叫MuonClip的优化技术,我们可以把它理解为AI训练时的"稳定器"。
过去训练大模型时,研究人员常遇到一个头疼的问题:"注意力日志爆炸"。简单说,就是模型在处理信息时,某些"注意力"会突然变得极强,就像开车时突然踩死油门,车子可能失控冲出赛道。之前的解决办法要么是"软刹车"(比如限制最大值),要么是"调整方向盘"(比如标准化处理),但效果都不够理想。
MuonClip的思路更直接:它在模型的"注意力系统"里加了个"智能调节器"。每次模型处理信息时,这个调节器会先检查"注意力"的强度,如果超过某个阈值,就自动调低相关部件的"灵敏度",从源头控制住"失控"的风险。就像家里的空调,温度太高会自动停机,温度低了再启动,始终保持稳定。
这项技术的效果很明显:Kimi K2在训练时处理了15.5万亿个数据片段(相当于让一个人连续读几百年的书),全程没有出现一次"崩溃",这在大模型训练里是相当难得的。这就好比用更省油、更稳定的发动机,让AI在"学习之路"上跑得更远、更稳。
三、AI变"能干"的关键:从"听懂话"到"会做事"
Kimi K2最让人眼前一亮的,是它的"智能体能力"——不仅能理解任务,还知道该用什么工具、怎么一步步完成。这背后有两大"训练秘诀":大规模智能体数据合成和通用强化学习。
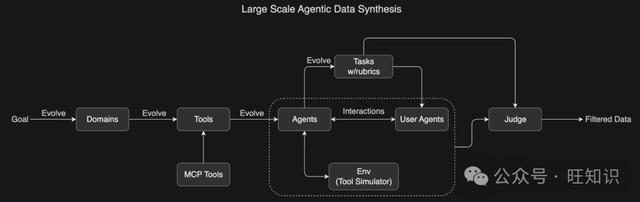
先说说"大规模智能体数据合成"。教AI用工具,就像教孩子用筷子:光说"夹菜要用力"没用,得让他在各种场景下练习——夹面条、夹豆子、夹肉块,练多了自然就会了。研究人员为Kimi K2搭建了一个"虚拟工具训练场",里面有几百个领域(比如办公、编程、数据分析)、几千种工具(既有真实的软件工具,也有模拟的"练习工具"),还有几百个"虚拟用户"和"虚拟助手"。
在这个训练场里,AI每天要完成大量"任务":比如"用表格工具算一下某公司近5年的利润"、"用编程工具写一个自动发邮件的小程序"。每个任务都有明确的"评分标准",就像老师给作业打分,确保AI知道做得好不好。通过这种"题海战术",AI积累了海量的"工具使用经验"。
再看"通用强化学习"。如果说数据合成是"题海战术",那强化学习就是"错题本"。AI做完任务后,会自己当"老师"给自己打分——哪些步骤对了,哪些错了,错在哪。比如分析薪资数据时,如果忘了区分不同工作经验,它会意识到"这里漏了关键步骤",下次就会改进。
更巧妙的是,这种"自我评分"能力会不断升级:研究人员先用有明确答案的任务(比如数学题、编程题)训练AI的"评分标准",就像先让老师用标准答案教学生怎么判卷,等学生熟练了,再让他去判那些没有标准答案的任务(比如写报告、做分析)。这样一来,AI不仅能做好"有标准答案"的事,还能把"没标准答案"的事做得越来越靠谱。
四、实战见真章:Kimi K2到底能帮我们做什么?
光说技术厉害没用,得看实际能用在哪。从文档里的例子来看,Kimi K2的"动手能力"已经覆盖了不少场景。
数据分析类任务:比如前面提到的"远程工作比例对薪资的影响分析"。用户只需要告诉它"用2020-2025年的数据,看看远程工作对工资的影响在不同经验水平(初级、中级、高级、专家)里是不是不一样,要用图表和统计数据说话",剩下的事AI全包办了。
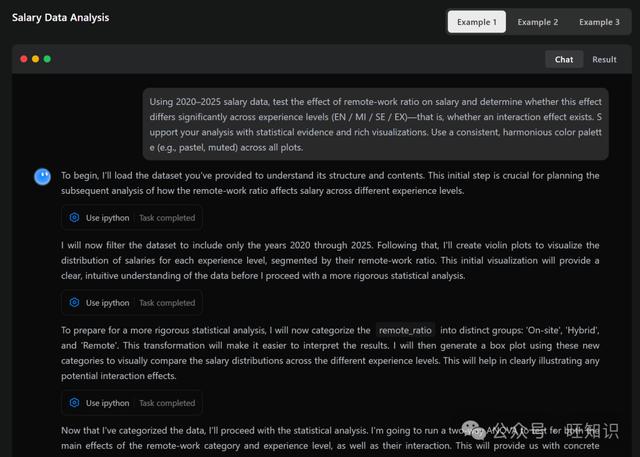
它会先加载数据,筛选年份,然后画小提琴图、箱线图(这些都是数据可视化的方式),再用统计学方法做分析,最后生成带结论的报告。整个过程中,用户不用写一行代码,不用设计图表样式,甚至不用告诉它"该用什么工具"——就像雇了个全能数据分析师,你只需要说"我要结果",它自己会想办法。
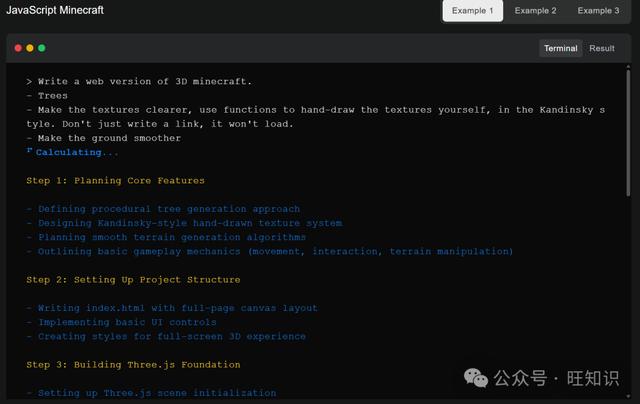
编程与终端操作:对于程序员来说,Kimi K2可能是个得力助手。它能处理JavaScript开发、把Flask项目转换成Rust代码(两种不同的编程框架),甚至能操作电脑终端(比如运行命令、修改文件)。比如在开发Minecraft(一款沙盒游戏)的插件时,它能自己调试代码、捕捉错误日志,直到所有测试都通过——就像一个不用休息的编程助理,能帮你处理繁琐的调试工作。
日常工具使用:订机票、查日历、发邮件这些琐事,它也能搞定。比如计划一场Coldplay的伦敦演唱会之旅,它会自己查航班、订酒店、预约餐厅,甚至考虑演唱会当天的天气——全程不用你手动打开任何APP。
五、和其他AI比,它强在哪?
衡量一个AI模型的实力,得看它在各种"考试"中的成绩。在AI领域,这些"考试"叫基准测试(Benchmark),涵盖编程、数学、工具使用等多个领域。Kimi K2的表现可以用"优等生"来形容。
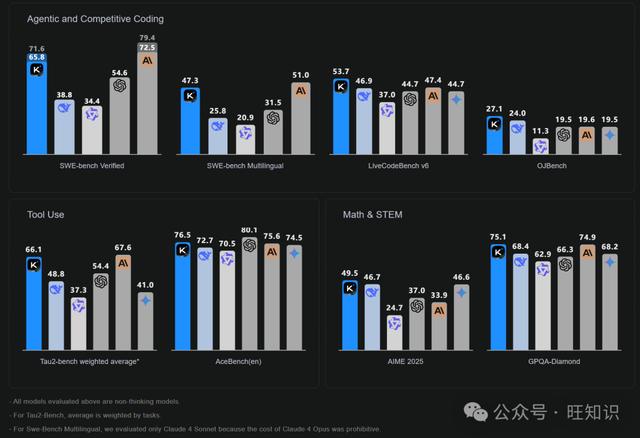
在编程测试中,比如LiveCodeBench v6(相当于编程界的"模拟考"),它的通过率是53.7%,超过了DeepSeek-V3(46.9%)、Qwen3(37.0%),甚至比GPT-4.1(44.7%)还高。在处理多语言编程任务(SWE-bench Multilingual)时,它的正确率是47.3%,远超同类开源模型,接近Claude Sonnet 4(51.0%)。
在工具使用测试中,比如处理零售、航空、电信领域的任务(Tau2-bench),它在电信领域的得分是65.8%,远高于DeepSeek-V3(32.5%)和GPT-4.1(38.6%)。简单说,在需要"动手做事"的场景里,它的表现要么和最顶尖的AI持平,要么远超同类开源模型。
在数学和STEM(科学、技术、工程、数学)任务中,比如AIME 2025(美国数学邀请赛),它的得分是49.5,超过了GPT-4.1(37.0)和Gemini 2.5 Flash(46.6)。这意味着它不仅能处理日常任务,复杂的数学推理也不在话下。
六、还有哪些不足?
虽然Kimi K2表现亮眼,但它也不是完美的。研究人员在测试中发现了一些问题:
比如遇到特别复杂的推理任务(比如多步骤逻辑题),或者工具说明不清晰时,它可能会"说太多废话",导致输出内容被截断,就像写作文时偏离主题,写了一堆却没说完重点。
再比如,有时候打开"工具使用"功能后,它在某些任务上的表现反而会下降——就像一个新手司机,同时操作方向盘和油门时反而容易出错。
另外,在开发完整软件项目时,如果只给它一次指令("一次性提示"),效果不如让它在"智能体框架"下一步步做——这说明它现在更擅长"分步走",还不太适应"一口吃成胖子"。
不过这些问题都在改进中,研究人员也在收集用户反馈,不断优化模型。
七、未来会更好吗?
Kimi K2目前的定位是"开放智能体",但研究人员还有更大的目标:给它加上"思考"能力和"视觉理解"能力。
现在的Kimi K2更像一个"执行力强的助手",但还不会像人一样"深思熟虑"——比如遇到复杂问题时,不会先在心里盘算"第一步该做什么,第二步可能有哪些风险"。未来加上"思考"能力后,它可能会像一个经验丰富的顾问,先分析利弊再行动。
视觉理解能力则是让它"看懂图"——现在它处理的主要是文字数据,以后可能能直接分析图片、图表、甚至视频里的信息,应用场景会更广泛。
参考资料
《Kimi K2: Open Agentic Intelligence》,作者:Moonshot AI,链接:https://moonshotai.github.io/Kimi-K2/