ICML25上下文增强学习解读:给大模型学习 “不强制背的参考书”
旺晓通:深入浅出解读,轻松通晓技术
你有没有过这种经历?明明对着答案刷题刷了一下午,可稍微换个题型就懵了;但如果做题时旁边放着课本的重点笔记,哪怕不刻意背,进步也快得惊人。最近我在研究大语言模型(LLMs)训练时,发现它们居然也有类似的"学习习惯"——这就是ICML25文章最新探索的"上下文增强学习"(context-enhanced learning),一个能让AI学得又快又不容易"泄露秘密"的新方法。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
先聊聊:AI平时是怎么"学习"的?
要理解这个新方法,得先说说大模型传统的"学习套路"。现在让AI掌握新技能,比如翻译、解数学题,最常用的是"监督微调"(SFT)——简单说就是给模型看一堆"输入-输出"样本,比如"2+3=?"和答案"5",让它通过不断调整参数,慢慢学会从输入猜到输出。
但这种方法有个大问题:学得太慢,还容易学不会。就像让一个从没学过英语的人直接背"Hello=你好"、"Goodbye=再见",没有语法书和例句参考,哪怕背再多句子,遇到"Hi"还是可能懵圈。
更麻烦的是,如果要学的任务稍微复杂点,比如多步骤推理(比如把"中文→英文→法文"这种多层翻译),传统微调需要的样本量会爆炸式增长。我们在实验里发现,有些任务用传统方法可能需要百万级样本,而用新方法只需要几万就够了——这差距,就像别人做100道题掌握的知识,你做10道就吃透了。
上下文增强学习:给AI配一本"不强制背的参考书"
那这个"上下文增强学习"到底是啥?其实思路特别朴素:训练时给模型额外的"参考资料",但不强迫它记住这些资料。
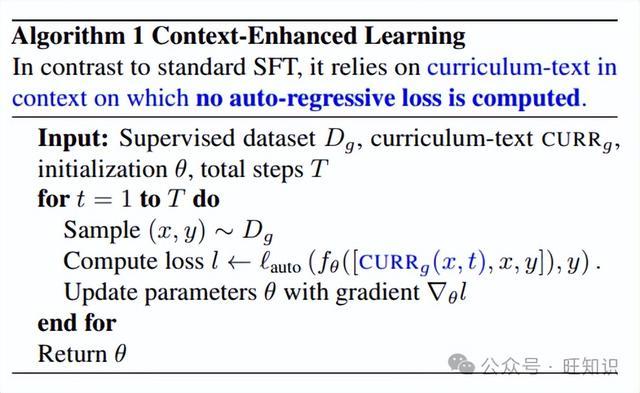
比如教模型做多层翻译时,我们会在训练材料里加入"短语手册"(比如"中文→英文"的对应规则),但模型只需要对最终翻译结果负责,不用管这些手册内容对不对。就像老师让学生做翻译题时,允许翻看短语手册,但只批改翻译结果——学生自然会学会参考手册里的规则,而不是死记硬背题目。
这里的关键是"不计算参考资料的损失":传统方法会让模型连参考资料一起学(比如要求模型复述手册内容),而新方法里,参考资料就像图书馆的书,用了就还,模型只需要学会怎么用,不用背下来。
为什么这方法这么高效?三个关键发现
论文用一个叫"多层翻译"(MLT)的任务做了实验——简单说就是设计几种"人造语言",比如L1→L2→L3→...→Ld+1,每层翻译都有规则,最终要让模型直接从L1翻到Ld+1,不显示中间步骤。
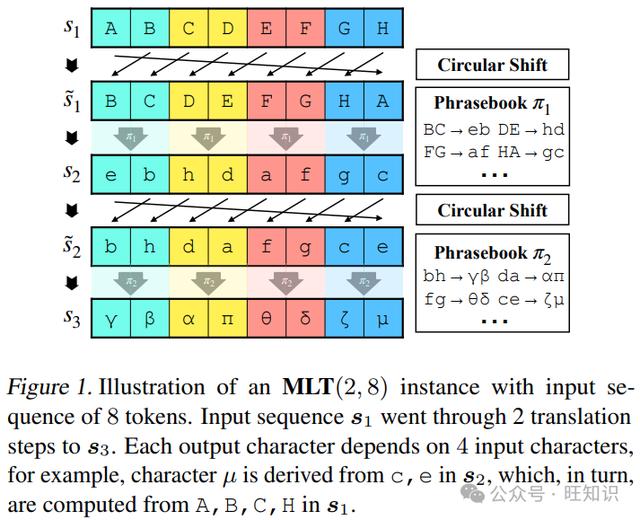
实验结果挺惊讶的,总结下来有三个核心发现:
1. 样本效率呈"指数级提升"
同样学MLT任务,传统微调可能需要100万个样本才能达到90%正确率,而用上下文增强学习,只需要10万个甚至更少。这就像两个人学下棋,一个只看棋谱,一个旁边放着"战术手册",后者进步速度肉眼可见。
为什么会这样?论文发现上下文提供了更准的"梯度信号"。就像学生做题时,参考书能帮他更快找到错误原因("哦,原来这步该用这个公式"),模型的参数调整方向也更明确,少走很多弯路。
2. 模型会"循序渐进"地内化知识
论文设计了一个"逐步撤掉参考书"的策略:一开始给全所有短语手册,然后慢慢随机删掉一些规则(比如从0% dropout到100%)。结果模型不仅没懵,反而慢慢把手册里的规则"内化成自己的能力"。
这特别像老师教学生:先让学生带着课本做题,然后逐渐收走课本,最后学生哪怕没课本,也能熟练运用知识。我们观察模型的中间层发现,它会把不同层的翻译规则,对应存到自己的不同神经网络层里,就像图书馆的书按类别上架,井然有序。
3. 学了就忘?不,是"会用但不说"
最有意思的一点是:模型学完后,你很难从它的输出里反推出它用过的参考资料。
作者试过各种方法,比如让模型补全短语手册里的规则,结果它的正确率和瞎猜差不多(比如只有1%左右)。就像一个学生用一本秘籍学会了解题,但你问他秘籍里写了啥,他说不上来——这对数据安全太重要了,意味着可以用一些敏感资料当参考,又不用担心模型"泄密"。
这方法到底有啥用?说两个实际价值
别看这是实验室里的研究,它的潜在影响其实挺实在的:
1. 大幅降低AI训练成本
现在训练大模型动不动就需要海量数据,不仅费钱,还可能因为数据不够导致效果差。上下文增强学习能让模型用更少数据达到同样效果,相当于"用更少的食材做出同样的好菜",这对中小企业开发AI特别友好。
2. 平衡"学习效率"和"数据隐私"
很多时候,最有价值的参考资料可能涉及版权或隐私(比如企业内部手册、专业教材)。用这种方法,模型可以参考这些资料提升能力,但不会把资料内容记下来泄露出去——就像律师办案时参考保密案卷,能打赢官司但不会泄露案卷细节。
最后说句大实话:它不是万能的
当然,这方法也有局限。比如它特别依赖模型的"上下文学习能力"(ICL)——如果模型本身就不会"参考资料"(比如一些小模型),那给再多参考资料也没用。就像给一个还不会查字典的孩子一本词典,他也用不上。
另外,目前主要在合成任务上验证了效果,要用到更复杂的真实场景(比如医疗诊断、代码生成),还需要更多实验。但不管怎么说,这种"让模型聪明地学,而不是死记硬背"的思路,可能是未来AI训练的重要方向。
如果你也觉得"让AI更高效、更安全地学习"是个有意思的话题,欢迎在评论区聊聊——你觉得哪些领域最需要这种技术?是教育、医疗,还是隐私保护?
参考资料
• 标题:On the Power of Context-Enhanced Learning in LLMs
• 作者:Xingyu Zhu, Abhishek Panigrahi, Sanjeev Arora
• 链接:https://arxiv.org/pdf/2503.01821.pdf