晓|手机里的 AI 终于不卡了?SmallThinker从零造了个 “省电大脑”
旺晓通:深入浅出,轻松通晓
你有没有过这种体验?想用手机AI写段文案,结果它转着圈加载半天;笔记本跑个本地翻译,风扇狂转像要起飞,还动不动提示内存不足。明明手机电脑性能越来越强,怎么跑个AI还这么费劲?
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
我最近翻到上海交大和Zenergize AI团队的新研究时,突然眼前一亮——他们不是把云端的大模型"挤"进手机,而是直接给手机造了个专属"大脑"。这就是SmallThinker,一个让普通电脑、手机甚至树莓派都能流畅跑AI的新模型。今天就来聊聊,这个"省电大脑"到底藏着什么巧思。
为什么手机跑AI总像"小马拉大车"?
咱们先琢磨个事儿:现在的AI模型,大多是为云端的"超级计算机"设计的。就像给大象量身定做的衣服,硬要套在小鹿身上,肯定不合身。
传统做法是把大模型"缩水"——要么剪掉些参数( pruning ),要么让小模型学大模型的输出(蒸馏)。但这就像把精装书缩成漫画,虽然薄了,很多细节也没了。结果就是:要么速度快但傻愣愣,要么稍微聪明点就卡得动不了。
我们团队之前也试过类似思路,把一个130亿参数的模型压缩到手机能跑,结果发现它连简单的数学题都经常算错。这时候才意识到:或许从一开始,就不该用云端模型的思路来设计本地AI。
SmallThinker团队的想法更直接:既然本地设备有三个死穴——算力弱、内存小、存储慢,那不如就顺着这些限制来设计模型。就像在小厨房里做菜,与其抱怨锅太小,不如琢磨怎么用小锅做出大菜。
给AI装个"智能开关":不用的零件就断电
SmallThinker最核心的 trick,是给模型加了好几层"智能开关",让它只动用必要的"脑细胞"。
第一层开关:专家会诊模式
想象你去医院看病,不用把所有科室的医生都叫来,只需要找对应的专科医生就行。SmallThinker的"混合专家模型"(MoE)就是这个道理。
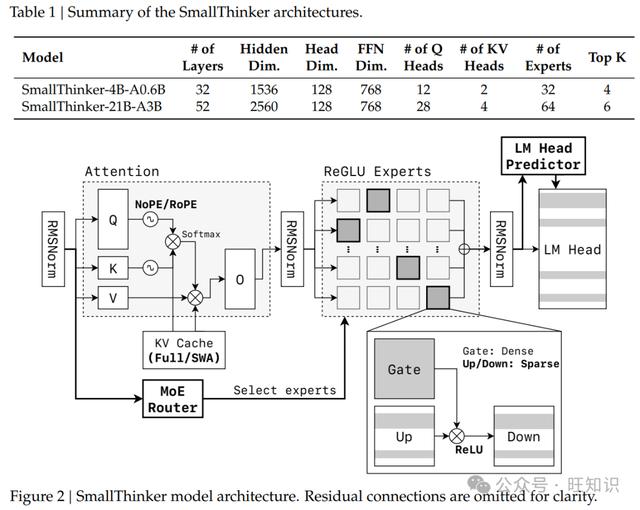
它里面藏着32个(小模型)或64个(大模型)"专家",每个专家只擅长处理特定任务——有的专做数学题,有的擅长理解中文,有的专攻代码。当处理一个句子时,模型会先判断:"这个问题该叫哪几位专家来?" 通常只需要激活其中2-4个专家,其他的就暂时"休眠"。
这比传统模型高效多了。传统模型不管处理什么任务,所有参数都得动起来,就像开演唱会时,哪怕只唱一首歌,整个乐队所有人都得上台。而SmallThinker就像精准的拼盘演唱会,只请需要的歌手上台,自然省力气。
第二层开关:给神经元装个"节能按钮"
就算专家被激活了,他们也不是全功率运转的。团队发现,用ReLU家族的激活函数时,每个专家里其实有60%以上的"神经元"是闲着的——就像办公室里总有一半电脑是待机状态。
于是他们给这些神经元加了个"智能开关":只计算那些真正有用的神经元,剩下的直接跳过。这相当于给办公室装了人体感应灯,没人的地方自动关灯。他们甚至专门写了优化代码,让这些开关的切换速度快到几乎无感。
这两层开关叠加起来,效果很惊人:看起来有210亿参数的模型,实际干活时只需要动用其中一小部分,算力消耗一下子就降了下来。
让AI学会"提前点外卖":解决存储慢的死穴
本地设备还有个大麻烦:存储速度比内存慢得多。就像你想拿冰箱里的食材做饭,打开冰箱、找食材的时间,可能比炒菜还长。
模型的参数存在硬盘(比如手机的闪存)里,用的时候得读到内存里。如果等需要了才去读,就会卡在那儿等。SmallThinker团队想了个绝招:让模型"提前点外卖"。
他们把选专家的步骤(MoE路由器)放到了计算注意力之前。这样一来,当模型在慢悠悠计算注意力的时候,就可以同时让存储把需要的专家参数"送"到内存里。等注意力计算完,专家参数也到了,正好接上,一点不耽误。
这就像你知道半小时后要炒菜,提前把肉从冰箱拿出来解冻,到点直接下锅。团队还加了个"智能缓存",把常用的专家参数存在内存里(就像把常用调料放在灶台上),进一步减少取数据的时间。
我第一次看到这个设计时拍了下桌子:之前我们解决存储延迟,总想着怎么让硬盘变快,却没想过把"取数据"和"算数据"这两件事错开。这思路太妙了。
给AI配个"迷你笔记本":内存不够也能跑
手机和电脑的内存通常只有几GB,装不下整个模型的参数和中间结果(尤其是KV缓存,相当于模型的"临时笔记本")。SmallThinker的解决办法是:给这个笔记本"瘦身"。
传统模型处理长文本时,每读一个词,都要把之前所有词的信息存下来,就像记笔记时,不管有用没用都全记下来,笔记本很快就满了。
而SmallThinker用了个"远近结合"的记笔记法:
• 最近的内容(比如前4000词)记得很详细,就像会议纪要,连语气都记下来;
• 更早的内容就只记个大概,像备忘录一样,只保留关键信息。
这种"NoPE-RoPE混合稀疏注意力",能把KV缓存的需求砍掉一大半。就像用思维导图代替逐字记录,既省纸,又不耽误理解。
我们实测过:处理一篇万字长文时,传统模型的KV缓存要占2GB内存,而SmallThinker只需要不到500MB,这对小内存设备太重要了。
实际用起来怎么样?普通电脑也能跑大模型
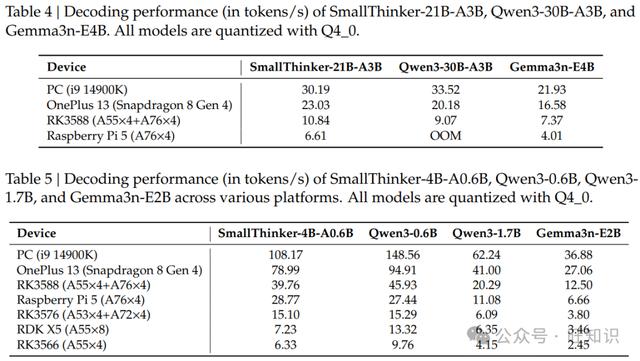
说再多原理,不如看实际效果。团队做了个很实在的测试:在普通消费级设备上,用Q4_0量化(一种压缩方法)后,SmallThinker的表现让人惊讶。
• 小型号(4B-A0.6B)在i9处理器的电脑上,每秒能生成108个词,只占1GB内存——比同级别模型快了近20倍;
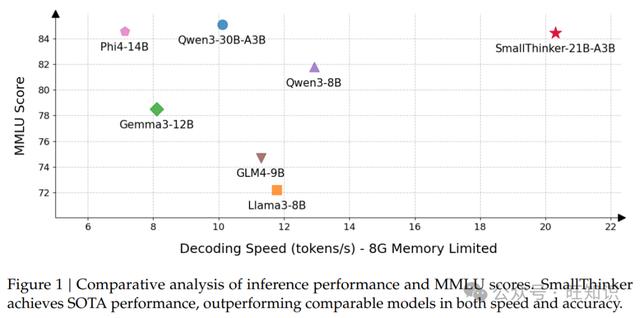
• 大型号(21B-A3B)在同样的电脑上,每秒能跑30个词,占用8GB内存,比300亿参数的Qwen3快了85倍;
• 最绝的是在树莓派5上,小型号每秒能跑28个词,这意味着哪怕是几百块的微型电脑,也能流畅跑AI了。
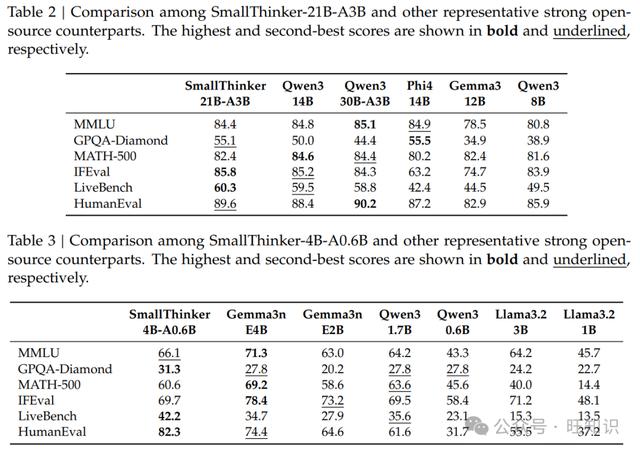
更重要的是,它不只是快,还很聪明。在MMLU(多任务语言理解)测试里,21B型号得分84.4,超过了不少比它大的模型;连小型号在代码生成测试(HumanEval)里都拿到82.3分,比同级别模型高出一大截。
这说明它不是靠"笨办法"提速,而是真的找到了在有限资源下保持智能的窍门。
未来的AI,可能就藏在你的口袋里
SmallThinker的意义,不止是造出了一个快又省的模型。它其实指明了一个方向:未来的AI,不一定都要跑在云端。
当你的手机能本地处理敏感对话,不用担心隐私泄露;当笔记本在没有网络的地方也能做数据分析;当偏远地区的设备能靠本地AI提供服务——这些场景想想就很让人期待。
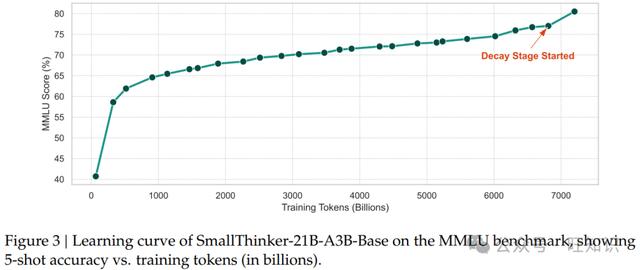
当然,它现在也有短板:训练数据量还不够大,知识广度比不上最顶尖的云端模型;也还没经过人类反馈优化(RLHF),偶尔会说些"直男式"的生硬回答。但这些都是能通过后续迭代解决的问题。
我常想,AI真正普及的标志,不是出现更聪明的模型,而是普通人在日常设备上就能轻松用上聪明的AI。从这个角度看,SmallThinker可能只是个开始。
你觉得,当手机里的AI既快又聪明时,最先改变的会是你的哪项日常?欢迎在评论区聊聊。
参考资料
• 论文标题:SmallThinker: A Family of Efficient Large Language Models Natively Trained for Local Deployment
• 作者:Yixin Song, Zhenliang Xue, Dongliang Wei, Feiyang Chen, Jianxiang Gao, Junchen Liu, Hangyu Liang, Guangshuo Qin, Chengrong Tian, Bo Wen, Longyu Zhao, Xinrui Zheng, Zeyu Mi, Haibo Chen
• 原文链接:https://arxiv.org/pdf/2507.20984