晓|从“单个裁判”到“辩论团”:AI评委进化史
旺晓通:深入浅出,轻松通晓
你有没有过这种经历?跟AI聊天时,它的回答看起来头头是道,细想却发现逻辑拧巴;或者用AI写报告,明明感觉不对,但又说不出哪里错——毕竟,我们怎么判断一个"AI专家"的输出靠不靠谱?
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
最近翻新论文时,我发现了一个挺颠覆的思路:现在连评估AI的活儿,都开始交给AI自己干了。这篇叫《When AIs Judge AIs》的论文,把"AI当裁判"的来龙去脉讲得透透的。读完第一感觉是:这步棋早该走了,但没想到能玩这么花。
为啥非要让AI当裁判?传统方法太"拉胯"
说起来,给AI打分这事儿,学界头疼了好多年。以前无非两种办法,结果都不太理想。
一种是请人类专家来评。这就像请米其林评委给餐厅打分,专业是专业,但架不住"贵、慢、少"。评估一个复杂的AI对话系统,可能要请十几个专家耗上几周,成本高到离谱。更麻烦的是,人类打分还容易"带情绪"——早上没喝咖啡的评委,可能给同一篇AI作文打低3分。
另一种是用机器自动算分,比如BLEU、ROUGE这些指标。它们的套路是数句子里重复的词语,有点像老师批改作文只看"跟范文重合了多少字"。但AI现在都能写小说、编代码了,光看词语重复率根本没用。比如AI写"医生建议多喝水",人类知道这是对的;但机器可能因为没跟范文"医师推荐增加饮水量"重合,就打低分。
所以当GPT-4这类大模型出来时,有人突然想到:既然它们能理解复杂文本,为啥不能让它们当评委?这就是"LLM-as-a-Judge"的由来——简单说,就是请一个更聪明的AI,按照人类制定的标准,给其他AI的输出打分。
从"单个裁判"到"辩论团":AI评委进化史
但事情没这么简单。最开始的AI裁判,问题不少。
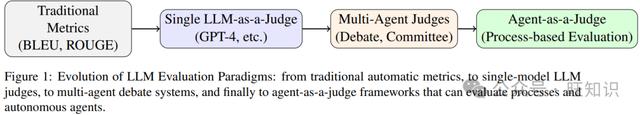
比如用GPT-4当单裁判,它可能偷偷"偏心"。有研究发现,它会给长得像自己写的答案打高分,就像老师偏爱跟自己笔迹像的学生。更逗的是,它还可能被"花架子"骗了——一段onsense的文字,只要写得流畅华丽,居然能拿到高分。
这就像体育比赛只请一个裁判,万一他刚好没看清某个犯规,结果就跑偏了。于是研究者们想:人类评复杂事儿都要开个评审会,AI为啥不行?
于是"多智能体评委"登场了。这思路跟《奇葩说》辩论有点像,多个AI扮演不同角色吵一架,最后汇总结论。
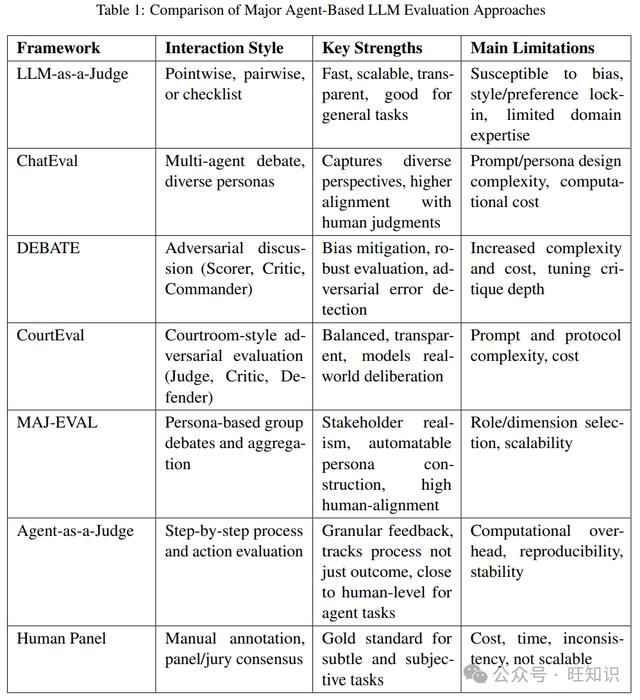
比如ChatEval框架,会让三个AI分别扮演"事实核查员"、"语言流畅度评委"、"用户体验官",就像三个食客争论:"这道菜食材新鲜吗?""摆盘好看吗?""吃着舒服吗?"吵完一轮,得分反而比单个AI准10%-16%。
更绝的是DEBATE框架,直接安排"正方、反方、主持人"。"正方"先给AI输出打个分,"反方"立刻挑刺:"你漏看了这里的逻辑错误!"主持人再协调。这就像法庭上检察官和律师对喷,最后法官再拍板,想偏袒都难。
我们团队之前也试过类似的方法,但没敢让AI"互怼"这么彻底。论文里说这种" adversarial 评审"能减少偏见,这点我深表认同——毕竟,真理越辩越明,AI也一样。
连过程都要评!最秀的"裁判AI"会盯全程
如果说多智能体辩论是"升级款",那"Agent-as-a-Judge"就是"顶配版"了。
这招专门针对会"做事"的AI,比如能写代码、能规划行程的AI智能体。以前评估这类AI,只看"最后结果对不对",就像看学生解题只看答案,不管过程。但代码写对了,可能是瞎蒙的;行程规划成了,可能绕了远路。
"Agent-as-a-Judge"就像个严格的数学老师,不仅看答案,还会盯着你的草稿纸:"这步为什么用这个公式?""这里计算错了吧?"它会一步步跟踪被评估AI的行动,比如写代码时是否检查语法、调用工具时是否选对了方法。
论文里有个例子特别惊艳:用它评估AI代码助手,居然能发现"虽然最后代码能跑,但中间有三次没必要的调试"。这种细节,别说机器自动评估,连人类专家都可能漏掉。更牛的是,它的打分跟5个资深程序员的集体意见重合度高达99.7%,单个人类专家反而只有69%。
这些AI裁判,现在都在哪干活?
说这么多,这些AI裁判真的能用吗?论文里举的几个领域案例,看得我直呼"实用"。
医疗领域:评估AI写的病历总结时,单个人类医生可能漏看"药物过敏提示"。但多智能体评委可以分角色——一个扮演"主治医生"查专业性,一个扮演"患者"看是否易懂,一个扮演"伦理专家"查是否泄露隐私。有次评估发现,某AI总结漏了"患者青霉素过敏",就是"患者角色"的AI指出来的。
法律领域:模拟法庭辩论的AI系统,现在用"法庭式评委"——一个AI当法官,一个当检察官(挑错),一个当辩护律师(维护)。比如评估AI起草的合同,检察官AI会揪"这条款违反了XX法律第3款",辩护AI会说"但结合上下文可以解释为...",最后法官AI综合给分。这比人类律师省钱多了,还不怕被贿赂。
教育领域:给儿童故事AI打分时,评委AI会分别扮演"老师"(查知识点)、"家长"(看是否适合孩子)、甚至"小朋友"(看是否有趣)。有个案例特别逗:"小朋友角色"的AI给一个故事打低分,理由是"里面的恐龙不够凶,不好玩"——这角度,人类评委可能根本想不到。
但AI裁判还不是"完美神",这些坑得填
尽管AI裁判进步飞快,但论文也没藏着掖着,把问题摆得明明白白。
最头疼的是"偏见传染"。如果几个评委AI都来自同一个模型家族(比如都用GPT系列),可能会集体"带节奏"。就像一群同一所学校毕业的评委,可能都偏爱某种风格的作品。
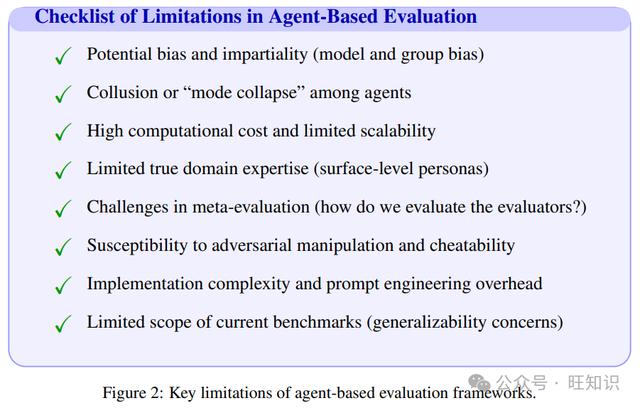
成本也是个大问题。多智能体辩论一次,相当于同时调用3-5个大模型,费用是单裁判的好几倍。有团队算过,评估1000个AI输出,多智能体评委可能要花上万美元——这对中小企业来说,还是太贵。
更麻烦的是"被忽悠"。虽然多智能体评委比单裁判难骗,但架不住有人专门研究"怎么哄骗评委AI"。比如知道评委重视"事实准确",就故意在回答里塞满正确但无关的知识点,分散注意力。
不过这些问题,论文里给了方向。比如用不同家族的模型当评委(GPT-4+Claude+LLaMA),减少同温层偏见;或者让评委AI学会"查资料",不确定的地方自己搜一搜再打分。
未来:AI裁判不是要取代人类,而是当"超级助手"
说到底,AI当裁判不是要把人类踢出局。论文里反复强调:它们是"补充",不是"替代"。
想象一下未来的AI评估场景:先用单AI裁判快速筛掉明显差的输出,就像初筛简历;再用多智能体辩论团评估复杂案例,比如AI写的医疗诊断;最后人类专家只需要看那些AI们吵不出结果的"疑难杂症"。这样既保证了效率,又守住了质量底线。
更酷的是,AI裁判还能帮AI自己进步。比如代码AI写完一段程序,裁判AI立刻指出"这里的循环可以简化",相当于给了实时反馈。这种"AI教AI"的模式,可能会让AI进化速度再上一个台阶。
最后说句掏心窝的
读这篇论文时,我总想起刚开始做AI评估的日子。那时候拿着计算器算BLEU分,心想"啥时候才能让机器真正'懂'内容啊"。现在看,AI不仅能懂,还能当裁判、开评审会,这步子迈得比想象中快多了。
但有个点得记牢:AI裁判再牛,最终标准还是人类定的。就像再智能的评分系统,最后还是要问一句:"这东西对人类有用吗?"
如果你也好奇AI是怎么给同类打分的,推荐读读原文(链接在最后)。说不定下次你用AI写报告时,背后就有一群AI评委在悄悄给它打分呢。
参考资料
• 标题:When AIs Judge AIs: The Rise of Agent-as-a-Judge Evaluation for LLMs
• 作者:Fangyi Yu
• 链接:https://arxiv.org/pdf/2508.02994