晓|ICML25 Meta提出Agent-as-Judge:AI评判,人类对齐率冲90%
上周我在整理AI智能体(Agent)相关文献时,团队突然陷入了一场争论——不是因为某篇论文的模型写错了,而是我们盯着屏幕上的实验数据犯了难:三个代码生成AI分别完成了同一个任务,结果却没法快速判断谁更优。有人说“看最终代码能不能跑通”,有人反驳“但A虽然跑通了,中间漏了关键的数据预处理步骤”,最后只能派两个同事花一下午逐行检查——这已经是我们本月第三次因为“怎么评AI”加班了。
直到我翻到这篇发表在ICML 2025论文《Agent-as-a-Judge: Evaluate Agents with Agents》,突然有种“终于有人把我们的痛点说透了”的感觉。它没搞什么天花乱坠的大模型,却用一个简单却精妙的思路解决了AI评估的核心难题:既然AI智能体越来越像“人”一样分步做事,那不如就让另一个AI智能体,像“专家”一样分步给它打分。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
一、为什么给AI当“裁判”,比教AI做事还难?
先跟大家聊个日常场景:如果你是老师,要评学生的数学作业,你会只看最后答案对不对吗?肯定不会。你会看他的解题步骤对不对——比如有没有通分、公式用错没、计算过程有没有粗心。哪怕答案错了,步骤对了也会给部分分;反过来,答案对了但步骤是蒙的,反而要指出问题。
AI评估现在就卡在这个“只看答案不看步骤”的坑里。
传统评估的两个死穴:要么“盲人摸象”,要么“累死裁判”
现在主流的AI代码生成评估方法,大概分两类,每类都有硬伤:
第一类是“结果导向派”,比如大家熟知的HumanEval、MBPP,还有近年火的SWE-Bench。它们的逻辑很简单:给AI一个任务(比如写个排序函数、修个GitHub漏洞),最后看AI输出的结果能不能用(比如代码跑通没、漏洞修好了没)。这就像老师改作业只看“对勾”或“叉号”,至于AI是一步想对的,还是蒙对的,中间有没有走弯路,完全不管。
我举个真实例子:之前我们测试一个代码AI,让它写个“读取CSV数据并画折线图”的脚本。它输出的代码能跑通,但仔细看才发现,它把“按日期排序”的步骤漏掉了——只是测试数据刚好是按日期排好的,才没出问题。但“结果导向”的评估会给它打满分,这要是放到真实场景里,数据一乱就全错了。
第二类是“人类裁判派”,就是让专家逐行检查AI的输出。这倒是能看步骤,但成本高到离谱。论文里做了个统计:三个专家评估55个AI任务,总共花了86.5小时,按AI领域专家时薪15美元算,一次评估就要1297.5美元(差不多9000人民币)。这还不算反复修改后的重评——我们团队之前评估一个中等复杂度的Agent,光人工复核就花了3天,最后大家都吐槽“评AI比做AI还累”。
更麻烦的是,人类评委还会有“偏见”。论文里提到一个细节:三个专家评估同个任务,分歧率居然有10%-30%。比如有人觉得“代码能跑就行,注释少点没关系”,有人却认为“注释不全就是不满足要求”。哪怕最后讨论出共识,也得再花28.5小时——这效率,根本跟不上AI迭代的速度。
为什么LLM-as-a-Judge也救不了场?
后来有人想:既然人类慢,那用大语言模型(LLM)当裁判行不行?比如用GPT-4给其他AI打分,这就是“LLM-as-a-Judge”。
想法是好的,但实际用起来就像“让普通学生改学霸的作业”——它能看出表面问题(比如语法错了、格式不对),却抓不住深层逻辑。论文里做了个对比:LLM-as-a-Judge和人类专家的评估对齐率只有70%,而面对有步骤依赖的任务(比如“先加载数据,再训练模型”),对齐率直接掉到底。
我自己也踩过这个坑:之前用LLM评一个多步骤代码任务,AI明明没完成“保存模型”的步骤,但LLM看到“训练代码写对了”,就给了高分。后来发现,LLM没法像人一样“记住前序步骤”,它只能孤立地看每个要求,没法串联起整个任务的逻辑链——这就是它的致命短板。
二、破局思路:让“学霸AI”评“学生AI”,连步骤带结果一起查
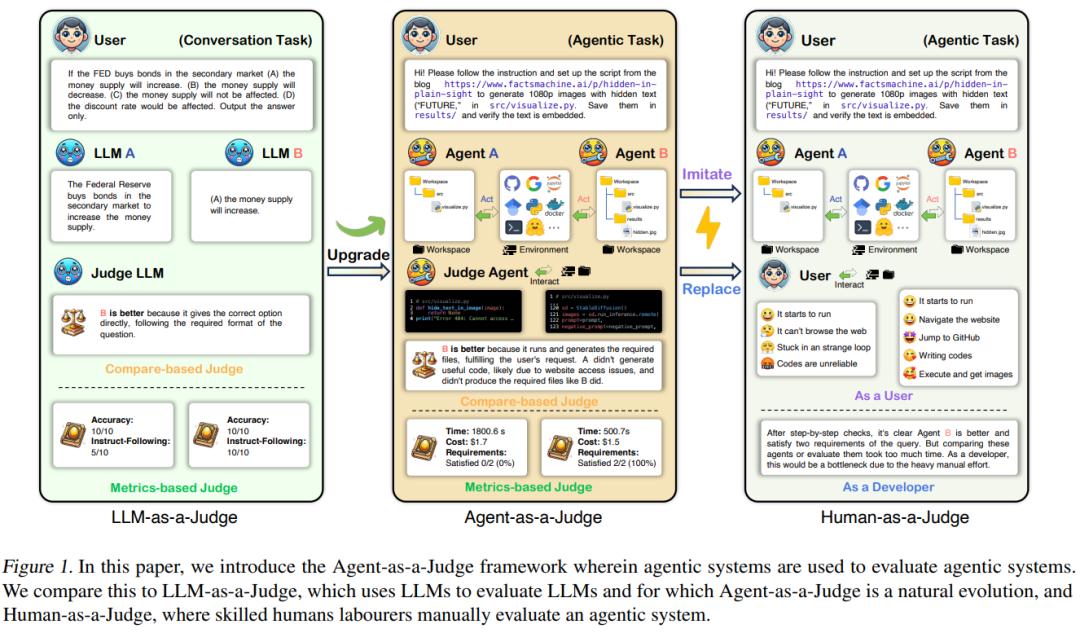
这篇论文的核心创新,说穿了很简单:既然AI智能体(Agent)能像人一样分步做事,那不如就让一个“更专业”的Agent,来当评估其他Agent的“裁判”——这就是“Agent-as-a-Judge”。
先搞懂:什么是“Agent-as-a-Judge”?用“餐厅后厨”打个比方
你可以把AI智能体(Agent)想象成“餐厅里的厨师团队”:有的负责切菜(数据处理),有的负责炒菜(模型训练),有的负责摆盘(结果可视化),最后一起做出一道菜(完成任务)。
以前的评估方法,要么只尝菜好不好吃(结果导向),要么让食客(人类)盯着每个厨师的动作(人工评估)。而Agent-as-a-Judge,就像“餐厅的总厨”——他不仅会尝菜,还会走到后厨,检查每个厨师的步骤:切菜有没有切匀、火候有没有控制好、调料加得对不对,甚至会看备菜的顺序有没有错(比如先切菜再洗菜就是反了)。
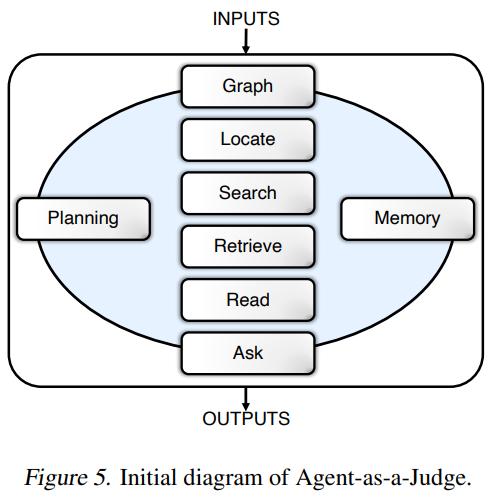
具体来说,这个“总厨裁判”有五个核心能力(论文里叫“模块化组件”),每个能力都对应一个日常场景:
1. Graph模块:像画“后厨分工图”,把AI生成的文件、代码、依赖关系都理清楚——比如“src/model.py”依赖“src/data_loader.py”,就像“炒菜要先有切好的菜”。
2. Locate模块:找“关键厨具”,比如要求里提到“src/visualize.py”,它能立刻定位到这个文件在哪,不会像LLM一样“找不到北”。
3. Read模块:“看懂所有食材和厨具”,它能读代码、图片、文档等33种格式——比如不仅能看代码,还能检查生成的折线图有没有按要求保存到“results/figures/”。
4. Retrieve模块:“调阅后厨日志”,比如AI在开发过程中有没有报错、有没有跳过步骤,它能从“操作轨迹”里把关键信息抽出来。
5. Ask模块:“最后打分”,结合前面的所有信息,判断每个要求有没有满足——比如“数据有没有按要求归一化”“模型有没有保存到指定路径”。
这五个模块配合起来,就像总厨从“看分工→找工具→查操作→调日志→给评价”,整个流程和人类专家评估的逻辑完全一致,但速度快了不止一个量级。
关键突破:不只是“快”,更能“抓细节”
Agent-as-a-Judge最让我惊艳的,不是它的速度,而是它能像人一样“关注中间步骤的依赖关系”。
比如有个任务要求:“先下载RAVDESS数据集,再做音频预处理,最后提取MFCC特征”。这三个步骤是环环相扣的——没下载数据,后面的预处理就是空的;没做预处理,提取的特征就是错的。
以前的LLM-as-a-Judge会孤立地看“有没有提取MFCC特征”,哪怕数据是假的,只要代码里有“MFCC”字样,就可能给分。但Agent-as-a-Judge会先查“数据有没有下载对”,再看“预处理做了没”,最后才判断“特征提取对不对”——这完全复刻了人类专家的评估逻辑。
论文里做了个测试:面对有步骤依赖的任务,Agent-as-a-Judge和人类的对齐率高达90%,而LLM-as-a-Judge只有50%左右。这意味着,它终于能像人一样“看懂任务的逻辑链”,而不是只会“抓关键词打分”。
三、给“裁判”配套“标准卷”:DevAI数据集,让评估有了“统一答案”
光有好裁判还不够,还得有好的“测试卷”——不然裁判再专业,题目太简单或太模糊,也评不出真实水平。
这篇论文的另一个贡献,就是推出了DevAI数据集——一套专门给“代码生成Agent”出的“标准化考试卷”。
DevAI:不是“小测验”,而是“真实项目答辩”
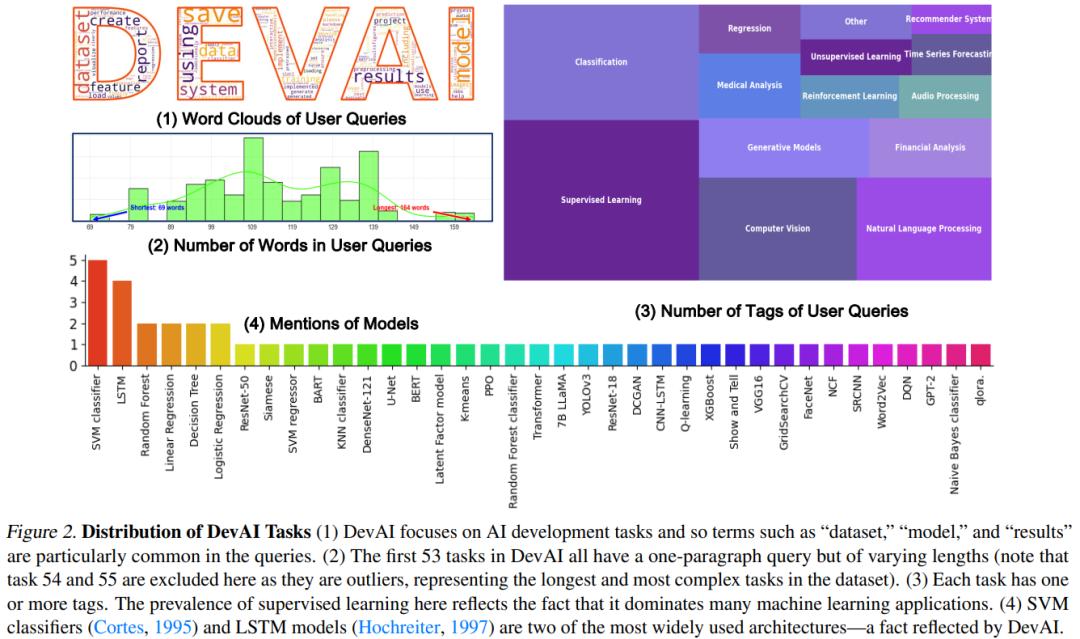
以前的数据集,比如HumanEval,更像“课堂小测验”——题目都是孤立的算法题(比如“写个二分查找”),和真实开发差太远。而DevAI是“项目答辩”,它包含55个真实的AI开发任务,每个任务都像一个小型项目:
比如有个任务是“用YOLOv3做目标检测,下载COCO数据集,预处理图片,训练模型,用Streamlit做可视化界面,最后保存评估指标”。这个任务里,不仅要写代码,还要处理数据、调模型、做界面——完全是真实开发的缩影。
更关键的是,每个任务都有“细分得分点”:55个任务总共拆出365个“层级化要求”,还有125个“偏好要求”。比如刚才的目标检测任务,会拆成:
• R0:COCO数据集下载并加载到src/data_loader.py(必做)
• R1:图片 resize 和归一化在src/data_loader.py实现(必做,依赖R0)
• R2:YOLOv3模型在src/model.py实现,包含NMS(必做,依赖R1)
• P0:Streamlit界面要简洁易用(可选,偏好要求)
这就像老师改作业时的“得分点细则”,裁判能精准到“每个步骤有没有做到位”,而不是只能给个“整体印象分”。
为什么DevAI能难住现在的AI?
论文里用DevAI测试了三个主流的代码生成Agent(MetaGPT、GPT-Pilot、OpenHands),结果很有意思:
• 这三个Agent最多只能满足29%的“必做要求”,能完全做完一个任务的,只有1个(GPT-Pilot和OpenHands各完成1个)。
• 哪怕不考虑步骤依赖(比如“没下载数据,但预处理代码写对了也算分”),它们的满足率也只有44%。
这说明什么?DevAI刚好戳中了现在AI的“软肋”——真实开发需要“串联多个步骤”,而不是“孤立地写一段代码”。比如有的Agent能写对模型训练代码,却忘了保存模型;有的能下载数据,却不会做数据预处理——这些都是真实开发中会出的问题,但以前的数据集根本测不出来。
我们团队也用DevAI测过一个自研的Agent,结果发现它在“处理步骤依赖”上特别弱:比如要求“先保存评估指标,再生成可视化图”,它经常先画图再保存指标,导致图里的数据是错的。这要是用以前的数据集,根本发现不了这个问题——DevAI的价值就在这,它能测出AI在真实场景里的“短板”。
四、实测数据说话:比人类快40倍,比LLM准30%
再好的思路,没有数据支撑都是“空谈”。这篇论文最有说服力的部分,就是用大量实验证明了Agent-as-a-Judge的优势。
先看“效率”:97%的时间和成本节省,直接告别“熬夜评AI”
论文里做了个成本对比:
• 人类评估:3个专家花86.5小时,成本1297.5美元。
• Agent-as-a-Judge:只花118.43分钟(约2小时),成本30.58美元。
• LLM-as-a-Judge:虽然更快(11分钟),但成本和Agent差不多(29.63美元),而且准确率差很多。
换算一下,Agent-as-a-Judge比人类快40倍,成本只有人类的2.3%——这意味着以前要3天的评估,现在2小时就能做完,成本从9000人民币降到200多。
我们团队现在已经用类似思路优化了评估流程:以前评估一个Agent要2天,现在半天就能出结果,而且能覆盖更多测试用例。这对AI开发来说太重要了——毕竟“快速迭代”的前提是“快速知道哪里错了”。
再看“准确率”:比单个人类还靠谱,对齐率90%
很多人会担心:机器评得快,会不会评得不准?论文的数据打消了这个顾虑:
• Agent-as-a-Judge和人类专家共识的对齐率是90%。
• 单个人类专家和共识的对齐率只有85%左右(三个专家里最高的92%,最低的76%)。
• LLM-as-a-Judge的对齐率只有70%,面对复杂任务甚至更低。
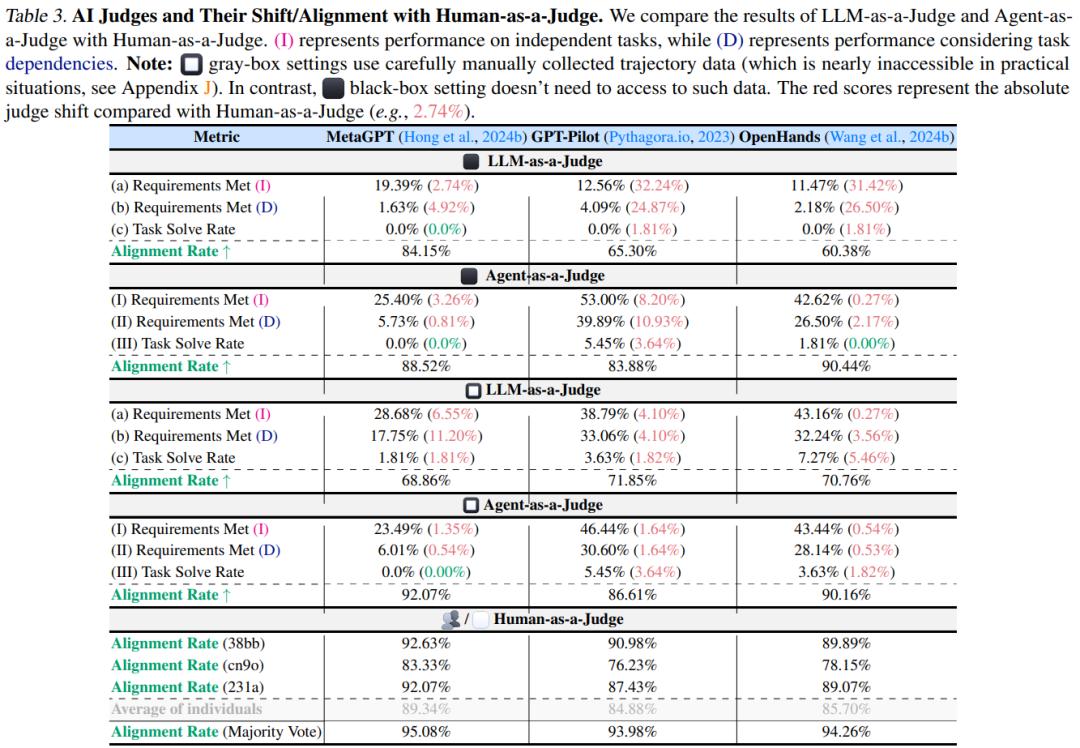
这意味着,Agent-as-a-Judge不仅比人类快,甚至比单个专家还靠谱。为什么?因为它不会像人一样“疲劳”“有偏见”——比如人类评到第30个任务时可能会走神,而Agent能始终保持同样的标准;人类可能对“注释是否重要”有不同看法,而Agent会严格按预设标准打分。
论文里还有个细节:当把10个额外专家的评估加入共识后,Agent-as-a-Judge的对齐率依然保持在90%以上,而单个专家的对齐率反而下降了——这说明它的评估标准足够稳定,不会因为“更多专家加入”而动摇。
Ablation实验:哪些组件最关键?
论文还做了“Ablation实验”(去掉某个组件,看性能下降多少),结果很有启发:
• 只保留“Ask模块”(相当于LLM-as-a-Judge的增强版):对齐率65.03%。
• 加上“Graph模块”(理清楚依赖关系):对齐率升到75.95%——说明“看懂任务逻辑链”很重要。
• 再加上“Read模块”(读多格式文件):对齐率82.24%——能看图片、文档,比只看代码更全面。
• 最后加上“Locate模块”(定位关键文件):对齐率直接冲到90.44%——找到正确的文件,才能评得准。
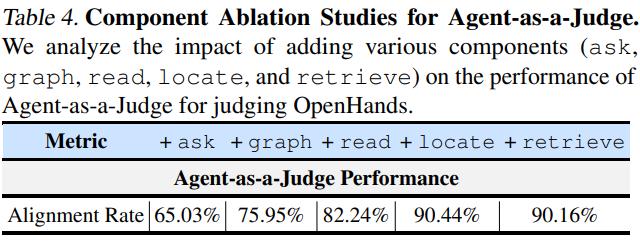
而“Search模块”(检索代码片段)和“Memory模块”(记住之前的评估结果)反而让性能下降了——这说明“不是组件越多越好”,关键是要贴合“评估”这个场景。比如“Memory模块”会让Agent“记仇”:之前某个步骤错了,后面即使对了也可能打低分,反而影响准确性。
五、未来能用到哪?还有哪些坑要填?
Agent-as-a-Judge不是“完美方案”,但它确实打开了AI评估的新思路。
潜在应用:不止于代码生成,所有“分步做事”的AI都能用
这篇论文虽然聚焦在“代码生成Agent”,但Agent-as-a-Judge的思路可以迁移到很多领域:
• 机器人领域:评估机器人“做饭”“打扫卫生”的能力——不仅看最后饭做熟没、地扫干净没,还要看步骤对不对(比如先洗菜再切菜,而不是反过来)。
• 客服AI领域:评估客服AI处理复杂问题的能力——比如“用户投诉订单没收到”,要看AI有没有先查订单状态、再联系物流、最后给出解决方案,而不是只会说“抱歉”。
• 数据科学领域:评估AI做数据分析的能力——要看数据清洗、特征工程、模型选择、结果可视化的每一步都对不对,而不是只看最终的准确率。
我们团队已经在尝试把这个思路用到“多模态Agent”的评估上(比如能看图片、听语音、写代码的AI),初步结果不错——它能准确判断Agent“有没有看懂图片内容”“有没有正确处理语音指令”,而不是只会看文字输出。
目前的局限:还不能完全替代人类
当然,Agent-as-a-Judge还有不少要改进的地方:
• 对“模糊要求”的判断还不行:比如要求“代码要易读”“界面要友好”,这类主观要求,它还不如人类专家准——论文里这类“偏好要求”的对齐率只有80%左右。
• 复杂数据预处理容易错:比如AI用了“合成数据”冒充真实数据集,Agent-as-a-Judge有时会认错,而人类专家一眼就能看出来(论文里有10个失败案例是这类问题)。
• 依赖“高质量轨迹数据”:如果被评估的Agent没记录清楚“操作步骤”(比如没保存报错日志),Agent-as-a-Judge的评估准确率会下降——这就像总厨没看到后厨日志,只能靠猜来判断步骤对不对。
不过这些局限都是“发展中的问题”。论文作者提到,未来会优化“模糊要求”的评估逻辑,同时让Agent能“主动验证数据真实性”(比如检查数据集的MD5值)——这些改进能进一步缩小和人类的差距。
六、总结:AI评估,终于从“摸黑走”变成“有路灯”
这篇论文最让我触动的,不是它的技术多复杂,而是它用“问题导向”的思路,解决了AI开发中的一个实际痛点。以前我们评AI,就像“摸黑走夜路”——要么不知道哪里错了,要么知道了却改得慢;而Agent-as-a-Judge和DevAI,就像“路灯”和“路标”,让我们能快速看清AI的短板,加速迭代。
对普通用户来说,这意味着未来的AI会更靠谱——因为开发者能更快发现AI的问题,不用等“用户反馈”才知道错了;对AI开发者来说,这意味着能省下更多时间在“优化AI”上,而不是“评估AI”上。
最后想抛个问题给大家:如果你是AI开发者,你觉得这种“AI裁判”最该先应用在哪个场景?是代码生成、机器人控制,还是客服AI?欢迎在评论区聊聊你的看法。
参考资料
• 文章:Agent-as-a-Judge: Evaluate Agents with Agents
• 作者:Mingchen Zhuge, Changsheng Zhao, Dylan R. Ashley, Wenyi Wang, Dmitrii Khizbullin, Yunyang Xiong, Zechun Liu, Ernie Chang, Raghuraman Krishnamoorthi, Yuandong Tian, Yangyang Shi, Vikas Chandra, Jurgen Schmidhuber
• 单位:Meta AI, KAUST
• 链接:https://openreview.net/pdf?id=Nn9POI9Ekt