精|告别试错!用缩放定律找到大模型的最佳数据配比
旺精通:细节全解,深度精通
训练一个80亿参数的AI模型,到底该用多少文本数据、多少图像数据才能达到最佳性能?是一半一半,还是侧重某一类?过去要试几十次才能知道,而现在,一种新的数学规律告诉你:几次小规模实验就够了。这个能“未卜先知”的缩放定律,究竟是如何破解数据混合的难题的?
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
本文针对大型基础模型训练中数据混合比例(各领域数据占比)选择依赖试错法、难以适应大规模训练的问题,提出了一种基于缩放定律的系统解决方案。该方法扩展了传统缩放定律,将数据领域权重纳入模型损失预测,构建了损失与模型规模(N)、训练token数(D)、领域权重(h)的函数关系(L(N,D,h))。通过推导加性和联合两种缩放定律公式,实现了对目标域损失的精准预测,并在大型语言模型(LLM)、原生多模态模型(NMM)和大型视觉模型(LVM)上验证了普适性。实验表明,该定律可通过少量小规模训练拟合,并外推到更大规模模型和未见过的领域权重,推导的最优数据混合比例性能优于传统基线。该方法为大规模模型训练提供了一种低成本、原则性的最优数据配比选择方案。
摘要&解读
大型基础模型通常在来自多个领域的数据上训练,其中数据混合比例(即每个领域的使用占比)对模型性能起着关键作用。选择这种混合比例的标准方法依赖于试错法,这在大规模预训练中变得不切实际。我们提出了一种利用缩放定律确定任意目标领域最优数据混合比例的系统方法。我们的方法能准确预测规模为N、训练token数为D且使用特定领域权重向量h的模型的损失。我们通过在三个截然不同的大规模场景(大型语言模型(LLM)、原生多模态模型(NMM)和大型视觉模型(LVM)预训练)中验证其预测能力,证明了这些缩放定律的普适性。我们进一步表明,这些缩放定律能够外推到新的数据混合比例和不同规模:只需通过几次小规模训练即可准确估计其参数,并用于预测更大规模和未见过的领域权重下的性能。缩放定律允许在给定训练预算(N, D)下推导出任意目标领域的最优领域权重,为昂贵的试错法提供了一种有原则的替代方案。
研究背景
现代大型模型(LLM、NMM、LVM)需在多领域数据上训练,数据混合比例(领域权重)对性能影响关键,但传统依赖试错法,成本高且不适合大规模训练。
现有缩放定律已能预测模型损失与参数(N)、训练token(D)的关系,但未纳入数据混合比例的影响,无法指导领域权重选择。
数据领域多样性增加(如LLM涉及7类文本,NMM涉及文本/图像等3类数据),使得手动试错的难度和成本进一步上升,亟需系统化方法。
研究贡献
扩展缩放定律至数据混合场景:首次将数据领域权重(h)纳入缩放定律,建立损失与N、D、h的关联,提出L(N,D,h)预测模型。
提出两种定律公式:设计加性缩放定律(仅基础损失项E依赖h)和联合缩放定律(E、A、B均依赖h),分别捕捉不同维度的交互关系,兼顾简洁性与表达性。
普适性与外推能力:在LLM(7领域)、NMM(3领域)、LVM(4领域)上验证,证明定律可跨模态、跨规模适用,能从小规模训练外推到大规模(如从1B参数到8B参数)。
高效拟合与最优权重计算:通过少量(10-20次)小规模训练即可拟合定律,结合镜像下降算法快速求解最优领域权重,替代试错法。
实现设计
问题定义:明确数据领域(D₁...Dₖ)、领域权重(h,单纯形向量)、目标损失(Lₜ(θ)),核心目标是预测模型在规模N、token数D、权重h下的目标损失L(N,D,h)。
缩放定律公式:
• 加性定律:ℒ = E + 1/(∑Cᵢhᵢ^γᵢ) + A/N^α + B/D^β(仅E依赖h);
• 联合定律:ℒ = E + 1/(∑Cᵢhᵢ^γᵢ) + (∑Cᵢᴬhᵢ)^γᴬ/N^α + (∑Cᵢᴮhᵢ)^γᴮ/D^β(A、B也依赖h)。
参数拟合:采用胡贝尔损失(Huber loss)最小化预测误差,结合随机搜索初始化参数与盆地跳跃算法(替代传统L-BFGS)优化高维参数(最多37个)。
最优权重求解:通过镜像下降法在单纯形上最小化缩放定律,得到h*,支持多目标域的加权优化。
实验结果
最优权重性能:推导的最优权重(h*)优于均匀分布和基线(如slimpajama标准分布),例如7B LLM在OpenHermes数据集上,h*对应的损失低于基线20%以上。
效率验证:仅需10-20次小规模训练即可拟合定律,支持4-8个领域场景,如NMM(3领域)需10次,LLM(8领域)需20次。
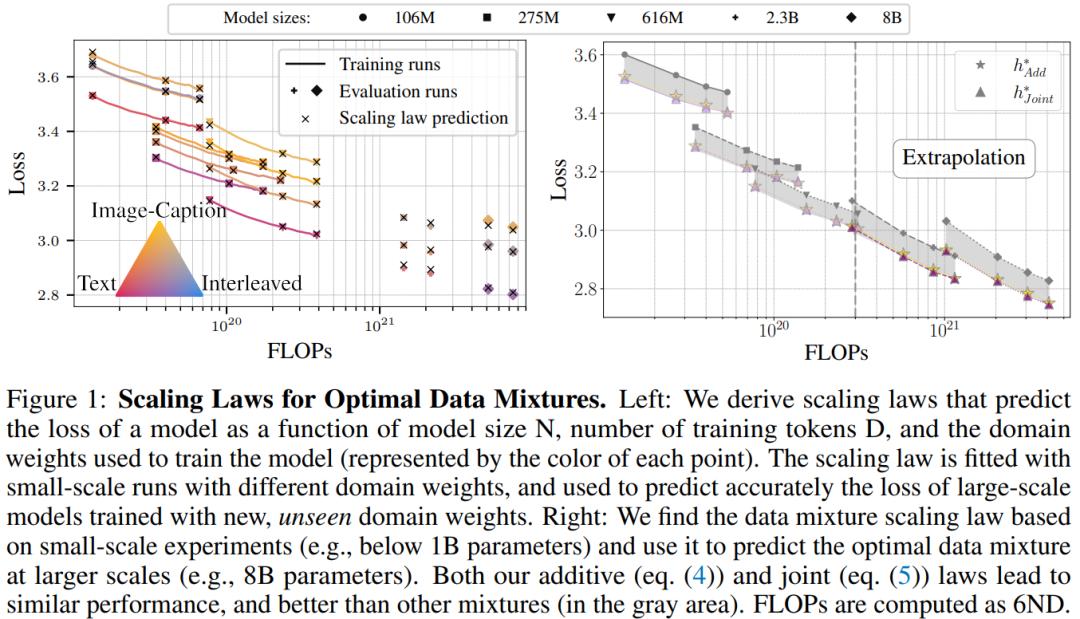
图1:最优数据混合的缩放定律左图:我们推导出的缩放定律可将模型损失预测为模型规模N、训练token数D和训练所用领域权重(由各点颜色表示)的函数。该缩放定律通过不同领域权重的小规模训练拟合得到,并能准确预测使用新的、未见过的领域权重训练的大规模模型的损失。右图:我们基于小规模实验(例如参数小于10亿)发现数据混合缩放定律,并用于预测更大规模(例如80亿参数)下的最优数据混合比例。我们的加性定律(公式(4))和联合定律(公式(5))均能产生相近的性能,且优于其他混合比例(灰色区域)。计算量(FLOPs)按6ND计算。
1. 引言
现代机器学习模型[8, 16, 20]在多样化的数据领域上预训练,例如语言模型(LLMs)的文本数据、视觉模型的图像数据以及多模态模型的混合模态数据。对于LLMs,这些领域包括通用知识、代码、推理、多语言内容等[5, 16, 25, 58, 59]。多模态模型[1, 34, 43, 55, 69]在文本、成对数据和交错多模态数据的混合集上训练,而大型视觉模型则在不同质量的图像领域上训练,包括带文本配对和不带文本配对的图像[17, 20, 47]。
领域权重决定了训练过程中每个领域的使用比例,对模型性能有显著影响。然而,这些权重通常通过临时试错法选择,即通过不同领域权重的训练并选择效果最佳的[16, 43, 55]。尽管其作用关键,但选择领域权重的原则性方法仍严重缺失。
缩放定律提供了预测模型性能的理论框架。最初为LLMs开发[28, 30, 32],这些定律将模型损失建模为参数数量N和训练token数D的函数。该框架已扩展到其他领域和模态[3, 55],并考虑了诸如混合专家模型中的专家数量[33]、稀疏性[2]、数据重复[46]、微调token数[7, 68]和学习率调度[41]等因素。
在这项工作中,我们扩展了缩放定律以建模领域权重对模型性能的影响。我们表明,模型损失以可预测的方式依赖于领域权重,并与训练token数和模型参数相互作用。我们在三个大规模场景中广泛验证了我们的缩放定律:大型语言模型(LLMs)、原生多模态模型(NMMs)和大型视觉模型(LVMs)的预训练。我们训练了大型模型——LLMs最多达70亿参数和1500亿token,NMMs达80亿参数和1600亿token,LVMs达10亿参数和3300亿token,覆盖多个文本、多模态和图像领域。我们工作的核心要点如下:
可外推的缩放定律。我们证明,我们的缩放定律可以通过小规模训练拟合,然后准确预测使用新的、未见过的领域权重训练的大规模模型的损失。如图1左图所示,其中我们报告了NMMs在文本上的损失。正如预期,更多的文本数据有助于降低该损失。我们的缩放定律精确量化了这一现象。
最优领域权重估计。一旦拟合完成,这些缩放定律就能准确估计作为领域权重函数的损失。最小化该估计值可得到最优领域权重。这种方法为昂贵的“尝试不同领域权重并选择最佳”的做法提供了一种原则性替代方案。如图1右图所示,其中我们报告了NMMs的平均损失。
本文结构如下:第2节介绍领域权重选择问题并描述我们的缩放定律公式。第3节详细说明LLM、NMM和LVM预训练的模型架构和数据领域。第4节证明我们的缩放定律能够准确外推到新的领域权重、更大的模型规模和更多的token数。第5节展示如何通过少数小规模训练,利用拟合的定律估计最优领域权重。最后,第6节探讨我们缩放定律的各个方面,包括表明我们需要少量不同的领域权重即可获得满意的估计、最佳领域权重如何随计算量变化以及替代的缩放定律公式。最后,我们在第7节讨论相关工作。
2. 数据混合缩放定律
2.1 问题设置
我们考虑在来自k个数据域D₁, ..., Dₖ的数据上训练模型;我们可以从任何域Dᵢ中随机采样样本x。因此,对于任何领域权重h,我们可以从分布mix(h) = ∑ᵢ₌₁ᵏ hᵢDᵢ采样,遵循分布p(x | mix(h)) = ∑ᵢ₌₁ᵏ hᵢp(x | Dᵢ)。这里,h是一个k维正向量,其元素和为1,即属于单纯形Δₖ。简单来说,从域i采样数据的概率为hᵢ。我们有一个目标域Dₜ,它可以是训练域之一。我们考虑一个具有N个参数的模型,用参数向量θ ∈ ℝᴺ表示。最后,我们有一个损失函数ℓ(x, θ),定义在所有数据域Dᵢ或目标域Dₜ的任何x上。注意,目标域Dₜ不一定是训练域Dᵢ之一。这使我们能够定义任何领域权重h下的损失,以及目标损失,作为期望:
Lₕ(θ) = 𝔼ₓ∼mix(h)[ℓ(x, θ)] 且 Lₜ(θ) = 𝔼ₓ∼Dₜ[ℓ(x, θ)]
模型在固定领域权重h下的训练,通过运行优化算法(如Adam)近似最小化Lₕ来完成。在执行过程中,优化算法处理D个token并输出规模为N的训练参数θ*(h, D)。本文的目标是预测在目标域Dₜ上,用领域权重h训练规模为N、token数为D的模型后的损失;该量记为L(N, D, h),定义为Lₜ(θ*(h, D))。在实践中,我们当然可以有多个目标域,以捕捉模型能力的不同方面。在这种情况下,我们通过拟合多个缩放定律来估计所有目标域上的目标损失。该框架足够通用,可涵盖各种模型架构和模态。在这项工作中,我们认为不同的领域可以是各种文本域数据集、各种图像域、不同模态(例如图像和文本)或不同数据类型(例如成对或交错)。
2.2 缩放定律推导
在其原始形式中,缩放定律允许我们预测给定规模N的模型在D个token上训练后的训练损失[32]。Chinchilla缩放定律将训练损失建模为加性幂律[30]:
ℒ(N, D) = E + A/N^α + B/D^β,
其中E、A、B、α和β是依赖于训练集、模型架构和优化算法的参数。我们在两个方面偏离这些原始缩放定律:i)我们考虑模型在目标域(不一定是训练域)上的损失;更重要的是,ii)我们量化领域权重h对损失的影响。关于i),正如多项工作所示[23, 28, 45, 55],目标域上的损失仍然可以用公式(2)形式的缩放定律建模。因此,对于用于训练的每个领域权重h,我们期望目标域上的损失遵循Chinchilla幂律,其中系数依赖于h。换句话说,目标域上的损失可以表示为:
ℒ(N, D, h) = Eʰ + Aʰ/N^αʰ + Bʰ/D^βʰ. (3)
现在的问题是,参数Eʰ、Aʰ、αʰ、Bʰ和βʰ如何依赖于h?我们提出两种不同的公式,对这些参数使用简单的参数化表示。我们首先研究加性缩放定律,其中仅将Eʰ建模为h的函数,而其他参数Aʰ、αʰ、Bʰ和βʰ视为常数:
ℒ = E + 1/(∑ᵢ₌₁ᵏ Cᵢhᵢγᵢ) + A/N^α + B/D^β. (4)
缩放定律的参数为Z = (E, A, B, α, β, (Cᵢ)ᵢ₌₁ᵏ, (γᵢ)ᵢ₌₁ᵏ),它们依赖于模型架构、目标域和源域。该缩放定律有5 + 2k个参数。由于该缩放定律是加性的,最小化它的最优领域权重h*与模型规模N和token数D无关:
为了捕捉规模和混合比例之间的相互作用,我们还提出联合缩放定律:
ℒ = E + 1/(∑ᵢ₌₁ᵏ Cᵢhᵢ^γᵢ) + Aʰ/N^α + Bʰ/D^β,其中Aʰ = (∑ᵢ₌₁ᵏ Cᵢᴬhᵢ)^γᴬ 且 Bʰ = (∑ᵢ₌₁ᵏ Cᵢᴮhᵢ)^γᴮ (5)
在该定律中,我们考虑与公式(4)中相同的E对h的依赖关系,并且额外将Aʰ和Bʰ项建模为h的简单函数。该定律的参数为Z = (E, α, β, (Cᵢ)ᵢ₌₁ᵏ, (γᵢ)ᵢ₌₁ᵏ, (Cᵢᴬ)ᵢ₌₁ᵏ, γᴬ, (Cᵢᴮ)ᵢ₌₁ᵏ, γᴮ),共5 + 4k个参数。在该定律中,N、D和h之间存在相互作用,即∂²L/(∂N∂h) ≠ 0且∂²L/(∂D∂h) ≠ 0,而在加性缩放定律中这些偏导数为0。该定律预测,N和D对损失的贡献依赖于领域权重,因此最优领域权重是计算相关的。联合缩放定律比加性缩放定律更具表达性,因为当取γᴬ = γᴮ = 1且对所有域i有Cᵢᴬ = A、Cᵢᴮ = B时,我们可以恢复公式(4)。因此,如果缩放定律拟合得当,联合缩放定律在训练上的误差总是低于加性缩放定律。联合缩放定律仍将αʰ和βʰ项建模为常数。我们尝试使用相同的依赖于h的简单参数化形式建模这些项,但从未得到显著改进(见第6节)。另一方面,从加性定律到联合定律通常会显著降低估计误差。因此,我们的研究主要集中在这两种定律上。
2.3 拟合缩放定律
为了拟合缩放定律,我们进行多次训练,使用不同的领域权重h、模型规模N和token数D,并记录目标域Lₜ上的损失。我们训练的模型规模和token数均匀分布。我们通过在单纯形中取均匀分布的点网格来选择训练领域权重,其中每个领域权重都高于最小值(即0.1)。我们有p个输入-目标对(Nʲ, Dʲ, hʲ),Lₜʲ(j = 1, ..., p),其中p是训练次数。最优参数Z*通过最小化标准胡贝尔(Huber)损失获得:
H(Z) = (1/p)∑ⱼ₌₁ᵖ Huber(Lₜʲ - ℒ(Nʲ, Dʲ, hʲ; Z)),(6)
其中Huber(x) = x²/2(若|x| < δ),否则为δ(|x| - δ/2),其中δ是超参数,我们取δ = 1e-3。
拟合缩放定律的标准技术包括使用L-BFGS[38]从均匀分布的初始参数Z网格开始最小化损失,然后保留最小的局部最小值。与大多数仅涉及5个参数的缩放定律不同,我们的缩放定律有5 + 2k或5 + 4k个参数,其中k是领域数量。在我们的实验中,我们最多使用k = 8个领域,这需要拟合37个参数。这种增加的维度使得标准的缩放定律拟合技术变得繁琐。我们提出了两处改进,以实现良好的拟合。首先,我们使用随机搜索来采样初始参数Z。其次,我们使用盆地跳跃(Basin-hopping)算法[62]代替L-BFGS来探索损失函数的最小值。盆地跳跃算法本身使用L-BFGS作为内部程序来最小化损失函数,但它还使用随机游走探索局部最小值空间。图2给出了该算法性能的一个例子:为达到较低的拟合损失,盆地跳跃算法所需的L-BFGS调用次数远少于对L-BFGS初始值进行随机搜索的次数。
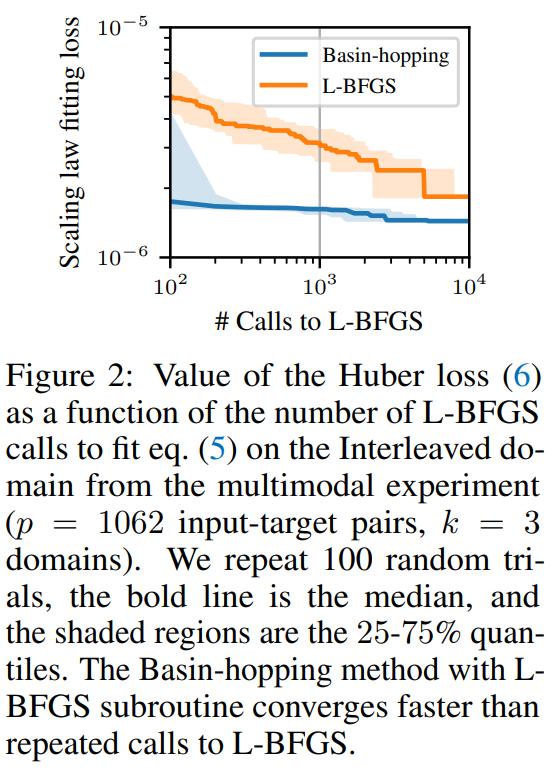
图2:缩放定律拟合损失纵轴:胡贝尔损失值(公式(6))横轴:L-BFGS调用次数
为了评估缩放定律,我们采用一组新的训练,给出不同的(N, D, h)值,并将缩放定律预测的损失与模型实际达到的损失进行比较。我们用平均相对误差(MRE)量化这一点,计算为|预测值 - 观测值| / 观测值,并以百分比报告。
3. 实验设置
我们概述实验中使用的模型和领域。详细架构和超参数见附录A。
3.1 大型语言模型(LLMs)的预训练
模型。我们使用Transformer[61]进行自回归语言建模。我们采用与llama[60]相同的设置,包括旋转位置嵌入、SwiGLU激活和RMSNorm。通过改变潜在维度来缩放模型,模型规模从1.86亿到70亿参数不等。
对于一些小规模分析,我们还使用GPT2风格的Transformer[50]进行自回归语言建模,模型规模从9000万到30亿参数不等。
数据集。在主要实验中,我们使用来自slimpajama[56]的k = 7个领域。我们使用作者提供的这些领域,不进行额外的数据过滤。
对于一些小规模分析,我们使用来自Pile数据集[21]的多达k = 8个领域:Wikipedia、StackExchange、GitHub、pg19、arxiv、free law、openwebtext和PubMed Central。
3.2 原生多模态模型(NMMs)的预训练
模型。我们预训练原生多模态模型(NMMs),基于早期融合架构[6, 55],并遵循[55]中提出的设计和实现。该模型由单个Transformer[61]组成,没有单独的视觉编码器,因此与LLMs使用相同的架构。该模型处理交错的文本和图像token序列。文本token通过标准LLM分词器获得,而图像token通过对图像进行分块并应用线性投影获得。图像被调整为224×224分辨率,分块大小为14×14。整体模型架构与[35]一致,包含SwiGLU FFNs[53]和QK-Norm[15]。
数据集。遵循先前工作[34, 37, 55],我们在多模态数据集的混合集上训练,涵盖k = 3种数据类型:(1)来自DCLM[35]的纯文本数据;(2)来自Obelics[34]的交错多模态文档;(3)来自DFN[19]、COYO[10]和高质量图像-文本对(HQITP)私人集合的成对图像-标题数据集。
3.3 大型视觉模型(LVMs)的预训练
模型。我们使用多模态目标预训练大型视觉模型,遵循AIMv2方法[20]。与上述专注于文本解码的传统语言建模或多模态模型不同,AIMv2使用图像和文本token上的自回归目标训练视觉编码器。模型架构由视觉编码器和多模态解码器组成,以晚期融合方式拼接在一起。
数据集。我们在来自四个领域(k = 4)的成对图像-标题数据集混合集上训练:(1)来自互联网的带噪声替代文本,包括COYO-700M[10]和DFN2B[19],它们提供大规模真实世界图像-文本对,噪声和质量各不相同;(2)HQ-ITP-1,一个包含1.34亿样本的高质量数据集;(3)HQ-ITP-2,另一个包含4亿样本的高质量数据集;(4)合成数据,由DFN2B和HQ-ITP-2的重新标题版本组成。
3.4 实现细节
为了缩放模型,我们改变Transformer中的隐藏维度d,保持层数固定。为降低实验成本,大多数实验使用恒定学习率调度器。这使我们能够为每个训练收集多个不同的token数D点,而不是每个训练一个点,这意味着我们可以进行更多实验并更彻底地探索领域权重空间。我们还在第6节验证了使用余弦学习率调度器时的发现,表明在这种情况下缩放定律也能从小规模外推到大规模行为。
4. 从小规模实验预测大规模性能
在本节中,我们证明(a)我们的缩放定律准确捕捉训练数据,(b)能有效推广到N和D显著增加的更大规模。为此,我们使用小规模模型和少量token拟合定律,并在更大模型和更多token上验证它们。
我们在LLMs(在文本域混合集上训练)、NMMs(在多模态域混合集上训练)和LVMs(在图像和成对图像-文本域混合集上训练)上进行实验。对于LLMs,我们考虑来自slimpajama的k = 7个领域,它们是不同的文本域。对于多模态预训练,与先前工作[34, 55, 69]类似,数据混合涵盖k = 3个不同领域:文本、成对(图像-标题)和交错多模态数据。对于大型视觉模型预训练,我们使用k = 4个领域。
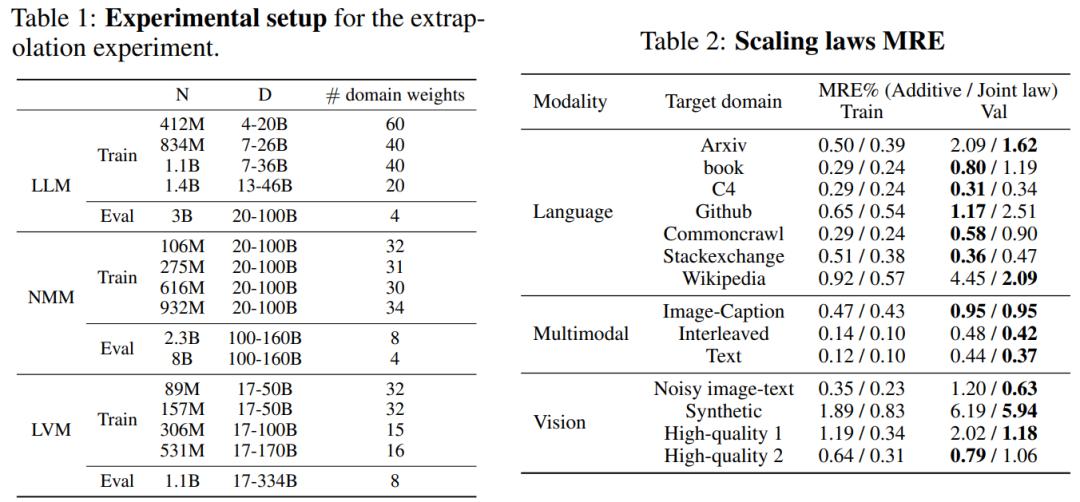
表1显示了我们用于训练和评估缩放定律的不同模型规模、训练token数和不同领域权重的数量。
结果。图3比较了我们训练的模型实际达到的损失与缩放定律预测的损失。我们通过显示每个领域的平均预测损失来总结结果(完整结果见附录B)。值得注意的是,对于联合定律和加性定律,预测损失与观测值密切一致。此外,这些定律对更大的模型规模表现出良好的外推性。为进一步量化这种一致性,我们在表2中报告了平均相对误差(MRE%),结果显示两种定律的MRE%始终较低,且联合定律优于加性定律。这些结果表明,我们可以在小规模上拟合缩放定律并外推到更大规模。我们注意到,MRE在不同领域间存在一定变异性;例如,在LLM实验中,我们在C4数据集上得到极低的0.31% MRE,而在Wikipedia上得到4.45%的高MRE。
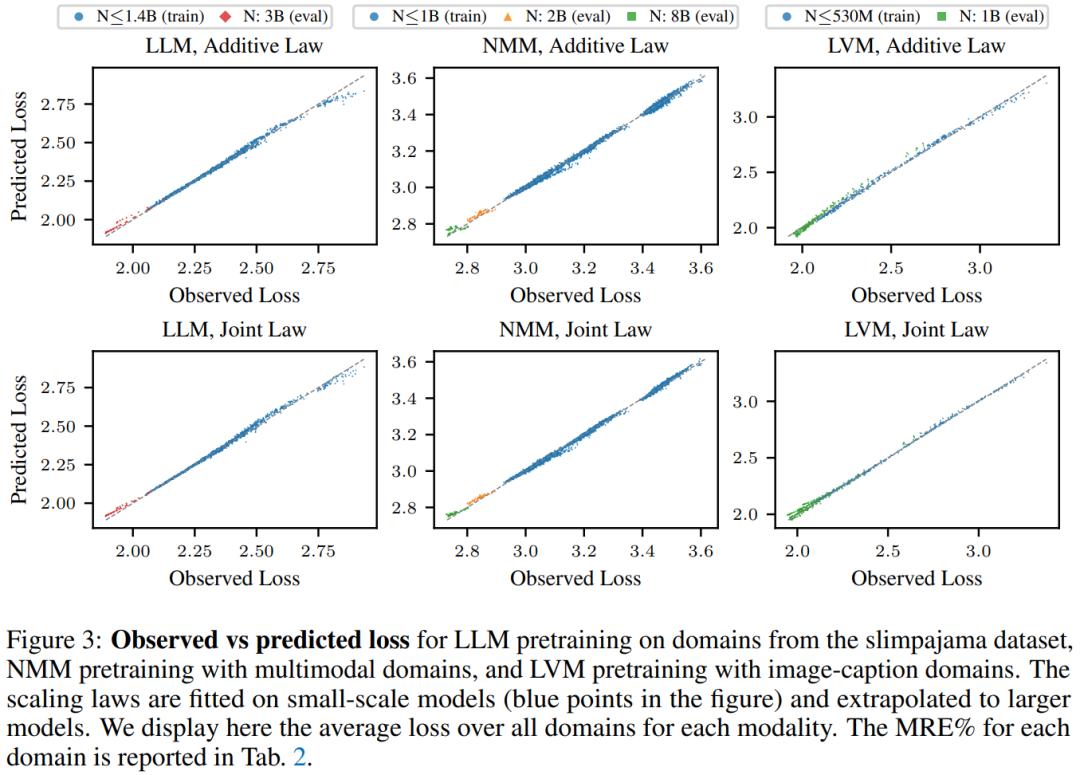
图3:LLM在slimpajama数据集领域上预训练、NMM在多模态领域上预训练、LVM在图像-标题领域上预训练的观测损失与预测损失对比缩放定律在小规模模型上拟合(图中的蓝色点)并外推到更大模型。这里我们显示每种模态在所有领域上的平均损失。每个领域的MRE%报告在表2中。
5. 最优数据混合
最优领域权重估计 一旦缩放定律拟合完成,我们可以通过在单纯形上求解以下优化问题来推导出最小化它的最优领域权重h*:
minₕ∈Δₖ ℒ(N, D, h) (7)
这是单纯形上的优化问题,我们使用镜像下降法求解,即迭代hᵗ⁺¹ = ĥᵗ / ∑ᵢĥᵢᵗ,其中ĥᵗ = hᵗ × exp(-η∇ₕL(N, D, h)),η是小步长。在实践中,我们可能希望获得一个在多个任务上都表现良好的模型,带有权重w。在这种情况下,我们有m个不同的目标域Dₜ¹, ..., Dₜᵐ。我们可以为每个目标域Dₜⁱ估计缩放定律,并获得m个不同的缩放定律Lⁱ(N, D, h)。我们通过求解以下优化问题获得平均表现良好的最优领域权重h*:
h*(N, D) ∈ arg minₕ∈Δₖ ∑ᵢ₌₁ᵐ ℒⁱ(N, D, h).
h*的行为取决于我们考虑的缩放定律。由于公式(4)假设加性关系,公式(8)的最小值与N、D无关;换句话说,它不依赖于规模。另一方面,公式(5)考虑了N、D和h之间的乘法相互作用。因此,最优h是规模相关的。如果一个任务比另一个更重要,我们可以在公式(8)的总和中纳入重要性权重。
本文的主要实际收获是这种简化的最优混合估计方法。事实上,如第4节所示,我们可以通过小规模训练准确拟合我们的缩放定律。使用这些缩放定律,我们可以为各种目标(N, D)求解公式(8),这提供了一种选择领域权重的原则性方法,而不是实践中通常使用的临时方法。为了说明这一点,我们对本文中考虑的不同模态进行了验证。
LLM结果。由于加性缩放定律给出了最低的MRE,我们使用它来估计最小化k = 7个训练域上平均损失的最优数据混合,记为h_avg*。然后,我们使用该最优数据混合训练一个70亿参数的模型,使用1500亿token。
在所有训练中,我们还监测OpenHermes数据集上的损失,这是一个用于模型对齐的小型高质量数据集。我们也为该领域拟合缩放定律,尽管该领域不是预训练领域的一部分。理由是我们希望估计导致在这个高质量数据集上最佳性能的权重,这应该是下游任务性能的代理。然后,我们找到该缩放定律的最优领域权重,记为h_OH*,并使用1500亿token训练另一个70亿参数的模型。作为基线,我们使用另外两个70亿参数的模型,使用相同数量的token,一个使用slimpajama的标准分布(领域权重与每个领域的token数成比例),另一个使用均匀领域权重。由于我们希望获得尽可能好的模型,我们使用余弦学习率调度。我们在图4中报告了训练域上的平均损失和OpenHermes数据集上的损失。我们还在几个下游任务上评估它们,并在表3中报告结果。使用h_OH*权重训练的模型总体上优于其他模型。我们认为,本文展示的流程——通过小规模训练估计高质量领域上损失的缩放定律,找到最小值,用它训练大规模模型——是获得更好模型的有前景的途径。
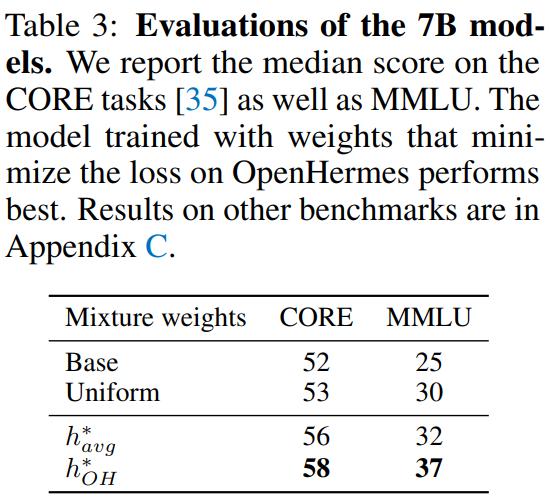
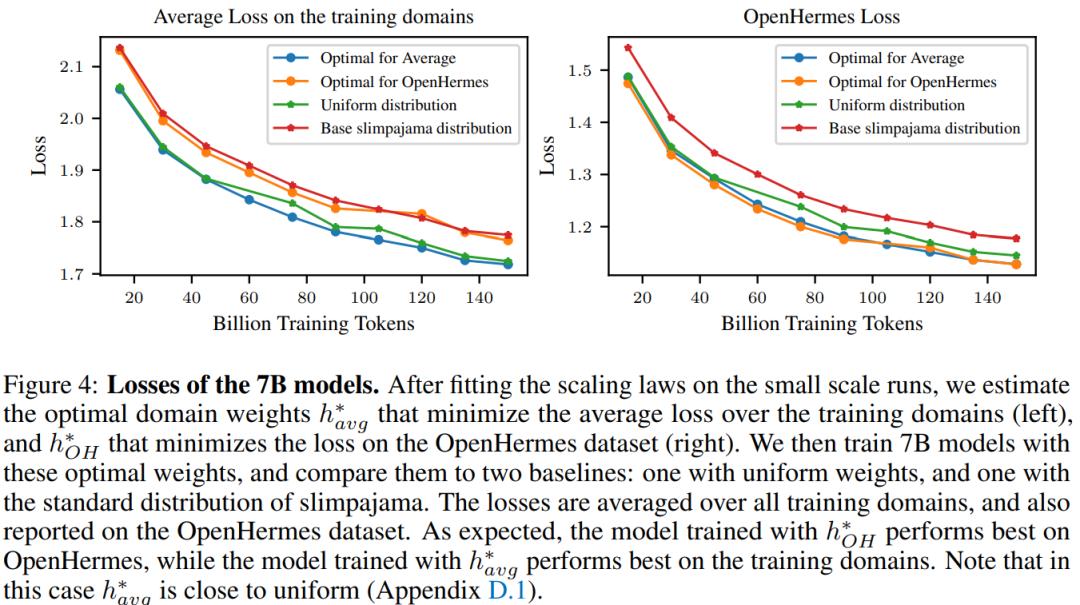
图4:70亿参数模型的损失在小规模训练上拟合缩放定律后,我们估计最小化训练域上平均损失的最优领域权重h_avg*(左图)和最小化OpenHermes数据集上损失的h_OH*(右图)。然后,我们使用这些最优权重训练70亿参数模型,并将它们与两个基线进行比较:一个使用均匀权重,一个使用slimpajama的标准分布。损失在所有训练域上平均,并在OpenHermes数据集上报告。正如预期,使用h_OH训练的模型在OpenHermes上表现最佳,而使用h_avg训练的模型在训练域上表现最佳。注意,在这种情况下,h_avg*接近均匀分布(附录D.1)。
NMM结果。我们使用仅小规模模型在三个多模态数据域上拟合加性和联合缩放定律。对于联合缩放定律,我们在固定token数为1000亿的情况下,为每个模型规模预测最小化领域损失平均值的最佳训练混合h*。然后,我们使用这些优化的混合训练模型。图1比较了这些最佳混合与均匀混合、先前工作中使用的混合[43, 55]以及覆盖混合网格重要区域的随机采样混合的性能。使用我们估计的混合训练的模型始终优于其他替代方案。值得注意的是,加性定律和联合定律的表现相近,使加性定律成为一个强大且更实用的基线,因为它对所有训练使用相同的最优混合。值得注意的是,优化的混合能有效推广到更大的模型规模,这验证了基于小规模实验选择最优混合并外推到更大规模的可能性。
LVM结果。我们在AIMv2数据混合(由4个领域组成)上拟合缩放定律,并估计最小化这些领域上平均损失的最优领域权重。然后,我们使用这些最优权重训练一个10亿参数的模型,并与使用均匀权重训练的模型进行比较。我们发现使用最优权重训练的模型比使用均匀权重的模型表现更好,这验证了我们从小规模训练估计最优领域权重的方法。
6. 缩放定律分析
在本节中,我们在不同的设置下进行LLM实验,使用Pile数据集[21],这使我们能够拥有可变数量的领域,在k = 4到k = 8之间。
只需10-20次训练即可拟合缩放定律。我们研究准确拟合缩放定律所需的训练次数。我们将领域权重随机划分为大小为q的h_train = [h₁, ..., h_q],并将其他领域权重放入h_test。我们在h_train上拟合缩放定律,并报告在测试领域权重上的MRE。
由于缩放定律的参数数量与领域数量k成线性关系,我们预期当考虑更多领域时,拟合缩放定律所需的训练次数会增加。为验证这一假设,我们考虑NMM预训练实验(k = 3个领域)和LLM预训练(k = 4、6、8个领域)。对于迄今为止考虑的k = 3个领域的NMM和k = 4个领域的LLM,我们在小规模模型上拟合定律,并如第4节所述在大规模模型上计算MRE。对于k = 6、8个领域的LLM训练,由于高领域数量带来的巨大搜索空间,我们采用单一模型规模,跳过缩放定律中对N的依赖,仅考虑对h和训练token数D的依赖。我们在图5中报告MRE作为训练混合数q的函数。我们观察到,对于NMM和k = 4个领域的LLM,需要约10次训练才能达到最优MRE,而对于k = 6和8个领域的LLM则需要约20次。有趣的是,我们观察到当训练次数非常少时,由于参数数量较少,加性定律的评估MRE略低。
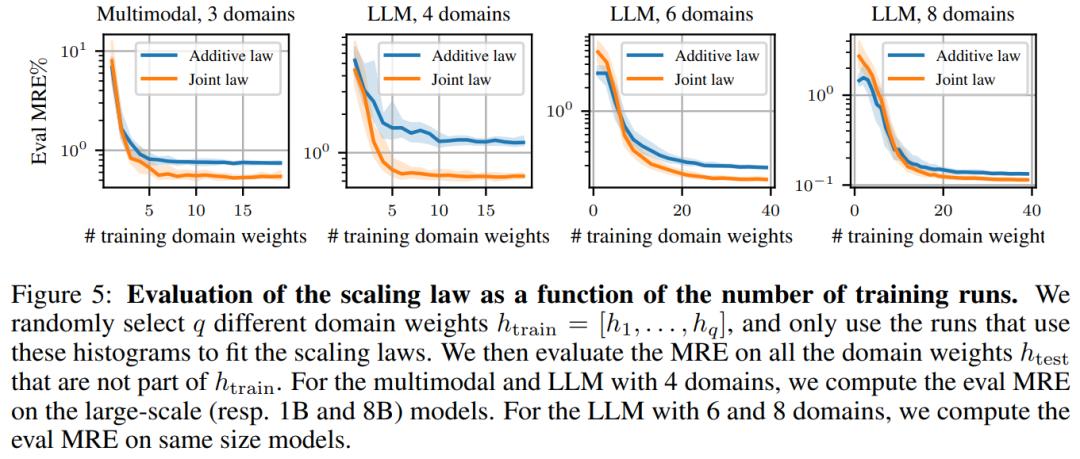
图5:缩放定律评估作为训练次数的函数我们随机选择q个不同的领域权重h_train = [h₁, ..., h_q],仅使用这些混合的训练来拟合缩放定律。然后,我们在所有不属于h_train的领域权重h_test上评估MRE。对于多模态和4个领域的LLM,我们在大规模(分别为10亿和80亿)模型上计算评估MRE。对于6个和8个领域的LLM,我们在相同规模的模型上计算评估MRE。
计算量(FLOPs)缩放时的最优领域权重行为。我们研究如联合缩放定律(公式(5))所预测的,多模态模型上平均损失的最优混合h*(N, D)如何作为计算预算(N, D)的函数演变。我们在图6中报告结果。我们看到,随着D的增加,交错数据的重要性降低,而更大的模型往往更依赖文本。加性定律捕捉了所有规模的平均行为。
余弦学习率调度器。我们的大部分实验使用恒定学习率,这有助于我们为每个训练收集多个D点,但这与训练竞争性模型时的实践不同,后者通常使用余弦学习率。为了验证我们的缩放定律在使用余弦学习率训练时仍然有效,我们在k = 4个Pile领域上重复LLM实验,使用余弦学习率衰减,训练次数更少,在5个不同的D值上训练,使用25个不同的领域权重。我们使用9000万、2亿、3.5亿和7亿参数的模型进行训练,并外推到13亿参数。我们观察到,我们的缩放定律拟合与主要实验中的相似:在10亿参数模型上,加性定律的平均MRE为0.76%,联合定律为0.54%。我们在附录B中报告详细结果。有趣的是,平均损失的估计最优领域权重与使用恒定学习率估计的非常相似:对于加性定律,我们有h_cos* = [0.35, 0.18, 0.30, 0.17],而h_const* = [0.34, 0.17, 0.32, 0.17]。
其他缩放定律公式。我们研究替代缩放定律,并通过在与第4节相同的设置中评估其他公式来验证我们提出的缩放定律。首先,我们想了解是否可以对领域权重h的依赖使用更简单的形式。为此,我们使用“简单加性”缩放定律:
ℒ = E + (∑ᵢ₌₁ᵏ Cᵢhᵢ)^γ + A/D^α + B/N^β,
其中与加性和联合缩放定律相比,对h的依赖更简单。该定律比加性缩放定律少k-1个参数。联合缩放定律将Aʰ和Bʰ项建模为领域权重的函数。我们想了解同时考虑α和β对h的依赖是否有助于捕捉更多关于模型行为的信息。为此,我们考虑“完全”缩放定律:
ℒ = E + 1/(∑ᵢ₌₁ᵏ Cᵢhᵢ^γᵢ) + Aʰ/N^αʰ + Bʰ/D^βʰ, 其中 (10)
Aʰ = (∑ᵢ₌₁ᵏ Cᵢᴬhᵢ)^γᴬ, Bʰ = (∑ᵢ₌₁ᵏ Cᵢᴮhᵢ)^γᴮ, αʰ = (∑ᵢ₌₁ᵏ Cᵢ^αhᵢ)^γ^α 且 βʰ = (∑ᵢ₌₁ᵏ Cᵢ^βhᵢ)^γ^β (11)
该定律比联合缩放定律更具表达性,并且增加了2k + 2个参数。我们在附录B中给出这些定律的完整结果,并在表4中报告平均MRE。总体而言,虽然完全定律在LLM和LVM实验中给出了最佳结果,但我们认为加性和联合定律的简单性,加上它们相对较低的MRE,使它们成为缩放定律公式的首选。对于LVM实验,情况不同:简单定律比加性定律表现更好,而完全缩放定律比联合定律有显著改进。
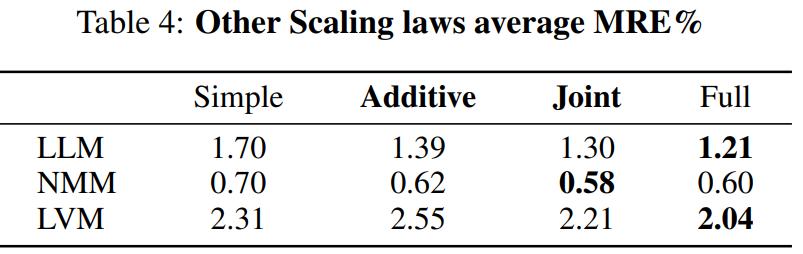
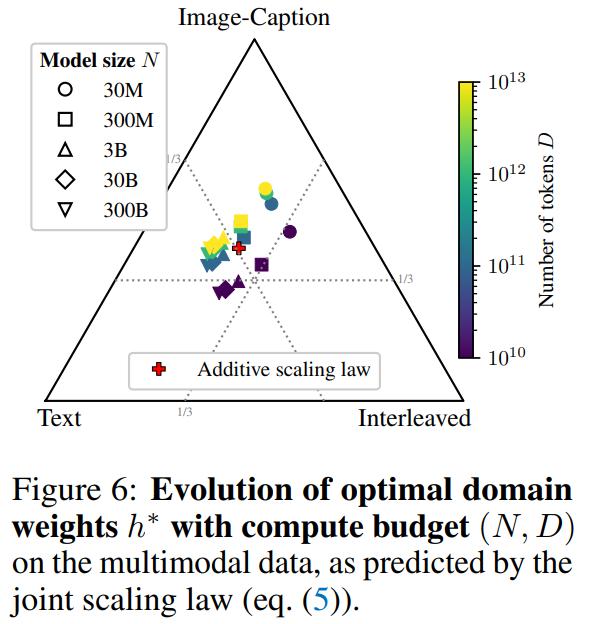
图6:多模态数据上最优领域权重h*随计算预算(N, D)的演变,由联合缩放定律(公式(5))预测
渐近行为。我们可以从信息论角度解释缩放定律中的偏差项。设p为目标域的真实数据分布。设q(h)为使用领域权重h训练的规模N→∞、token数D→∞的模型的输出分布。设h*为最小化缩放定律L(+∞, +∞, h) = E + (∑ᵢ₌₁ᵏ Cᵢhᵢ^γᵢ)⁻¹的最优领域权重,即交叉熵项CE(p, q(h)) = H(p) + KL(p || q(h)),其中H(·)是香农熵,KL(·||·)是Kullback-Leibler散度。我们有以下分解:
CE(p, q(h)) = H(p) + KL(p || q(h*)) (常数,与h无关) + KL(p || q(h)) - KL(p || q(h*)) (根据h的假设≥0)= E + (∑ᵢ₌₁ᵏ Cᵢhᵢ^γᵢ)⁻¹ + (∑ᵢ₌₁ᵏ Cᵢhᵢ^γᵢ)⁻¹ - (∑ᵢ₌₁ᵏ Cᵢhᵢ*^γᵢ)⁻¹.
我们可以识别这两项,因为它们具有“常数加非负函数(在h处为零)”的形式。我们看到,E + (∑ᵢ₌₁ᵏ Cᵢhᵢ^γᵢ)⁻¹既捕捉了目标分布的内在熵H(p),也捕捉了在最优混合h上训练引起的偏移KL(p || q(h)),而右侧项是期望对数似然比𝔼ₚ[log(q(h*)/q(h))],它衡量了在h上训练的模型与最优模型的距离。如果p是训练域Dᵢ之一,对于不相交的领域,我们可以假设hᵢ*≈1(见附录D的证明),并简单地界定其熵H(p) ≤ E + Cᵢ⁻¹。
7. 相关工作
缩放定律。缩放定律研究调查模型性能如何随训练计算量变化。基础研究[29, 30, 32]确立了语言模型在性能和计算量之间遵循可预测的幂律关系,允许在指定预算内优化参数和训练token的分配。此后,缩放行为已在广泛领域中探索,包括视觉模型[20, 52]、扩散Transformer[36]和其他领域[12, 48]。虽然典型的缩放定律考虑总参数数量,但其他研究检查了宽度和深度的影响[44],或模型蒸馏中分配给教师和学生的参数数量[9]。稀疏混合专家(MoE)模型是另一个焦点,研究了诸如稀疏性、专家数量和路由策略如何影响缩放[2, 14, 33, 63]。对于多模态模型,缩放定律已在[3, 55]等研究中探索。特别相关的是[55],它检查了原生多模态模型。然而,他们的分析受限于固定的预训练混合。
数据混合的缩放定律。优化模型训练的数据混合是一个关键挑战,通常需要大量实验。最近的研究开始探索更高效地识别最优混合的系统方法。例如,Goyal等人[24]研究了CLIP模型中数据过滤的缩放定律,强调数据质量和重复。Gu等人[27]检查了语言模型持续预训练的缩放定律,预测预训练和领域特定数据之间的最优平衡,而Bethune等人[7]采用相同方法,专注于微调中的遗忘。类似地,[11]推导出考虑数据质量因素(如多样性)的缩放定律。与我们的工作更接近的是,Ye等人[67]和Ge等人[22]提出了将损失建模为h的函数(对于固定的(N, D))的缩放定律,但他们没有像我们这样考虑(N, D, h)的联合定律。我们还发现,在我们的实验中,对于固定的(N, D),我们的缩放定律对未见过的混合的外推性更好(见附录B)。此外,这些方法通常限于单一模态,并且考虑相对较小的模型(低于10亿参数)。
数据混合选择。选择训练数据混合的标准方法依赖于试错法,测试不同组合以确定性能最佳的混合[20, 34, 37, 43, 54, 57, 69]。然而,这种方法成本高昂,导致最近的努力探索替代策略。一些研究采用启发式方法,基于每个领域的数据大小调整混合比例[13, 26, 51]或匹配目标任务的分布[25]。另一些研究使用将混合作为输入的小规模模型预测模型性能[4, 18, 39, 66]。第三种方法采用辅助模型来排序和选择高质量训练数据,这最近被大型基础模型普及[8, 16, 49, 64, 65]。
8. 讨论
局限性。我们当前的研究集中在预训练,但持续预训练和微调也是混合比例重要的场景。我们的缩放定律预测通用目标损失[32],已知它与下游任务性能相关[30, 42]。未来的工作可能直接预测这种性能,如[31]。此外,假设无数据重复(即每个领域有无限数据流),这在LLM预训练中很典型,但在使用非常稀缺的高质量源训练时不切实际。最后,我们假设混合在整个训练过程中是固定的,但未来的工作可能考虑权重的动态演变(例如课程学习)。
更广泛影响。混合系数对下游任务的性能有巨大影响。现代训练语料库通常是数十个子领域的组合,在多样性和质量之间取得平衡。由于预训练的成本,通过大量试错找到最优混合可能非常昂贵。我们的缩放定律只需几次小规模训练即可为更大的模型产生有意义的系数。我们的工作还有环境效益,因为它显著降低了预训练成本,包括二氧化碳排放量和所需能量。此外,从长远来看,它可能产生更好的模型。
结论。我们提出了一种数据混合定律,可从混合系数和计算预算(N, D)预测任意目标域上的损失。我们的定律适用于语言、多模态和视觉模型的预训练。从小规模找到的最优混合系数可用于大得多的模型和训练预算,表现出比通过简单网格搜索找到的领域权重大幅改进。这项工作为数据混合选择的原则性理论铺平了道路。
参考文献
标题:Scaling Laws for Optimal Data Mixtures
作者:Mustafa Shukor, Louis Bethune, Dan Busbridge, David Grangier, Enrico Fini, Alaaeldin El-Nouby, Pierre Ablin
单位:Sorbonne University, Apple
标签:机器学习、缩放定律、数据混合、大型语言模型(LLM)、原生多模态模型(NMM)、大型视觉模型(LVM)、模型训练优化
概述:本文提出一种基于缩放定律的系统方法,用于确定大型模型(LLM、NMM、LVM)训练中的最优数据混合比例,可通过小规模训练预测大规模性能,替代传统试错法。
链接:https://arxiv.org/pdf/2507.09404