当 AI 开始 “想太多”:我们如何让大模型变得更 “聪明高效”?
旺晓通:深入浅出,轻松通晓
你有没有过这种经历?明明只是问“今天天气怎么样”,手机助手却先给你讲了一通气象原理,再分析未来一周的气候趋势,最后才含糊地说“可能下雨”;或者做一道简单的数学题,步骤写了满满一页,回头一看其实三步就能搞定。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
其实,AI也会犯类似的毛病。我最近在读一篇关于大型推理模型(LRMs)的论文时发现,这些能解决复杂问题的“聪明大脑”,常常陷入一种“过度思考”的困境——明明可以用简洁的步骤得出答案,却非要绕一大圈,生成冗长、重复的推理过程。这不仅让回答变慢、成本变高,有时候还会因为想太多而“绕晕”自己,给出错误答案。
今天就来聊聊,研究者们是怎么给这些“想太多”的AI“减减负”,让它们既能保持聪明,又能高效工作的。
先搞懂:AI为什么会“想太多”?
要解决问题,得先明白问题在哪儿。我们先来看看,AI的“过度思考”到底是怎么回事。
你可以把大型推理模型想象成一个刚上初中的学生。老师教了它“解题要写步骤”,于是它不管遇到什么题都严格遵守——哪怕是“2+3等于几”,它也会先写“1+1=2”,再写“1+1+1=3”,最后总结“2+3=5”。不是不会,而是“太认真”,认真到冗余。
论文里把这种现象称为“overthinking”,具体表现有两种:
• 对简单问题小题大做:比如回答“地球是不是圆的”,它非要从古希腊学者的观测开始讲起,绕到牛顿力学,最后才说“是的”。
• 反复纠结自我怀疑:就像做选择题时,明明选了A,却反复检查“是不是B更对?”“刚才是不是看错了?”,来来回回兜圈子。
这种“想太多”的后果可不轻。首先是慢,生成一堆没用的内容会让回答速度变慢;其次是贵,AI每多“说”一个字,背后的计算成本就增加一分;最麻烦的是,想太多还可能让它在冗长的推理中犯低级错误,就像人绕路绕多了会迷路一样。
给AI“减负”的两大思路:自己优化 vs 组队协作
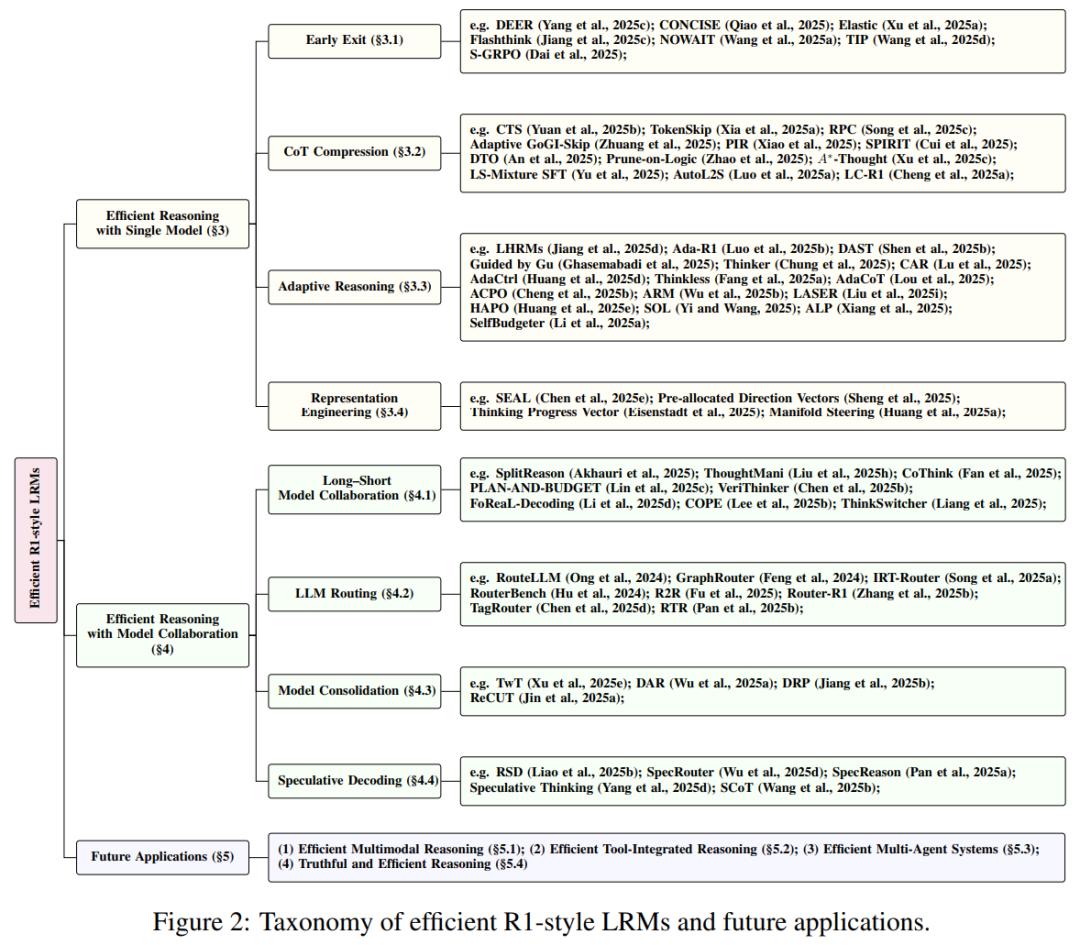
既然AI会“想太多”,那怎么让它“想少点,但想对点”?研究者们提出了两大方向,有点像我们解决问题的两种方式:要么自己提升效率,要么找队友分工合作。
思路一:单模型优化——让AI自己学会“抓重点”
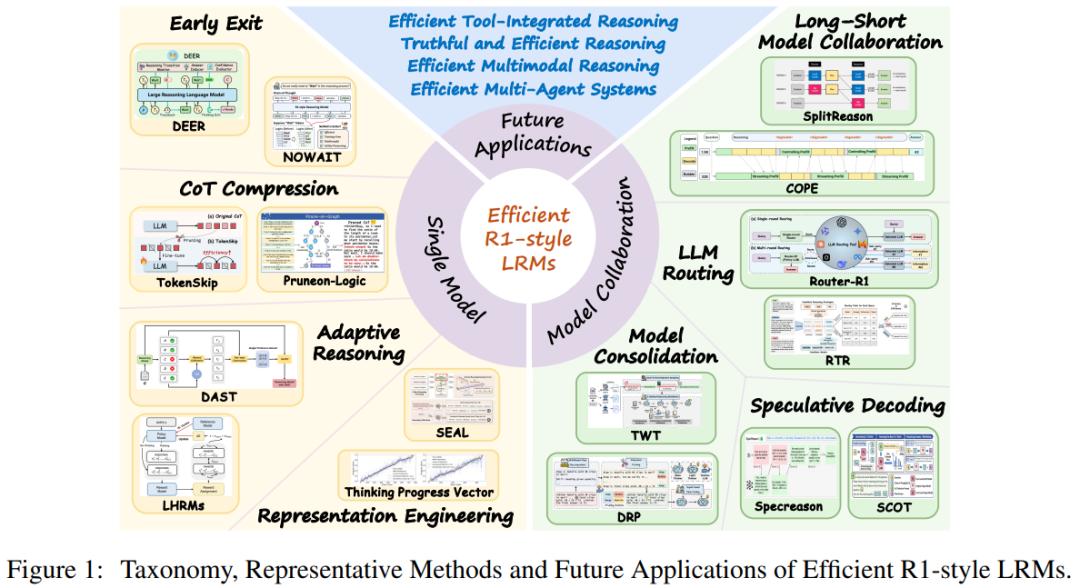
就像人通过训练学会“快速抓住问题核心”,单模型优化的思路就是让单个AI模型自己变得更“干练”。具体有四种方法,每一种都很有巧思。
1. 提前“交卷”:该停就停,别硬撑
你参加考试时,会不会遇到这种情况:明明已经算出正确答案了,却非要再检查三五遍,直到考试结束才交卷?AI也会这样。“提前退出(Early Exit)”技术就是让AI学会“算完就交卷”。
比如DEER方法,它会在AI的推理过程中设置“检查点”。当AI生成“关键句”(比如“最终答案”)时,就停下来评估一下:这个答案靠谱吗?如果靠谱,直接输出;如果不靠谱,再接着想。这就像你做完数学题,先快速验算一遍,对了就不用再耗时间了。
还有一种更“直接”的方式,比如NOWAIT方法,它会“禁止”AI说某些“废话触发词”。就像聊天时有人总说“等等”“不过”来拖延时间,AI也会用这些词来回避结论。NOWAIT会让这些词“说不出口”,逼着AI直奔主题。
2. “压缩”推理链:把长作文改成短笔记
有时候AI不是不想停,而是不知道怎么精简。就像有人写作文总爱写流水账,“压缩推理链(CoT Compression)”技术就是教AI“写摘要”。
比如TokenSkip方法,它会给AI生成的每一个词打分,重要的留下,没用的删掉。就像你记笔记时,会划掉“今天天气很好所以我去公园玩了”里的“今天天气很好所以”,只留下“我去公园玩了”。
还有更聪明的“平行思考压缩”,让AI同时生成多个推理路径,然后挑最短、最正确的那个。就像你问三个人“怎么去地铁站”,有人说绕三条街,有人说走小巷,你选最短的那条就行。
3. 灵活调整:难的问题多想想,简单的问题少想想
人会根据问题难度调整思考深度:算“1+1”不用动脑,解微积分就得认真推导。“自适应推理(Adaptive Reasoning)”就是让AI学会这种“弹性思考”。
比如LHRMs模型,它会先学两种“思考模式”:一种快而简,一种慢而细。遇到简单问题(比如“3乘4是多少”),就用快模式;遇到复杂问题(比如“解方程式”),就切换到慢模式。就像你用手机导航,近路用步行模式,远路就切开车模式。
还有用奖励机制引导的方法,比如LASER,AI思考得又快又对,就给它“奖励”;想太多或想太少,就“扣分”。慢慢的,AI就知道“该想多久”了。
4. 调整“脑回路”:从内部改变思考方式
如果说前面的方法是“教AI怎么做事”,那“表征工程(Representation Engineering)”就是“改AI的大脑结构”,让它从根上更高效。
简单说,研究者会找到AI“思考高效”和“思考冗余”时的“脑电波”(内部数据表征),然后通过调整这些“脑电波”,让AI更倾向于高效思考。就像医生通过调整人的神经信号,让某些过度活跃的反应平静下来。
比如SEAL方法,它能精准“抑制”AI的“冗余思考信号”,同时“放大”“有效推理信号”。就像给AI的大脑装了个“过滤器”,只让有用的想法通过。
思路二:模型协作——组队干活,各展所长
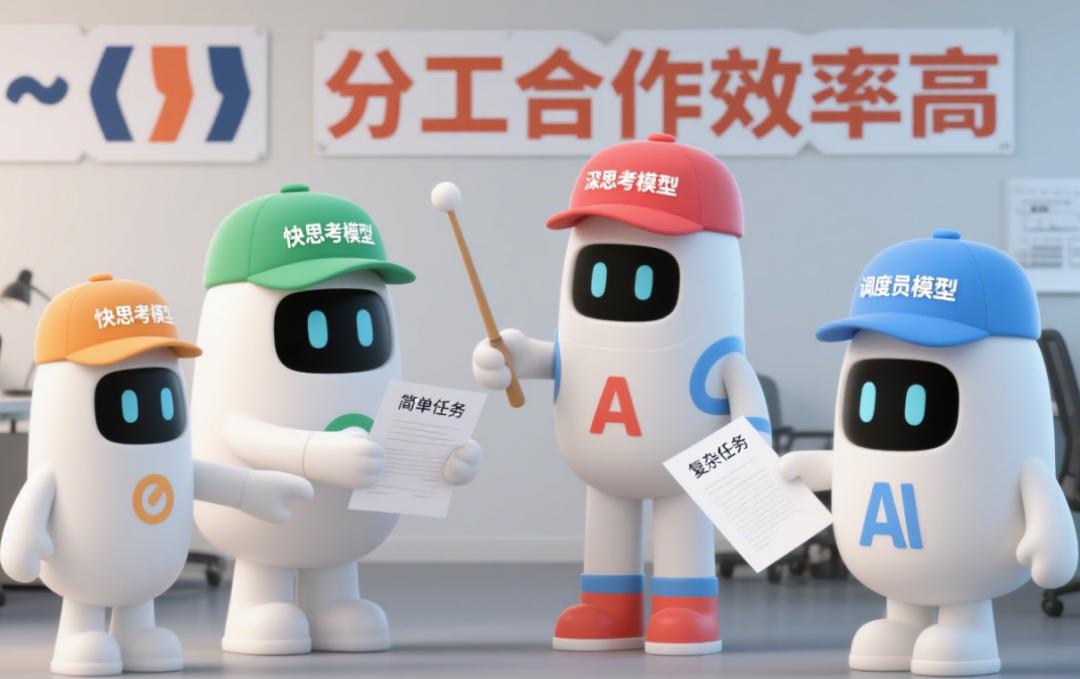
一个人再能干,也有极限。有时候AI“想太多”,是因为它一个人要扛太多活。“模型协作”就是让多个AI组队,简单的活交给“快手”,复杂的活交给“专家”。
1. 长短搭配:让“快手”和“专家”互补
就像公司里有负责日常琐事的助理,也有解决难题的专家,“长短模型协作”让“快思考模型”(处理简单问题快)和“深思考模型”(处理复杂问题强)组队。
比如SplitReason框架,简单的推理步骤由“快模型”搞定,遇到它搞不定的复杂步骤,就丢给“深模型”。就像你写报告时,自己写简单的概述,复杂的数据图表交给分析师。
还有更灵活的“互动模式”,比如ThinkSwitcher,它会先评估问题难度:简单的让“快模型”答,复杂的让“深模型”答,拿不准的就让两者商量着来。就像你不确定一道题的难度,先让学渣试试,不行再找学霸。
2. 智能“派单”:让对的人干对的事
如果有一堆AI模型,怎么知道谁最适合解决当前问题?“LLM路由(LLM Routing)”就是AI界的“调度员”。
比如RouteLLM,它会给每个模型建“能力档案”:这个擅长数学,那个擅长聊天,那个适合简单问答。接到问题时,就根据档案“派单”。就像外卖平台会把订单分给最近的骑手,这里会把“2+3等于几”分给小模型,把“解微分方程”分给大模型。
还有更精细的“多步路由”,比如R2R,它会在推理过程中动态换模型。就像你做手工,先用剪刀剪形状,再用胶水粘,最后用彩笔涂色,每个步骤用最合适的工具。
3. 模型“合体”:把多个AI的优点融在一起
有时候我们需要一个“全能选手”,但单独训练太麻烦。“模型合并(Model Consolidation)”就是把多个AI的“优点”融成一个。
比如TwT方法,让多个“老师模型”一起教一个“学生模型”:这个老师教它快速解题,那个老师教它深入推理,最后学生就兼具两者优点。就像一个人同时学过短跑和长跑,既能冲刺又能耐力跑。
还有更直接的“参数合并”,把擅长不同任务的AI模型“拆零件”再“重组”,就像把两辆不同的车拆开,用最好的发动机、最稳的底盘装成一辆新车。
4. 先猜后验:让“实习生”试错,“专家”把关
“ speculative decoding(投机解码)”是个很形象的方法:让小模型先“猜”一个答案,再让大模型检查。对了就用小模型的答案,错了大模型再修正。
就像公司里实习生先写份报告初稿,主管检查没问题就直接用,有问题再修改。这样既能利用实习生的“快”,又能保证主管的“准”,效率大大提升。
未来:高效推理模型会给我们带来什么?
这些让AI“少想高效”的技术,不只是让模型变“干练”,更会影响我们的日常生活。
比如“高效多模态推理”,未来的AI既能看懂图片又能理解文字,但不会对一张简单的猫咪图片分析半天“猫的进化史”,而是直接告诉你“这是一只橘猫”。
再比如“工具集成推理”,现在的AI用计算器时可能反复计算同一个数,未来它会精准调用工具,算一次就够。就像你用导航,它不会反复规划路线,而是一次选最优。
最有意思的是“多智能体系统”,多个高效AI组队协作:一个处理信息,一个做决策,一个执行任务,像一支高效的球队一样配合,帮我们解决更复杂的问题。
写在最后:让AI“聪明”得更“懂事”
读完这篇论文,我最大的感受是:AI的进步不只是“更聪明”,更是“更懂事”——知道该想多少、怎么想,既不敷衍,也不冗余。
这其实和我们人类的成长很像:从一开始的“想太多”“做太杂”,到后来学会“抓重点”“分轻重”。或许未来的AI,会像一个成熟的助手,你问它问题,它总能用最简洁的方式给你最准确的答案。
你平时用AI时,遇到过哪些“想太多”的情况?欢迎在评论区分享~
参考资料
• 标题:Don’t Overthink It: A Survey of Efficient R1-style Large Reasoning Models
• 作者:Linan Yue, Yichao Du, Yizhi Wang等(东南大学、中国科学技术大学、阿里巴巴集团等)
• 链接:https://arxiv.org/pdf/2508.02120