晓|阿里WebWatcher:智能体学会 “看图说话 + 上网查资料”
你有没有过这样的经历?刷到一条带图表的新闻,想弄明白里面的数据趋势,却得盯着图片里的曲线半天;或者看到一张陌生的建筑照片,想知道它的历史背景,翻遍网页文字也找不到线索。这时候,你可能会想:要是AI能同时看懂图和字,还能自己上网查资料就好了。
过去的AI确实有点“偏科”。有的擅长处理文字,能写报告、查文献,但对着一张图片就犯迷糊;有的能识别图片里的物体,却读不懂图片旁边的说明文字,更别说结合网页里的图文信息做深度分析了。
但现在,阿里巴巴通义实验室的研究员们推出了一款叫WebWatcher的多模态深度研究智能体,它就像一个既能看懂图片又能读懂文字,还会自己上网找答案的“超级助手”。今天,我们就来聊聊这个能“眼观六路、耳听八方”的AI到底有多厉害。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
一、为什么我们需要“图文通吃”的AI?
先从一个场景说起。假设你看到一张老照片,照片里是一个火车站,配文说“这是印度北部某州的重要铁路枢纽,其所属铁路公司总部在首都”,你想知道从这个车站延伸出的一条铁路线是哪年动工的。
要回答这个问题,你需要做几件事:先确认照片里的火车站是哪个(看图),再查这个车站所属的铁路公司(查文字资料),最后找到该铁路线的动工时间(图文结合推理)。这对人来说尚且需要几步操作,对AI来说更是难上加难。
过去的AI智能体,要么是“文字控”,只能处理纯文本信息,遇到图片就卡壳;要么是“看图侠”,能识别图片里的物体,却不会结合文字背景做深度推理。比如有的AI能认出照片里是火车站,却不知道“印度北部某州”“铁路公司总部在首都”这些文字信息该怎么用;有的AI能查资料找到铁路公司信息,却对照片里的车站视而不见。
研究员们发现,现实世界的问题大多是“图文混合”的:看科研论文需要理解图表和文字结论,刷新闻需要结合图片和报道内容,甚至网购时都要对比商品图片和详情页描述。如果AI只能处理单一模态的信息,就像一个只有一只眼睛能看见的侦探,永远抓不到完整的线索。
于是,WebWatcher的研发目标很明确:让AI既能看懂图,又能读懂字,还能像人一样用工具(比如搜图片、查网页、算数据),把这些能力结合起来解决复杂问题。
二、WebWatcher:一个会“动手动脑”的多模态智能体
WebWatcher到底是什么?简单说,它是一个“三合一”智能体:
• 视觉-语言翻译官:能把图片里的信息(比如图表、物体、场景)转化成文字,再结合文本信息做推理;
• 工具使用者:会用“图片搜索”“文字搜索”“网页访问”“计算器”“文字提取(OCR)”等工具,就像人遇到不懂的问题会查手机、翻资料一样;
• 深度思考者:能规划解决问题的步骤,比如先看图猜物体,再搜资料验证,最后计算数据得出结论,而不是瞎猜。
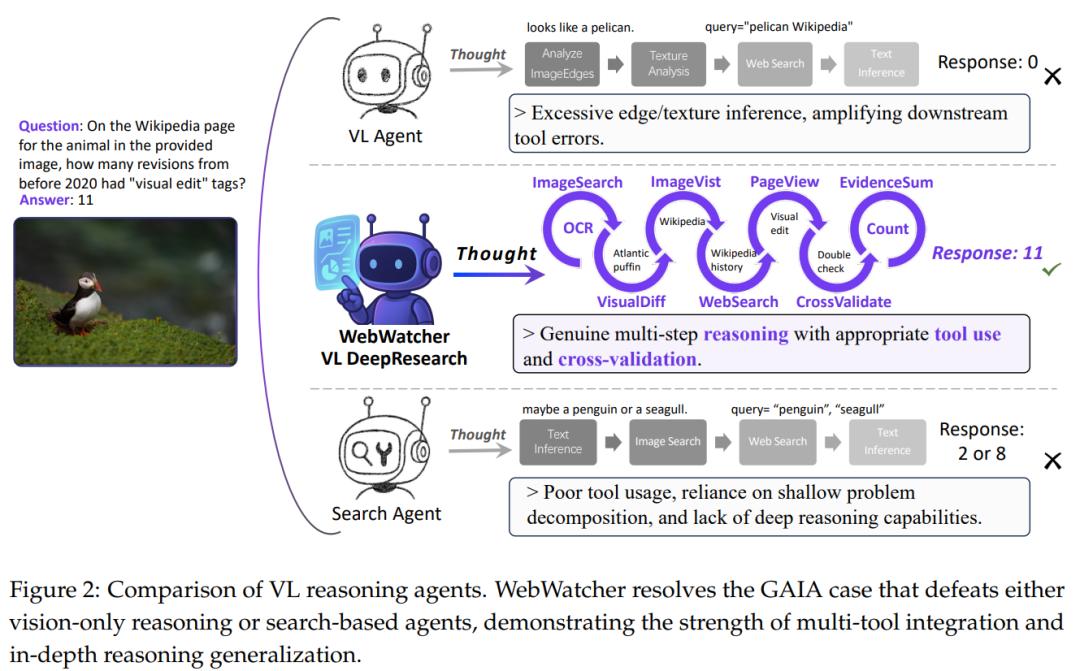
举个例子,面对“图片里的动物在维基百科页面上,2020年前有多少次带‘visual edit’标签的修订?”这个问题:
• 普通视觉智能体可能只会认出动物是鹈鹕,却不会查维基百科;
• 普通文字智能体可能会搜“鹈鹕维基百科”,却不知道图片里的动物是不是鹈鹕;
• 而WebWatcher会先通过图片判断动物可能是企鹅或海鸥,再分别搜索验证,找到正确页面后,用工具提取修订记录,最终算出答案。
这种“先观察、再搜索、后推理”的能力,正是WebWatcher的核心竞争力。
三、WebWatcher是怎么“练出来”的?
要让AI具备这些能力,可不是简单编个程序就行。研究员们为WebWatcher设计了一套“特训计划”,分为三个关键步骤:练什么(数据准备)、怎么练动作(轨迹生成)、怎么越练越强(训练方法)。
1. 先建一个“超级题库”:BrowseComp-VL基准
想让学生考得好,得先有好题库。WebWatcher的“题库”叫BrowseComp-VL,是一个专门为多模态推理设计的 benchmark(基准)。
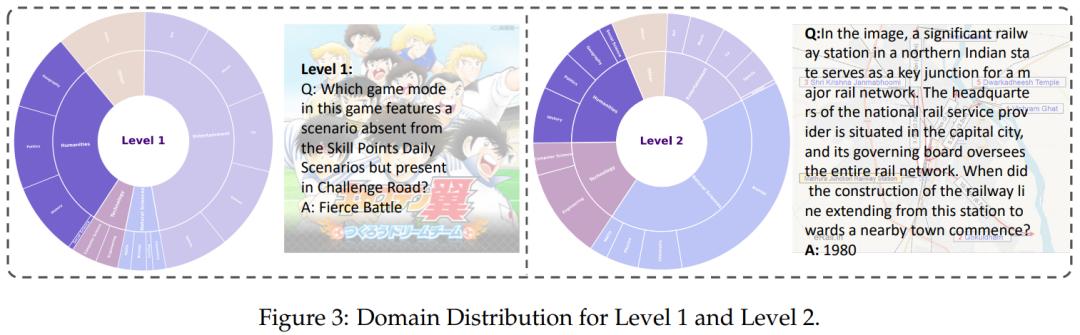
这个题库有多特别?它涵盖了5大领域(娱乐、人文、科技、自然科学等)、17个细分领域,还分了两个难度等级:
• Level 1:问题里的实体是明确的,比如“图片里的城市是巴黎,它的标志性建筑是什么?”,需要多步搜索但线索清晰;
• Level 2:问题里的实体被“模糊化”了,比如“图片里的欧洲首都,其标志性建筑有铁塔,该建筑建于哪年?”,需要先猜城市,再查建筑,最后找年份,更考验推理能力。
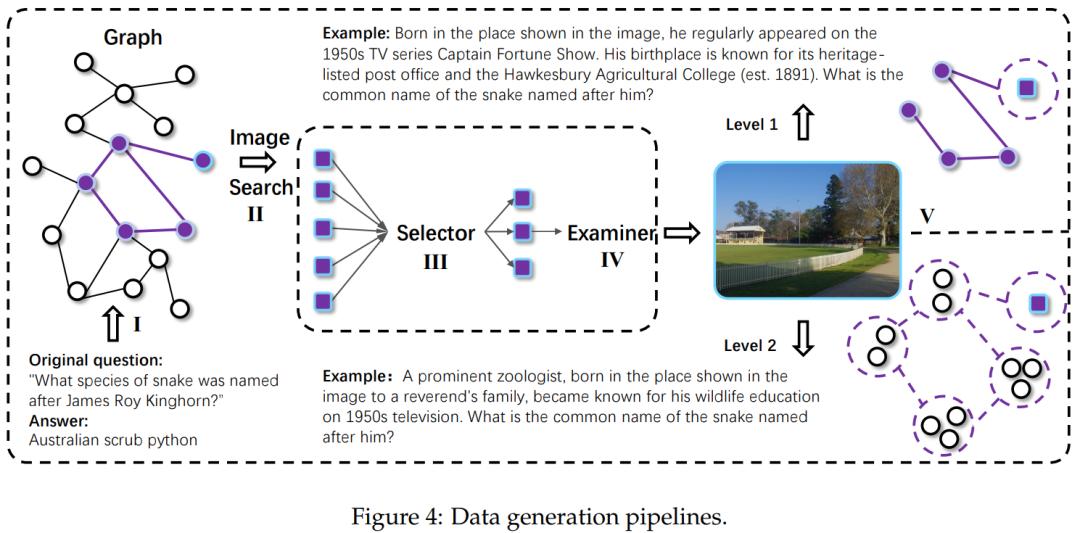
更关键的是,这些题目都“有图有文”。比如一道题可能配一张蛇的图片,问“图片里的地方出生的动物学家,有一条以他命名的蛇,这蛇的俗名是什么?”——要解这题,得先通过图片认出地点,再关联动物学家,最后找到蛇的名字,全程需要图文交叉验证。
这个题库的构建方法也很巧妙。研究员们先从维基百科、arXiv等权威来源爬取文本问答(比如“以詹姆斯·罗伊·金霍恩命名的蛇是什么?”),再把问题里的关键实体(比如“詹姆斯·罗伊·金霍恩”)换成图片(比如他出生地的照片),最后用AI和人工筛选确保题目质量。这样一来,题库既保留了文本推理的复杂度,又加入了视觉信息,完美模拟了现实世界的问题。
2. 模拟“解题步骤”:生成推理轨迹
有了题库,还得教WebWatcher“怎么解题”。研究员们想到了一个办法:生成“推理轨迹”——就像老师给学生展示解题步骤,每一步怎么做、用什么工具、得到什么结果,都写得明明白白。
比如解一道KenKen谜题(类似数独的算术游戏),轨迹会记录:
1. 先看图片里的谜题结构(用OCR提取笼子和数字);
2. 搜“4x4 KenKen解法”(用文字搜索);
3. 访问相关网页学习技巧(用网页访问);
4. 用计算器验证数字组合是否符合规则(用代码解释器);
5. 最终得出答案。
这些轨迹不是瞎编的,而是严格按照“思考-行动-观察”的循环生成的:“思考”是智能体的想法(比如“我需要先确认图片里的笼子数字”),“行动”是调用的工具(比如“用OCR提取文字”),“观察”是工具返回的结果(比如“提取到笼子标注‘8+’‘6*’”)。
为了保证轨迹质量,研究员们还做了三层筛选:答案必须正确、步骤必须逻辑连贯、至少用3个工具(避免偷懒)。这样一来,WebWatcher学到的就是“靠谱的解题思路”,而不是瞎蒙的技巧。
3. 从“学会”到“学精”:训练方法
有了题库和轨迹,WebWatcher的训练就像人学技能一样,分两步走:
• 冷启动( supervised fine-tuning ):先让智能体“照葫芦画瓢”,学着模仿优质轨迹解题。这就像新手学开车,先看教练示范每一步操作(挂挡、踩油门),再自己尝试,确保动作规范。
• 强化学习( GRPO ):光模仿还不够,还得让它“从错误中学习”。研究员们让智能体多生成几种解题轨迹,然后给这些轨迹打分(比如答案对不对、步骤规范不规范),鼓励得分高的轨迹,惩罚得分低的。这就像运动员通过多次训练调整动作,越练越熟练。
通过这两步,WebWatcher不仅能学会基本的解题步骤,还能根据不同问题灵活调整策略——比如遇到图表题多用计算器,遇到陌生物体题多用图片搜索。
四、WebWatcher有多强?战绩说话
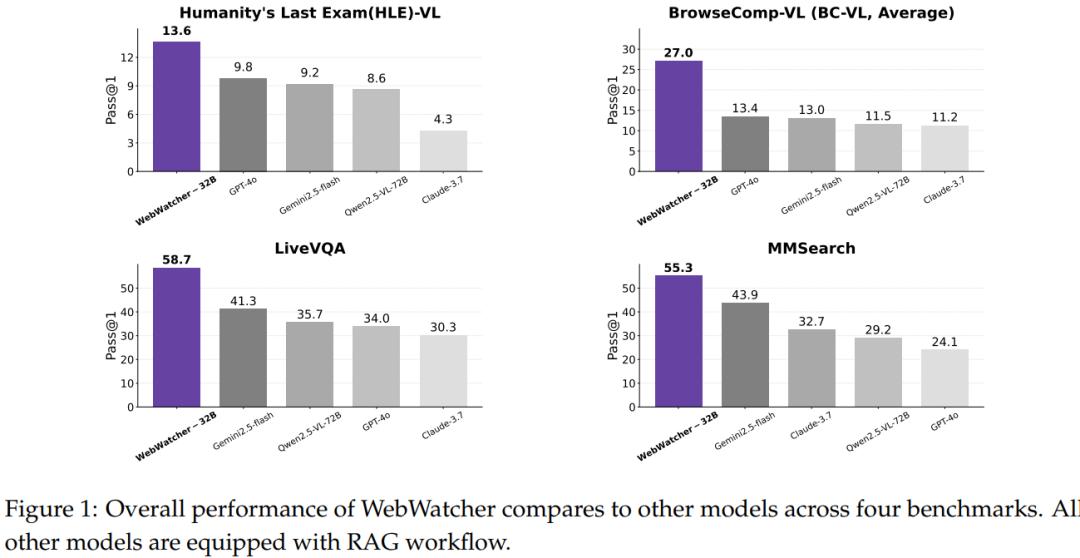
光说不练假把式,研究员们用四个权威 benchmark 测试了WebWatcher的能力,结果相当亮眼:
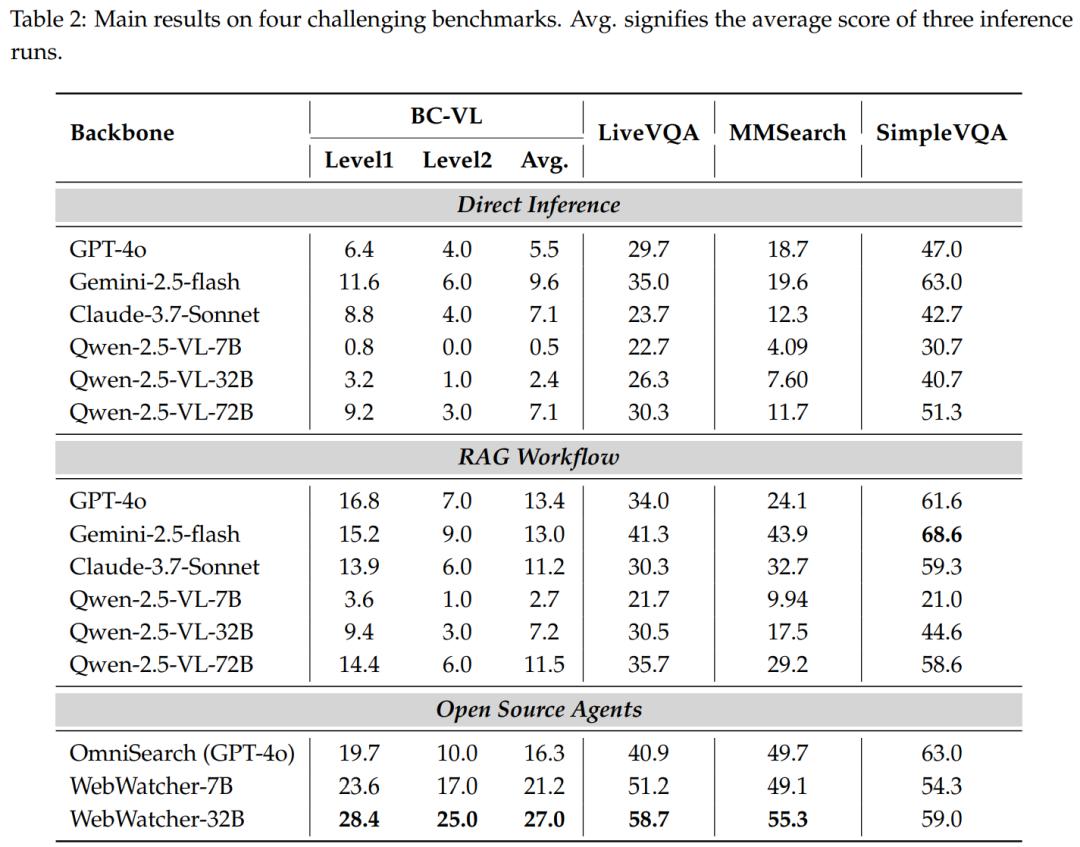
• LiveVQA(测试实时视觉知识):得分58.7%,超过GPT-4o(34.0%)和开源智能体OmniSearch(40.9%),说明它更擅长结合最新图片和新闻信息;
• MMSearch(测试多模态搜索):得分55.3%,远超Qwen-2.5-VL-72B(29.2%),说明它找图文信息更准;
• BrowseComp-VL(自家题库):平均得分27.0%,是第二名OmniSearch(16.3%)的1.6倍,尤其在高难度的Level 2问题上优势明显;
• HLE-VL(人文社科难题):平均得分13.6%,超过所有开源智能体,在生物学、物理学等领域表现突出。
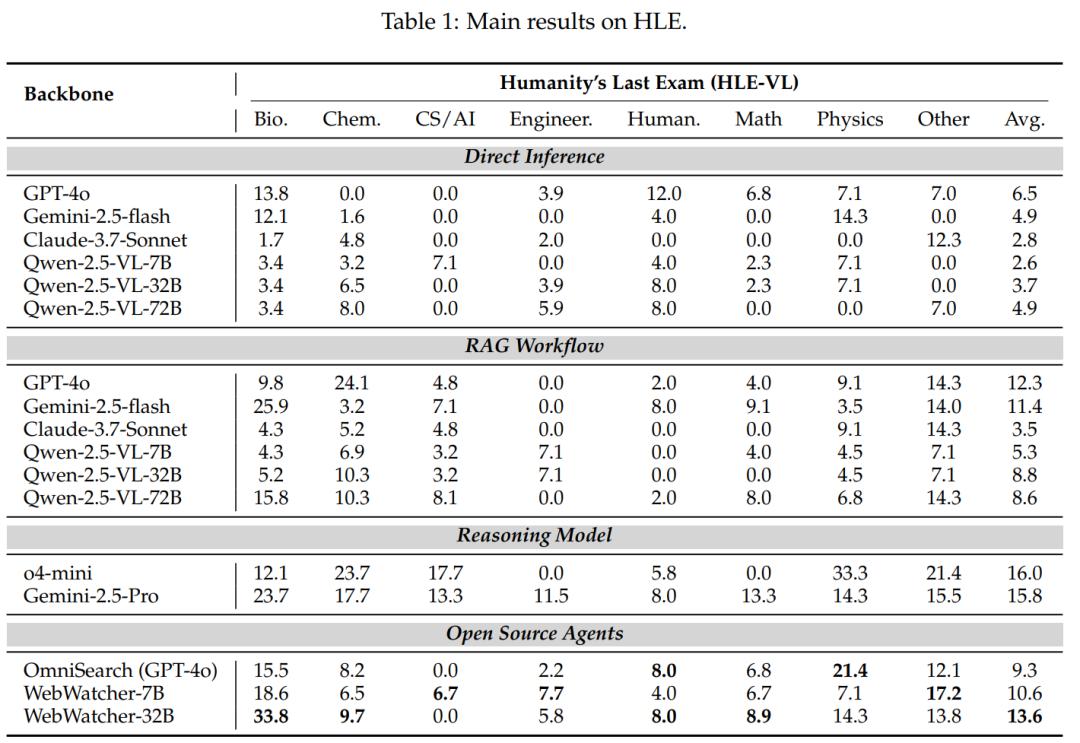
为什么能赢?关键在于WebWatcher的“工具使用智慧”。比如在HLE-VL测试中,它会根据问题类型灵活选工具:遇到数学题多用计算器,遇到历史题多查网页,遇到图片题先OCR再搜索,而其他智能体要么只用一种工具,要么乱用工具有时甚至用图片搜索解数学题,自然效率低。
五、多模态智能体的未来:不止于“解题”
WebWatcher的意义,远不止“考得好”。它代表了AI发展的一个重要方向:从“单一能力”走向“综合智能”。
过去,AI就像流水线上的工人,各司其职:有的看图片,有的读文字,有的算数据。而WebWatcher更像一个“全能助理”,能把这些能力串起来,解决现实中更复杂的问题——比如帮科学家分析论文里的图表和结论,帮记者验证新闻图片的真实性,帮普通人规划旅行(结合景点图片和攻略文字)。
研究员们还提到,未来的多模态智能体可能会更“主动”:比如看到一张模糊的图片,会自动调整清晰度再识别;发现搜索结果矛盾,会主动找更多来源验证。就像一个越来越老练的侦探,不仅能破案,还能预判线索可能出现的地方。
当然,它也有局限。比如面对极其抽象的艺术图片,WebWatcher可能还是难以理解其中的象征意义;处理超大规模的图文数据时,速度还能再提升。但这并不妨碍它成为AI向“通用智能”迈进的重要一步。
参考资料
• 标题:WebWatcher: Breaking New Frontiers of Vision-Language Deep Research Agent
• 作者:Xinyu Geng, Peng Xia, Zhen Zhang, Xinyu Wang, Qiuchen Wang, Ruixue Ding, Chenxi Wang, Jialong Wu, Yida Zhao, Kuan Li, Yong Jiang, Pengjun Xie, Fei Huang, Jingren Zhou
• 单位:Tongyi Lab , Alibaba Group
• 链接:https://arxiv.org/pdf/2508.05748