晓|ICML2025 生成式 AI 与强化学习教程:AI 学会 “自己闯关”
1770年,欧洲出现了一台轰动一时的“象棋机器人”。它外形酷似一个木箱,带着齿轮和杠杆,能和人类对弈,甚至赢过拿破仑和富兰克林。但当人们拆开木箱才发现,里面藏着一个象棋高手——所谓的“机器人”,不过是人类躲在镜子后面操纵的骗局。
250年后的今天,我们的AI模型似乎也在重复类似的故事。无论是能写文章的大语言模型,还是会画画的图像生成器,看似“智能”的背后,其实大多是在模仿训练数据里的人类行为。就像那台“象棋机器人”,拆开来看,它们的“智慧”本质上是对人类经验的复现。
但如果AI只能模仿,永远成不了真正的“高手”。想象一下:如果AlphaGo只模仿人类棋手的棋谱,永远下不出那些让职业选手惊叹的“神之一手”;如果机器人只照搬人类的操作记录,永远学不会在突发状况下灵活应对。
那么,AI如何才能突破“模仿”的天花板?2025年国际机器学习大会(ICML)上,普林斯顿大学和得克萨斯大学的研究员们带来了一个新思路:让生成式AI和强化学习“联姻”。这不是简单的技术叠加,而是要让AI既能像生成式模型那样“创造”,又能像强化学习智能体那样“闯关升级”。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
第一章:给AI装个“模拟器”——生成模型如何帮强化学习“开挂”
强化学习:不止于“抄作业”
要理解这场“联姻”,得先搞懂两个主角:生成式AI和强化学习。
生成式AI我们不陌生,比如能生成图片的扩散模型、能写代码的大语言模型,核心是“创造”出和训练数据相似的内容。而强化学习,本质是让智能体通过“试错”学会做决策。
举个例子:教智能体玩《俄罗斯方块》。如果用传统的“模仿学习”,就是让它照着人类玩家的操作记录练,最多只能达到人类中等水平。但强化学习不同,它会让智能体自己玩,每消除一行就给个“奖励”(比如加分),慢慢摸索出“先堆高左边,再消右边”的策略,甚至能发现人类没试过的高分技巧。
但强化学习有个大麻烦:太依赖“实战”。就像学开车,总不能一直在路上练——撞了车、耗了油不说,还危险。如果是机器人做手术、控制核聚变这类高风险场景,“实战试错”的成本更是高到离谱。
生成模型:给智能体造个“虚拟训练场”
这时候,生成式AI就派上用场了。研究员们发现,生成模型能当智能体的“世界模型”——简单说,就是给智能体造一个“虚拟训练场”。
比如训练机器人叠杯子,不需要让它在现实中一次次打翻杯子。生成模型可以先“学习”杯子掉落、碰撞的物理规律,然后在虚拟空间里模拟出无数种叠杯子的场景。智能体在这个“模拟器”里练熟了,再到现实中操作,失误率会大大降低。
这个“虚拟训练场”的原理不复杂:生成模型通过分析大量“状态-动作-结果”数据(比如“杯子在A位置,夹起它,放到B位置”),学会预测“做了某个动作后,下一个状态会是什么”。就像我们玩游戏时,看到敌人的位置,能猜到“往左跳”大概能躲开攻击——生成模型就是帮智能体建立这种“预判能力”。
现在,研究员们已经尝试用各种生成模型当“世界模型”:有的用Transformer学复杂序列,有的用扩散模型模拟连续动作(比如机器人手臂的移动),甚至还有用类似“GAN”的模型生成多样化的虚拟场景。这些模型就像不同版本的“模拟器”,各有擅长的场景。
不止于模拟:生成模型还能当“行动指南”
除了当“模拟器”,生成模型还能直接当智能体的“行动指南”(策略)。
比如玩《王者荣耀》,传统强化学习的“策略”可能是一个简单的函数:看到敌人血量低于30%,就释放技能。但生成模型能做得更灵活——它可以像写小说一样,生成一整套“连招”:先走位绕后,再减速,最后放大招。
最有意思的是“奖励条件生成模型”。比如我们想让智能体“赢游戏且少掉血”,可以给生成模型输入“目标奖励”,它会自动生成符合这个目标的行动序列。就像告诉厨师“做一道不辣的川菜”,厨师会自动调整配料和做法,而不是只照搬菜谱。
第二章:互动即创造——为什么说智能体“闯关”也是一种生成模型?
从“画画”到“闯关”:生成模型的两种打开方式
生成式AI的核心是“生成内容”,比如扩散模型生成图片,要经过几十步“去噪”迭代;大语言模型写文章,要一个字一个字往下续。
研究员们发现:智能体和环境互动的过程,其实也是一种“生成”。比如机器人从起点走到终点,每一步移动、避障,最终生成了一条“轨迹”;AlphaGo下一盘棋,每一步落子,最终生成了一局完整的对弈记录。
这种“互动生成”和“画画生成”的区别在于:画画是在像素、文字这些“静态空间”里迭代,而智能体闯关是在“环境动态空间”里迭代——前者的“画笔”是神经网络的参数,后者的“画笔”是智能体的动作。
没有“奖励”也能学?用“目标”代替“分数”
传统强化学习总离不开“奖励”——就像玩游戏时的分数,智能体做对了加分,做错了扣分。但现实中,很多任务没法用“分数”衡量。比如让机器人“整理房间”,什么是“整理好”?是衣服叠整齐?还是桌子擦干净?很难用一个具体的“分数”定义。
研究员们想到了一个办法:用“目标”代替“奖励”。比如告诉智能体“把杯子放到桌子上”,不用给它打分,只要它能达成这个目标就行。这就像快递小哥送货,不用给“每走一步加1分”,只要把包裹送到目的地就完成任务。
这种“目标导向”的学习方式,其实是让智能体学一种“条件生成”能力:给定“目标状态”(比如杯子在桌上),生成能到达这个状态的“行动轨迹”。就像给定“终点”,生成一张“导航路线图”。
从“快递送货”到“多目标任务”
单一目标好办,但复杂任务往往有多个目标。比如“做一顿饭”,需要“洗菜”“切菜”“炒菜”多个步骤,每个步骤都是一个子目标。
这时候,生成模型的“序列生成”能力就派上用场了。研究员们让智能体学一种“目标之间的关联”:比如“切菜”必须在“洗菜”之后,“炒菜”必须在“切菜”之后。就像写文章时,先写开头,再写中间,最后写结尾,有内在的逻辑顺序。
更厉害的是,智能体还能学会“灵活切换目标”。比如做饭时发现“没盐了”,会先暂停炒菜,去买盐——这就像导航时遇到堵车,会自动切换路线,本质是生成了一个“应对突发情况的新轨迹”。
第三章:给AI装个“概率计算器”——如何让智能体学会“算胜算”?
不止于“做动作”,还要“算概率”
智能体光会“做动作”不够,还得知道“这个动作能成的概率有多大”。比如过马路时,不仅要“往前走”,还要估算“现在走过去被车撞的概率”;下棋时,不仅要“落子”,还要算“这步棋赢的概率”。
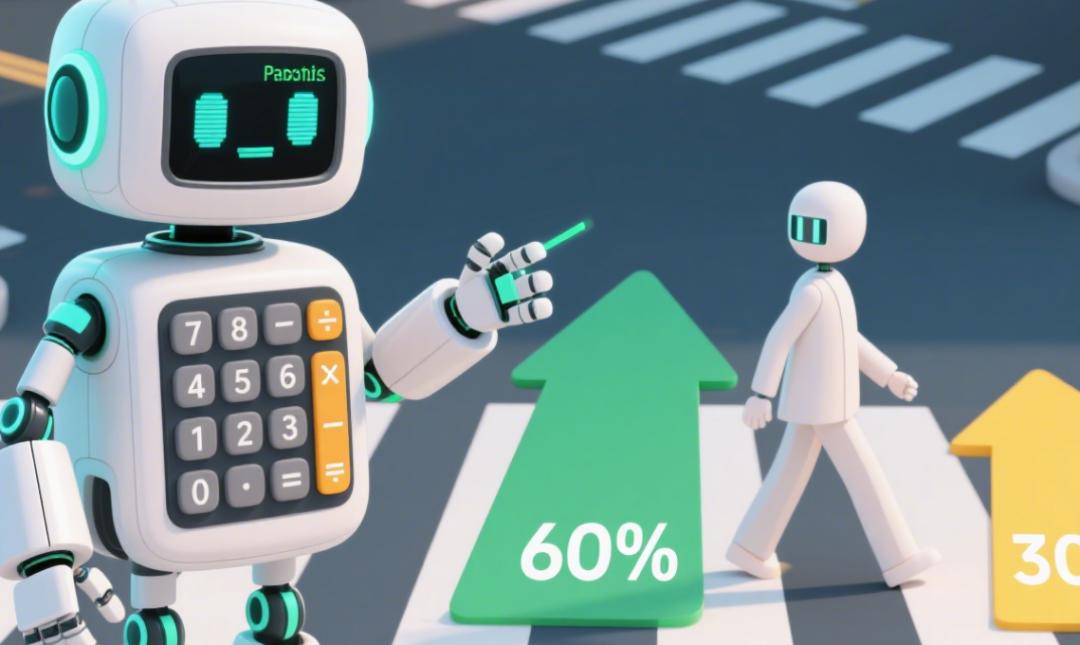
这种“算概率”的能力,其实是生成模型的另一个核心技能:估计“某个结果出现的可能性”。比如图像生成模型能算“这张图像猫的概率”,语言模型能算“这句话通顺的概率”。
在强化学习里,这个“概率”叫“占据度”——智能体在某个状态下,采取某个动作后,最终到达目标的可能性。比如“现在在A点,向左走,最终到达终点的概率是60%;向右走,概率是30%”。
用“对比学习”练出“概率感”
直接算“占据度”很难,尤其是在复杂环境里(比如有100个房间的迷宫)。研究员们想了个巧办法:用“对比学习”让智能体学“相对概率”。
比如给智能体看两段轨迹:一段是“从A点到终点”的成功记录,一段是“从A点走到死胡同”的失败记录。让它学会区分“哪段轨迹更可能到达目标”。就像我们看两个同学的考试卷,不用知道具体分数,也能看出“谁考得更好”。
这种学习方式不需要知道“具体概率是多少”,只要能比较“哪个动作更靠谱”。比如在迷宫里,看到“左边通道有更多人成功走出”,就知道“往左走更可能对”。
从“算概率”到“解所有题”
学会“算概率”后,智能体就能解决各种复杂任务了。
比如“多目标任务”:既想“快速到达终点”,又想“少走弯路”。智能体可以算“每个动作在‘速度’和‘距离’上的概率”,然后找一个平衡点。就像我们选通勤路线,既想“快”又想“不堵车”,会综合考虑两者的可能性。
甚至还能解决“没有明确目标”的任务。比如让机器人“探索一个陌生房间”,智能体可以算“每个角落被探索过的概率”,优先去那些“几乎没去过的地方”。这就像我们逛超市,会先去没去过的货架,而不是反复逛熟悉的区域。
第四章:自己找“练习题”——AI如何学会“主动学习”?
从“喂数据”到“找数据”
不管是生成式AI还是强化学习,都离不开数据。但传统方法是“人喂数据”:我们给AI一堆图片、文本,或者游戏记录,它照着学。
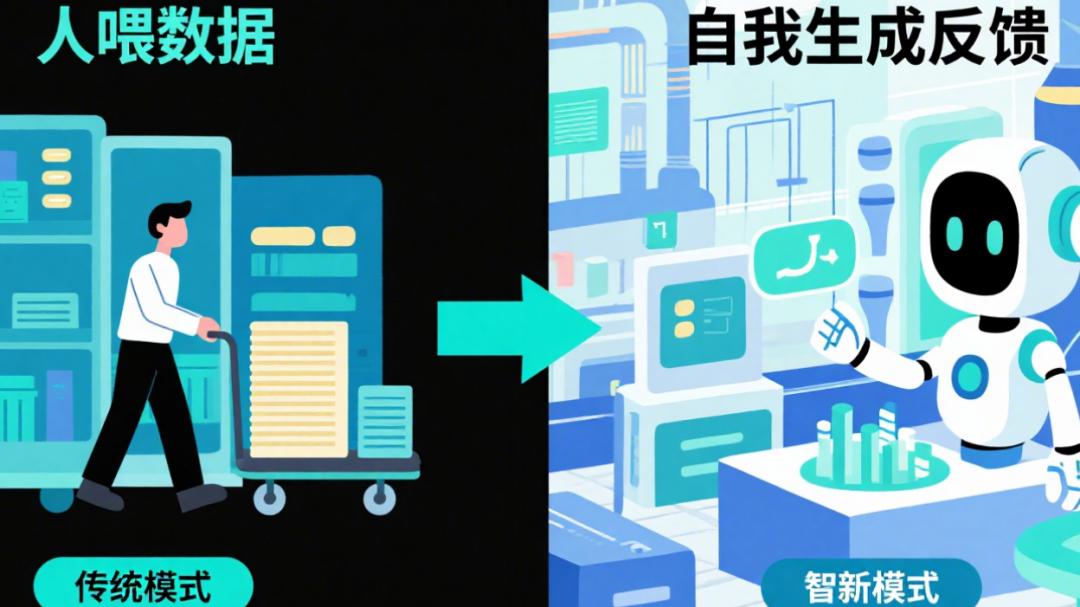
但真正的智能体应该会“自己找数据”。就像人类学习:学生不会只等着老师给题,会主动找练习册、问同学;科学家不会只看别人的论文,会自己做实验。
研究员们把这种能力叫“自我生成反馈”——智能体通过探索环境,自己创造“练习题”,然后从中学技能。
学“有用的技能”,而不是“瞎逛”
探索不是“瞎逛”,得学“有用的技能”。比如机器人学“抓东西”,不能只乱挥手臂,要学“怎么抓圆的东西”“怎么抓软的东西”这些具体技能。
怎么定义“有用”?研究员们提出两个标准:一是“覆盖广”,技能要能应对各种场景(比如既能抓杯子,也能抓书);二是“有区分度”,每个技能要有独特用途(比如“抓”和“推”是两个不同技能,不能混淆)。
这就像健身,不能只练手臂,要练全身(覆盖广);练卧推和练引体向上的动作要区分开(有区分度),不然练不出效果。
从“技能库”到“解决新问题”
学会一堆技能后,智能体遇到新任务时,就能从“技能库”里挑合适的组合。
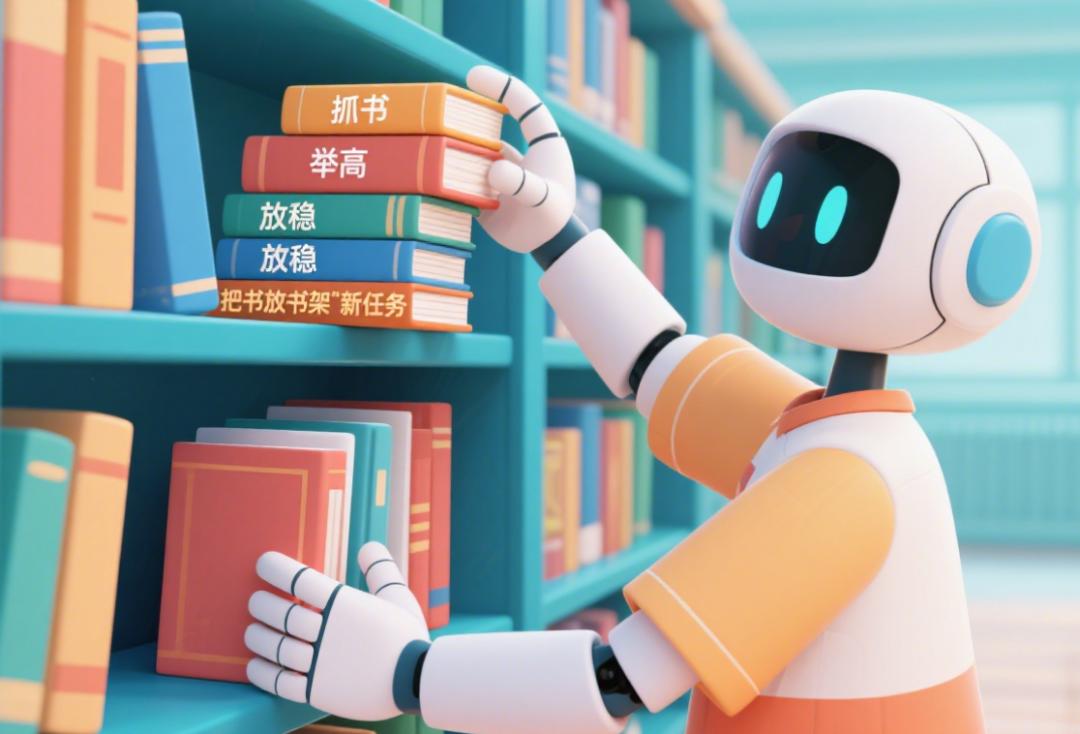
比如遇到“把书放到书架上”的新任务,智能体可以调出“抓书”“举高”“放稳”这几个学过的技能,组合起来完成任务。就像我们做菜,不用学“做宫保鸡丁”的具体步骤,只要会“切肉”“炒花生”“调酱汁”,就能组合出这道菜。
更厉害的是,这些技能还能“举一反三”。比如学会“抓杯子”后,遇到“抓碗”也能快速适应——因为两者的“抓握逻辑”是相通的。这就像学会骑自行车后,学骑电动车会更容易。
结语:AI的“进化”:从“模仿者”到“创造者”
从1770年的“象棋机器人”到今天的AI,我们走过了从“伪装智能”到“模仿智能”的路。但生成式AI和强化学习的结合,可能会让AI迈出第三步:成为“创造智能”。
未来的AI,可能不会只重复人类做过的事。它会像科学家一样做实验,像探险家一样找未知,像工程师一样组合技能。也许有一天,当我们拆开AI的“木箱”,里面不再是人类的影子,而是一套能自主学习、自主创造的“智慧系统”。
当然,这还有很多难题要解:如何让AI的“探索”更高效?如何保证学的技能“真有用”?如何让不同AI的技能“互通”?但至少,我们已经看到了方向——让AI不仅能“生成内容”,更能“生成智慧”。
参考资料
Notes from an ICML 2025 Tutorial: Generative AI Meets Reinforcement Learning,Benjamin Eysenbach、Amy Zhang,https://generative-rl-tutorial.github.io/notes.pdf