精|微软 CVPR'25 权威教程:针对视觉长时程任务的多模态推理
当我们让AI计算“平行四边形中y的值”时,它可能因忽略对边相等的视觉特征而得出错误答案;当要求对比1979年与1986年的教育入学率时,部分模型又会误读图表数据,将2%错判为1%——这些问题的核心,在于多模态模型尚未真正实现“视觉感知与文本推理的深度协同”。
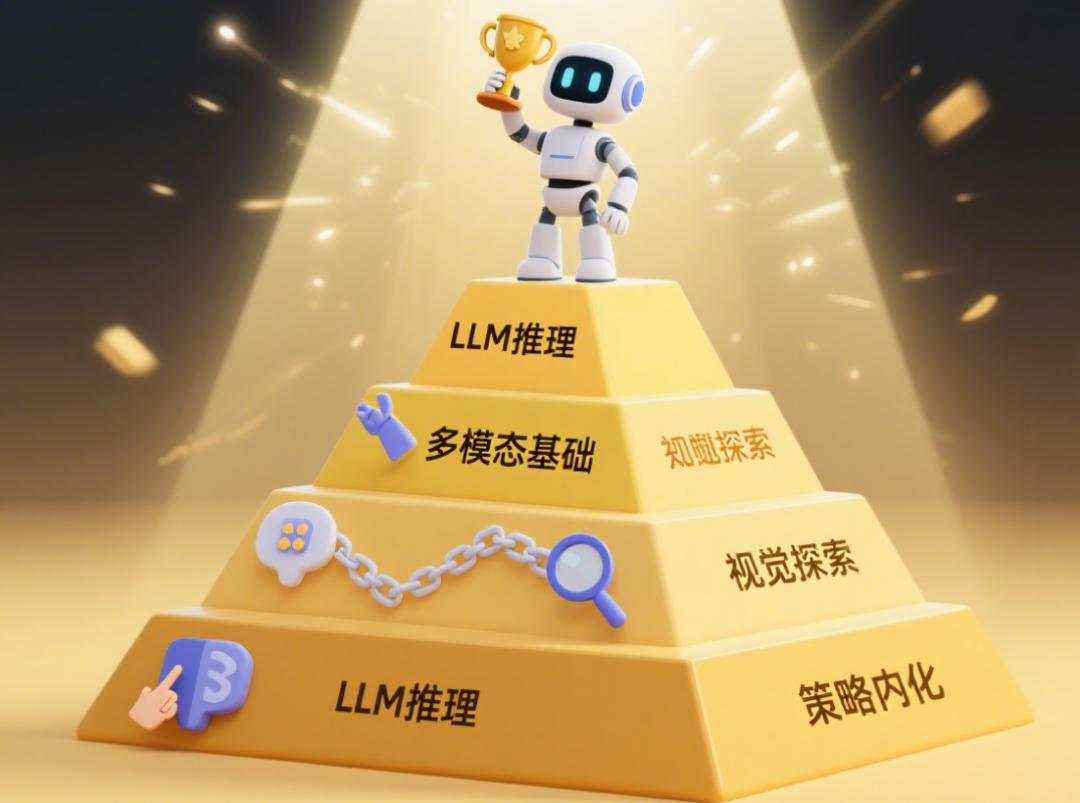
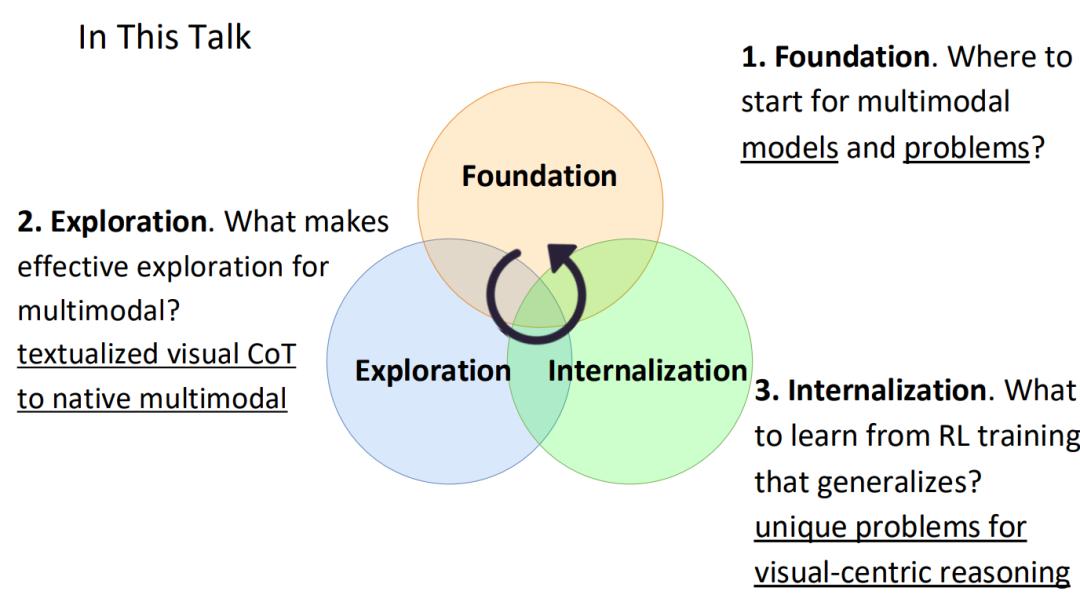
而Microsoft在其CVPR相关报告《Multimodal Reasoning for Visual-Centric Long-Horizon Tasks》中,系统提出了“基础-探索-内化”三阶框架,从文本大模型(LLM)的推理进化出发,逐步拆解多模态场景下的技术难点,为视觉中心长时任务的推理提供了可落地的解决方案。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
第一章 基石:LLM文本推理的突破如何赋能多模态?
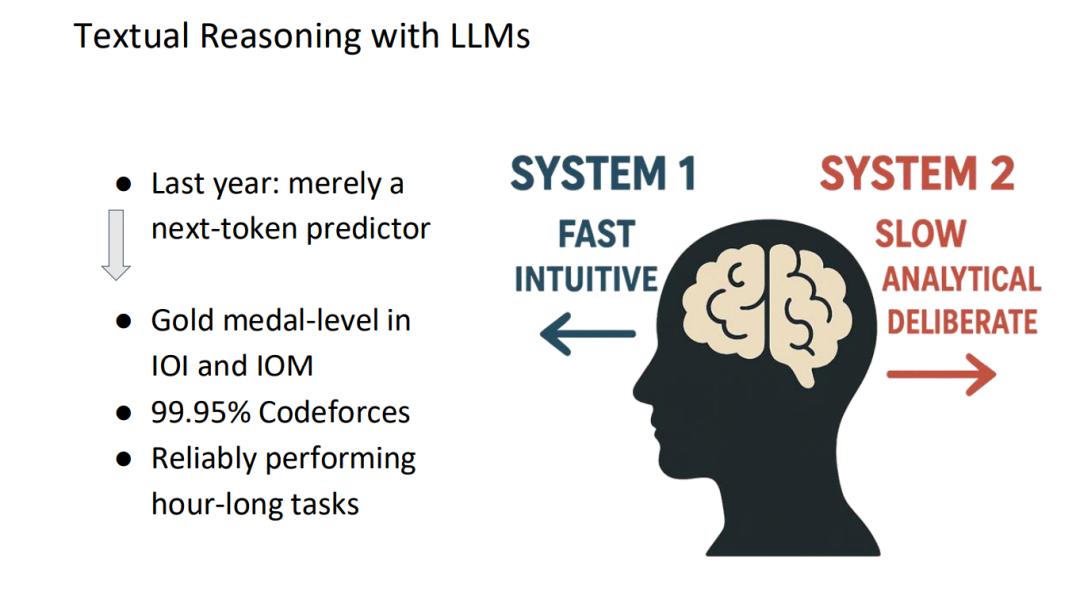
在探索多模态推理前,我们需先理解文本大模型(LLM)的推理能力进化——这是多模态技术的核心基础。LLM的推理能力已实现跨越式提升:从“仅能预测下一个token”,到如今在IOI(Implicit Object Identification)、IOM(Implicit Object Manipulation)任务中达到“金牌水平”,在Codeforces编程竞赛中准确率达99.95%,甚至能稳定处理“小时级”长时任务。
这种突破的核心,源于对“双系统推理”的模拟与强化:
• System 1:快速、直觉式推理,依赖模型预训练中的知识积累,适用于简单任务;
• System 2:缓慢、分析式推理,需通过“主动思考”拆解问题,也是复杂任务的关键。
为实现System 2的推理能力,主要依赖三大技术路径:
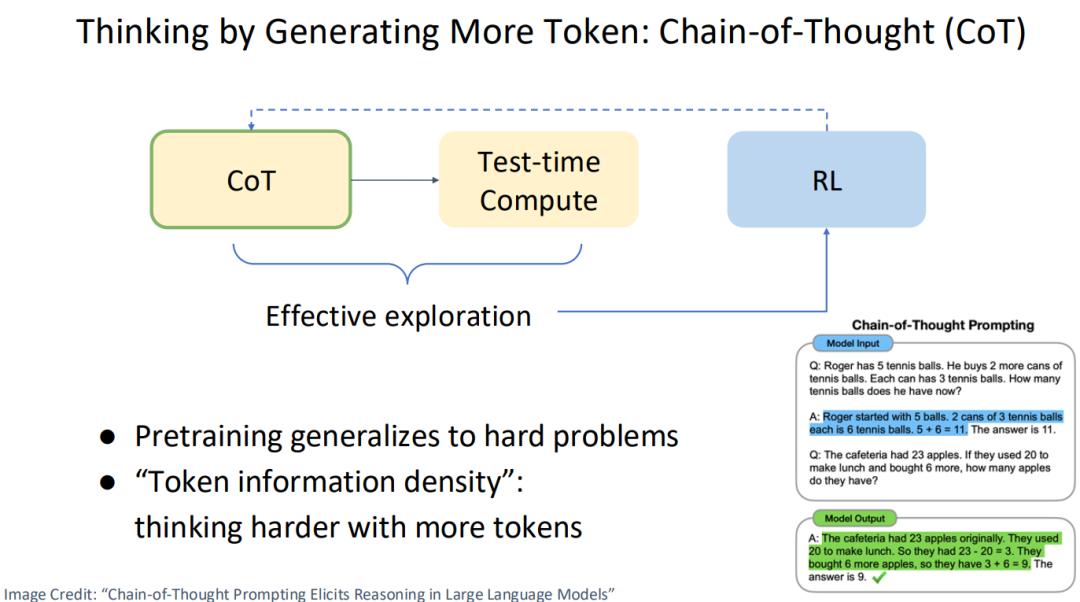
1.1 思维链(CoT):让模型“逐步思考”
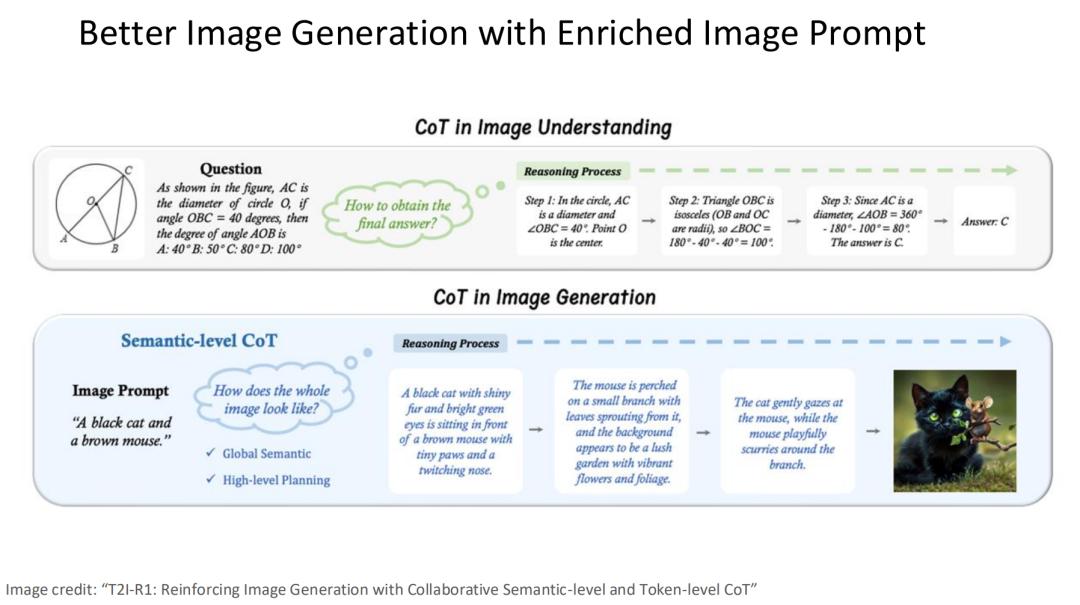
LLM推理的核心创新之一是Chain-of-Thought(CoT,思维链) ——通过生成更多“推理token”,引导模型逐步拆解问题。例如面对数学题“食堂原有23个苹果,用掉20个后又买6个,剩余多少个?”,CoT会促使模型输出“原有23个→用掉20个剩3个→买6个后共9个”的完整步骤,而非直接给出答案。这种“思考过程显性化”的方式,大幅提升了复杂任务的推理准确性。
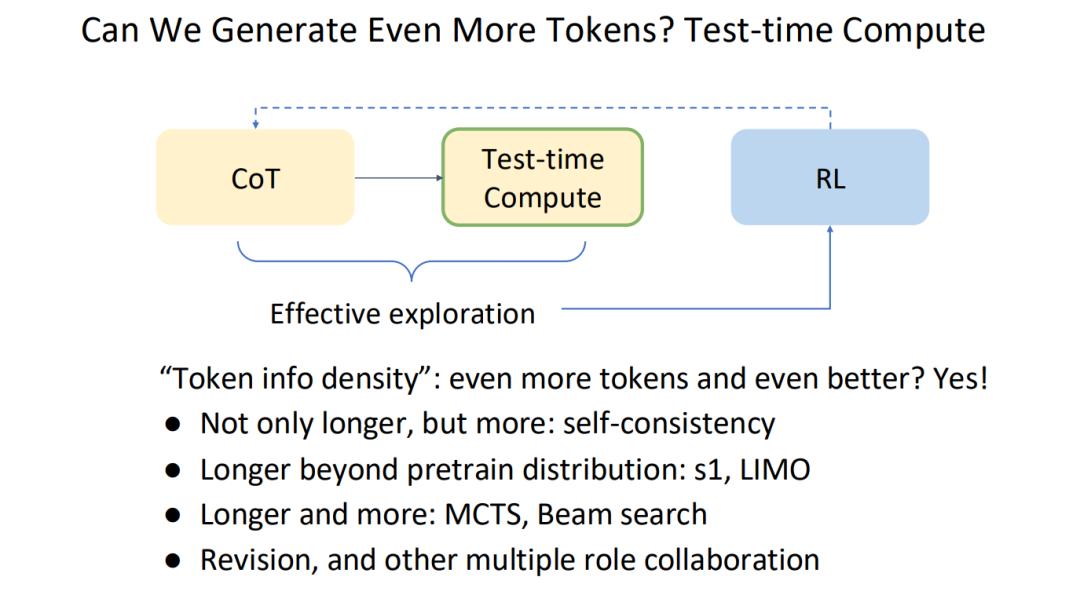
1.2 测试时计算(Test-time Compute):更多token=更优推理
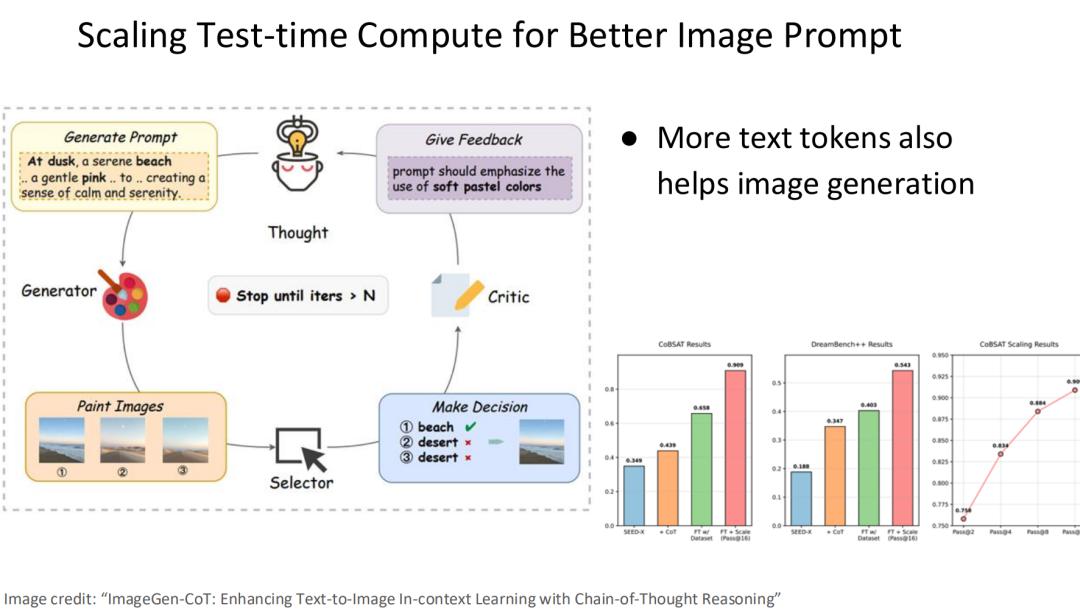
“token信息密度”很重要:模型推理效果不仅取决于token长度,更取决于“思考的充分性”。通过扩展测试时的token生成策略(如自一致性验证、蒙特卡洛树搜索MCTS、波束搜索Beam Search),模型能在“超出预训练分布”的场景下表现更优。例如在几何题求解中,MCTS可通过多轮迭代探索不同推理路径,最终选择最优解。
1.3 强化学习(RL):巩固有效推理策略
若说CoT是“探索思考方式”,RL则是“内化有效策略”。LLM通过RL训练,将“正确的推理路径”转化为模型的默认行为,实现两大目标:
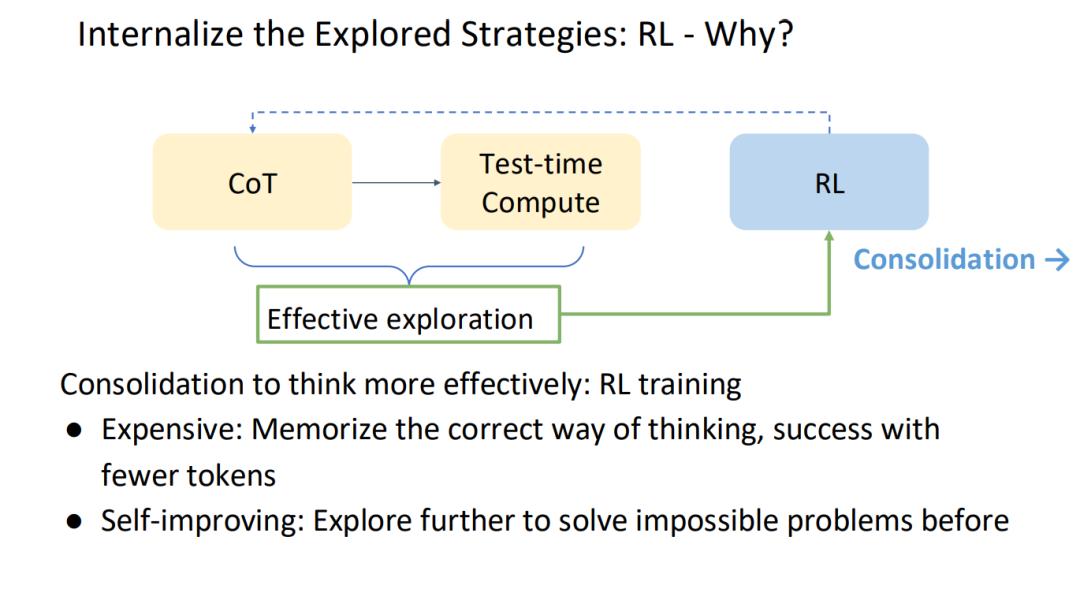
• 降本增效:让模型用更少token完成准确推理,减少计算消耗;
• 自我提升:探索此前无法解决的复杂问题,形成“探索-巩固-再探索”的闭环。
具体实现中,RL框架需依赖“奖励模型(RM)”提供反馈:
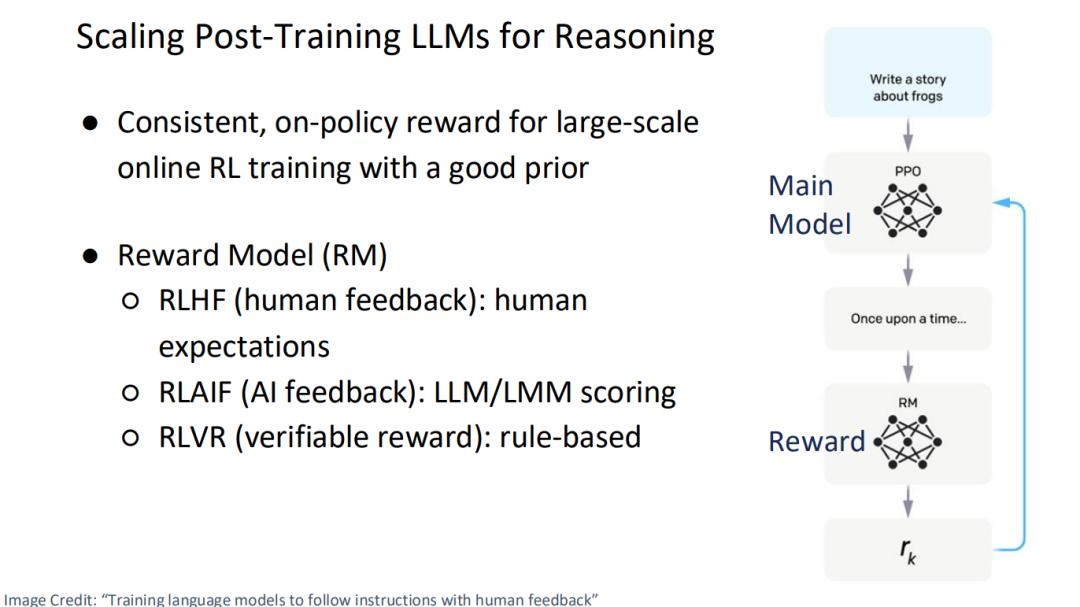
• RLHF(基于人类反馈的强化学习):以人类预期为奖励标准;
• RLAIF(基于AI反馈的强化学习):用LLM或多模态模型(LMM)评分;
• RLVR(可验证奖励):基于规则的客观奖励(如数学题答案是否正确)。
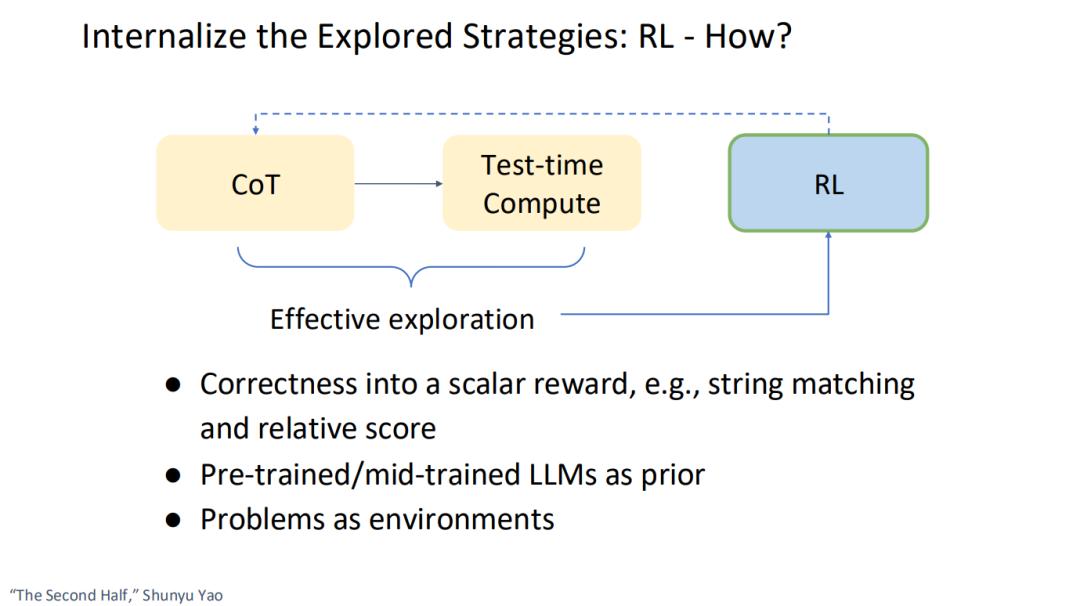
LLM推理的核心逻辑总结为三步:“有模型与问题→探索更优响应→通过RL内化策略”,这一逻辑也成为后续多模态推理的框架雏形。
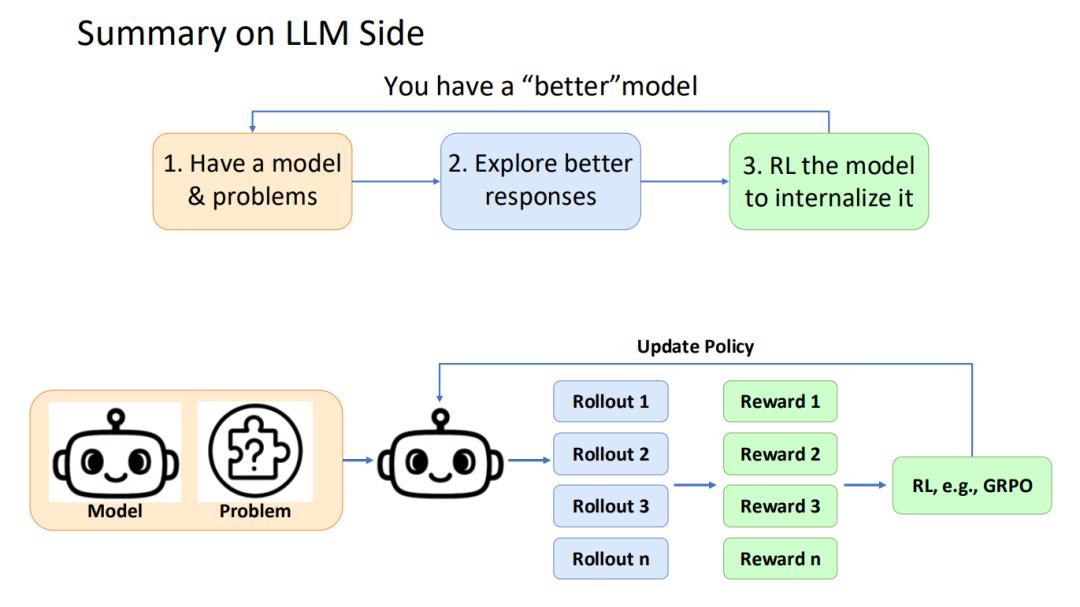
第二章 起点:多模态推理的“双重奠基”——模型与样本
当推理场景从“纯文本”扩展到“视觉+文本”,首要解决的是“基础层”问题:选择什么样的多模态模型?如何筛选能高效训练模型的样本?
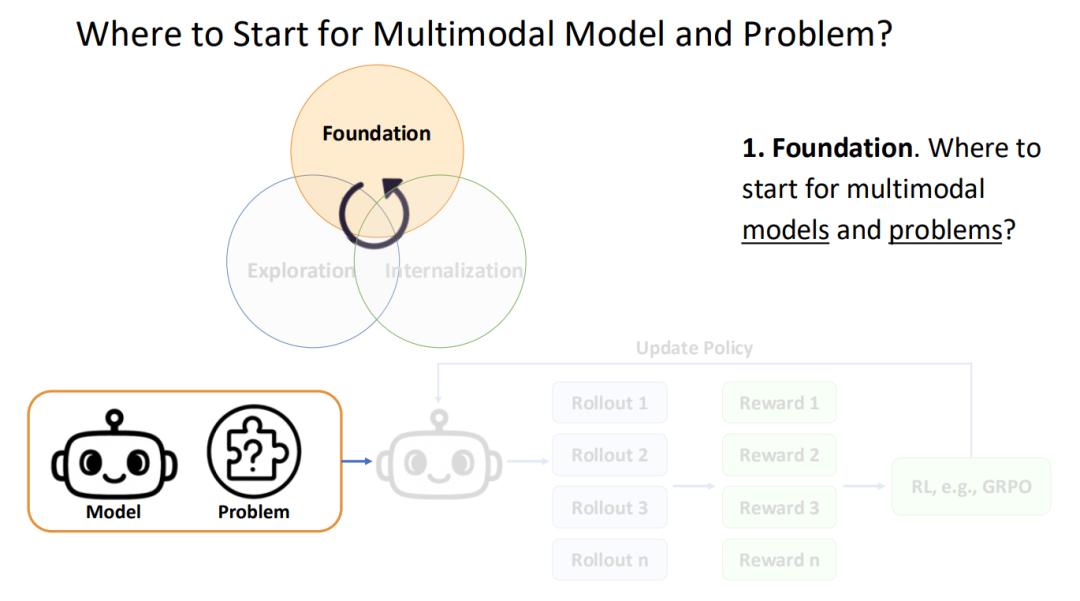
2.1 模型进化:从“文本化视觉输出”到“原生多模态”
早期的视觉-语言模型(如部分Vision-Language Model)本质是“文本模型的延伸”:在LLM预训练基础上添加视觉编码器,将视觉信息转化为文本格式输出(如“图片中有一个甜甜圈在白色盘子上,旁边是一杯拿铁”),核心仍依赖文本预训练知识。
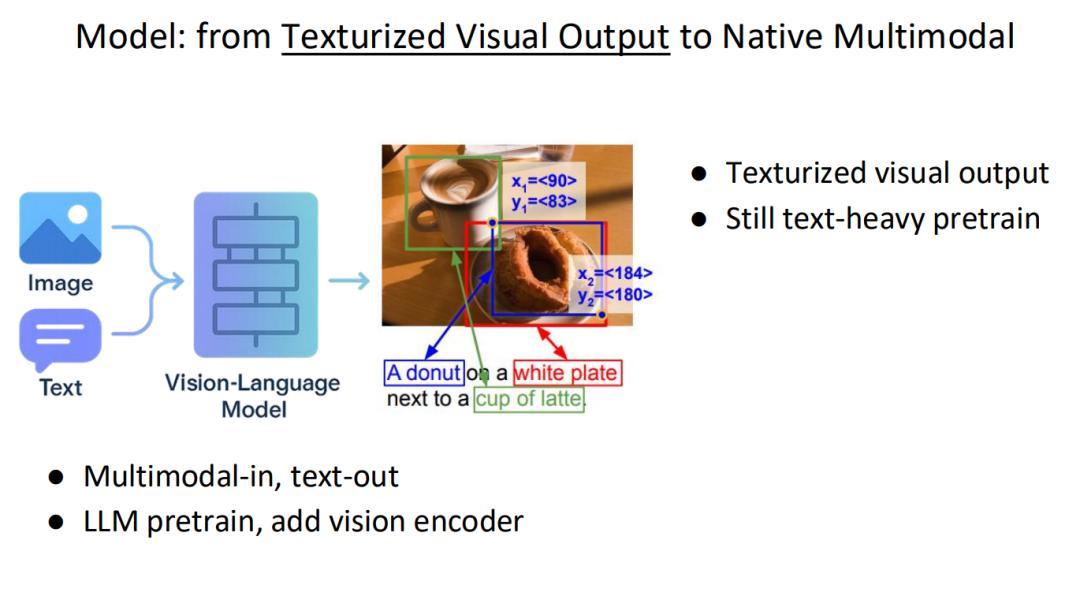
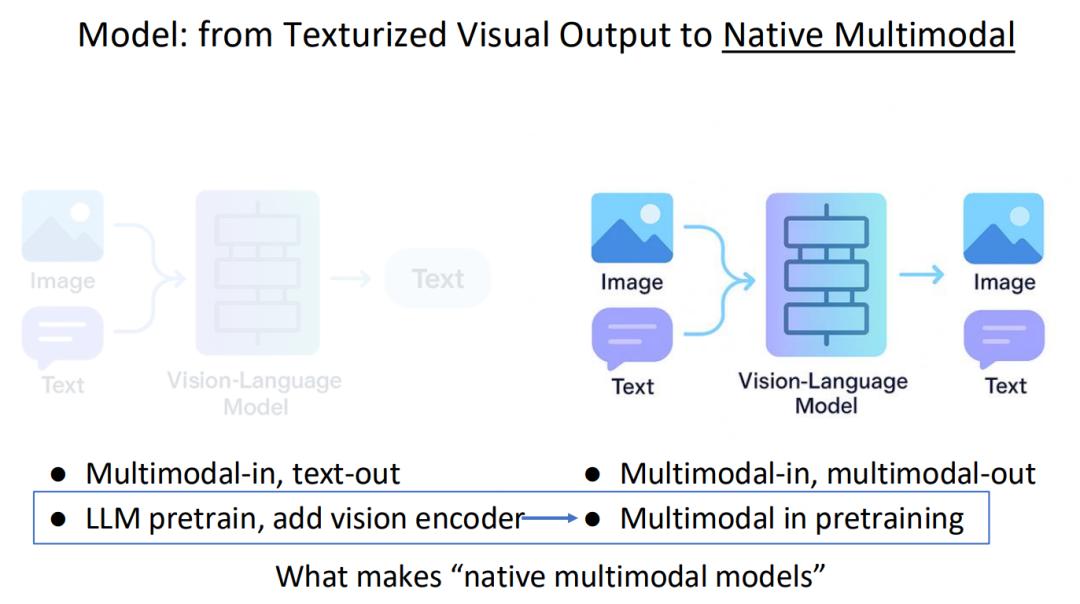
而原生多模态模型才是视觉中心任务的关键——其核心特征是“多模态输入、多模态输出”,且预训练过程本身包含多模态数据。例如,模型可直接接收“图片+文本问题”输入,输出“文本答案+视觉指向标注”(如在图表中标记数据点),无需将视觉信息强行转化为文本,从而保留更细腻的视觉细节。
2.2 样本选择:用MCTS找到“最有价值”的训练数据
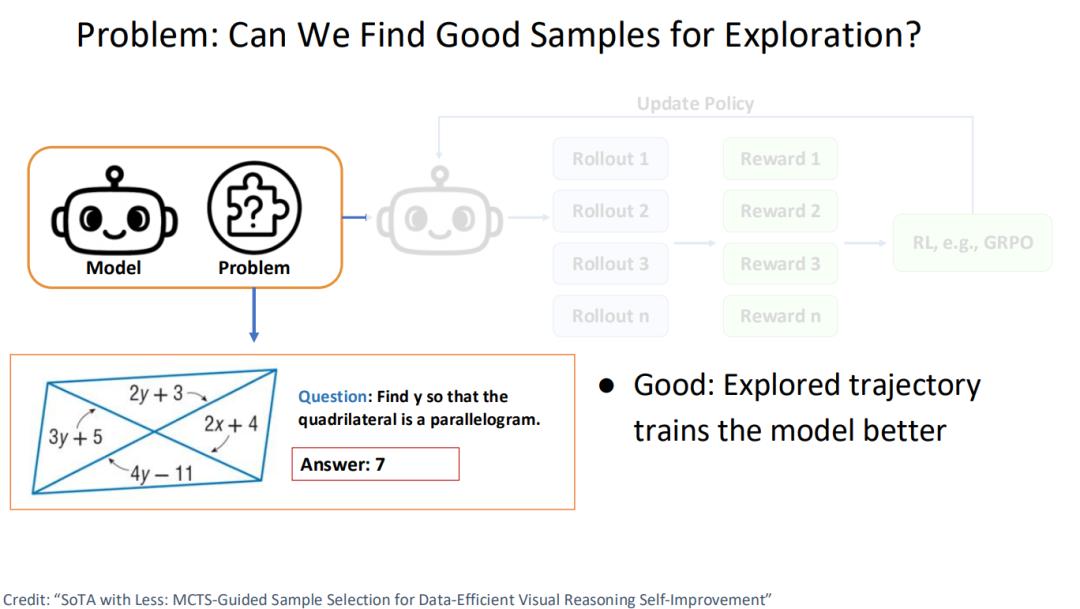
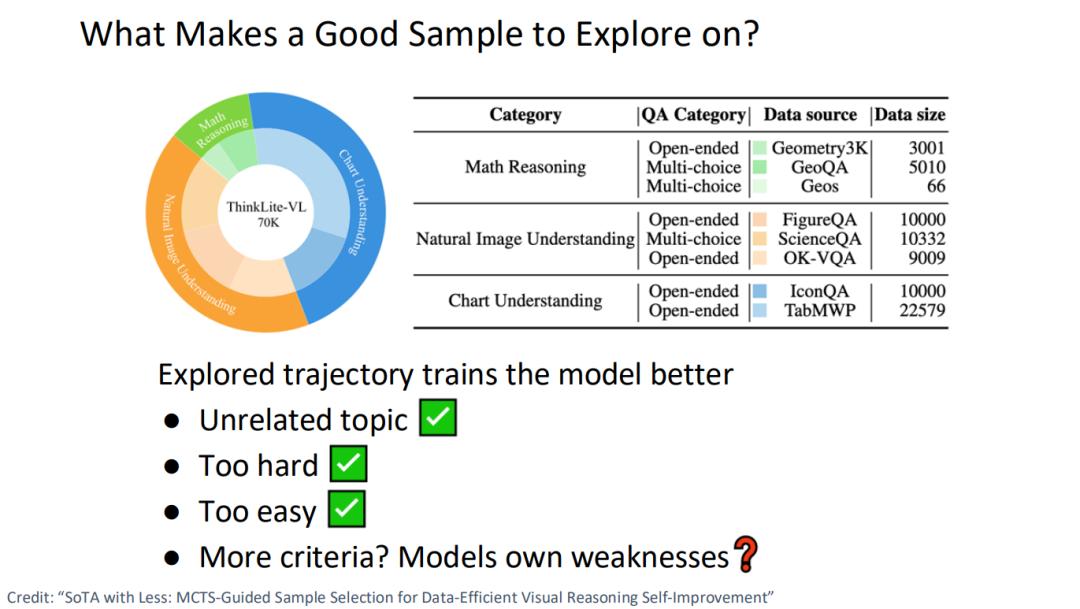
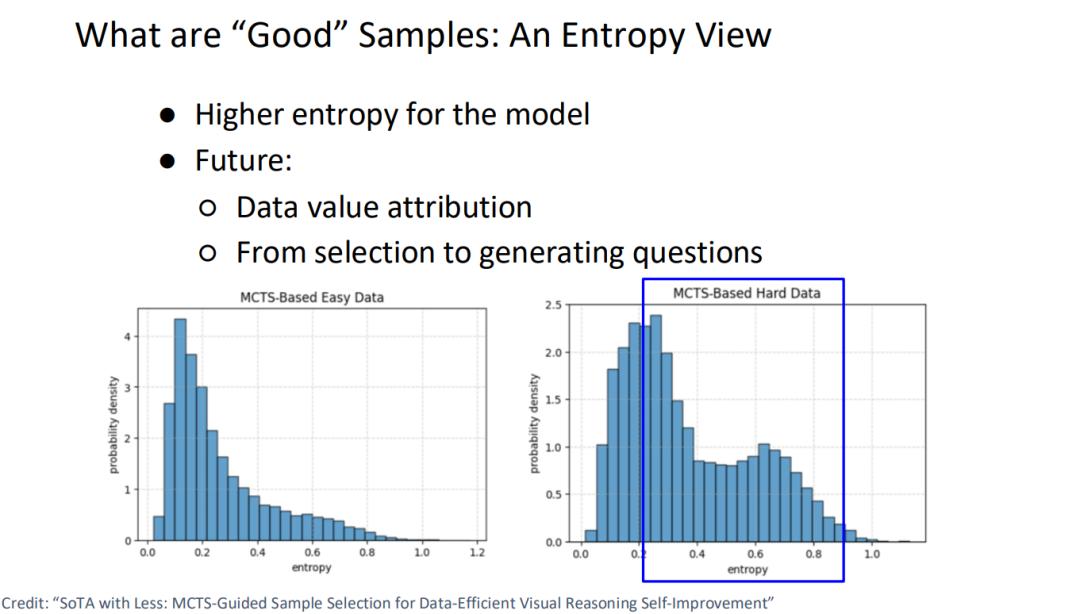
多模态任务的训练样本并非“越多越好”——无关、过难或过易的样本会浪费计算资源,甚至导致模型泛化能力下降。用蒙特卡洛树搜索(MCTS) 筛选“好样本”:通过多轮迭代,让模型在样本上尝试推理,直到得出正确答案,过程中记录“能有效提升模型能力的推理轨迹”,这类轨迹对应的样本即为“高价值样本”。
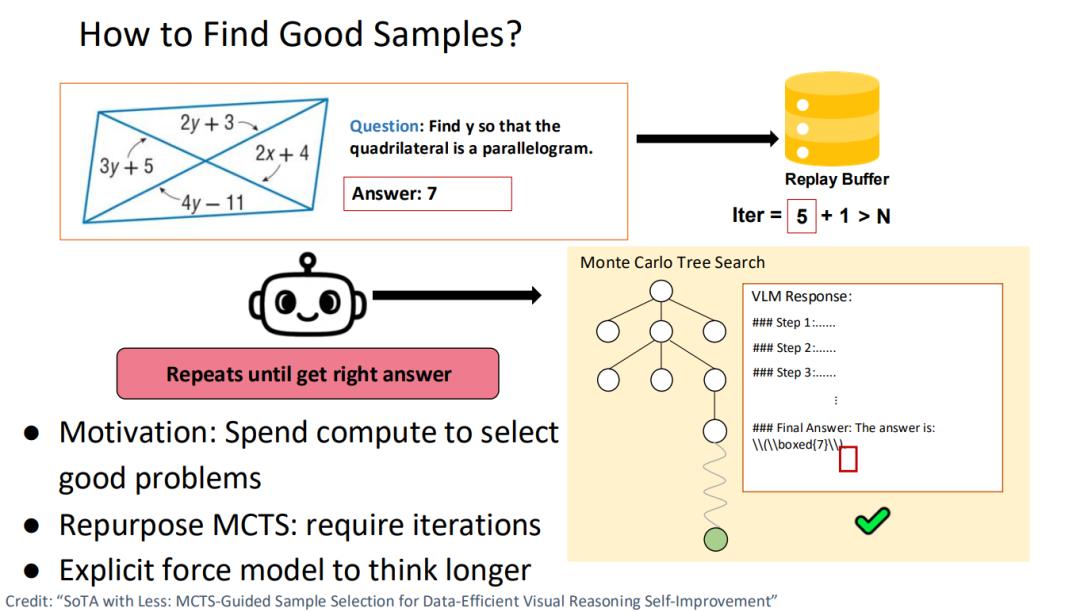
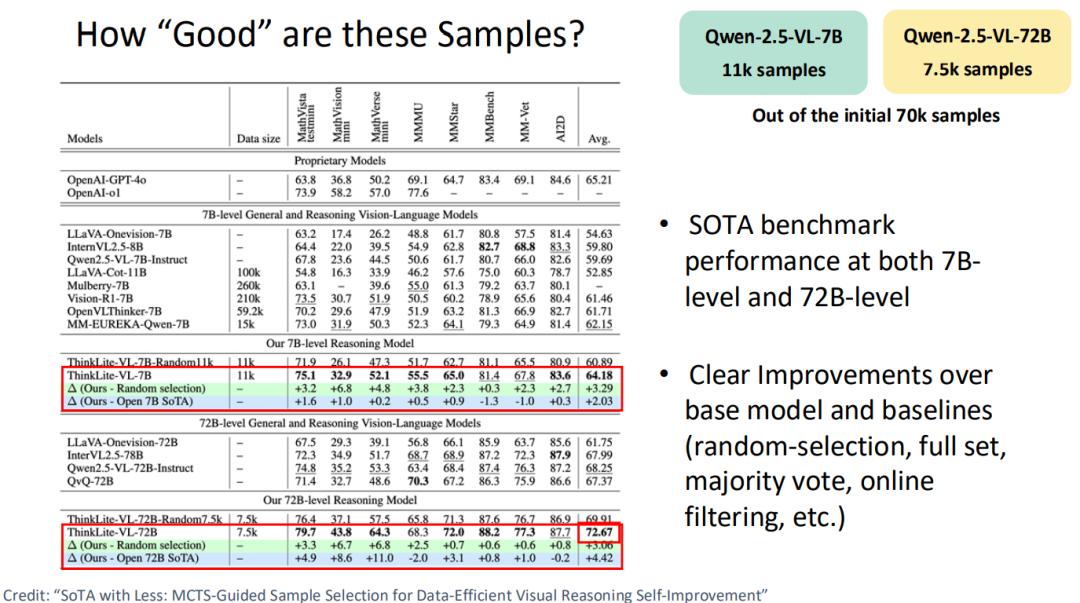
例如在“求平行四边形y值”的几何题中,MCTS会引导模型逐步推理“平行四边形对边相等→2y+3=3y+5→y=7”,并将该样本纳入训练集。实验数据显示,基于MCTS筛选的11k样本(ThinkLite-VL-7B模型),相比随机选择的11k样本,在8项通用基准测试中平均性能提升3.29,且超过开源7B级SOTA模型2.03个百分点;72B级模型(ThinkLite-VL-72B)用7.5k筛选样本,相比开源72B级SOTA模型平均提升4.42个百分点,证明“少而精”的样本能大幅提升训练效率。
第三章 探索:视觉中心——让多模态推理“看见细节”
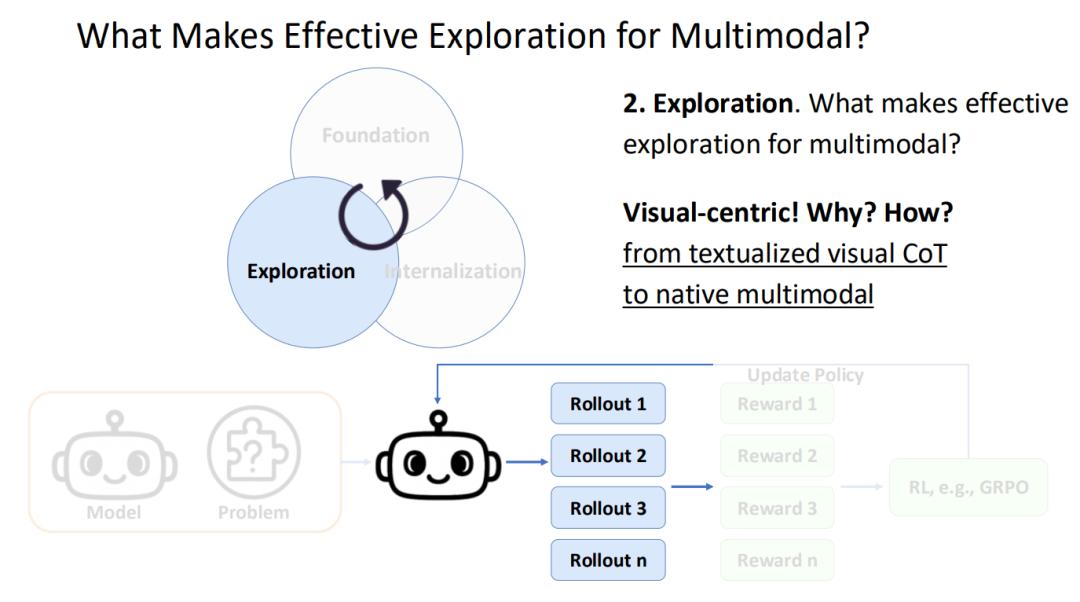
多模态推理的核心难点,在于“视觉信息如何有效参与推理”。这一过程定义为“视觉中心的探索”,这里提出三大技术路径:
3.1 视觉接地(Visual Grounding):Point-RFT让模型“指哪想哪”
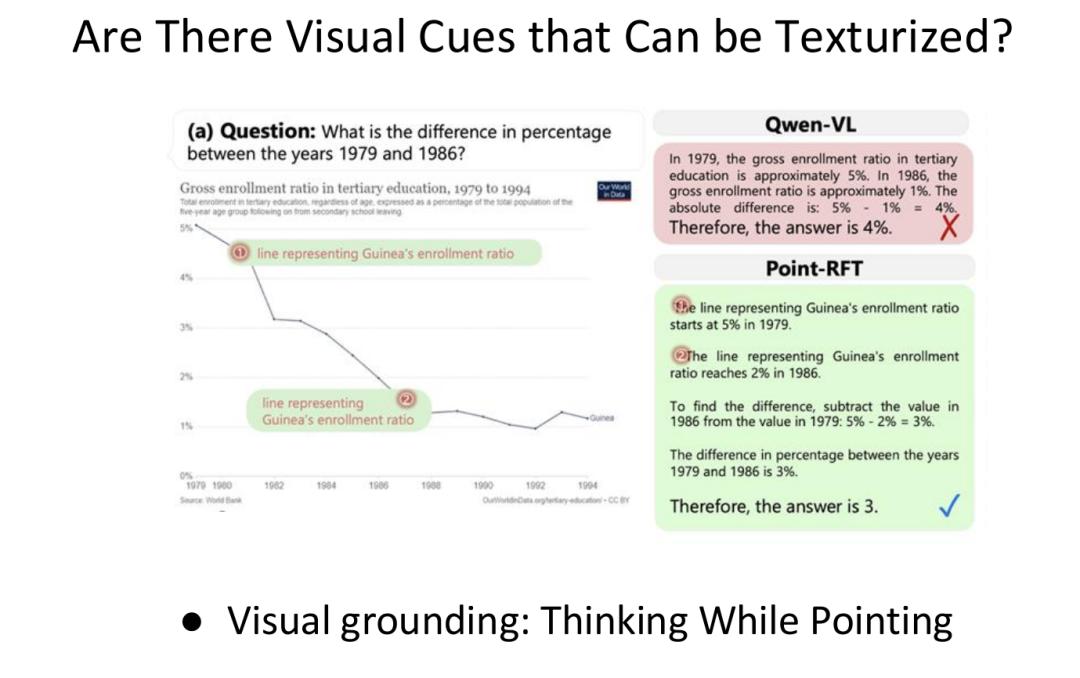
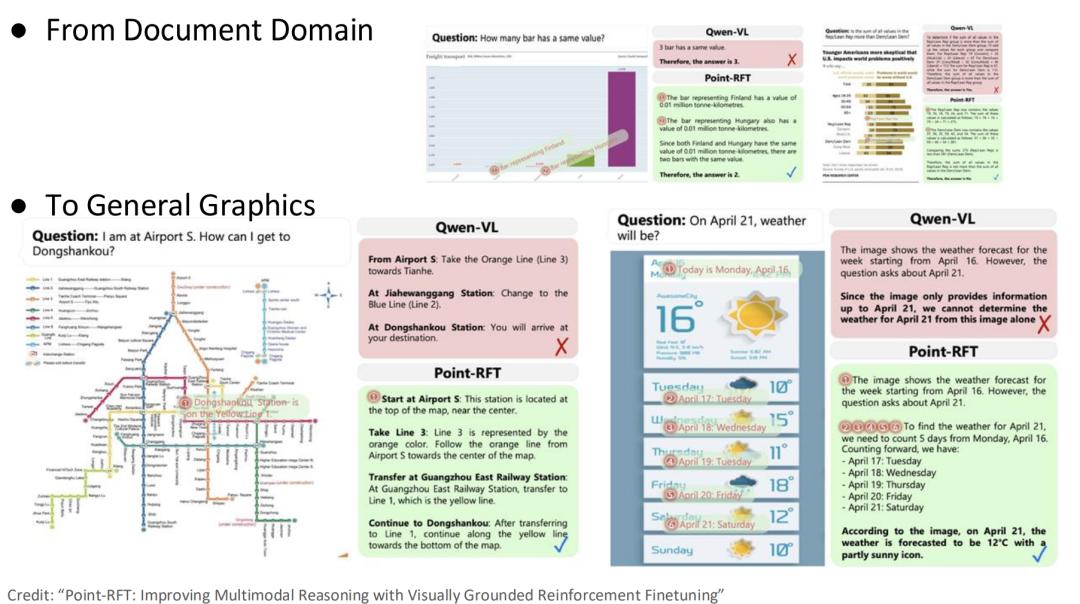
传统多模态模型在处理图表、地图等任务时,常因“视觉信息与文本推理脱节”出错。例如面对“1979年与1986年高等教育毛入学率差值”的问题,Qwen-VL模型误将1986年的2%读为1%,得出“差值4%”的错误结论;而Point-RFT(基于视觉接地的强化微调) 技术通过“思考时指向”解决这一问题:模型在推理过程中,会先标注出图表中1979年的5%和1986年的2%,再计算差值3%,实现“视觉细节与文本计算的绑定”。
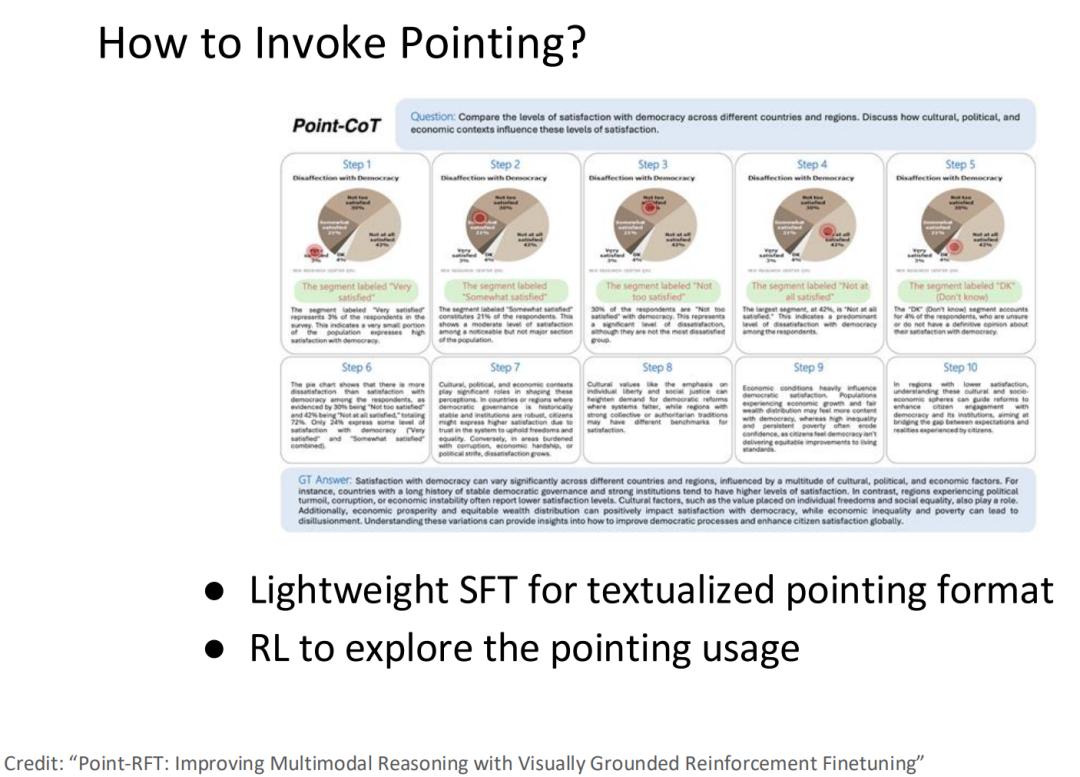
实现Point-RFT需两步:
1. 轻量级监督微调(SFT):让模型学习“文本化指向格式”,如用“①1979年数据点在图表左侧,值为5%”的表述关联视觉位置与信息;
2. RL探索指向用法:通过奖励模型激励“有效指向”,让模型学会在关键推理步骤中调用视觉标注。
该技术已在多场景验证有效性:从文档图表解读,到地图路线规划(如“从机场S到东山口的地铁换乘”),再到天气预报查询(如“4月21日天气”),Point-RFT能显著减少视觉信息误读。
3.2 视觉工具:让模型“主动操作”视觉内容
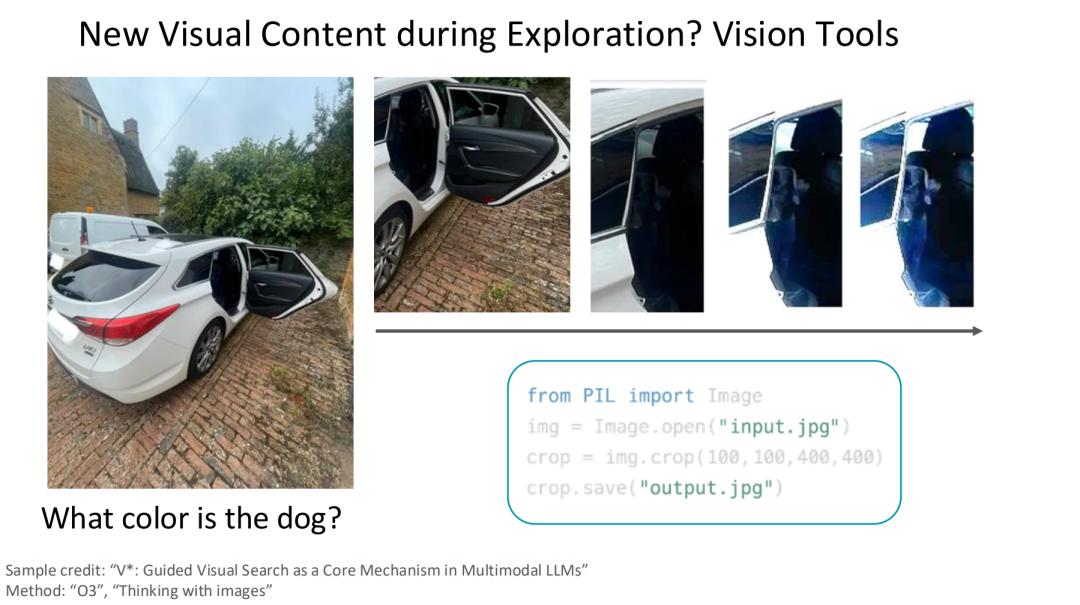
当问题需要“局部视觉信息”时(如“图片中狗的颜色”),仅靠模型内置视觉编码器可能不够——此时需引入视觉工具,让模型通过代码调用工具处理图像(如用PIL库裁剪图片中的狗区域),再基于处理后的视觉信息推理。
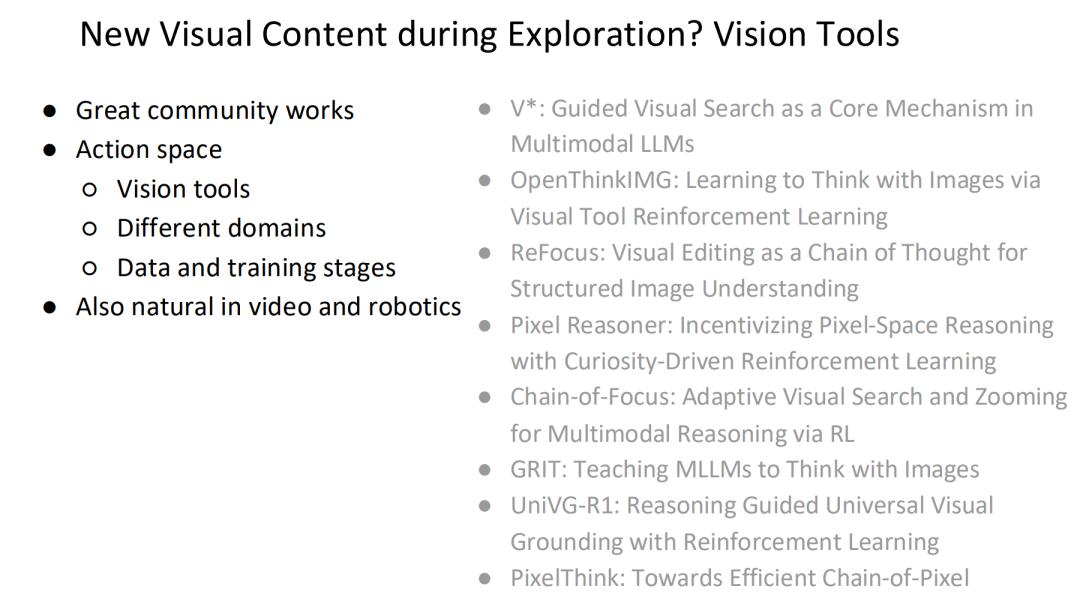
一些重要的视觉工具相关工作:
• V*:将“引导式视觉搜索”作为多模态LLM的核心机制;
• OpenThinkIMG:通过强化学习让模型学会“用图像思考”;
• Chain-of-Focus:自适应视觉搜索与缩放,聚焦关键区域。
这些工具的价值在于:让模型从“被动接收全图信息”变为“主动筛选关键视觉内容”,尤其适用于高分辨率图像或复杂场景。
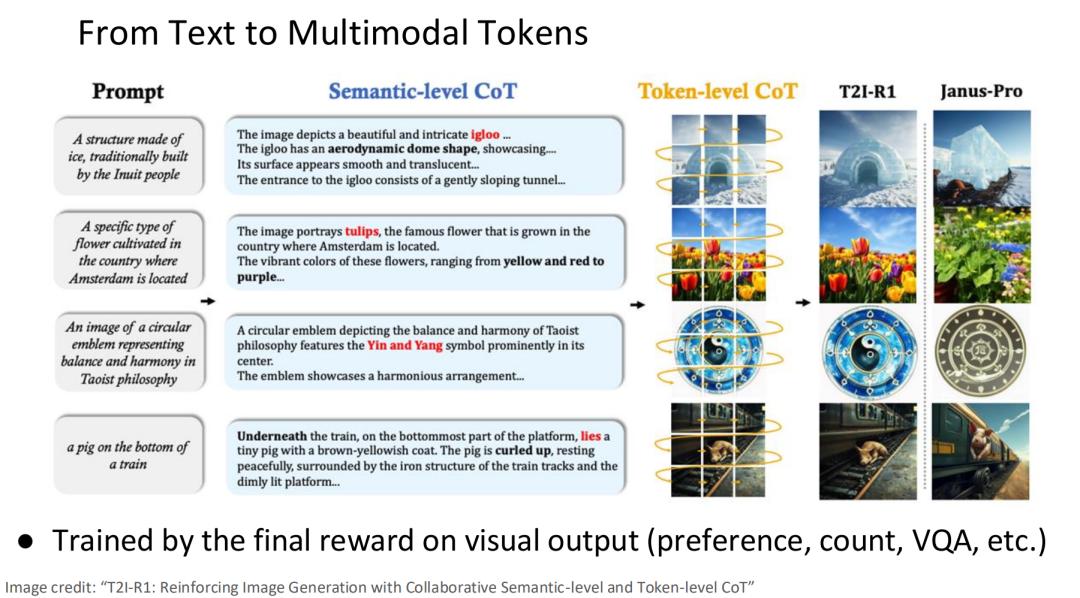
3.3 视觉生成:让模型“想象”视觉状态
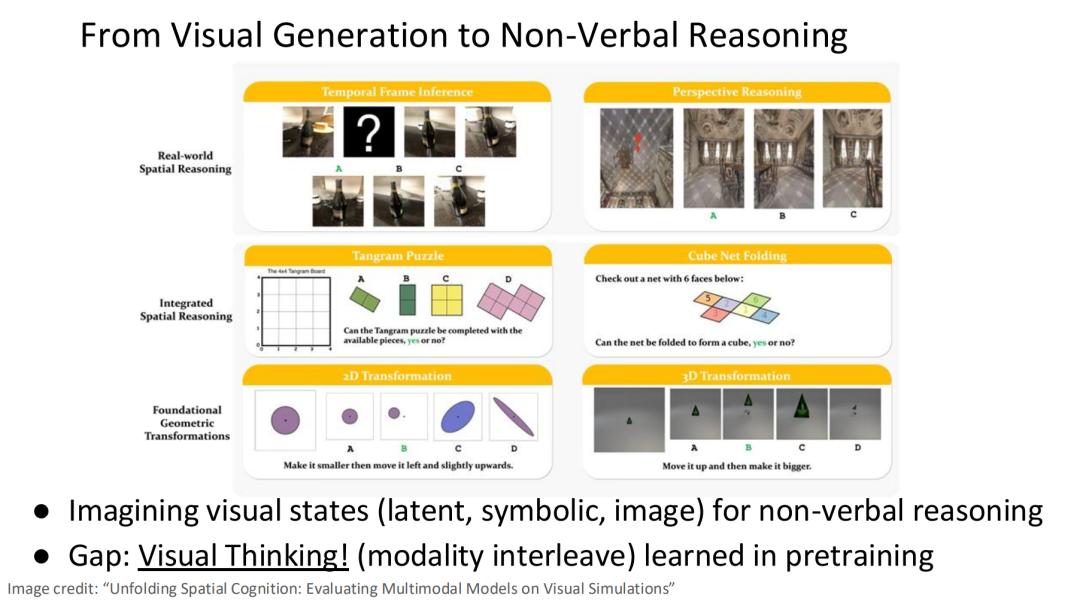
在部分任务中(如迷宫导航、FrozenLake环境决策),没有现成的视觉工具可调用——此时需模型“生成视觉内容”辅助推理。例如在迷宫任务中,模型会先生成“向左走→向上走”的动作序列,并同步想象每一步后的迷宫视觉状态,再基于“想象的视觉反馈”调整策略。
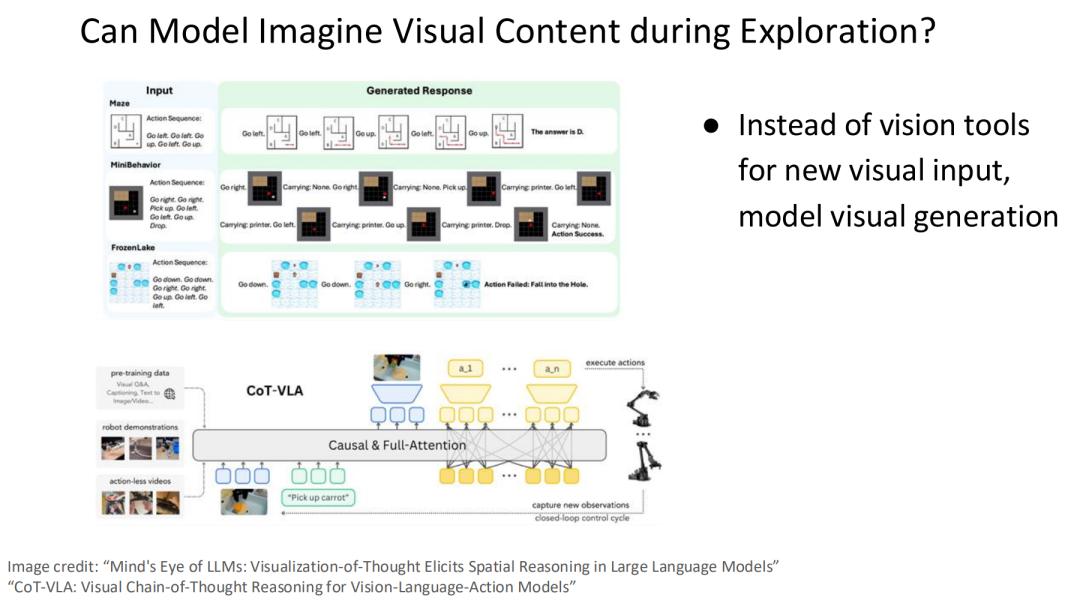
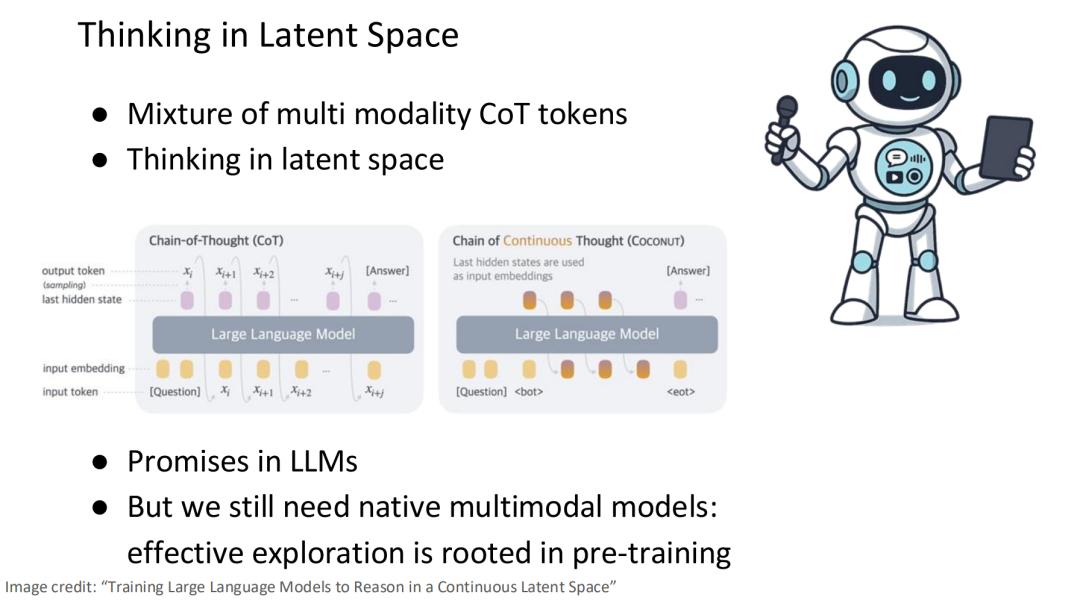
CoT-VLA(视觉-语言-动作思维链) 模型,正是通过“动作序列生成+视觉状态想象”,实现闭环控制。这种方式的核心是“将视觉生成融入推理链”,让模型在无外部视觉输入时,仍能基于任务逻辑构建视觉认知。
第四章 内化:让多模态模型“学会”视觉推理策略
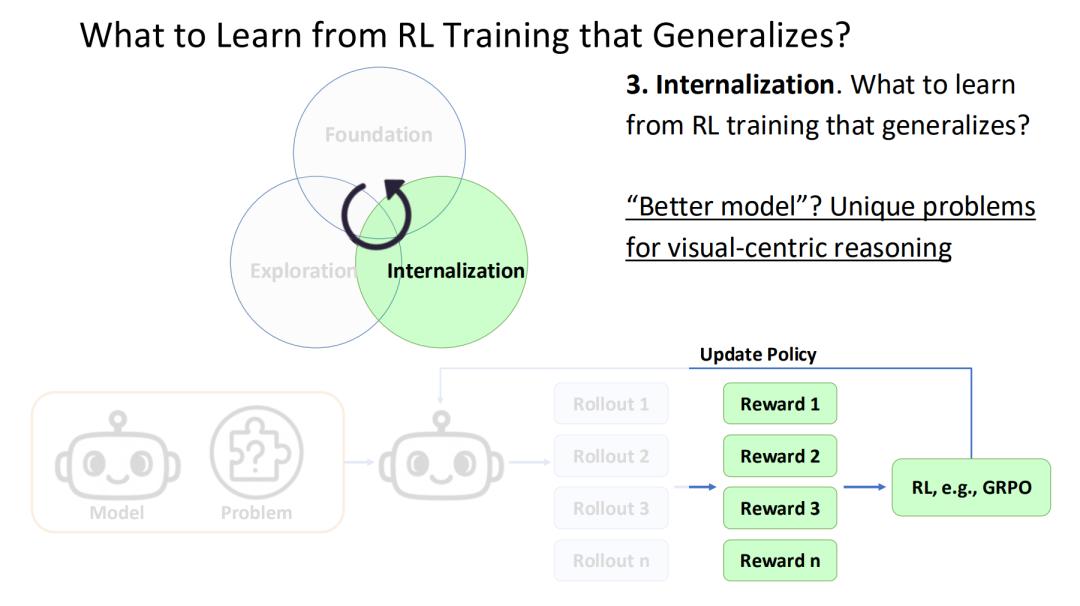
探索到有效推理路径后,需通过“内化”让模型将这些策略转化为默认能力。
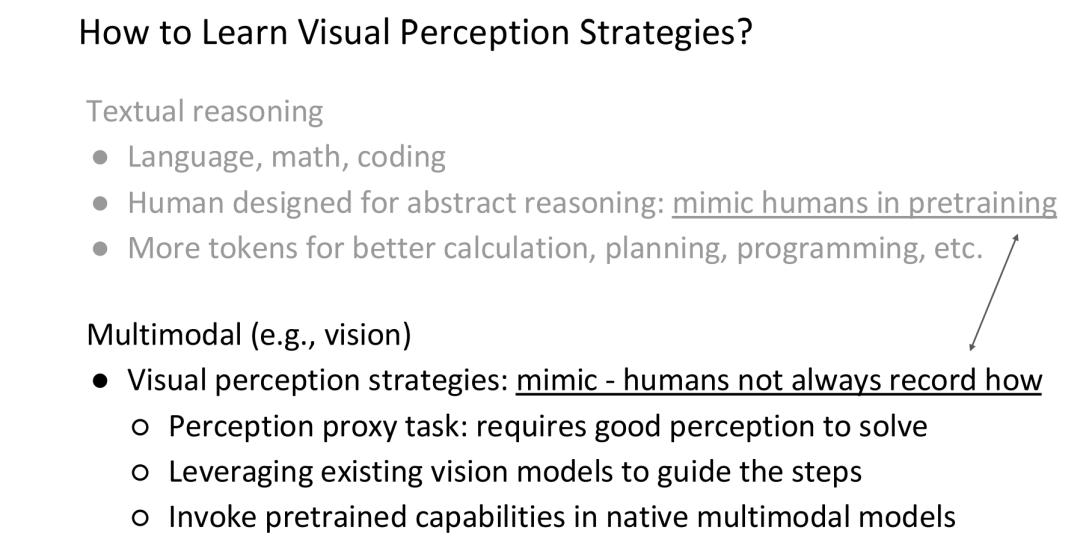
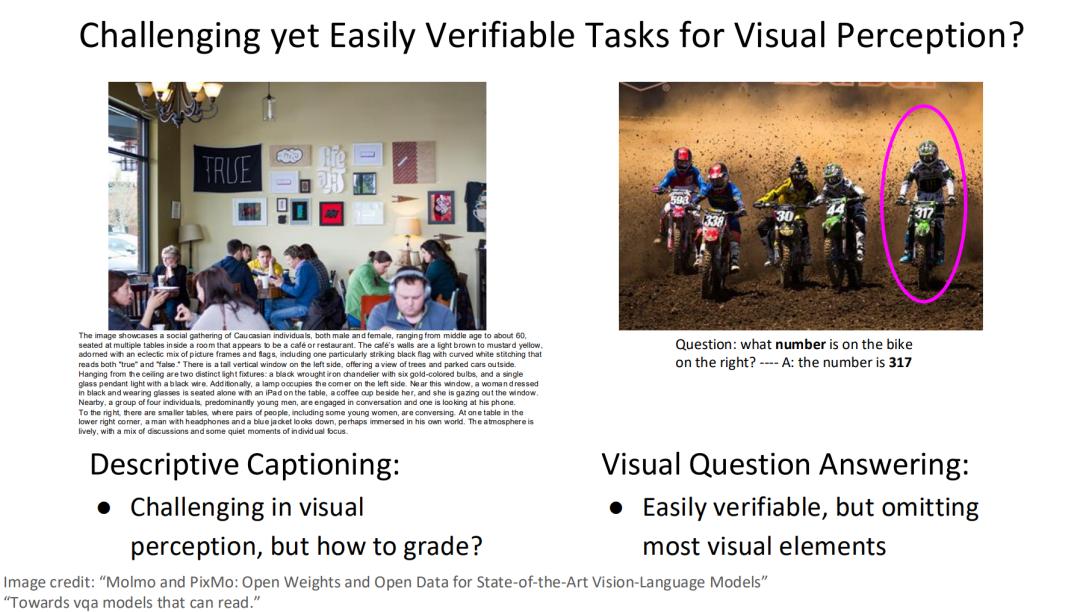
但多模态场景的内化面临特殊挑战:人类很少记录“如何通过视觉细节推理”(如“如何判断一个图形是平行四边形”),无法直接模仿文本推理的“人类标注路径”。对此报告提出两大解决方案:
4.1 ViCrit代理任务:用“幻觉验证”提升视觉感知
为让模型学会“准确感知视觉细节”,团队设计了ViCrit(视觉描述幻觉评判) 代理任务:给模型输入一张图片和一段“扰动后的视觉描述”(如将“6根鸡腿”写成“8根鸡腿”),让模型判断描述是否存在幻觉,并修正错误。该任务的优势在于:
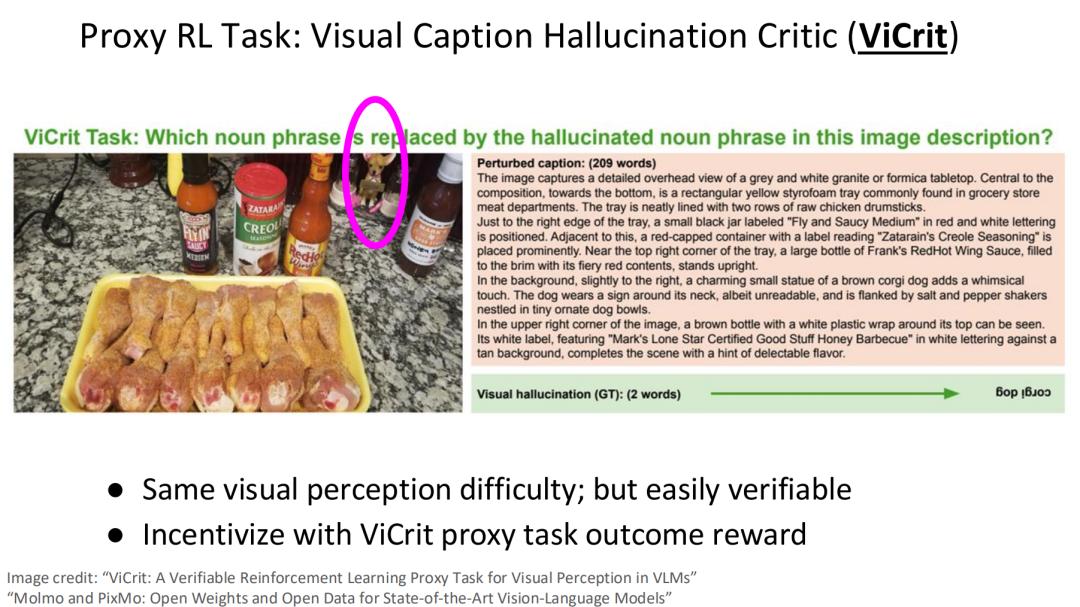
• 难度匹配:与真实视觉感知任务难度一致,需关注细节;
• 可验证性:幻觉判断有明确标准(如与图片真实内容对比),可提供客观奖励。
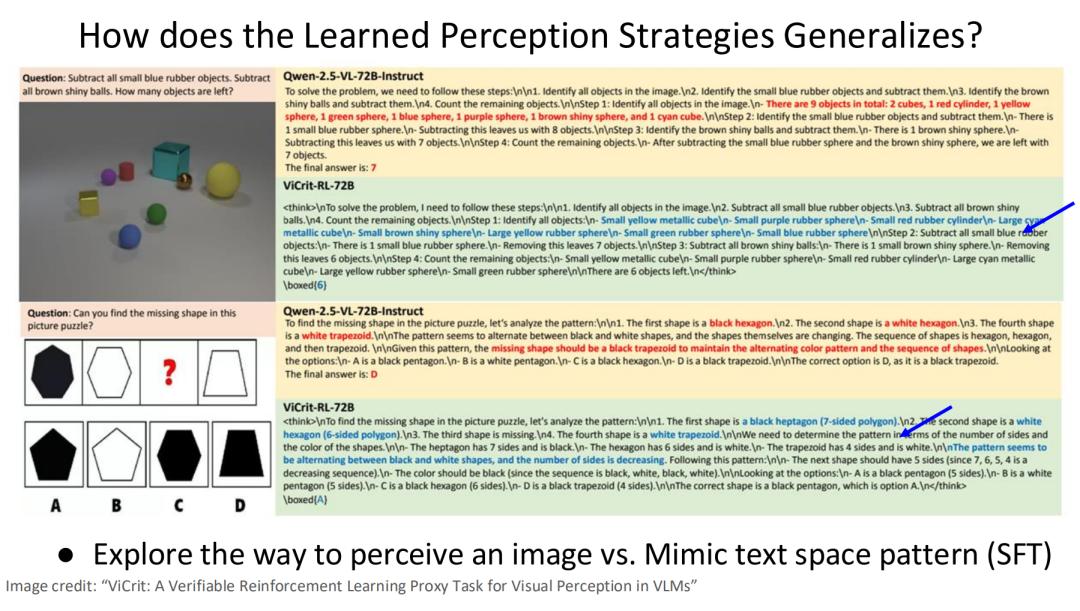
实验数据显示,经过ViCrit强化学习的72B模型(ViCrit-RL-72B),相比基础模型(Qwen2.5-VL-72B):
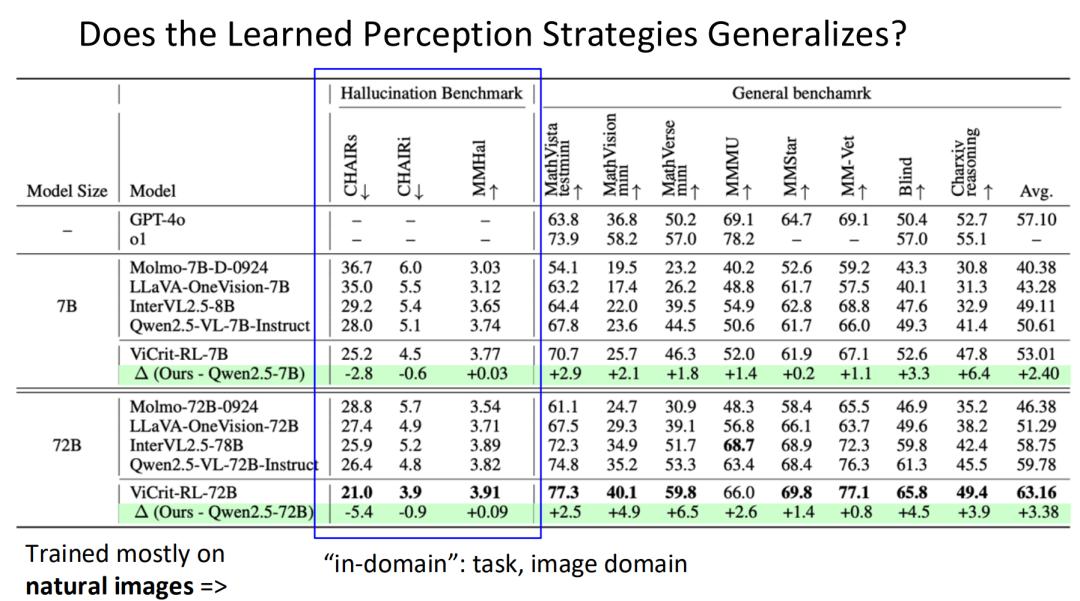
• 幻觉指标(H³)从26.4降至21.0;
• 通用基准测试平均性能提升3.38个百分点;
• 在“物体计数”“拼图推理”等任务中,能正确识别基础模型忽略的细节(如区分“橡胶球”与“金属球”)。
4.2 VisVM:用视觉价值模型指导推理
为进一步提升推理过程的“视觉准确性”,团队提出VisVM(视觉价值模型) ——基于CLIP模型训练,用于评估“当前视觉描述的未来价值”。例如在描述一张雨天图片时,VisVM会给“天空阴沉,地面有积水”的表述更高评分(因包含关键视觉细节),给“有一条街道”的泛泛描述低评分,从而引导模型在推理中聚焦有效视觉信息。
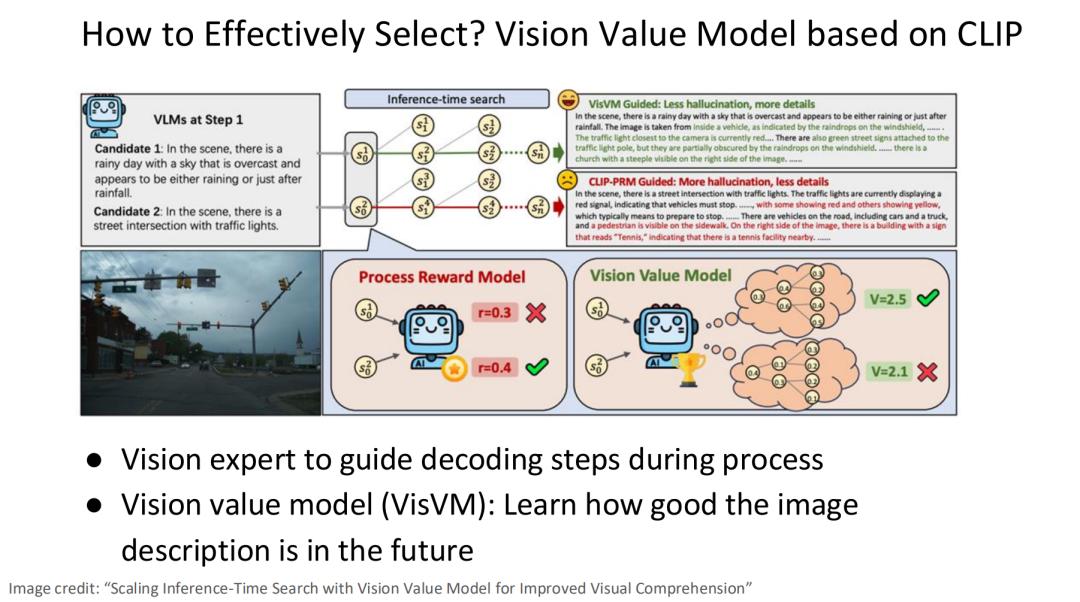
对比实验显示,VisVM指导的模型生成描述“幻觉更少、细节更全”,而基于文本奖励模型(如CLIP-PRM)的描述则易忽略关键视觉特征。
总结:从“文本推理”到“视觉推理”,多模态的下一站是什么?
报告提出的“基础-探索-内化”框架,本质是解决了多模态推理的核心矛盾——“视觉信息的细腻度”与“文本推理的逻辑性”如何协同。其核心创新可概括为三点:
1. 基础层:放弃“文本化视觉输出”,转向“原生多模态模型”,保留视觉细节;
2. 探索层:以“视觉为中心”,通过Point-RFT、视觉工具、视觉生成,让视觉信息深度参与推理;
3. 内化层:用ViCrit、VisVM等创新任务,解决“视觉推理策略无人类标注”的难题。
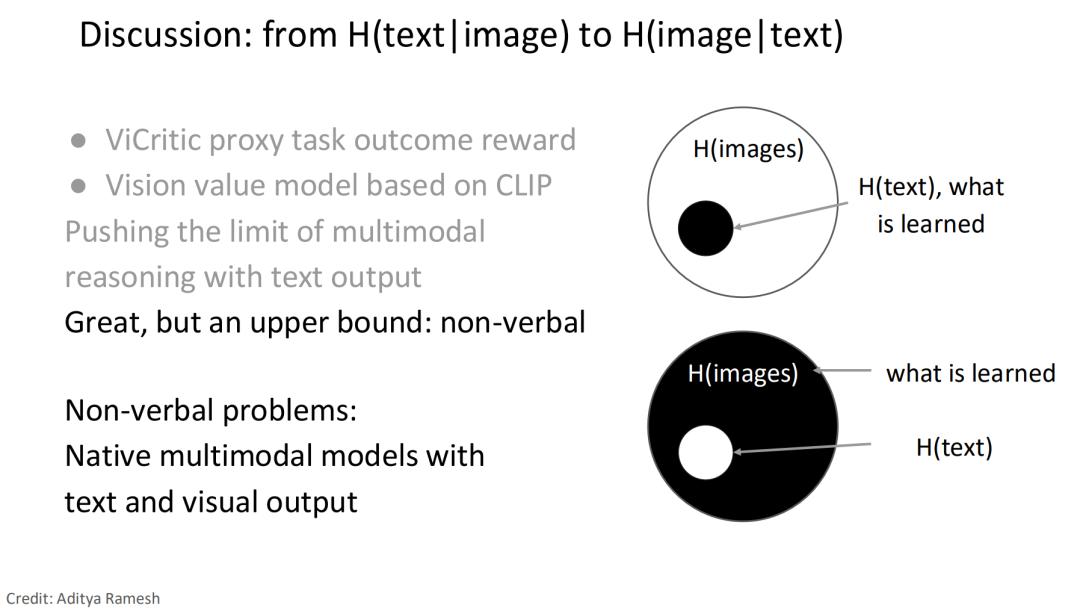
未来,多模态推理的突破方向将聚焦于“非语言推理”——例如让模型直接输出视觉答案(如补全拼图的图形),而非仅用文本描述;或在机器人控制、自动驾驶等场景中,实现“视觉感知-动作决策-文本解释”的三位一体。
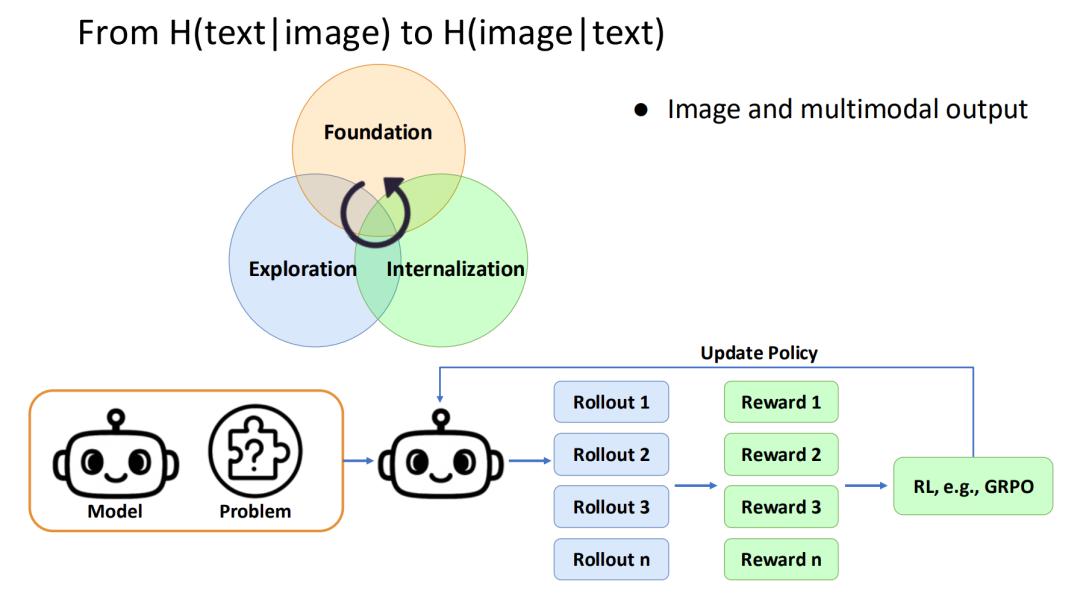
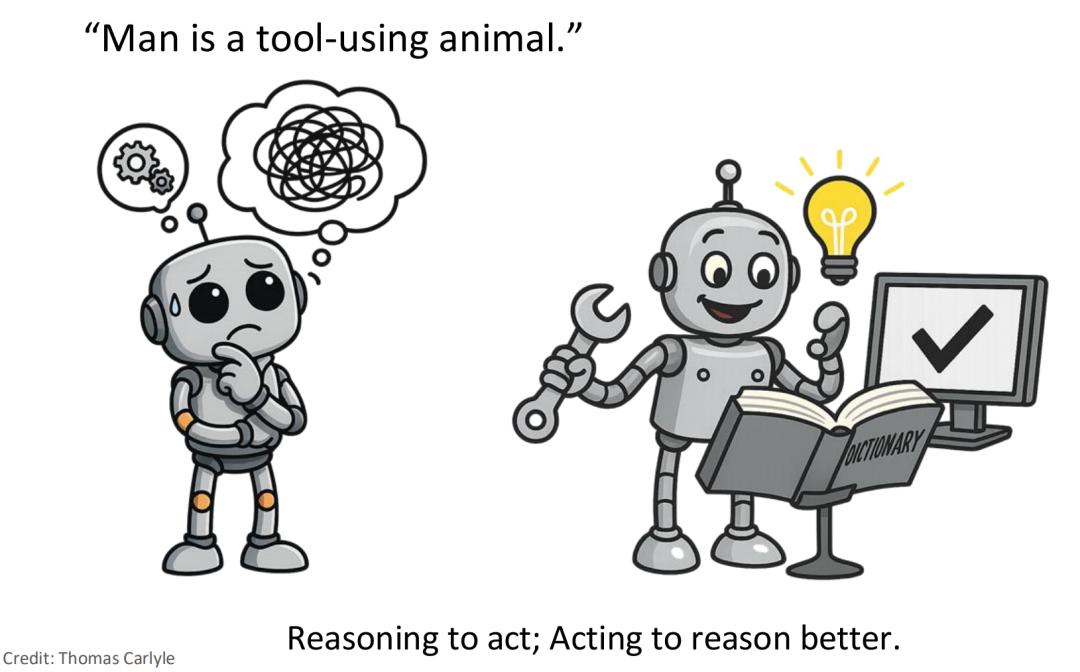
报告结尾引用的“人类是使用工具的动物”,多模态模型的进化,也将是“推理引导动作,动作反哺推理”的循环。
参考资料
• Multimodal Reasoning for Visual-Centric Long-Horizon Tasks,Zhengyuan Yang,Microsoft,https://vlp-tutorial.github.io/slides/tutorial/vision_foundation_models_2025/Zhengyuan.pdf