北交大&兰卡斯特大学智能体推理框架综述:讲透Agent三大能力层级
从微软的AutoGen到“AI程序员”Devin,基于大语言模型(LLM)的智能体(Agent)正以前所未有的速度重塑人工智能的边界。它们会分解任务、推演计划、调用工具、彼此协作——似乎把“机器推理”带入了一个新的时代。然而,在这股浪潮之下,一个核心的“双重模糊性”问题日益凸出:一个Agent的优秀表现,究竟是归因于背后更强的模型,还是来源于其“框架级”的设计?这种不确定性,使得对不同技术进行横向比较变得异常困难,也让我们容易忽视框架设计在Agent能力构建中的基石作用。
最近我在研究一篇最新Agent综述时,突然找到了答案。这篇名为《LLM-based Agentic Reasoning Frameworks: A Survey from Methods to Scenarios》的综述,由北交大、马普所、兰卡斯特大学、电子科大等机构的团队联合撰写,把当前让AI“自主解决复杂任务”的核心思路拆得明明白白。我们带你看懂这套让AI变“靠谱”的方法论,哪怕不懂编程,也能get到未来AI的进化方向。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
先搞懂一个关键概念:什么是“AI Agent”?
在讲框架前,得先澄清一个词:Agent(智能体)。很多人觉得这是技术黑话,其实特简单——你可以把它理解成“有自主能力的AI打工人”。
普通LLM比如ChatGPT,更像“一次性问答机器”:你问它“今天天气怎么样”,它答完就结束;但AI Agent不一样,它更像一个“能自己盯项目的实习生”——比如你让它“写一篇行业报告”,它会:
先想“需要哪些数据?要不要查最新行业报告?”(规划);
去调用数据工具(比如爬取行业数据库);
拿到数据后发现“有些数据过时了”,再回头补查(反思修正);
最后把数据整理成报告,还会检查“逻辑有没有漏”(迭代优化)。
简单说,LLM是“会说话的大脑”,而Agent是“能动手做事的完整角色”——它有目标、会规划、能调用工具,还能根据反馈调整动作。这篇论文的核心,就是拆解“怎么给LLM装一套‘做事框架’,让它变成靠谱的Agent”。
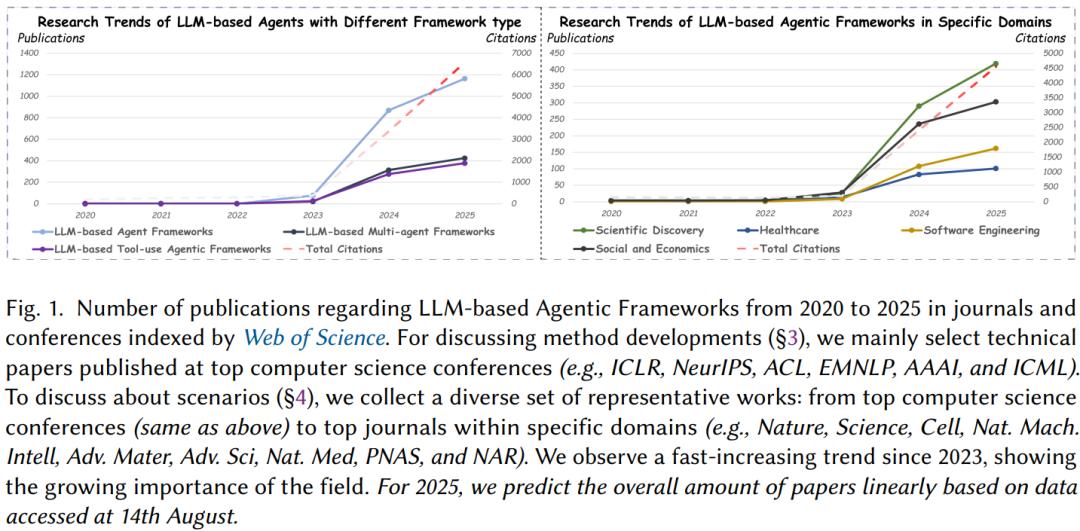
尽管社区中关于Agent的讨论非常活跃,但其工作往往呈现出碎片化、术语不一的局面。本综述的首要创新,便是引入了一套统一的形式化语言与通用推理算法,首次将各类“免训练”的框架级推理过程进行了数学化、结构化的描述。
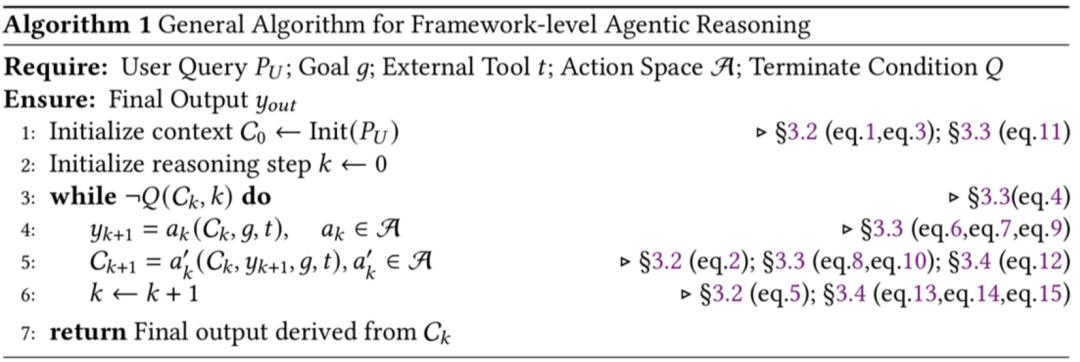
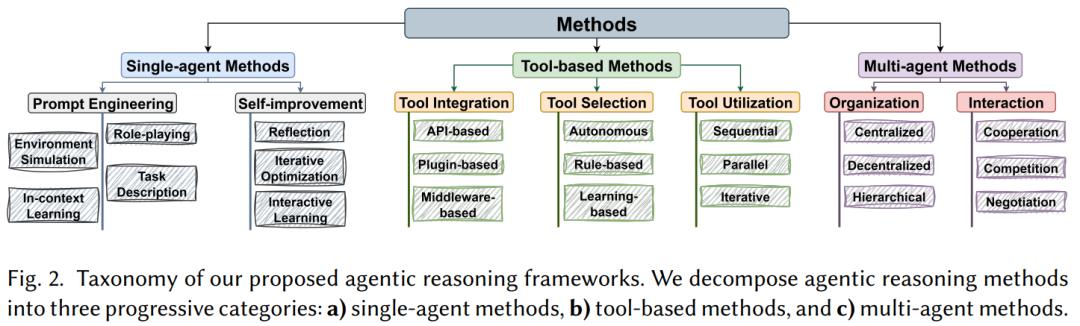
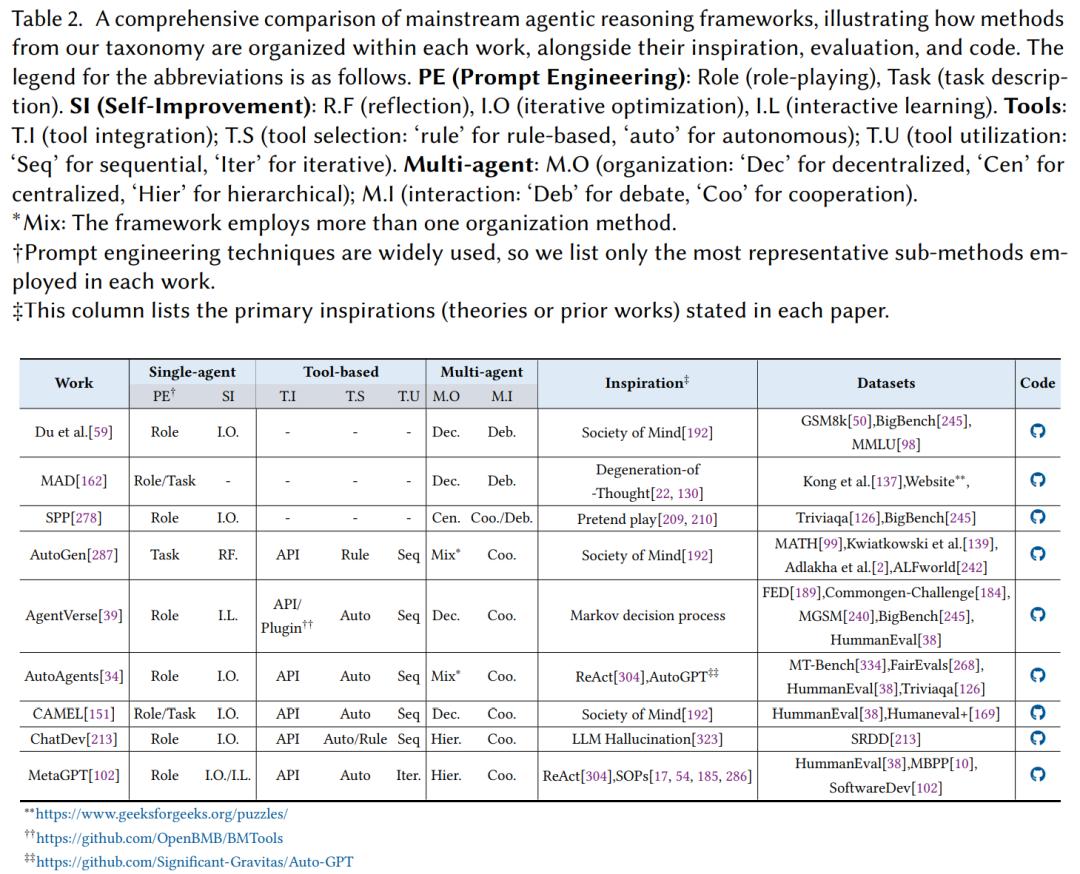
这套体系将Agent的行为抽象为推理、工具调用、反思等基本动作,使得原本五花八门的设计(如ReAct, AutoGen等)可以被映射到同一个流程中进行严谨的比较与复现,为整个领域从“经验化”走向“科学化”提供了理论基石。在统一的理论基础之上,综述进一步提出了一个清晰、递进的三层方法论分类体系,系统性地解构了现有Agent框架的设计范式。
AI Agent的“三大能力层级”:从单打独斗到团队协作
论文最让我惊艳的是,它把复杂的Agent框架分成了“三个递进层级”,就像人成长的三个阶段:从“自己做好一件事”,到“会用工具做事”,再到“能和别人协作做事”。每个层级都有清晰的方法论,我用生活场景一个个给你讲。
第一层:单Agent(自己做好一件事)——像“训练有素的厨师”
单Agent就是“一个AI独立完成任务”,核心是让它“想清楚、做明白”。就像一个厨师,不用别人帮忙,也能按步骤做出一道好菜。论文把这种能力分成两类:Prompt Engineering(提示工程) 和Self-Improvement(自我改进)。
1. Prompt Engineering:给AI“明确的角色和说明书”
你有没有发现,给AI加一句“你是资深产品经理,用结构化思维分析”,它的回答会靠谱很多?这就是Prompt Engineering的核心——给AI“定角色、给规则、举例子”,就像给厨师递上“米其林菜谱+角色定位”。
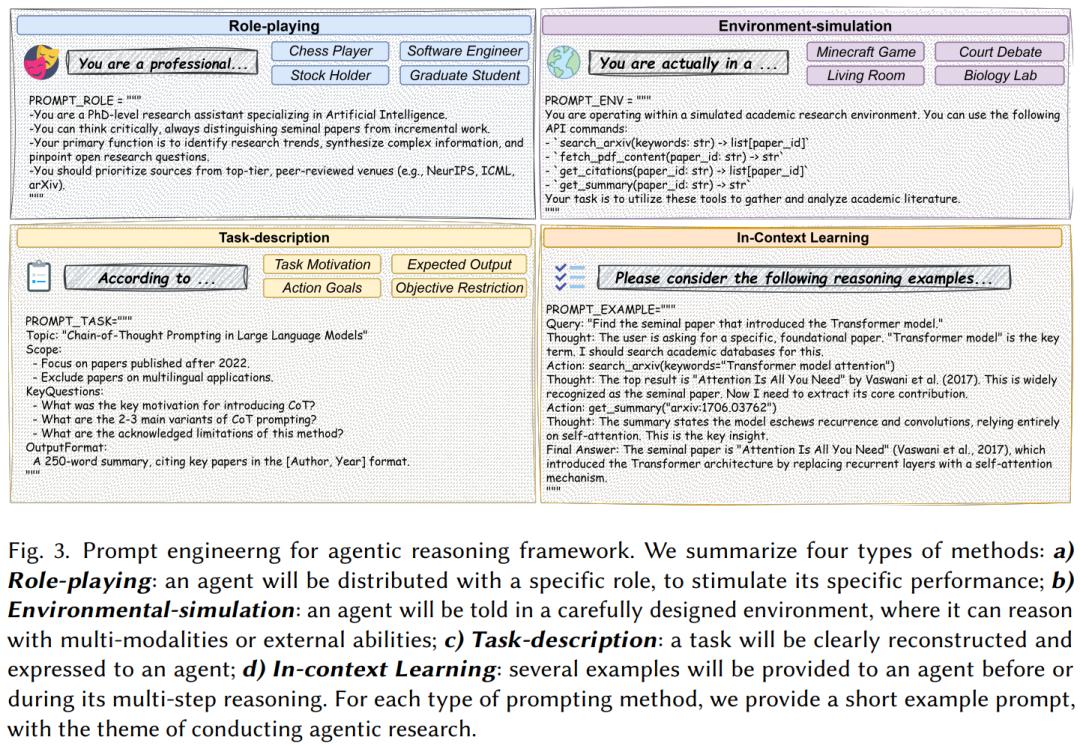
论文里提到四种常用方法,我用“做蛋糕”举例:
• 角色设定(Role-playing):“你是五星级甜品师,擅长做戚风蛋糕,要注意蛋白打发的程度”——给AI一个明确的“身份”,它会调动对应领域的知识(比如甜品师不会像川菜师傅一样放辣椒);
• 环境模拟(Environment Simulation):“现在你在家庭厨房,只有烤箱、手动打蛋器,没有商用工具”——告诉AI“做事的场景限制”,避免它给出“用工业搅拌机”这种不切实际的建议;
• 任务描述(Task Description):“目标是做6寸戚风蛋糕,需要分‘蛋黄糊制作-蛋白打发-烘烤-装饰’四步,最后要松软不塌陷”——把复杂任务拆成清晰步骤,就像给厨师列好“操作清单”;
• 示例学习(In-Context Learning):“上次做蛋糕时,蛋白打发到‘提起打蛋器有小尖角’就停,否则会消泡——这次按这个标准来”——给AI看“成功案例”,它不用重新学习,就能模仿正确做法。
我之前做过一个小测试:让AI写“用户调研问卷”,直接说“写一份问卷”,它只列了5个问题;但加上“你是UX研究员,按‘用户基本信息-使用场景-痛点反馈’三部分设计,参考这个示例(附2个问题模板)”,结果它写出了20个逻辑连贯的问题。这就是Prompt Engineering的魔力——不用改AI的“大脑”(模型参数),只需要给它“好的说明书”。
2. Self-Improvement:让AI“自己复盘、自己优化”
光有说明书还不够,厉害的Agent还能“做完事自己反省”,就像厨师做完菜会尝一口:“盐放多了,下次少放半勺”。论文里把这种能力分成三类:
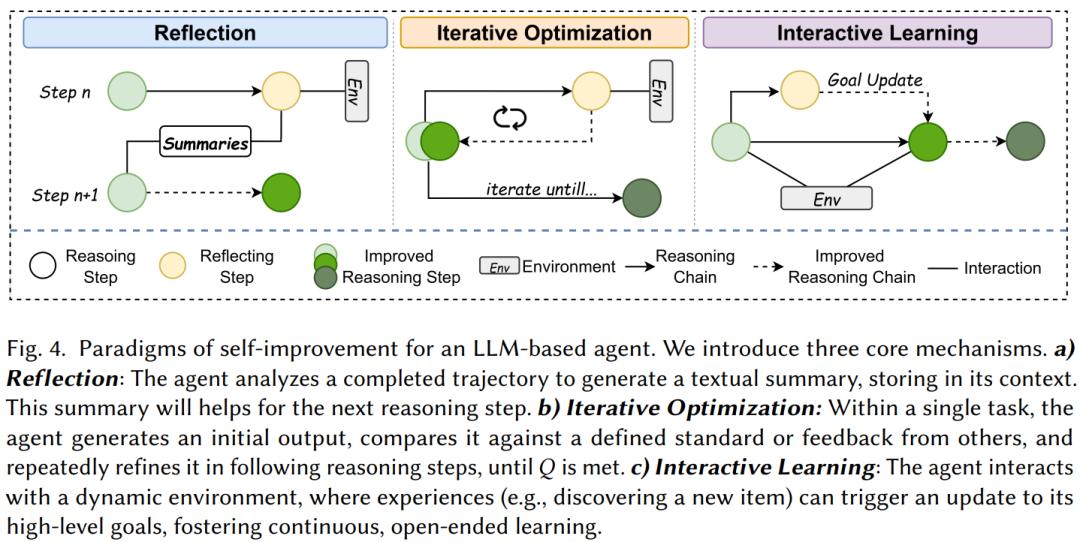
• Reflection(复盘):AI做完任务后,会总结“哪里错了”。比如AI写代码时出了bug,它会回头看“是循环逻辑错了,还是变量名写错了”,并记下来下次避免。就像学生考完试整理错题本,不是为了这次分数,而是为了下次不犯同样的错;
• Iterative Optimization(迭代优化):比如让AI写一篇演讲稿,它先写一版,然后按“逻辑是否通顺、有没有感染力”的标准反复修改,直到达标。这像设计师改方案——客户说“不够年轻化”,就调整用词和案例,改到客户满意;
• Interactive Learning(互动学习):这是最高级的,AI能根据环境变化调整目标。比如AI在游戏《我的世界》里,本来目标是“造房子”,但发现“没有木头”,就会先去“砍树”,甚至会“学新技能(比如合成斧头)”。就像你本来计划“今天在家办公”,但发现“网络断了”,就会临时改成“去咖啡馆办公”,还会提前查“咖啡馆地址”。
我团队之前试过用Reflexion(一个复盘型Agent框架)做数学题,发现它比普通LLM的正确率高30%——因为它会把“算错的步骤”用自然语言记下来,下次遇到类似题目,就会避开之前的坑。这说明:AI的“自我反省”能力,比单纯的“聪明”更重要。
第二层:工具型Agent(会用工具做事)——像“带了工具箱的维修师傅”
单Agent再厉害,也有“能力边界”——比如它不会算复杂的数学题(除非调用计算器),不会查实时天气(除非连网络)。工具型Agent就是给AI“配一套工具箱”,让它知道“什么时候用什么工具,怎么用好工具”。
论文把工具型Agent的能力拆成三步,像维修师傅修家电的流程:
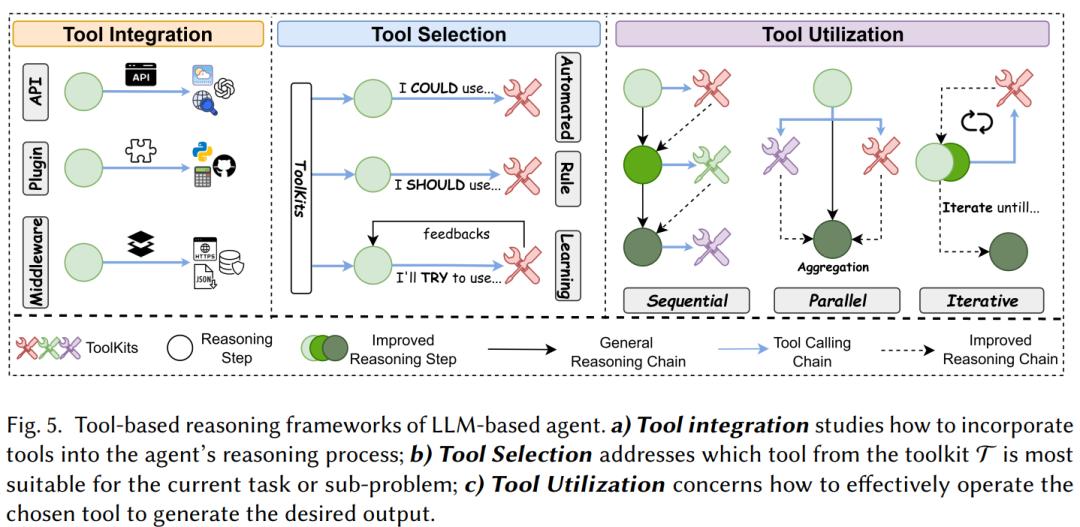
1. 工具集成(Tool Integration):给AI“装好用工具的接口”
维修师傅的工具箱里,螺丝刀要能拧螺丝、万用表要能测电流——AI的“工具集成”就是确保它能顺利调用工具。论文里提到三种方式,用“手机装APP”比喻最贴切:
• API集成:像手机装“外卖APP”,通过标准接口调用(比如AI通过百度地图API查路线),不用知道APP内部怎么运作;
• 插件集成:像手机装“相机插件”,直接嵌入系统(比如AI把“向量数据库”当插件,查资料时直接调用,不用跳转到其他软件);
• 中间件集成:像手机的“应用管理助手”,帮你统一管理APP的账号、更新——AI的中间件会处理“工具调用时的权限、数据格式转换”,比如AI同时调用“计算器”和“Excel”,中间件会把计算器的结果自动整理成Excel表格。
2. 工具选择(Tool Selection):让AI“选对工具”
维修师傅修空调,不会用螺丝刀去拆电路板——AI也需要知道“什么任务用什么工具”。论文里分了三种选择方式:
• 自主选择:像你出门旅行,凭经验选“用携程订酒店、用12306买火车票”,AI会根据任务描述自己判断(比如“算房贷”就调用计算器,“查新闻”就调用搜索引擎);
• 规则选择:像公司报销时“超过1000元走对公转账”,AI按预设规则选工具(比如“处理表格数据”就用Excel,“处理图片”就用PS插件);
• 学习选择:像你第一次用“大众点评”发现不好用,下次改用“美团”——AI会记住“上次用A工具没成功,这次试B工具”,比如调用A搜索引擎没找到资料,下次就换B搜索引擎。
3. 工具利用(Tool Utilization):让AI“用好工具”
选对工具还不够,还要会“怎么用”。比如同样用导航,有人会“先查路线再订酒店”(顺序用),有人会“同时查机票和酒店”(并行用),有人会“发现路线堵车后重新规划”(迭代用)——AI的工具利用也分这三种:
• Sequential(顺序用):像做咖啡“先磨豆-再煮咖啡-最后加奶”,工具按步骤调用(比如AI写报告“先调用数据工具查资料-再用写作工具写初稿-最后用校对工具改错别字”);
• Parallel(并行用):像你做饭“同时蒸米饭和炒青菜”,AI同时调用多个工具(比如“查天气”和“查景点开放时间”同时进行),节省时间;
• Iterative(迭代用):像你用导航“发现前方堵车,重新规划路线”,AI会反复调用同一个工具直到达标(比如用代码编译器,第一次报错就改代码,再运行,直到代码能跑通)。
第三层:多Agent(团队协作做事)——像“高效的餐厅后厨”
单Agent带工具,能解决不少问题,但遇到“需要多角色配合”的复杂任务(比如开发软件、做临床诊断),就像“一个人既要当厨师又要当服务员”,忙不过来。这时候就需要“多Agent协作”——多个AI分工合作,像餐厅后厨一样:主厨管炒菜,配菜师管切菜,服务员管传菜,效率翻倍。
论文把多Agent的协作拆成“组织架构”和“互动方式”,就像公司“怎么搭团队”和“怎么沟通协作”。
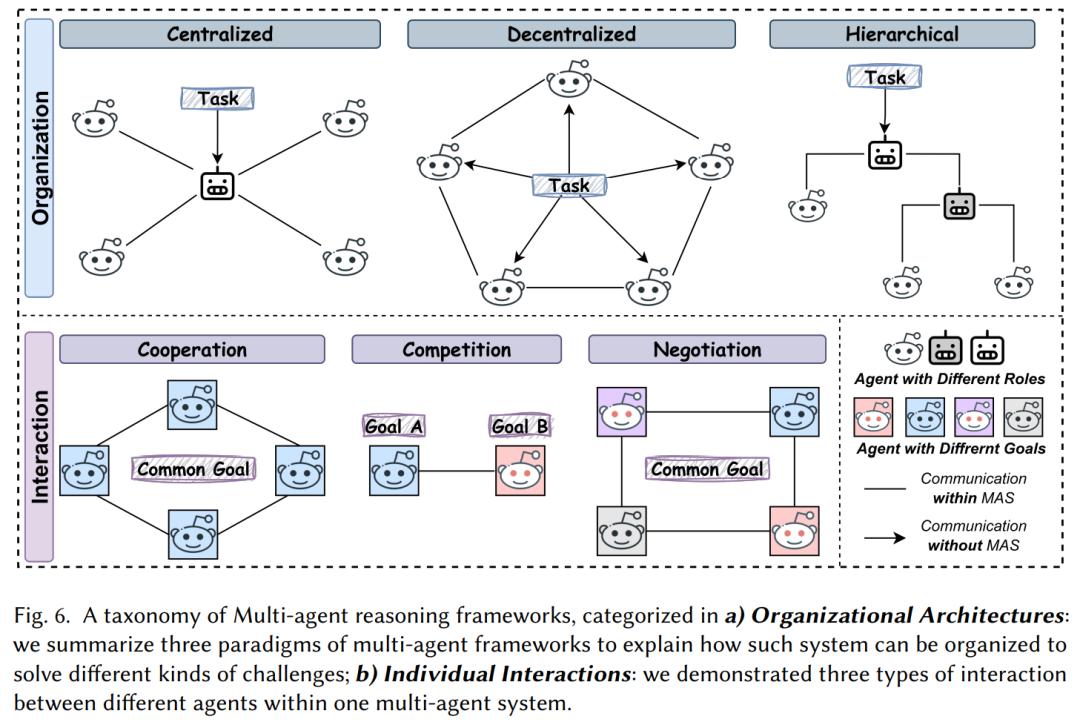
1. 组织架构(Organizational Architecture):“怎么搭团队”
不同任务需要不同的团队结构——比如小公司可能“老板直接管所有人”(集中式),创业团队可能“大家平等协作”(分布式),大公司可能“总部-分公司-部门”分层(层级式)。AI的多Agent架构也分这三种:
• Centralized(集中式):像公司“CEO管各个部门”,有一个“中央Agent”负责分配任务、汇总结果。比如AI做市场调研,中央Agent让“数据Agent查销量”、“用户Agent做访谈”,最后自己汇总成报告。优点是效率高,缺点是中央Agent出问题,整个团队就停了;
• Decentralized(分布式):像创业团队“没有老板,大家平等讨论”,每个Agent都能和其他人沟通。比如AI做辩论赛,每个Agent扮演“辩手”,各自查资料、反驳对方,最后得出结论。优点是灵活,一个Agent出问题不影响整体;
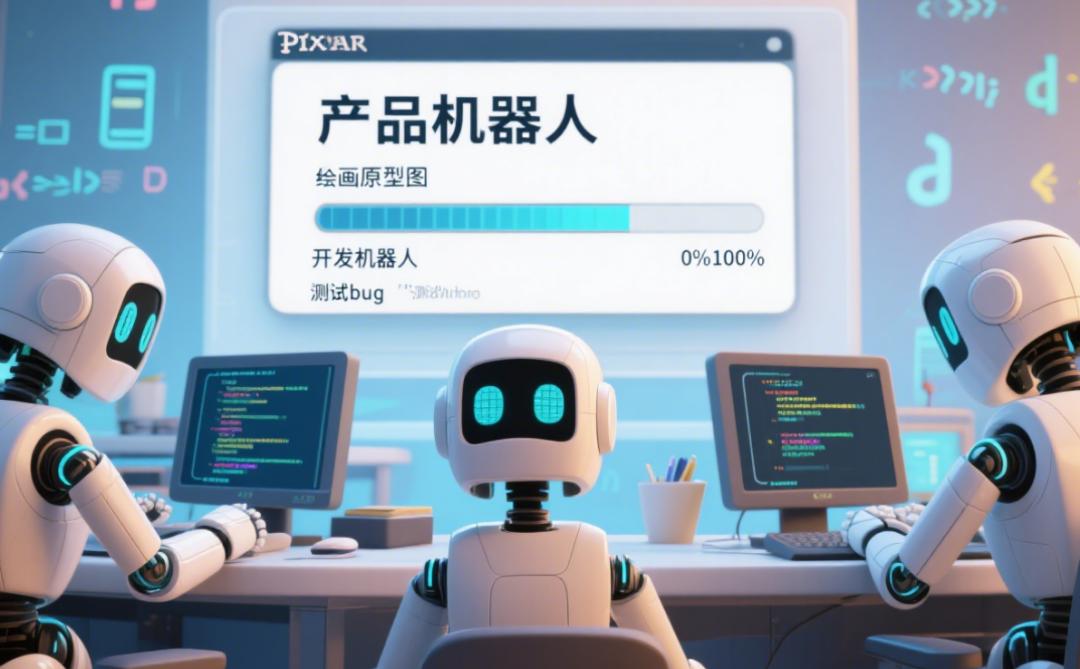
• Hierarchical(层级式):像公司“总部-分公司-门店”,Agent分等级。比如AI开发软件,“产品Agent”定需求,分给“开发Agent”写代码,再分给“测试Agent”找bug,最后“产品Agent”验收。优点是分工明确,适合复杂任务。
2. 互动方式(Individual Interaction):“怎么沟通协作”
团队搭好后,还要知道“怎么配合”——比如有的任务需要“一起出力”(合作),有的需要“互相竞争找问题”(竞争),有的需要“协商出方案”(谈判)。AI的互动方式也分这三种:
• Cooperation(合作):像团队做项目“大家分工,一起完成目标”。比如AI做临床诊断,“内科Agent”分析症状,“影像Agent”看CT片,“药剂Agent”推荐药物,最后一起给出诊断结果;
• Competition(竞争):像辩论赛“双方互相反驳,找出对方漏洞”。比如AI写报告,两个Agent分别写版本A和版本B,然后互相挑错,最后整合出更完善的版本;
• Negotiation(谈判):像商务谈判“双方妥协,达成共识”。比如AI规划会议时间,“参会人A的Agent”说“上午没空”,“参会人B的Agent”说“下午没空”,最后协商出“中午1小时”的方案。
应用场景:深入四大前沿场景,绘制理论落地的实践蓝图
看论文时,最让我感慨的是——这些框架不是“纸上谈兵”,已经在多个关键领域落地,解决了实际问题。
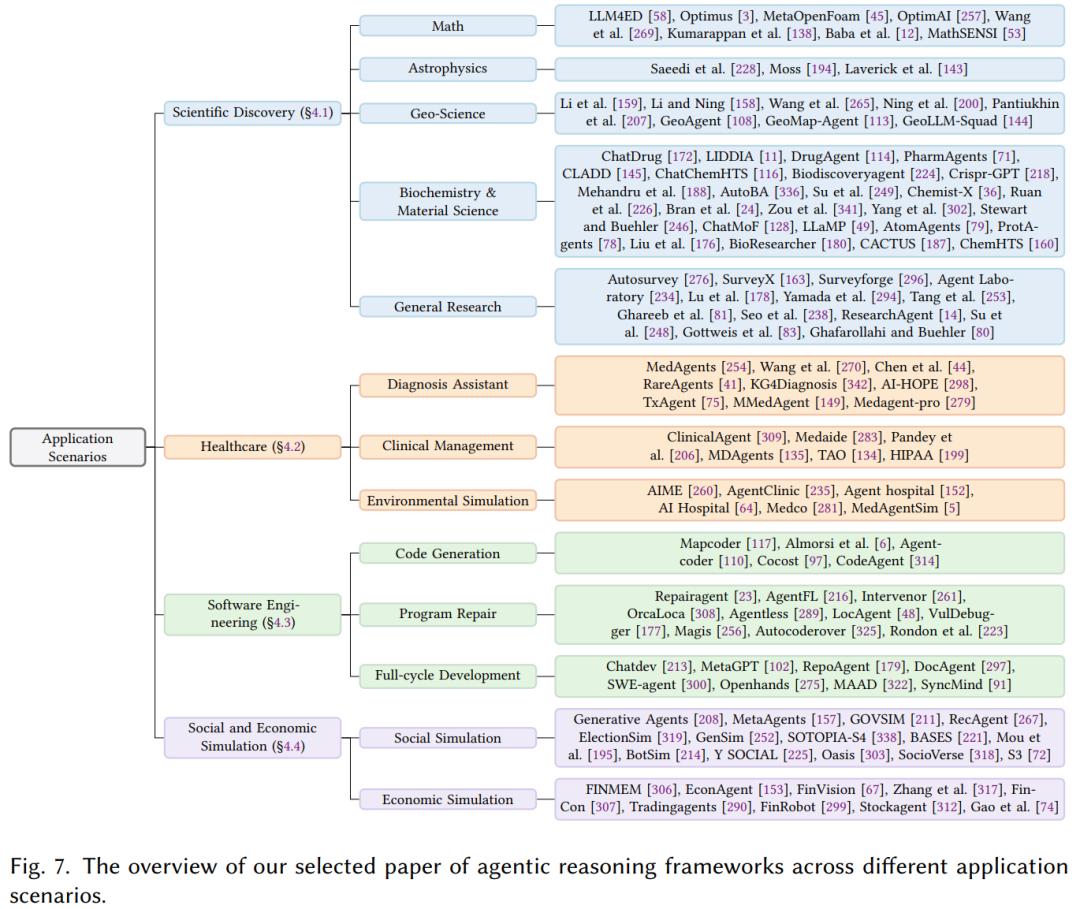
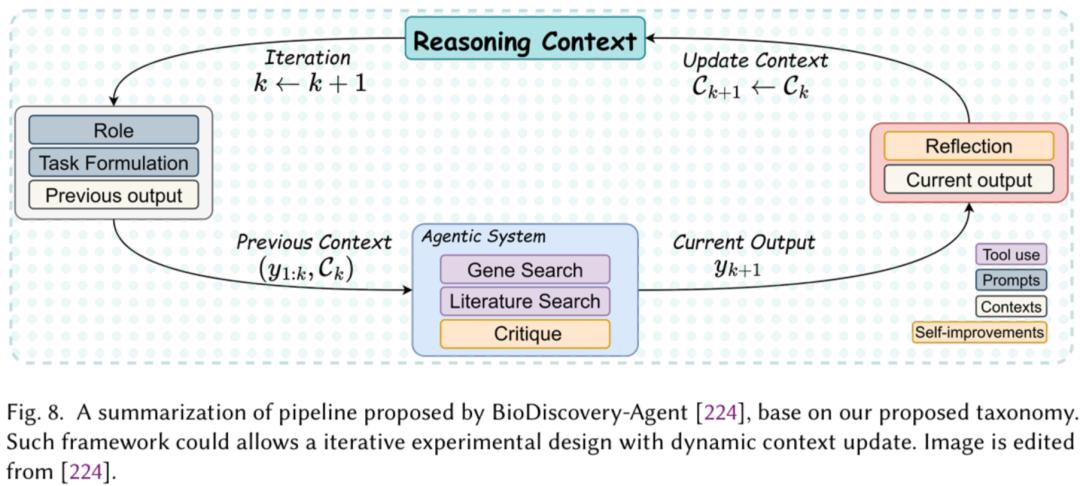
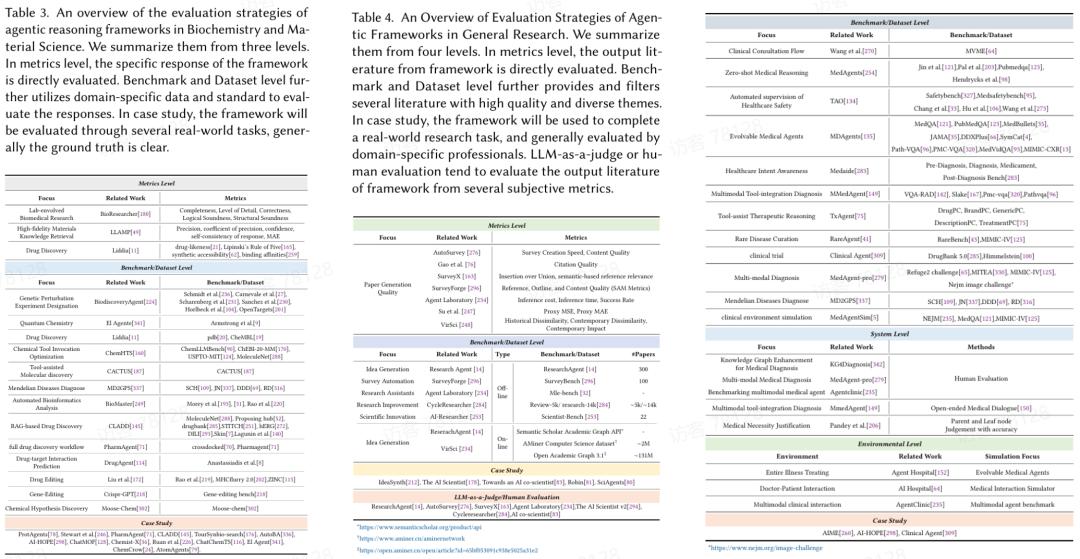
1. 科学发现:Agent正成为“AI科学家”的雏形。综述不仅涵盖了在数学领域进行自动化定理证明(如LeanAgent),在天体物理学中进行宇宙学参数分析,更深入到了生物化学领域,剖析了如BioDiscovery-Agent如何通过迭代式学习自主设计基因扰动实验,以及PharmAgents等多智能体系统如何模拟完整的药物研发管线。
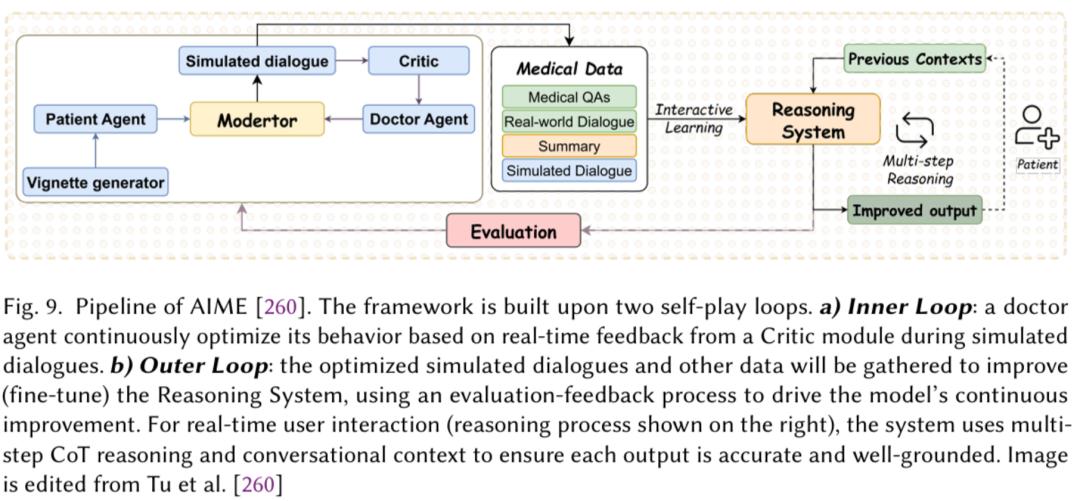
2. 医疗健康:Agent正在从辅助诊断走向临床管理的全流程。文章详细梳理了从MedAgents这类通过多专家“会诊”进行零样本推理的诊断助手,到Agent Hospital这样能够让Agent在模拟医院中自主“行医”并从成功与失败案例中不断进化的前沿探索。
3. 软件工程:Agent的目标是实现软件开发全生命周期的自动化。综述介绍了如MetaGPT这样模拟人类软件公司标准作业流程(SOPs)进行团队协作的框架,以及SWE-Agent这类开创性的工作,它通过构建“人-机接口”(ACI),让Agent能像人类一样直接在代码仓库中进行文件编辑、执行测试等操作。
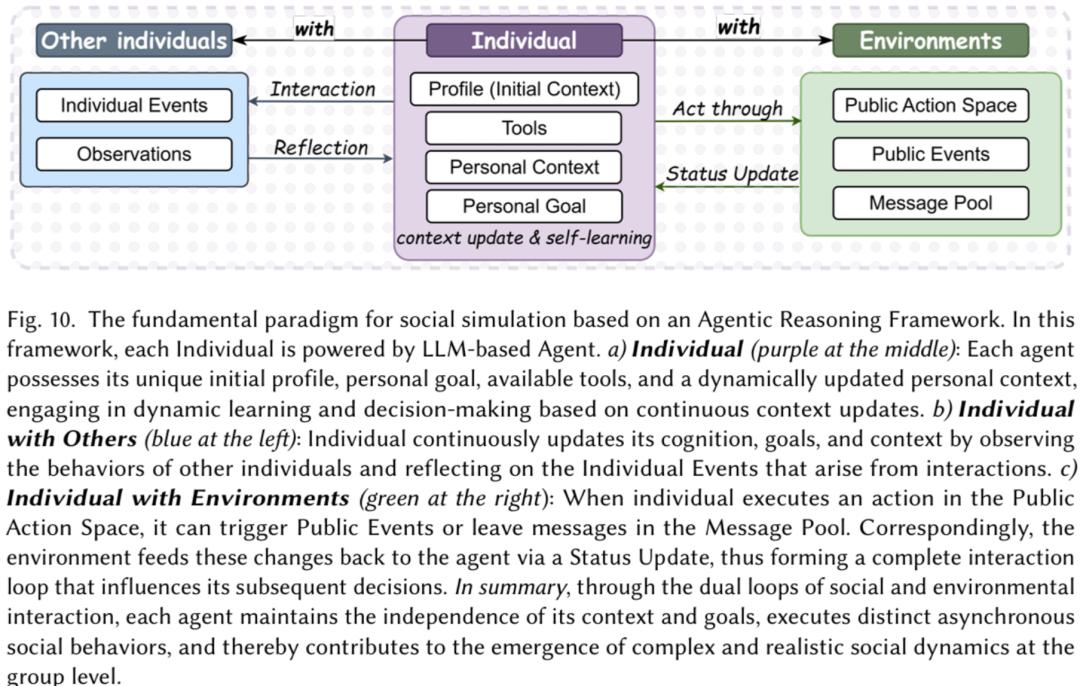
4. 社会与经济模拟:Agent为我们观察复杂的社会经济现象提供了前所未有的“沙盒”。从Generative Agents在虚拟小镇中模拟人类的日常行为,到StockAgent这类大规模系统在模拟环境中复现真实的股票市场撮合机制,再到SocioVerse这样基于千万级真实用户数据构建的“世界模型”,Agent正在成为社会科学研究的强大新工具。
在每个场景下,综述都系统性地归纳了其主流的架构模板、技术侧重点,并详尽地收集和整理了该领域下的主流评测方法、基准(Benchmark)和数据集,为后来者提供了极其宝贵的实践指南。
未来还得跨过去的几道“坎”
虽然Agent框架已经很厉害,但论文也没回避问题——目前还有几个关键挑战没解决:
效率问题:多Agent协作时,像“太多人开会”,沟通成本高。比如10个Agent一起做任务,互相传递信息的时间可能比做事还长;
自主性不足:现在的Agent还需要“人给目标”,比如“帮我写报告”,但不能自己“发现问题”(比如“用户现在需要一份Q3报告,但还没提”);
安全性风险:Agent调用工具时可能“被攻击”,比如调用外部API时,数据被泄露;或者Agent“被误导”,比如有人故意给假信息,让它做出错误决策;
解释性差:有时候Agent做出了正确决策,但没人知道“它为什么这么选”——比如AI诊断疾病时,说“患者得了A病”,但说不出“是哪个Agent的哪个分析起了关键作用”,这在医疗等关键领域很危险。
总结:AI从“问答工具”到“得力助手”的关键一步
看完这篇论文,我最大的感受是:LLM的“聪明”(模型能力)只是基础,而Agent框架的“靠谱”(做事能力)才是让AI走进真实场景的关键。就像一个人,光有知识还不够,还需要“做事的方法”和“协作的能力”。
未来,我们用到的AI,可能不再是“你问我答”的ChatGPT,而是“你说目标,它搞定一切”的Agent——比如你说“帮我组织一场家庭旅行”,AI会调动“机票Agent”订机票、“酒店Agent”找住宿、“攻略Agent”做行程,甚至“签证Agent”提醒材料。
最后想问问你:如果这种AI Agent真的普及了,你最想让它帮你解决生活里的哪个复杂任务?是搞定工作中的项目管理,还是规划一场长途旅行?欢迎在评论区聊聊你的想法。
参考资料
标题:LLM-based Agentic Reasoning Frameworks: A Survey from Methods to Scenarios
作者:Bingxi Zhao, Lin Geng Foo, Ping Hu, Christian Theobalt, Hossein Rahmani, Jun Liu
单位:北京交通大学,兰卡斯特大学,马克斯·普朗克信息研究所,电子科技大学
链接:https://arxiv.org/pdf/2508.17692