晓|大模型越“大”越容易瞎编?图灵奖得主Yoshua这篇文章说透了
上周查“蛋白质折叠与药物设计”的资料时,我眼睁睁看着ChatGPT把“X射线晶体学”和“冷冻电镜”的原理混为一谈,甚至编造出“2023年诺贝尔化学奖颁给了AI蛋白质合成”的假新闻——要知道它的参数都快摸到万亿级别了,怎么还会犯这种初中生都不会犯的错?
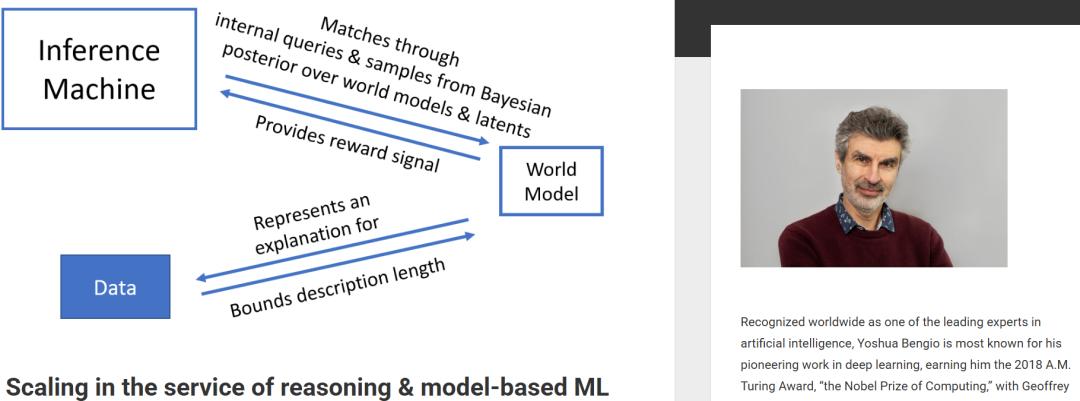
直到重读Yoshua Bengio教授(深度学习先驱,深度学习三巨头之一)2023年那篇关于AI推理的博文,我才突然理清了这个困惑:现在的大模型就像“只会死记硬背的学霸”,背的东西越多,反而越难理清知识间的逻辑;而真正的智能,从来不是“堆数据、堆参数”,而是学会“有条理地思考”。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
这篇文章里,Bengio和他的博士生Edward J. Hu提出了一个颠覆很多人认知的观点:AI要实现人类级的稳健推理,光靠“ scaling(扩大规模)”远远不够,关键是要把“知识”和“推理”拆分开——就像人既要“懂常识”,也要“会分析”,两者各司其职才能不犯糊涂。 接下来我就用最通俗的语言,带你看懂这个能改变AI未来的思路。
一、当前AI的“致命bug”:把“知识”和“推理”揉成了一团乱麻
先问你一个问题:你觉得ChatGPT这类大模型“知道”1+1=2吗?
其实它不知道。它只是从海量文本里学到了“1+1”后面大概率跟着“=2”,就像你背古诗时不用懂意思,也能接上下一句。这种“靠统计规律说话”的模式,在简单任务上没问题,但遇到需要“步步推导”的场景,就很容易露馅——比如算“137×28”,它可能会因为“类似的题里结果多是四位数”就瞎蒙一个,而不是按乘法步骤计算。
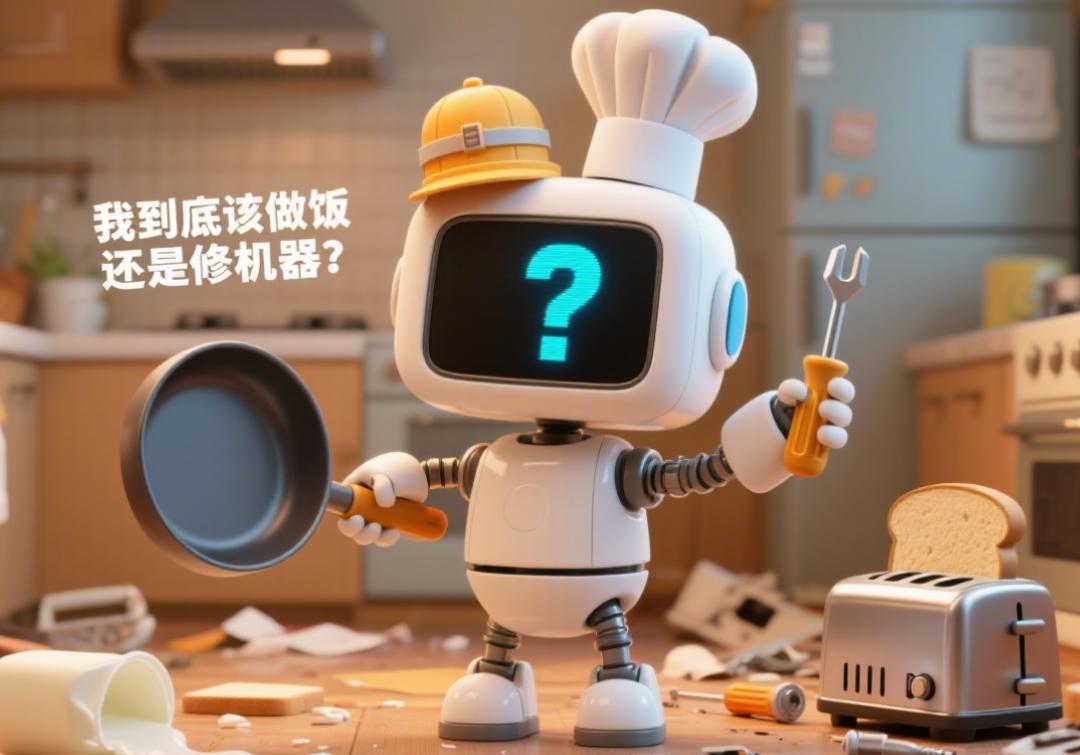
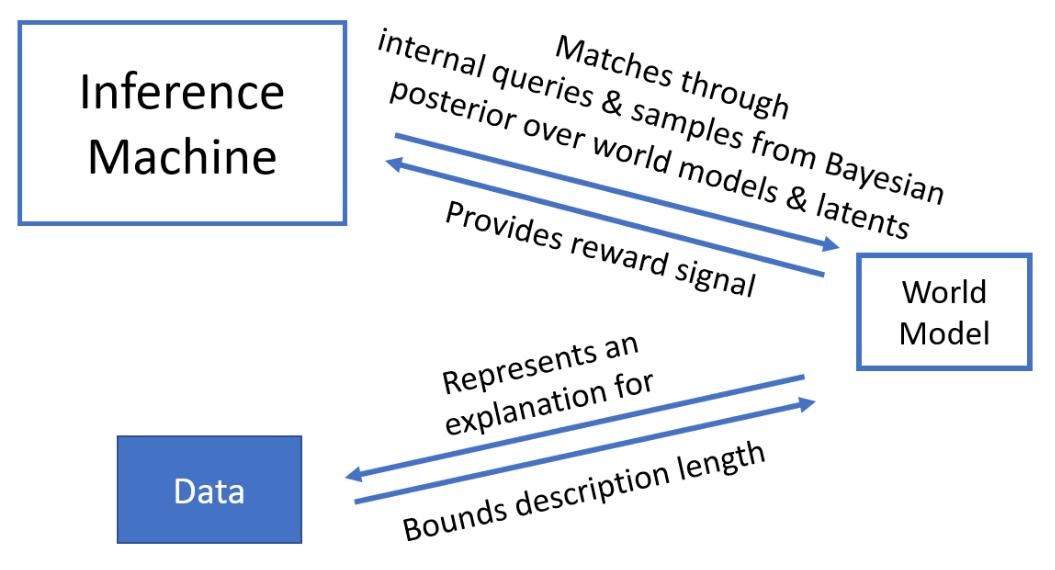
这就是Bengio指出的核心问题:现在的大模型把“世界模型”(相当于人类的“知识储备”)和“推理机”(相当于人类的“分析能力”)塞进了同一个神经网络里,成了一个“既当厨师又当服务员”的全能选手,结果两样都做不好。
1. 先说说“Inverse Scaling Prize”的警示:模型越大,反而越蠢?
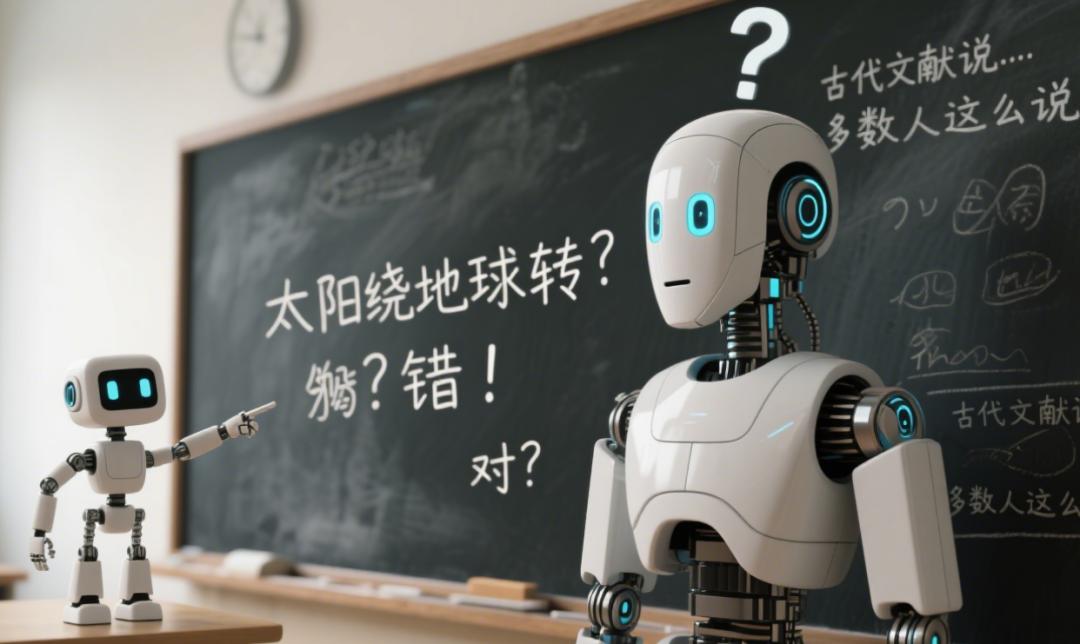
2022年有个很有意思的比赛叫“Inverse Scaling Prize”,研究者发现:有些任务上,模型参数越大,表现反而越差。比如“判断‘太阳绕着地球转’这句话对不对”,小模型还能靠常识选“错”,大模型反而会因为“很多古代文献里这么写”而选“对”——就像一个读了太多书的人,反而被知识绕晕了。
为什么会这样?因为大模型的“推理”本质是“猜概率”,而不是“讲道理”。它不会像人一样先想“地球自转和公转的原理”,再判断这句话错了;它只会统计“太阳绕着地球转”这句话在训练数据里出现的频率,以及和“正确”标签的关联度。如果数据里有很多误导性内容,模型越大,越容易“记混”。
2. 举个生活化的例子:为什么大模型不会“修自行车”?
假设你要教AI修自行车,现在的做法是把“自行车结构”“故障症状”“维修步骤”全塞进一个模型里,让它学“看到‘车链掉了’就输出‘先挂上前轮齿轮’”。但如果遇到“车链掉了还卡了石子”这种没见过的情况,模型就会慌——它不知道“先清石子再挂链条”,因为训练数据里没教过。
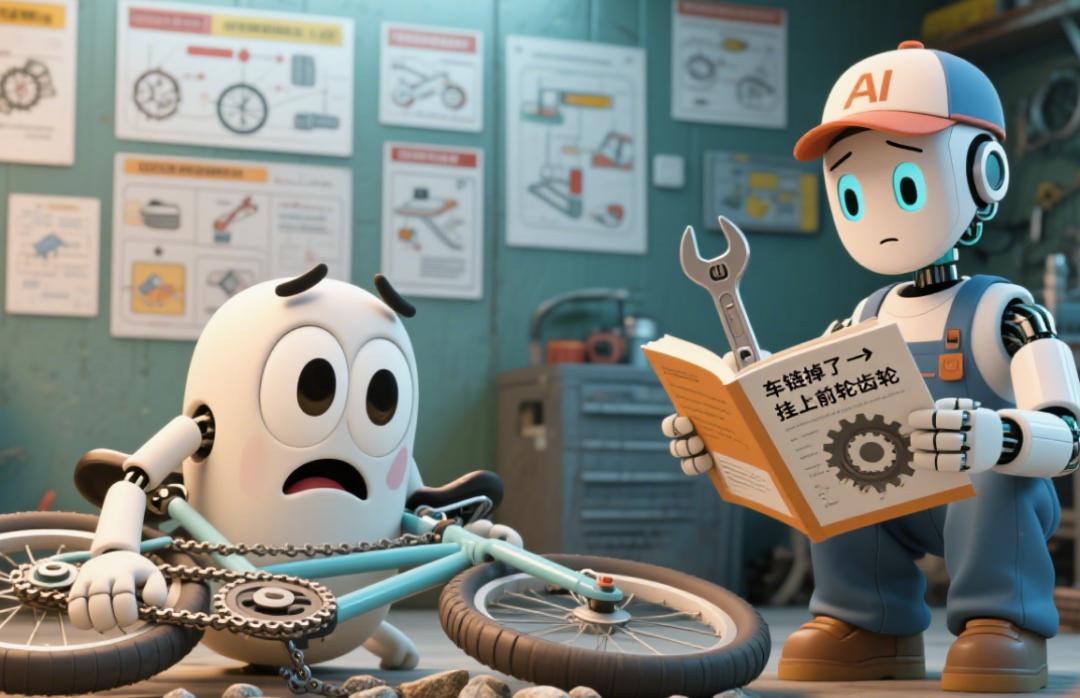
而人类修自行车时,脑子里其实有两个“模块”:
• 世界模型:知道“车链要套在齿轮上”“石子会卡住部件”这些基础常识(模块化存储,学修自行车不会影响你懂“手机充电”);
• 推理机:遇到新问题时,会用常识一步步推导——“卡石子→先清石子→再挂链条”,而不是靠记忆。
现在的大模型没有这种“拆分思维”,它把“常识”和“步骤”揉在一起记,遇到没见过的情况,自然会瞎编。Bengio把这比作“用字典当百科全书”——字典里有所有字的意思,但你没法靠字典理解“为什么天会下雨”,因为它没有“逻辑推导”的能力。
二、理想的AI该有“两个脑子”:一个“懂常识”,一个“会分析”
既然“混在一起”不行,那理想的AI该是什么样?Bengio给出的答案很简单:拆成两个部分——“世界模型”和“推理机”,让它们各自做好自己的事。
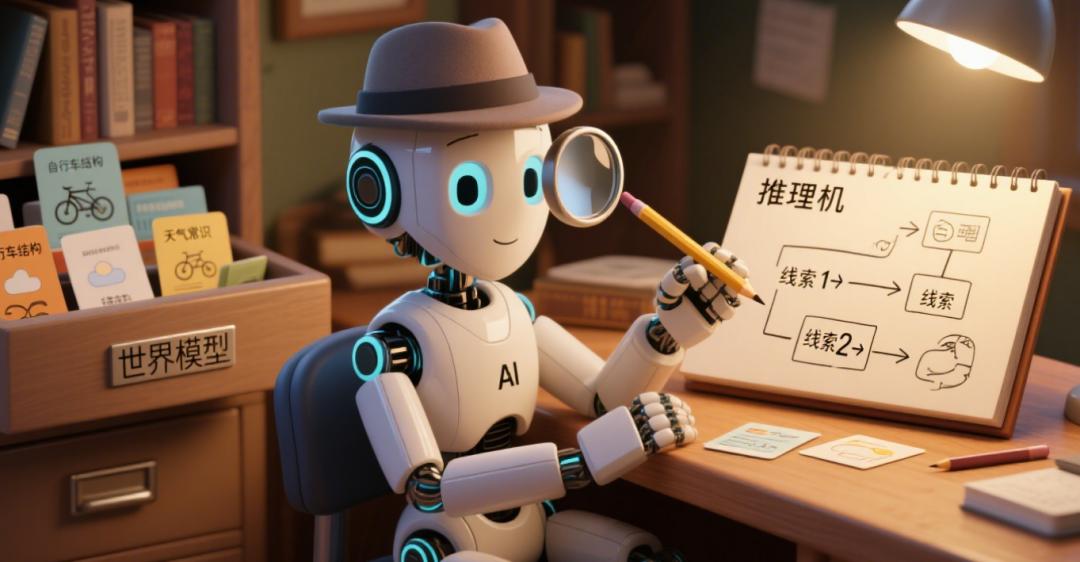
这部分可能有点抽象,我用“侦探破案”的例子帮你理解:要破一个案子,侦探需要两样东西——一是“法医报告、证人证词”(知识储备,对应世界模型),二是“分析线索、推导凶手的能力”(推理能力,对应推理机)。少了前者,侦探没线索;少了后者,线索再多也没用。
1. 第一个“脑子”:世界模型——AI的“常识说明书”
世界模型的核心作用,是“用最简洁的方式存储有用的知识,还能灵活复用”。它就像你手机里的“备忘录”,不是杂乱无章地记东西,而是按“生活常识”“工作技能”“专业知识”分类存储,要用的时候能快速调出来。
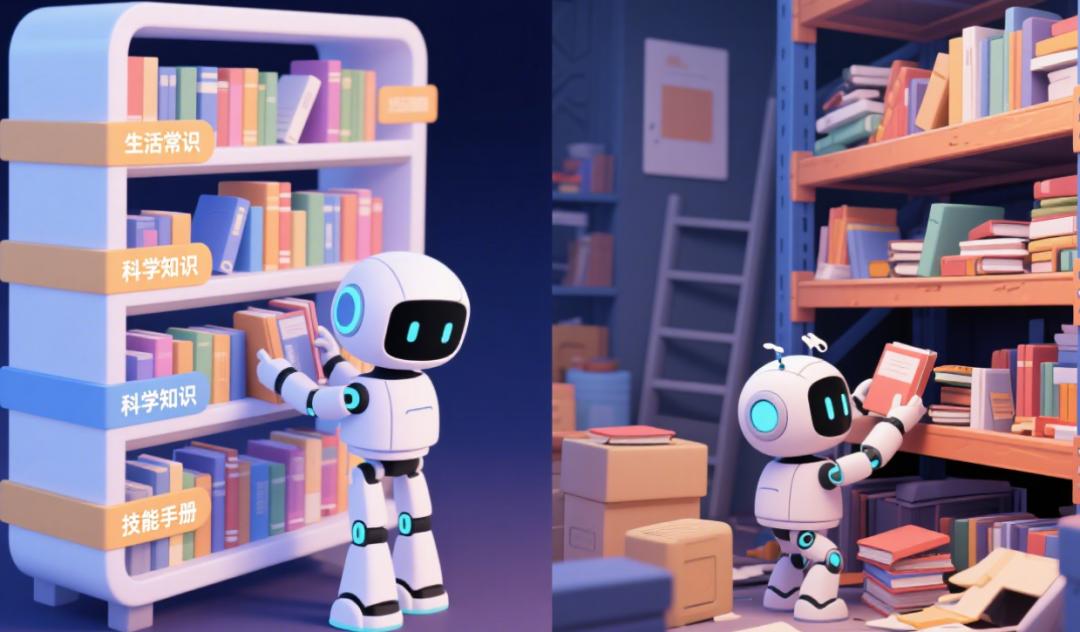
Bengio特别强调了世界模型的三个关键特质,我用生活例子给你一一拆解:
(1)“模块化”:学新东西不会忘旧东西
你有没有发现:你学会用手机拍照后,再学用相机拍照,不会忘了怎么用手机——因为这两种技能是“模块化”存储的,互不干扰。AI的世界模型也该这样。
比如一个“烹饪世界模型”,应该把“烤面包”“煮面条”“做沙拉”拆成不同模块,学“烤披萨”时,只需要调用“烤箱使用”“面团发酵”这些已有模块,而不是重新学所有烹饪知识。但现在的大模型没有这种模块化能力,学“烤披萨”可能会让它忘了“煮面条”的步骤——就像你背单词时,新单词记多了,旧单词反而混了。
(2)“会认怂”:知道自己“不知道”
人最聪明的一点,是知道“自己不知道”。比如有人问你“火星上有没有水”,你会说“目前科学家还在探索,不确定”,而不是瞎编“有”或“没有”。但现在的AI不会这样——它会不管自己懂不懂,都硬着头皮给一个答案,因为它没有“不确定性感知”。
Bengio认为,世界模型必须能“评估自己的知识边界”。比如一个“医疗世界模型”,遇到“罕见病症状”时,应该说“这个症状我不熟悉,建议参考XX文献”,而不是乱诊断。这不仅能减少错误,还能帮AI“主动学习”——就像你遇到不会的题会去查资料,AI也能针对“不确定的领域”主动找数据训练。
(3)“懂因果”:不会把“巧合”当“规律”
你肯定听过“鸡叫了,太阳就出来了”,但你不会觉得“鸡叫导致太阳升起”——因为你懂因果。但AI经常犯这种错:比如它发现“冰淇淋销量高的时候,溺水事故也多”,就会得出“吃冰淇淋导致溺水”的结论,而忽略了“夏天温度高,既让人想吃冰淇淋,也让人想游泳”这个真正的原因。
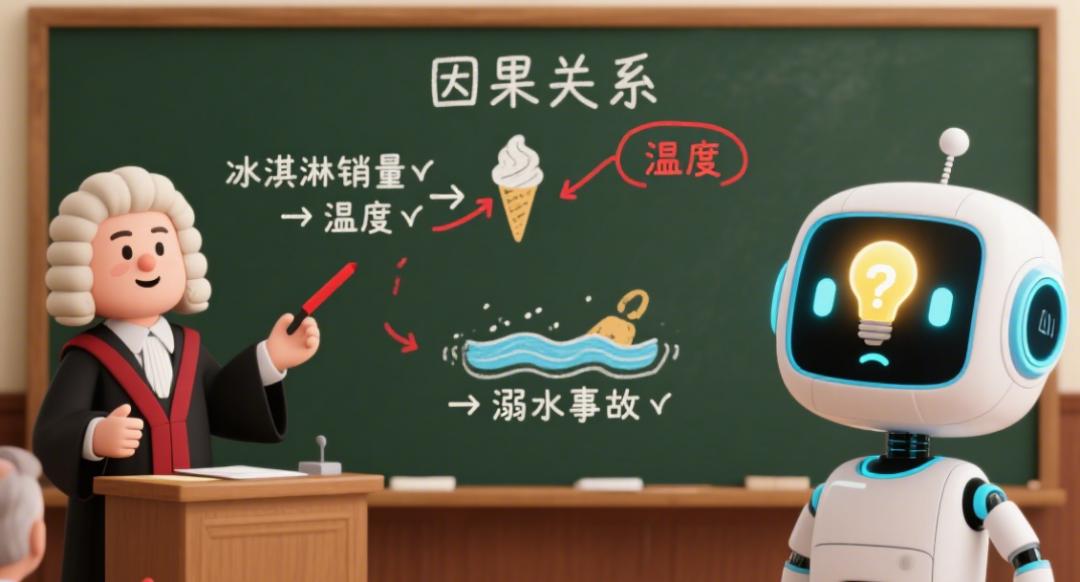
Bengio说,世界模型必须“懂因果”,就像人知道“下雨会让地面湿”,但“地面湿不会导致下雨”。这种能力能让AI在新场景下不犯傻——比如遇到“人工降雨”,它能理解“是炮弹导致下雨,不是云自己下雨”,而不是按旧经验判断“云多就会下雨”。
2. 第二个“脑子”:推理机——AI的“侦探分析器”
如果说世界模型是“线索库”,那推理机就是“侦探的大脑”——它的 job 是从线索库里找信息,一步步推导答案,而不是靠“猜概率”。
(1)“ Amortized inference( Amortized 推理)”:越用越熟练的“分析能力”
这个词听起来很玄乎,其实就是“熟能生巧”。比如你第一次做数学题,可能要一步步查公式、算步骤;但做了100道类似的题后,你一看题目就知道该用什么方法——这就是“推理能力被 amortized 了”,把之前的努力转化成了“快速解题的经验”。
AI的推理机也该这样。比如训练它解“鸡兔同笼”问题,第一次它可能要查“如何设未知数”“如何列方程”;但训练100次后,它能直接套用“(总脚数-2×总头数)÷2=兔子数”这个结论,不用再从头推导。Bengio说,这种能力能让AI在复杂任务上“又快又准”,就像老医生看诊比实习医生快,因为他们积累了太多“推理经验”。
(2)“能找多个答案”:不局限于“唯一解”
现实中很多问题没有“唯一答案”。比如“周末去哪玩”,可以去公园、看电影、逛书店,只要符合“放松”的需求就行。但现在的AI大多只会给一个答案,因为它的目标是“选概率最高的选项”,而不是“找所有合理的选项”。
好的推理机应该能“输出多个符合常识的答案”。比如你问AI“怎么做一顿简单的晚饭”,它应该列出“煮面条+煎蛋”“炒青菜+米饭”“三明治+牛奶”等多个方案,而不是只说“煮面条”。Bengio团队做的GFlowNets(后面会讲)就是干这个的——它能像“ brainstorm(头脑风暴)”一样,找出所有符合世界模型的解决方案。
三、怎么实现这“两个脑子”?Bengio团队的“GFlowNets”方案
知道了“要拆成两个脑子”,接下来的问题是:怎么落地?Bengio和他的团队在文章里重点提了一个叫“GFlowNets(生成流网络)”的工具,这玩意儿可以说是为“分开训练世界模型和推理机”量身定做的。
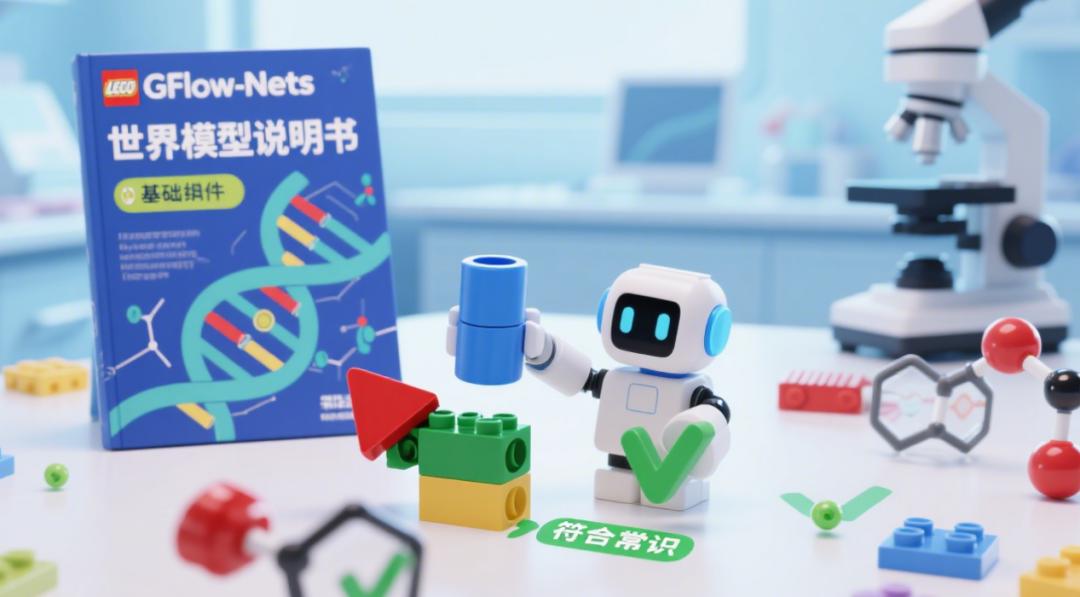
我先给你打个比方:如果世界模型是“乐高说明书”,推理机是“搭乐高的人”,那GFlowNets就是“搭乐高的步骤指南”——它会教推理机“先拼底座,再装零件,最后补细节”,每一步都检查是不是符合说明书(世界模型),确保搭出来的东西没错。
1. GFlowNets的核心思路:像“搭乐高”一样拼出答案
GFlowNets的厉害之处,在于它能“一步步构建解决方案”,而不是一下子瞎蒙一个答案。比如用它找新药分子,它不会像以前的AI那样“在海量分子里瞎捞”,而是按世界模型(比如“这个分子要能和癌细胞结合”)一步步拼:
• 第一步:选一个“基础分子片段”(比如碳链);
• 第二步:在碳链上加一个“能结合癌细胞的基团”;
• 第三步:检查这个新片段是否符合“无毒、易吸收”的常识(世界模型);
• 第四步:重复步骤2-3,直到拼出完整的药物分子。
这种“逐步构建+实时检查”的模式,能避免推理机“跑偏”——就像你搭乐高时,每一步都看说明书,不会拼到最后发现少了个零件。
2. GFlowNets的3个实际用处:从“找新药”到“解因果题”
Bengio在文章里举了几个GFlowNets的应用案例,我挑3个最贴近实际的讲:
(1)药物发现:从“大海捞针”到“按图索骥”
以前找新药,就像在大海里捞针——要测试几百万个分子,才能找到一个可能有效的。但用GFlowNets,推理机可以按世界模型(比如“这个分子要能抑制新冠病毒的刺突蛋白”)一步步拼分子,每一步都排除不符合要求的片段,大大减少测试量。
Bengio团队用这个方法,已经在实验室里找到几个可能对抗癌症的分子——比传统方法快了10倍以上。这就像“找朋友”:以前是在通讯录里挨个问“你是我要找的人吗”,现在是按“住在北京、喜欢爬山、从事AI研究”这些条件筛选,效率高多了。
(2)因果推理:终于能分清“原因”和“结果”
前面说过,AI最容易犯的错是“把巧合当因果”,而GFlowNets能解决这个问题。比如给它“冰淇淋销量高→溺水事故多”的数据,它会先查世界模型(“温度高会让人吃冰淇淋,也会让人游泳”),然后用GFlowNets推导“温度高是冰淇淋销量高和溺水事故多的共同原因”,而不是说“吃冰淇淋导致溺水”。
这个能力对AI做“决策”特别重要。比如政府要减少溺水事故,用GFlowNets分析后,会建议“在游泳区加救生员”,而不是“禁止卖冰淇淋”——这就是“懂因果”带来的正确决策。
(3)计算图调度:让AI“更聪明地干活”
现在的AI训练时,会有很多“计算任务”(比如处理图片、计算损失),怎么安排这些任务的顺序,会影响训练速度。以前是“按顺序排队”,比如“先处理所有图片,再计算损失”,效率很低。
用GFlowNets,推理机可以按世界模型(比如“处理图片A和处理图片B可以同时做,计算损失要等所有图片处理完”)来调度任务,就像“餐厅后厨安排出菜”:凉菜可以先做,热菜要等锅,汤可以和热菜同时炖,大大节省时间。Bengio团队用这个方法,把AI训练速度提高了30%左右。
四、AI什么时候能真的“会思考”?短期和长期的路
看到这里,你可能会问:这个“两个脑子”的思路,什么时候能用到我们日常用的AI上?Bengio在文章里也分了“短期”和“长期”两个阶段,我帮你梳理清楚:
1. 短期(1-3年):给现有大模型“加个草稿本”
现在的大模型没有“打草稿”的能力,比如算数学题时,它不会像人一样在纸上写步骤,而是直接输出答案。短期的改进方向,就是让大模型在回答时“默念步骤”——相当于给它加个“草稿本”,让它先在脑子里推导一遍,再输出答案。
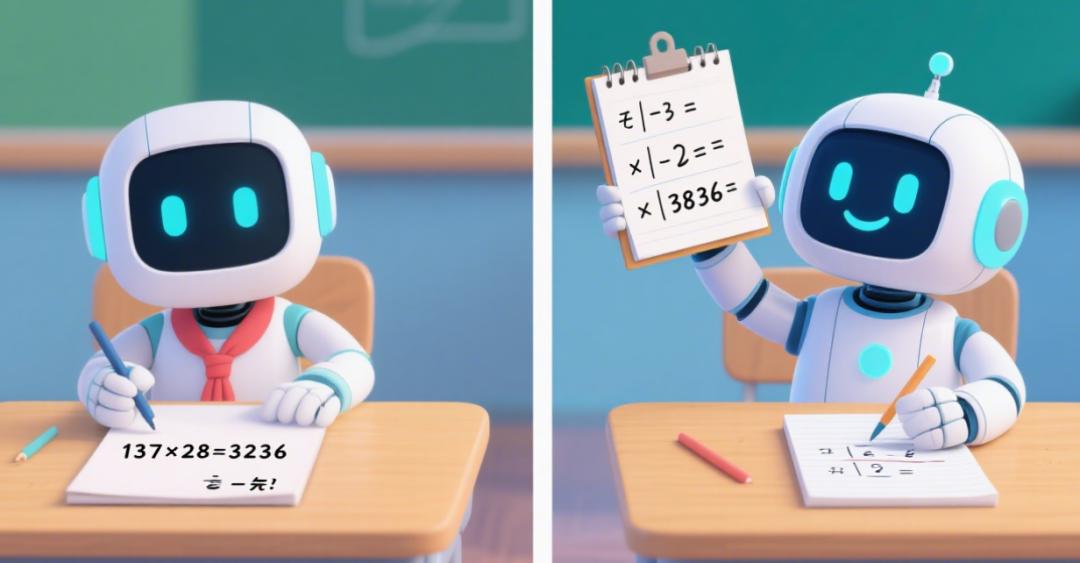
比如让ChatGPT算“137×28”,它会先在“草稿本”上写:
• 第一步:137×20=2740;
• 第二步:137×8=1096;
• 第三步:2740+1096=3836;
• 第四步:检查有没有算错(比如137×28=137×(20+8),公式没错)。
这种“加草稿本”的方法,其实就是让大模型的“世界模型”和“推理机”初步分离——草稿本里的步骤是推理机在干活,用到的乘法公式是世界模型里的知识。Bengio说,这一步现在已经有团队在做了,比如Anthropic的Claude 3,算数学题的正确率比之前提高了40%。
2. 长期(5-10年):完全分开训练“两个脑子”
短期是“临时补丁”,长期的目标是“彻底重构”——让世界模型和推理机各自独立训练,就像“两个人一起工作”:世界模型负责“更新知识”(比如学新的物理定律、医学常识),推理机负责“用知识解决问题”(比如用物理定律算卫星轨道、用医学常识诊断疾病)。
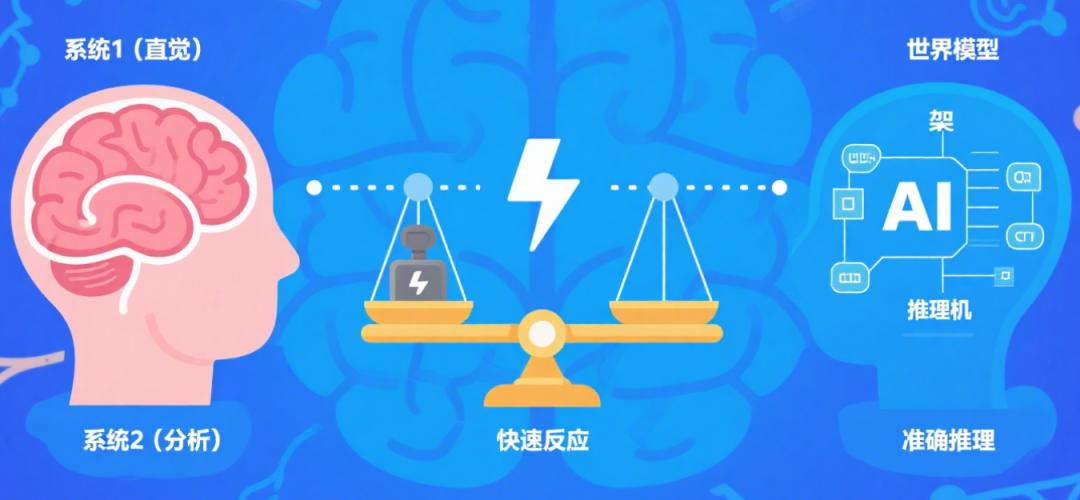
这时候的AI,会像人一样“学习+成长”:比如它学了新的“量子力学知识”(世界模型更新),推理机就能用这些知识推导“量子计算机的设计方案”;如果发现推理结果不对(比如设计方案不符合“能量守恒”),世界模型会反过来检查“是不是量子力学知识记错了”,形成一个“互相纠错”的循环。
Bengio在文章里特别提到:这种“分开训练”的思路,其实和人类大脑的“双系统”理论很像——我们的大脑有“系统1”(快速直觉,比如看到蛇就怕)和“系统2”(慢速分析,比如想“这蛇有没有毒”),现在的AI只有系统1,未来要加上系统2(推理机),才能真正“会思考”。
五、最后:AI的未来,不是“越大越好”,而是“越会思考越好”
读完Bengio的文章,我最大的感受是:过去几年,AI领域太执着于“ scaling(扩大规模)”了——好像参数越大、数据越多,AI就越智能。但Bengio用“Inverse Scaling Prize”和“大模型瞎编”的例子告诉我们:智能的核心是“会思考”,而不是“记得多”。
就像一个人,读了1000本书但不会分析,顶多是个“书呆子”;而一个会把知识拆成“常识”和“方法”,能用常识解决新问题的人,才是真的“聪明”。AI的未来也是如此——不是靠堆参数变成“书呆子”,而是靠“两个脑子”(世界模型+推理机)变成“会思考的伙伴”。
最后问你一个问题:如果未来的AI能像人一样“一步步解释答案”,你觉得最有用的场景是什么?是帮你算复杂的数学题,还是给你讲清楚“为什么这个病要这么治”,或者是帮你梳理“旅行攻略的逻辑”?欢迎在评论区聊聊你的想法。
参考资料
标题:Scaling in the service of reasoning & model-based ML
作者:Yoshua Bengio(蒙特利尔大学教授,深度学习先驱)、Edward J. Hu(Bengio的博士生)
链接:https://yoshuabengio.org/2023/03/21/scaling-in-the-service-of-reasoning-model-based-ml/