精|2025年Top10视觉语言模型VLM调研:技术、特性、使用、选型
2025年,VLMs迎来关键突破期,在跨模态理解精度、推理效率、场景适配性上均实现跨越式提升。那么,这些引领领域发展的VLMs究竟具备哪些核心技术特征?它们的创新点如何推动行业落地?本文中我们将回顾2025年的顶级视觉语言模型,重点介绍它们的独特能力,随后展示它们的性能及基准测试结果。针对开发人员和研究人员,我们还提供了示例代码片段,以便大家快速试用这些模型。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
一、先懂基础:什么是视觉语言模型(VLMs)?
当医疗影像AI能同时识别肺部微小结节并生成符合临床规范的诊断报告,当工业质检系统不仅定位产品缺陷还能解释缺陷成因,当智能助手可直接分析图表数据并生成自然语言结论——这些曾经需要多系统协同的复杂任务,如今已能被单一视觉语言模型(VLMs)高效完成。
在解读具体模型前,需先明确VLMs的技术定位。视觉语言模型(VLMs)是融合计算机视觉(CV) 与自然语言处理(NLP) 的跨模态AI模型,其核心区别于传统CV模型的关键在于:传统CV模型仅能输出图像特征或类别标签(如“猫”“狗”),而现代VLMs可实现“视觉感知-语言理解-逻辑推理”的全链路能力——既能解析图像中的物体、场景、嵌入式文本(如截图中的文字),又能通过自然语言回答视觉相关问题、生成结构化描述,甚至处理视频与文档的多模态输入。
正如AI研究员指出,VLMs的技术核心是“通过统一的表示空间对齐视觉与语言特征”:视觉编码器(如ViT系列)将图像转化为视觉嵌入向量,语言模型(如Transformer架构)将文本转化为语言嵌入向量,再通过跨模态注意力机制让两者实现语义关联。这种架构设计,使其在医疗诊断、自动化质检、智能文档分析等“精度优先于速度”的敏感场景中,展现出传统模型无法替代的价值。
二、2025年Top10 VLMs核心解读:创新、性能、使用
2025年的Top10 VLMs涵盖开源与闭源(专有)两类,各自在技术路线与应用场景上形成差异化优势。以下将重点解析各模型的核心创新、性能基准与典型应用方向。
1. Gemini 2.5 Pro:谷歌跨模态旗舰,领跑多任务基准
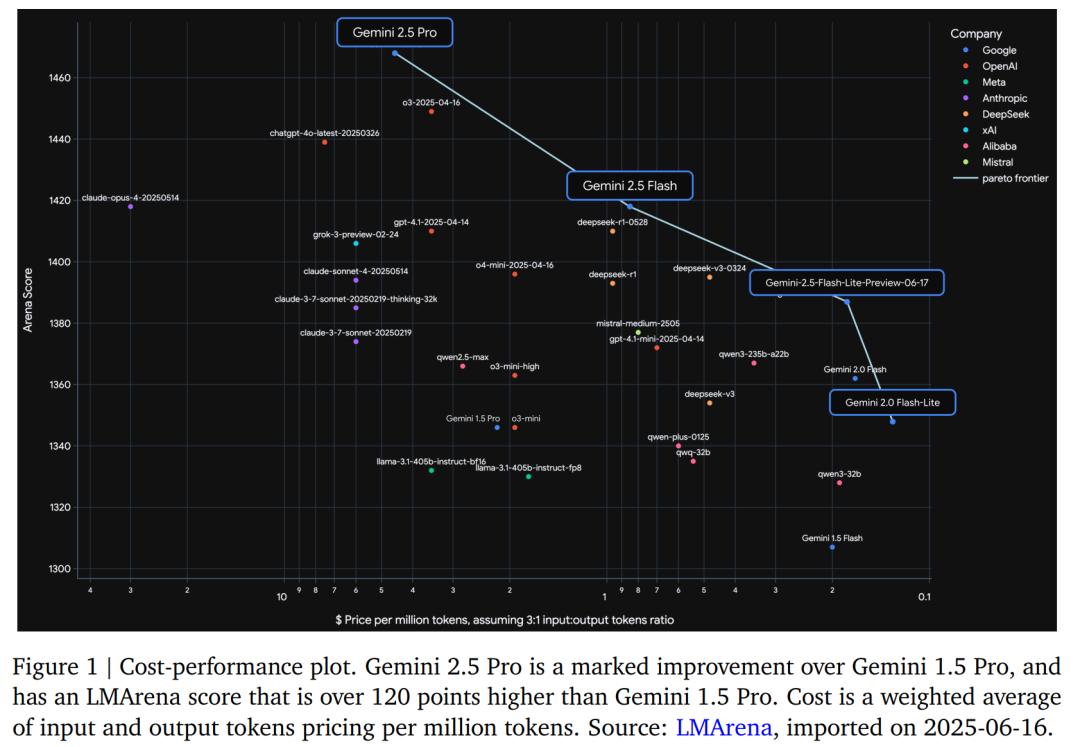
作为谷歌旗下最先进的AI模型,Gemini 2.5 Pro的核心优势在于跨模态协同能力——不仅支持文本、图像,还能处理音频与视频输入,且在LMArena(语言基准)与WebDevArena(编码基准)中均位列榜首,同时在Open LLM榜单的视觉语言任务中稳居前列。
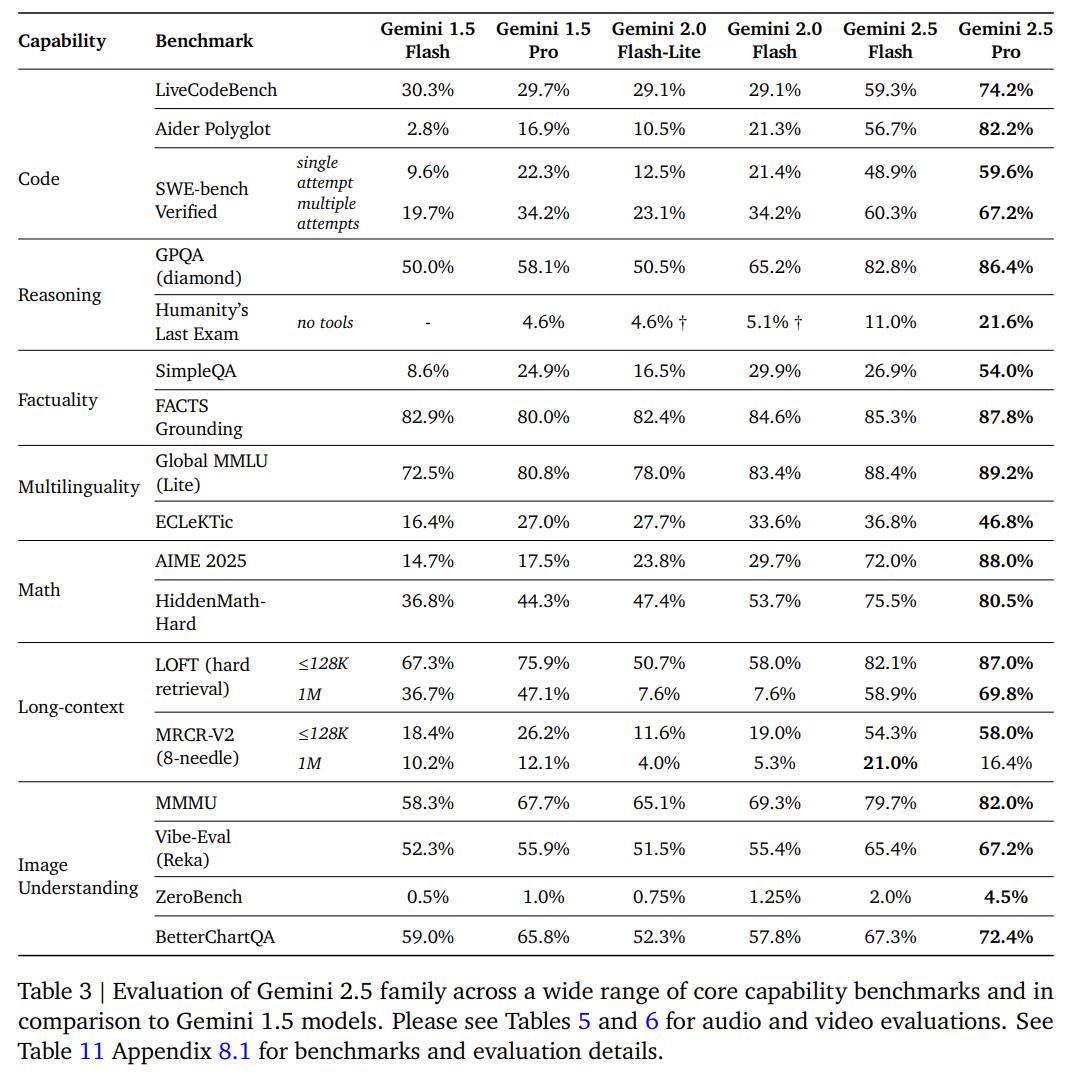
其技术亮点包括:
• 视觉语言理解:可生成上下文感知的图像/视频描述,精准回答视觉相关问题(如“图像中病灶的位置与特征”);
• 便捷集成:开发者可通过Gemini网页应用(gemini.google.com/app)、Google AI Studio、Gemini API或Python SDK调用,示例代码中仅需读取图像字节数据,即可通过generate_content接口实现视觉问答。
示例用法:
from google.genai import typeswith open('path/to/image.jpg', 'rb') as f: image_bytes = f.read() response = client.models.generate_content( model='gemini-2.5-pro', contents=[ types.Part.from_bytes( data=image_bytes, mime_type='image/jpeg', ), 'Explain the image.' ] )print(response.text)
2. InternVL3-78B:开源领域SOTA,参数规模与精度双突破
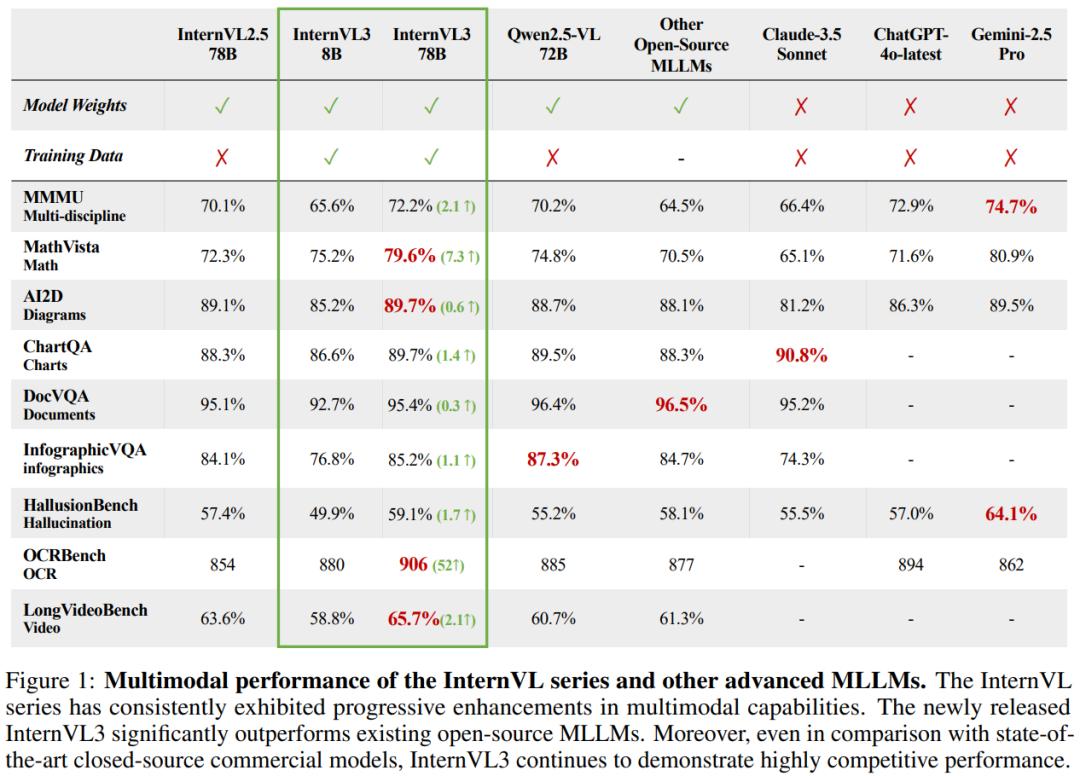
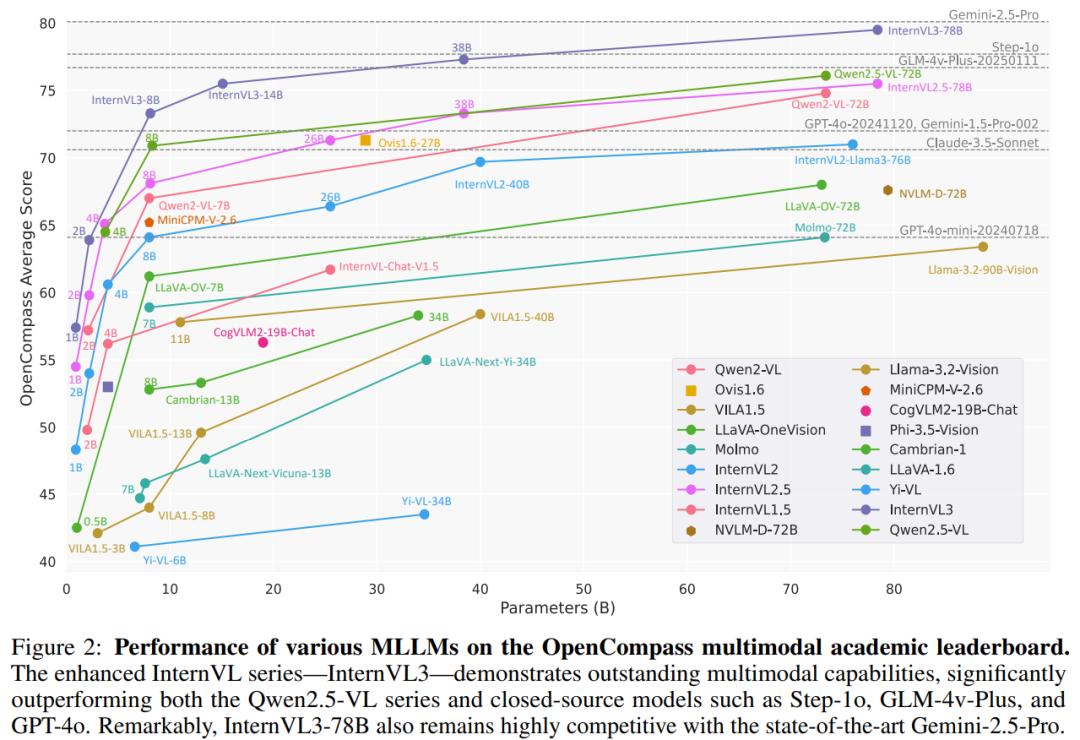
InternVL3-78B是开源多模态大语言模型(MLLMs)的代表,性能超越前代InternVL 2.5,在MMMU基准(多模态理解与推理)中取得72.2分的开源新纪录,甚至可与闭源模型竞争。
其技术架构与创新点明确:
• 组件搭配:视觉部分采用InternViT-6B-448px-V2_5编码器,语言部分基于Qwen2.5-72B,总参数达78.41亿,实现“视觉感知精度+语言推理能力”的平衡;
• 场景扩展:新增工具使用、GUI智能体、工业图像分析、3D视觉感知能力,尤其适用于工业质检中“缺陷识别+原因解释”的复杂任务。
示例用法:
# pip install lmdeploy>=0.7.3from lmdeploy import pipeline, TurbomindEngineConfig, ChatTemplateConfigfrom lmdeploy.vl import load_imagemodel = 'OpenGVLab/InternVL3-78B'image = load_image('https://raw.githubusercontent.com/open-mmlab/mmdeploy/main/tests/data/tiger.jpeg')pipe = pipeline(model, backend_config=TurbomindEngineConfig(session_len=16384, tp=4), chat_template_config=ChatTemplateConfig(model_name='internvl2_5'))response = pipe(('Explain the image.', image))print(response.text)
3. Ovis2.5-9B:视觉-文本嵌入对齐,原生分辨率,思考模式
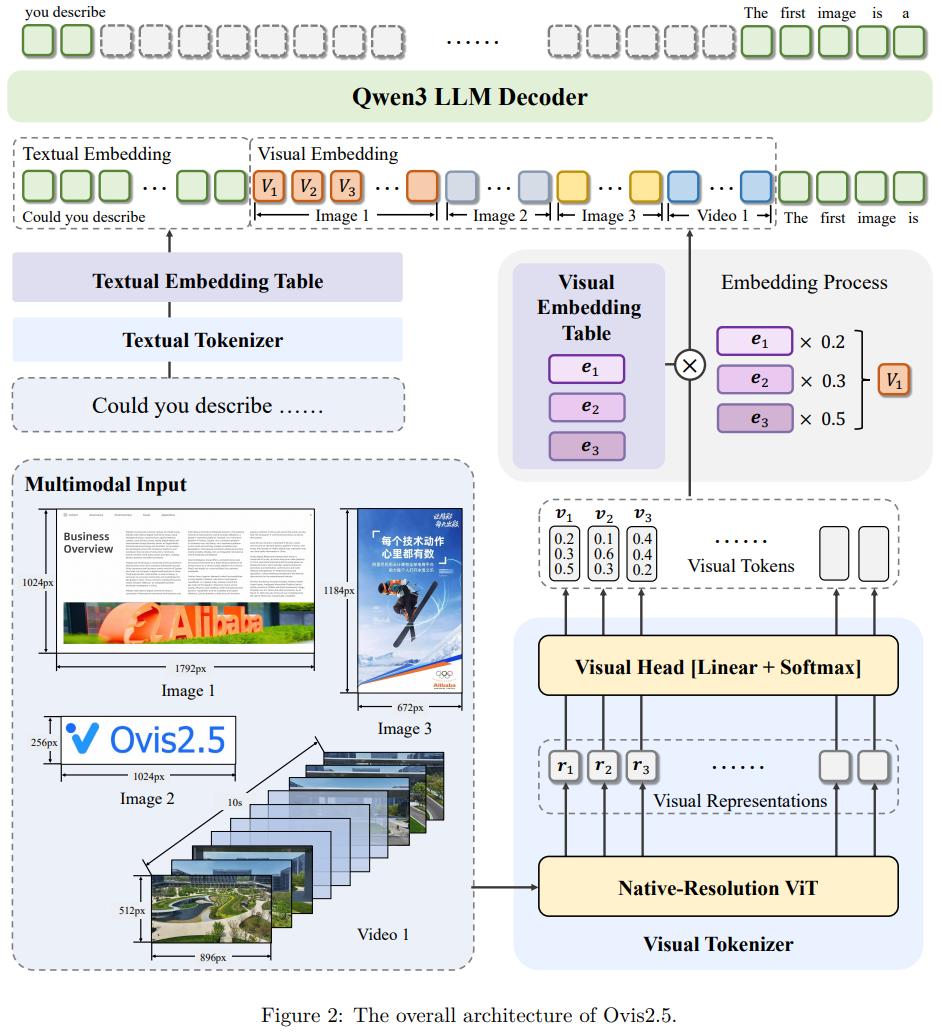
Ovis是阿里国际AI团队提出的视觉语言模型,Ovis通过视觉-文本嵌入结构对齐提升多模态能力,Ovis2.5主要技术创新如下:
• 集成原生分辨率ViT(NaViT),支持可变原生分辨率处理,避免分块损耗,保留细节与全局布局
• 新增“思考模式”,通过反思数据训练自我检查、修正能力,可权衡延迟与精度
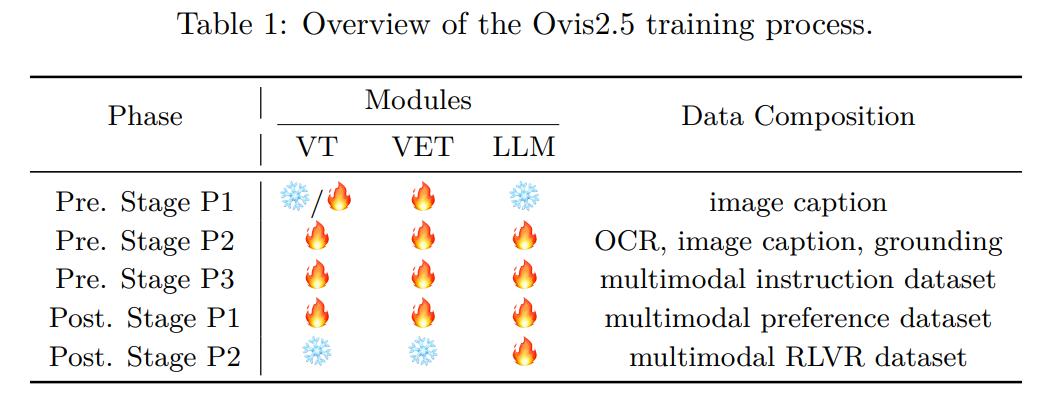
• 五阶段训练课程(视觉预训练→多模态预训练→指令微调→DPO→GRPO),搭配数据打包、混合并行技术,提速3-4倍。
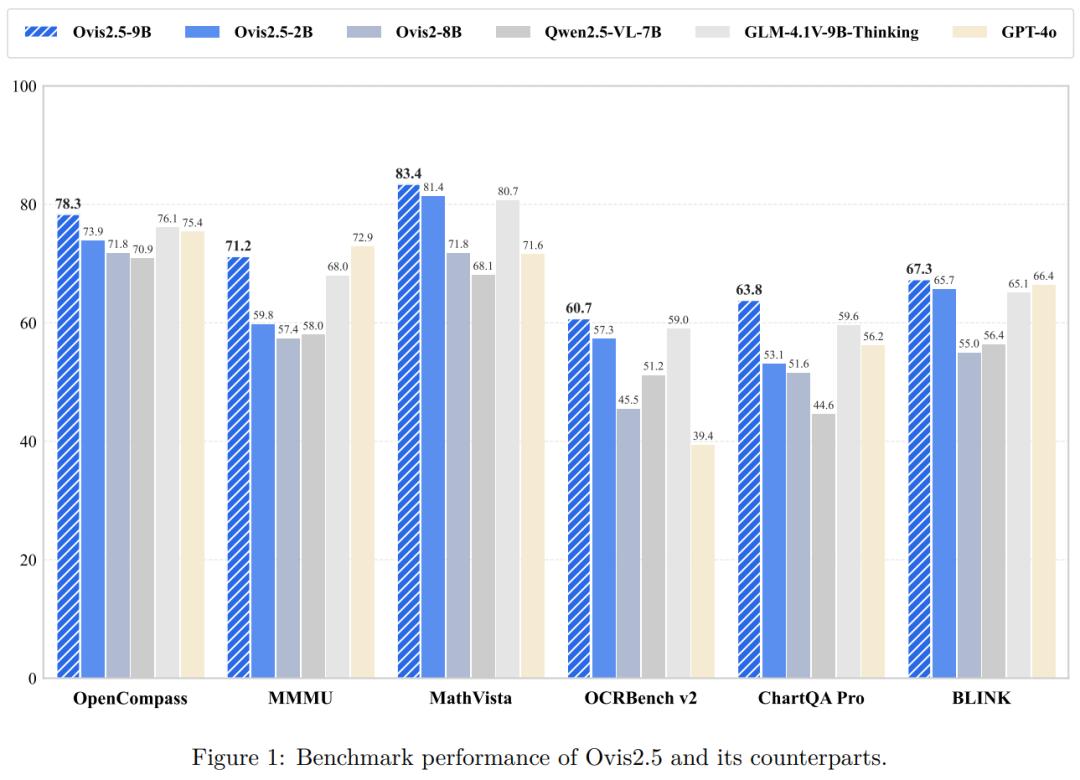
Ovis2.5-9B在OpenCompass得78.3,超Ovis2-8B,在参数少于40B的开源MLLM中处于SOTA水平;2B版得73.9,为同规模SOTA。在STEM、图表分析、视觉定位、视频任务领先,OCRBench超GPT-4o,ChartQA Pro创开源最佳,还缩小了与Gemini-2.5-Pro等闭源模型的差距。
示例用法:
import torchimport requestsfrom PIL import Imagefrom modelscope import AutoModelForCausalLMMODEL_PATH = "AIDC-AI/Ovis2.5-9B"# Thinking mode & budgetenable_thinking = Trueenable_thinking_budget = True # Only effective if enable_thinking is True.# Total tokens for thinking + answer. Ensure: max_new_tokens > thinking_budget + 25max_new_tokens = 3072thinking_budget = 2048model = AutoModelForCausalLM.from_pretrained( MODEL_PATH, torch_dtype=torch.bfloat16, trust_remote_code=True).cuda()messages = [{ "role": "user", "content": [ {"type": "image", "image": Image.open(requests.get("https://cdn-uploads.huggingface.co/production/uploads/658a8a837959448ef5500ce5/TIlymOb86R6_Mez3bpmcB.png", stream=True).raw)}, {"type": "text", "text": "Calculate the sum of the numbers in the middle box in figure (c)."}, ],}]input_ids, pixel_values, grid_thws = model.preprocess_inputs( messages=messages, add_generation_prompt=True, enable_thinking=enable_thinking)input_ids = input_ids.cuda()pixel_values = pixel_values.cuda() if pixel_values is notNone elseNonegrid_thws = grid_thws.cuda() if grid_thws is notNone elseNoneoutputs = model.generate( inputs=input_ids, pixel_values=pixel_values, grid_thws=grid_thws, enable_thinking=enable_thinking, enable_thinking_budget=enable_thinking_budget, max_new_tokens=max_new_tokens, thinking_budget=thinking_budget,)response = model.text_tokenizer.decode(outputs[0], skip_special_tokens=True)print(response)
4. Qwen2.5-VL-72B-Instruct:开源生态基石,多场景适配
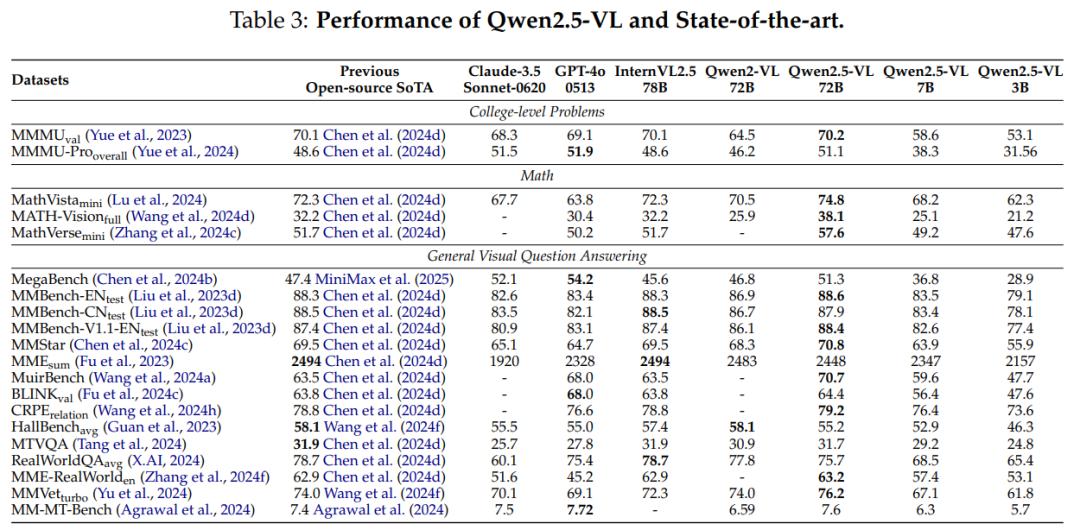
作为Qwen系列的多模态衍生模型,Qwen2.5-VL-72B-Instruct的核心价值在于支撑开源MLLM生态——众多开源模型基于其架构扩展,同时自身在视觉-文本处理上表现均衡:
• 性能覆盖:在MMMUval(70.2)、MathVista_MINI(74.8)、MMStar(70.8)等基准中保持高分数,支持图像与视频理解及智能体功能;
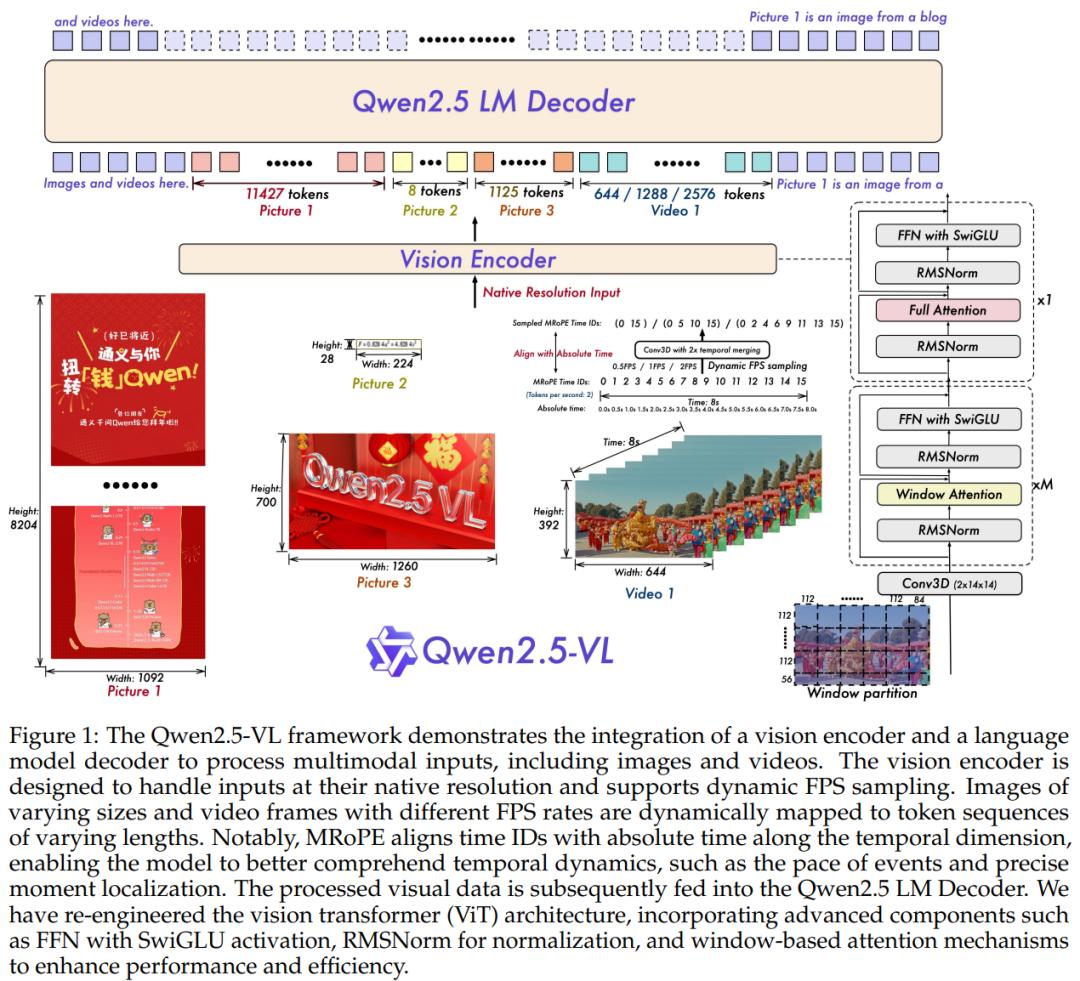
• 技术细节:采用动态FPS采样(0.5FPS/1FPS/2FPS)与MRoPE时间编码,优化视频序列的时间维度建模,适合动态视觉内容分析。
示例用法:
# pip install qwen-vl-utils[decord]==0.0.8from transformers import Qwen2_5_VLForConditionalGeneration, AutoTokenizer, AutoProcessorfrom qwen_vl_utils import process_vision_info# 默认:在可用设备上加载模型model = Qwen2_5_VLForConditionalGeneration.from_pretrained( "Qwen/Qwen2.5-VL-72B-Instruct", torch_dtype="auto", device_map="auto")# 默认处理器processor = AutoProcessor.from_pretrained("Qwen/Qwen2.5-VL-72B-Instruct")messages = [ { "role": "user", "content": [ { "type": "image", "image": "https://qianwen-res.oss-cn-beijing.aliyuncs.com/Qwen-VL/assets/demo.jpeg", }, {"type": "text", "text": "Describe this image."}, ], }]# 推理准备text = processor.apply_chat_template( messages, tokenize=False, add_generation_prompt=True)image_inputs, video_inputs = process_vision_info(messages)inputs = processor( text=[text], images=image_inputs, videos=video_inputs, padding=True, return_tensors="pt",)inputs = inputs.to("cuda")# 推理:生成输出generated_ids = model.generate(**inputs, max_new_tokens=128)generated_ids_trimmed = [ out_ids[len(in_ids) :] for in_ids, out_ids in zip(inputs.input_ids, generated_ids)]output_text = processor.batch_decode( generated_ids_trimmed, skip_special_tokens=True, clean_up_tokenization_spaces=False)print(output_text)
5. o3 Latest:OpenAI推理型模型,视觉推理精度跃升
OpenAI的o3 Latest是新一代强调“高级推理能力”的VLMs,核心突破在于数学、科学、视觉推理任务的精度提升:
• 基准优势:在MMMU(大学级视觉问题解决)、MathVista(视觉数学推理)、CharXiv-Reasoning(科学图表推理)中,性能超越o4-mini与o1,持平o3 Pro,尤其适合需要“视觉信息+逻辑计算”的场景(如学术图表解读、工程图纸分析)。
视觉基准测试成绩(百分比)
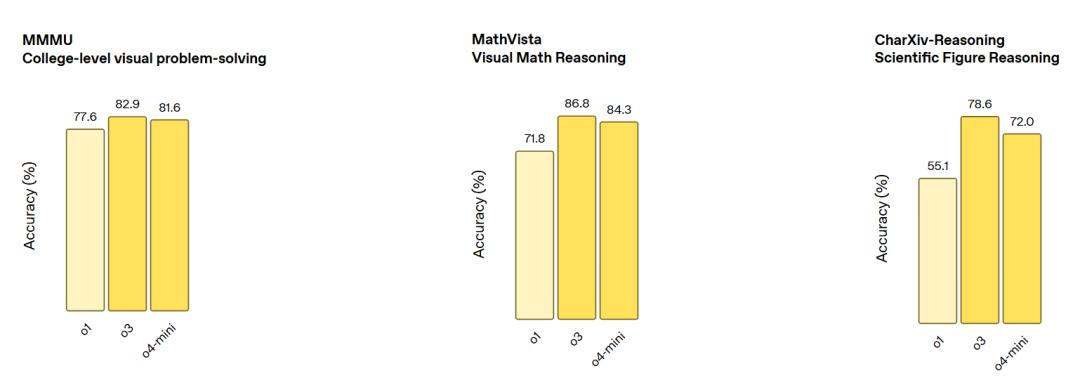
来源:OpenAI官方博客《Introducing OpenAI o3 and o4-mini》
示例用法:
from openai import OpenAIclient = OpenAI()response = client.responses.create( model="o3-2025-04-16", input=[{ "role": "user", "content": [ {"type": "input_text", "text": "what's in this image?"}, { "type": "input_image", "image_url": "https://upload.wikimedia.org/wikipedia/commons/thumb/d/dd/Gfp-wisconsin-madison-the-nature-boardwalk.jpg/2560px-Gfp-wisconsin-madison-the-nature-boardwalk.jpg", }, ], }],)print(response.output_text)
6. GPT 4.1(2025-04-14):非推理模型家族,视觉分析细化
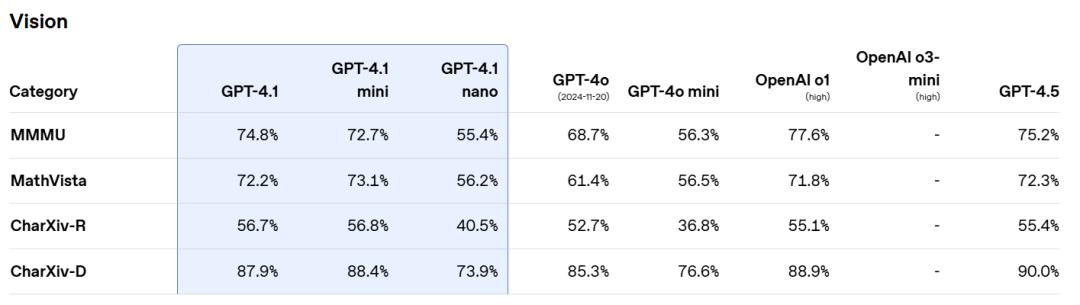
GPT 4.1系列(含GPT 4.1、Mini、Nano)定位为“非推理型VLMs”,核心改进在于视觉分析的细分能力强化,性能全面超越前代GPT-4o系列:
• 优势任务:擅长图表/示意图分析、视觉数学(如几何题)、物体计数、光学字符识别(OCR),在CharXiv-D(文档视觉理解)中达87.9%(标准版),适合需要精准提取视觉细节的场景(如表单识别、数据图表提取);
• 分级适配:不同尺寸模型(Mini、Nano)满足不同硬件需求,平衡精度与部署成本。
视觉能力基准测试对比(百分比)
来源:OpenAI官方博客《Introducing GPT-4.1 in the API》
示例用法:
from openai import OpenAIclient = OpenAI()response = client.responses.create( model="gpt-4.1-2025-04-14", input=[{ "role": "user", "content": [ {"type": "input_text", "text": "what's in this image?"}, { "type": "input_image", "image_url": "https://upload.wikimedia.org/wikipedia/commons/thumb/d/dd/Gfp-wisconsin-madison-the-nature-boardwalk.jpg/2560px-Gfp-wisconsin-madison-the-nature-boardwalk.jpg", }, ], }],)print(response.output_text)
7. Claude Sonnet 4:智能体编码融合,多格式理解
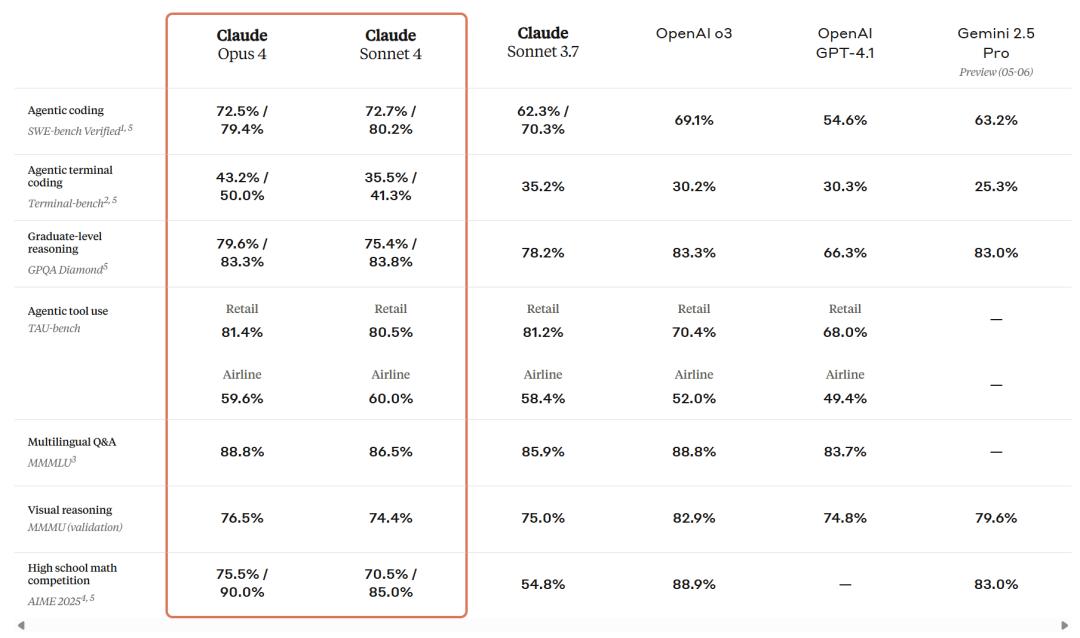
Anthropic的Claude Sonnet 4虽以编码为核心定位,但视觉能力与智能体功能的结合是其差异化亮点:
• 视觉-编码协同:可基于图像理解生成代码(如根据UI设计图生成前端代码),支持多种文件格式解析;
• 基准表现:在视觉推理(MMMU验证集74.4%)与智能体编码(SWE-bench Verijieal-5达72.7%/80.2%)中表现突出,适合“视觉需求+代码生成”的开发场景(如智能体驱动的自动化开发)。
Claude 4系列模型性能对比(百分比/分数)
来源:Anthropic官方博客《Introducing Claude 4》
示例用法:
import anthropicclient = anthropic.Anthropic()message = client.messages.create( model="claude-sonnet-4-20250514", max_tokens=1024, messages=[ { "role": "user", "content": [ { "type": "image", "source": { "type": "url", "url": "https://upload.wikimedia.org/wikipedia/commons/a/a7/Camponotus_flavomarginatus_ant.jpg", }, }, { "type": "text", "text": "Describe this image." } ], } ],)print(message)
8. Kimi-VL-A3B-Thinking-2506:开源推理优化,效率与精度平衡
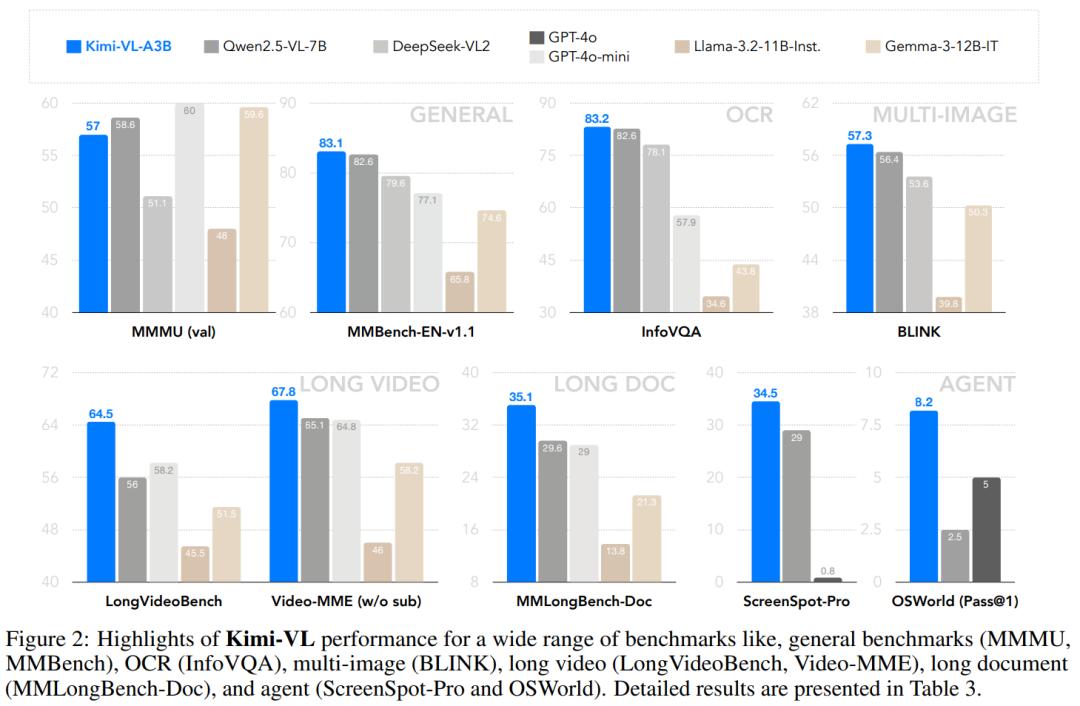
MoonshotAI推出的Kimi-VL-A3B-Thinking-2506是开源VLMs中“推理效率优化”的代表,核心突破在于缩短“思考长度”的同时保持高精度:
• 性能亮点:在MathVista(80.1)、MMMU(64.0)等推理基准中表现优异,思考长度平均缩短20%;同时在MMBench-EN-v1.1(84.4)、MMVet(78.4)等通用视觉任务中持平闭源模型;
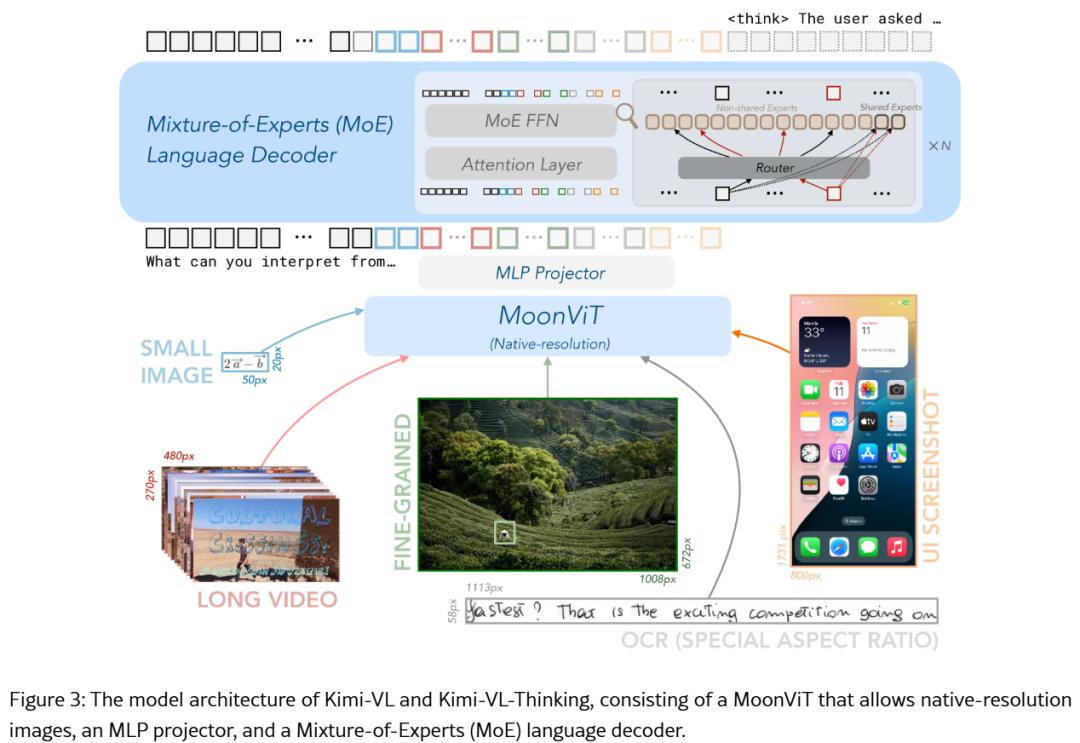
• 技术设计:采用MoE(混合专家)语言解码器与MoonViT原生分辨率视觉编码器,平衡推理速度与视觉感知精度。
模型结构说明
• 混合专家(MoE)语言解码器:包含非共享专家(Non-shared Experts)、共享专家(Shared Experts)和路由层(Router),通过MoE前馈网络(MoE FFN)优化计算效率。
• 注意力层(Attention Layer):处理视觉与文本token的注意力交互。
• 视觉处理模块:采用MoonViT(原生分辨率,MoonViT (Native-resolution))和多层感知机(MLP)投影器,支持小图像(SMALL IMAGE)、特殊宽高比OCR(OCR (SPECIAL ASPECT RATIO))和长视频(LONG VIDEO)输入。
来源:MoonshotAI/Kimi-VL: Kimi-VL
示例用法:
from transformers import AutoProcessorfrom vllm import LLM, SamplingParamsmodel_path = "moonshotai/Kimi-VL-A3B-Thinking-2506"llm = LLM( model_path, trust_remote_code=True, max_num_seqs=8, max_model_len=131072, limit_mm_per_prompt={"image": 256})processor = AutoProcessor.from_pretrained(model_path, trust_remote_code=True)sampling_params = SamplingParams(max_tokens=32768, temperature=0.8)import requestsfrom PIL import Imagedef extract_thinking_and_summary(text: str, bot: str = "◁think▷", eot: str = "◁/think▷") -> str: if bot in text and eot not in text: return "" if eot in text: return text[text.index(bot) + len(bot):text.index(eot)].strip(), text[text.index(eot) + len(eot) :].strip() return "", textOUTPUT_FORMAT = "--------Thinking--------{thinking}--------Summary--------{summary}"url = "https://huggingface.co/spaces/moonshotai/Kimi-VL-A3B-Thinking/resolve/main/images/demo6.jpeg"image = Image.open(requests.get(url,stream=True).raw)messages = [ {"role": "user", "content": [{"type": "image", "image": ""}, {"type": "text", "text": "What kind of cat is this? Answer with one word."}]}]text = processor.apply_chat_template(messages, add_generation_prompt=True, return_tensors="pt")outputs = llm.generate([{"prompt": text, "multi_modal_data": {"image": image}}], sampling_params=sampling_params)generated_text = outputs[0].outputs[0].textthinking, summary = extract_thinking_and_summary(generated_text)print(OUTPUT_FORMAT.format(thinking=thinking, summary=summary))
9. Gemma-3-27b-it:谷歌多尺寸家族,人机偏好领先
谷歌Gemma 3系列(1B/4B/12B/27B)的核心优势在于人机偏好评价——27B版本在人类偏好测试中超越Llama 3-405B等更大模型,同时具备稳定的视觉语言能力:
• 多模态表现:在COCOcap(116)、DocVQA(85.6)、VQAv2(72.9)等基准中达较高分数,视觉理解与语言生成的协同性优化;
• 灵活部署:不同参数规模适配从边缘设备到云端的多样部署需求,适合对交互体验要求高的场景(如视觉助手)。
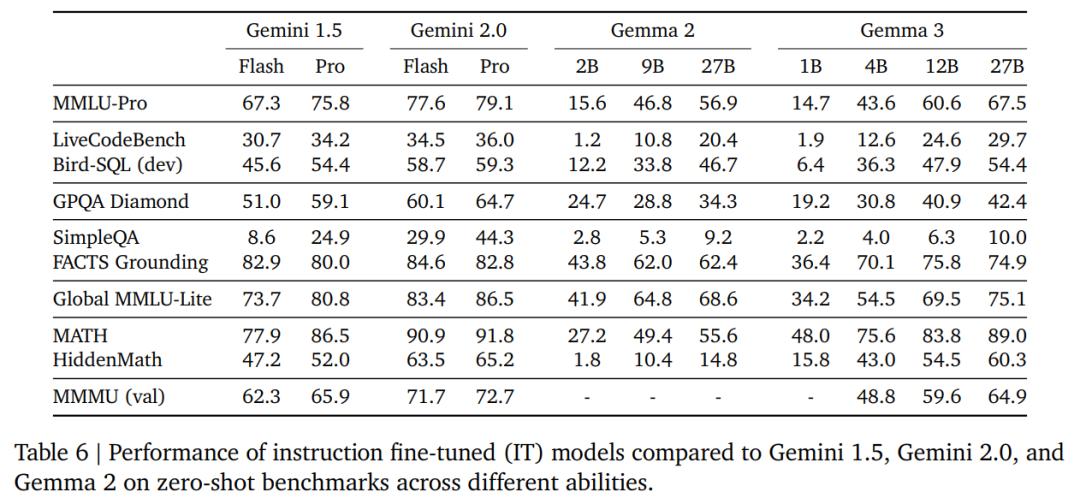
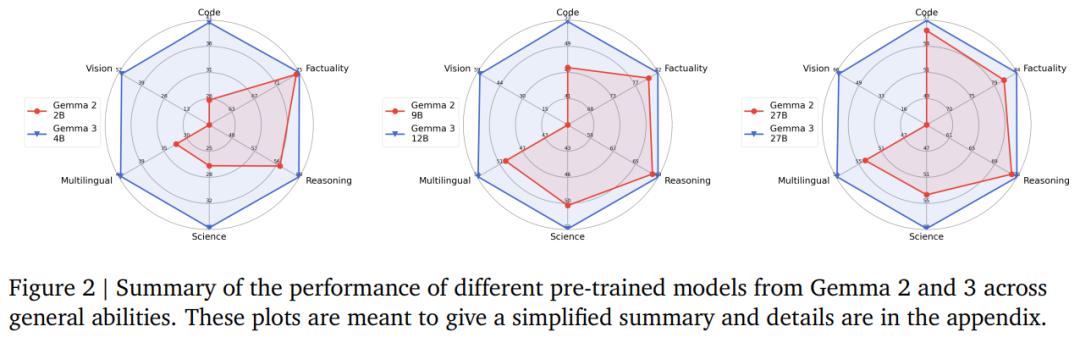
来源:Gemma 3 Technical Report
示例用法:
# pip install acceleratefrom transformers import AutoProcessor, Gemma3ForConditionalGenerationfrom PIL import Imageimport requestsimport torchmodel_id = "google/gemma-3-27b-it"model = Gemma3ForConditionalGeneration.from_pretrained( model_id, device_map="auto").eval()processor = AutoProcessor.from_pretrained(model_id)messages = [ { "role": "system", "content": [{"type": "text", "text": "You are a helpful assistant."}] }, { "role": "user", "content": [ {"type": "image", "image": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/bee.jpg"}, {"type": "text", "text": "Describe this image in detail."} ] }]inputs = processor.apply_chat_template( messages, add_generation_prompt=True, tokenize=True, return_dict=True, return_tensors="pt").to(model.device, dtype=torch.bfloat16)input_len = inputs["input_ids"].shape[-1]with torch.inference_mode(): generation = model.generate(**inputs, max_new_tokens=100, do_sample=False) generation = generation[0][input_len:]decoded = processor.decode(generation, skip_special_tokens=True)print(decoded)
10. Llama-3.2-90B-Vision-Instruct:Meta视觉适配,大规模训练支撑
Meta的Llama-3.2-90B-Vision-Instruct基于Llama 3.1文本模型扩展,核心技术路径是独立训练视觉适配器,实现“文本能力复用+视觉能力新增”:
• 训练投入:累计消耗885万GPU小时,确保大规模视觉数据的充分学习;
• 基准精度:在VQAv2(73.6)、Text VQA(73.5)、DocVQA(70.7)等任务中表现突出,尤其在AI2 Diagram(图表理解)中达75.3%,适合文档与图表密集型场景(如教育领域的课件分析)。
Llama 3.2系列模型视觉能力基准测试对比
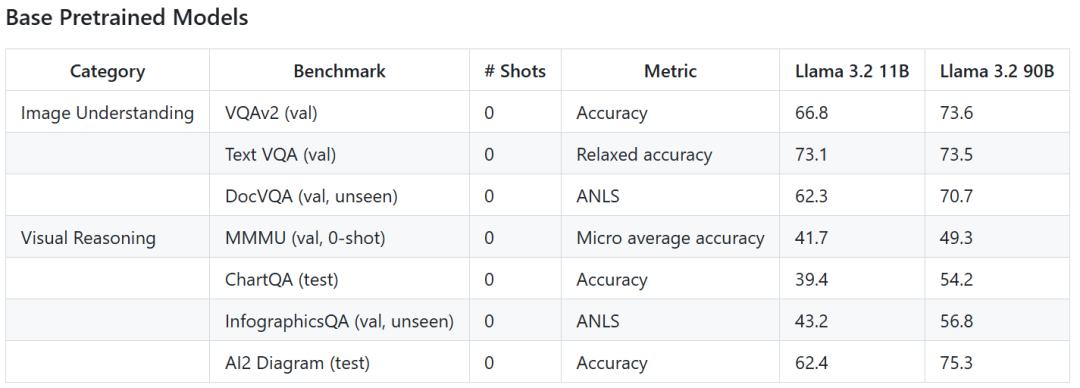
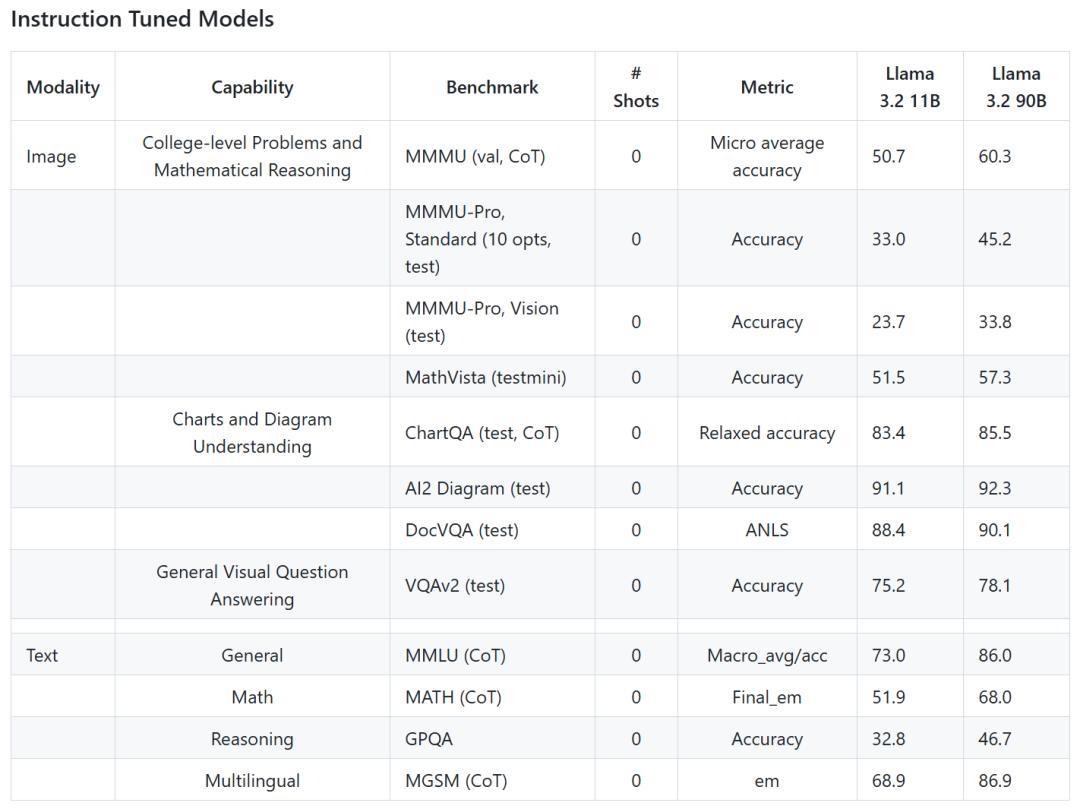
来源:llama-models
示例用法:
import requestsimport torchfrom PIL import Imagefrom transformers import MllamaForConditionalGeneration, AutoProcessormodel_id = "meta-llama/Llama-3.2-90B-Vision-Instruct"model = MllamaForConditionalGeneration.from_pretrained( model_id, torch_dtype=torch.bfloat16, device_map="auto",)processor = AutoProcessor.from_pretrained(model_id)url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/0052a70beed5bf71b92610a43a52df6d286cd5f3/diffusers/rabbit.jpg"image = Image.open(requests.get(url, stream=True).raw)messages = [ {"role": "user", "content": [ {"type": "image"}, {"type": "text", "text": "If I had to write a haiku for this one, it would be: "} ]}]input_text = processor.apply_chat_template(messages, add_generation_prompt=True)inputs = processor( image, input_text, add_special_tokens=False, return_tensors="pt",).to(model.device)output = model.generate(**inputs, max_new_tokens=30)print(processor.decode(output[0]))
三、2025年VLMs技术趋势:从“能做”到“做好”的跨越
通过对Top10模型的分析,可提炼出2025年VLMs的三大核心技术趋势,这些趋势也将决定未来1-2年跨模态AI的发展方向。
1. 跨模态融合:从“支持多模态”到“深度协同”
早期VLMs多为“视觉模块+语言模块”的简单拼接,而2025年的模型更注重跨模态的深度协同——如Gemini 2.5 Pro的音视频-文本统一处理、Claude Sonnet 4的“视觉理解-代码生成”闭环,均体现“多模态信息不再是独立输入,而是协同支撑任务完成”的思路。正如研究员所言,“未来VLMs的竞争焦点,将是跨模态信息的语义关联精度”。
2. 开源与闭源的平衡:开源模型冲击闭源壁垒
2025年以前,闭源VLMs(如GPT-4系列)在精度上长期领先,但InternVL3-78B、Kimi-VL等开源模型通过“大参数规模+优化架构”,已在部分基准(如MMMU)上接近闭源水平。同时,开源模型的“本地部署+数据可控”优势,使其在医疗、金融等敏感场景中更具吸引力,形成“闭源供能快速落地,开源支撑定制化需求”的生态格局。
3. 效率优化:推理速度与资源消耗的双重突破
随着VLMs在边缘设备(如工业质检终端)的落地需求增加,“效率”成为核心优化方向:Ovis2-34B的bfloat16精度、Kimi-VL的思考长度缩短、Gemma 3的多尺寸设计,均在“降低计算/内存开销”与“保持精度”间寻找平衡。这种优化使VLMs从“云端专属”走向“云边协同”,拓展了应用场景边界。
四、应用选择建议:按需匹配模型类型
不同场景对VLMs的需求差异显著,结合模型特性与行业需求,可形成以下选择逻辑:
• 敏感场景(医疗诊断、金融文档分析):优先选择开源模型(如Qwen2.5-VL、Kimi-VL),本地部署可确保数据隐私,且支持基于少量样本的微调以适配特定场景;
• 快速落地场景(通用视觉问答、智能助手):选择闭源模型(如Gemini 2.5 Pro、GPT 4.1),通过API快速集成,无需关注底层技术细节,同时享受稳定的精度保障;
• 专业场景(工业质检、电商推荐、学术图表分析):根据任务需求选择专项优化模型——如:工业场景选InternVL3-78B(工业图像分析),电商场景选Ovis2.5-9B(电商内容理解),学术场景选o3 Latest(科学图表推理)。
参考资料
• 标题:Top 10 Vision Language Models in 2025,作者:Datacamp,链接:https://www.datacamp.com/blog/top-vision-language-models