晓|腾讯&清华广告推荐基础大模型:从更精准到更懂你,GMV+2.45%
你有没有过这种被广告 “拿捏又拿捏不住” 的矛盾体验?前几天在搜 “3岁宝宝绘本推荐”,刚纠结完 “注音版会不会影响识字”,转头刷就看到那款无注音绘本在推 “宝妈专属折扣”,精准到让你忍不住拍腿:“它怎么知道我在纠结这个?”;可转头,你刚给家里换完新空调,接下来一周打开任何平台,还是会被反复推送同品牌的旧款空调,甚至连 “1.5 匹适合小卧室” 的型号都来凑热闹 —— 像个听不懂 “我已经买完了” 的固执推销员,越推越让人烦躁。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
我最近翻到腾讯团队刚发表的《Large Foundation Model for Ads Recommendation》(简称 LFM4Ads)论文时,瞬间有种 “哦,原来问题根在这” 的通透感。其实我们遇到的广告 “时灵时不灵”,既不是算法在 “偷懒”,也不是平台故意 “乱推”,而是过去的广告推荐系统一直有个没补上的 “短板”:它们只死磕 “用户是谁、做过什么”(比如你搜过绘本、买过空调),却没真正搞懂 “商品到底是什么”(比如这本绘本的 “无注音” 是核心卖点),更没弄明白 “用户和商品的适配度”(比如你买完空调后,需要的是 “滤网耗材” 而非 “同款机器”)。
而这篇论文里的新模型,相当于给广告推荐系统补上了 “全科课”—— 它不仅能看清你的需求,还能读懂商品的 “核心价值”,甚至能预判 “你和这个商品的适配阶段”。接下来我们拆解这个模型:从过去广告推荐 “偏科” 的根源,到新模型如何 “补全视角”,再到它落地后对我们日常刷广告的影响。看完你就会明白:那些让你 “拍腿叫绝” 或 “皱眉划走” 的广告,背后其实都是算法 “懂不懂适配” 的差别。
一、广告推荐的“老大难”:不是不想准,是“信息不全”
先别急着骂“广告烦”,其实推荐团队比你更想让广告“精准不扰人”。毕竟用户愿意点、商家愿意投,平台才能良性循环。但现实是,广告推荐面临两个绕不开的“坑”:
第一个坑是“冷启动”。就像你刚认识一个新朋友,不知道他喜欢吃辣还是吃甜,没法推荐餐厅一样。新上架的商品(比如一款刚推出的小众香水)、新注册的用户,因为没有历史互动数据,模型根本“猜不准”他们的匹配度,只能乱推一通。
第二个坑是“语义鸿沟”。传统模型把用户和商品的信息当成“两张独立的卡片”,比如用户卡片写着“25岁,喜欢户外”,商品卡片写着“帐篷,防水”,但模型不知道“用户喜欢户外”和“帐篷防水”之间的深层关联——就像你给一个喜欢徒步的人推荐帐篷时,只说“这是帐篷”,却没说“它适合雨天徒步”,精准度自然上不去。
我团队之前也做过类似的广告推荐优化,当时卡在了“怎么让模型同时看懂用户、商品,还有两者的关系”。直到看到LFM4Ads,才发现他们把这个问题拆解得特别透彻。
二、传统方法的“短板”:只盯“人”,忘了“货”和“场”
要理解LFM4Ads的创新,得先说说传统模型的“偷懒”之处。过去的广告推荐大模型,比如Meta的SUM、Pinterest的PinFM,都只盯着“用户表征”(可以理解为用户的“兴趣身份证”)做文章——就像月老牵线时,只问男方喜欢什么,却不问女方的条件,也不问两人见面时聊得投不投缘,成功率怎么可能高?
具体来说,传统方法有三个明显的“漏项”:
• 漏了“商品表征”:只记用户喜欢什么,却不记商品的“特质档案”。比如一款新口红,传统模型只知道它是“口红”,却不知道它“适合黄皮、哑光质地”,遇到想找“黄皮显白口红”的用户,自然匹配不上。
• 漏了“互动表征”:用户和商品的互动(比如“用户看了口红3秒就划走”vs“用户点进详情页看了色卡”)里藏着大量精准信号,但传统模型把这些互动当成“是否点击”的简单标签,却没把互动过程中的“偏好细节”记下来——就像你跟人聊天,只记了“聊过”,却没记“对方对哪个话题更感兴趣”。
• 转移方式太“简单粗暴”:传统模型把用户表征当成“一个额外特征”塞进下游模型,比如给推荐模型加个“用户喜欢户外”的标签,却没考虑这个标签和下游场景(比如朋友圈广告vs视频号广告)的适配性。就像你把西装直接套在运动服外面,虽然能穿,但肯定不舒服、不合身。
这些问题导致传统模型的精准度“上限很低”——不是工程师不够努力,是模型从设计上就“看不全信息”。
三、
LFM4Ads最让我惊艳的地方,不只是设计了 “三塔结构” 解决信息不全问题,更搭好了能让模型 “实时干活” 的在线系统。就像造好了一台精密的机器,还配套了稳定的操作台,让它能在实际广告场景里持续运转。
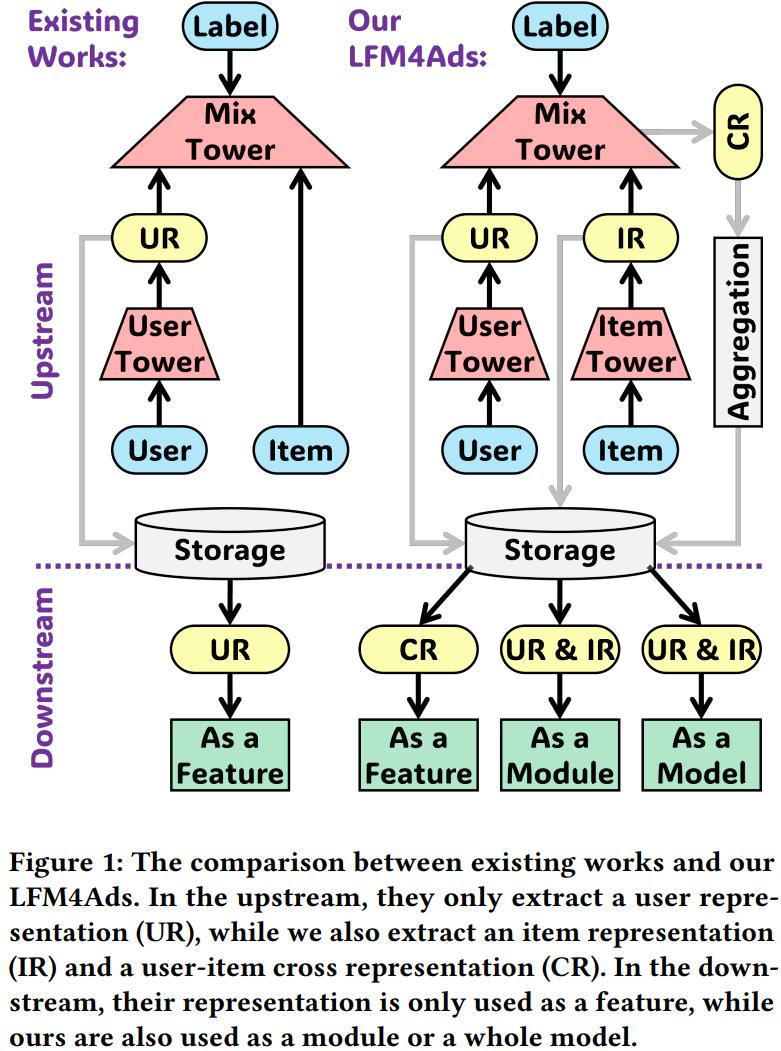
1. 第一板斧:全表征迁移——同时记好“人、货、互动”三张牌
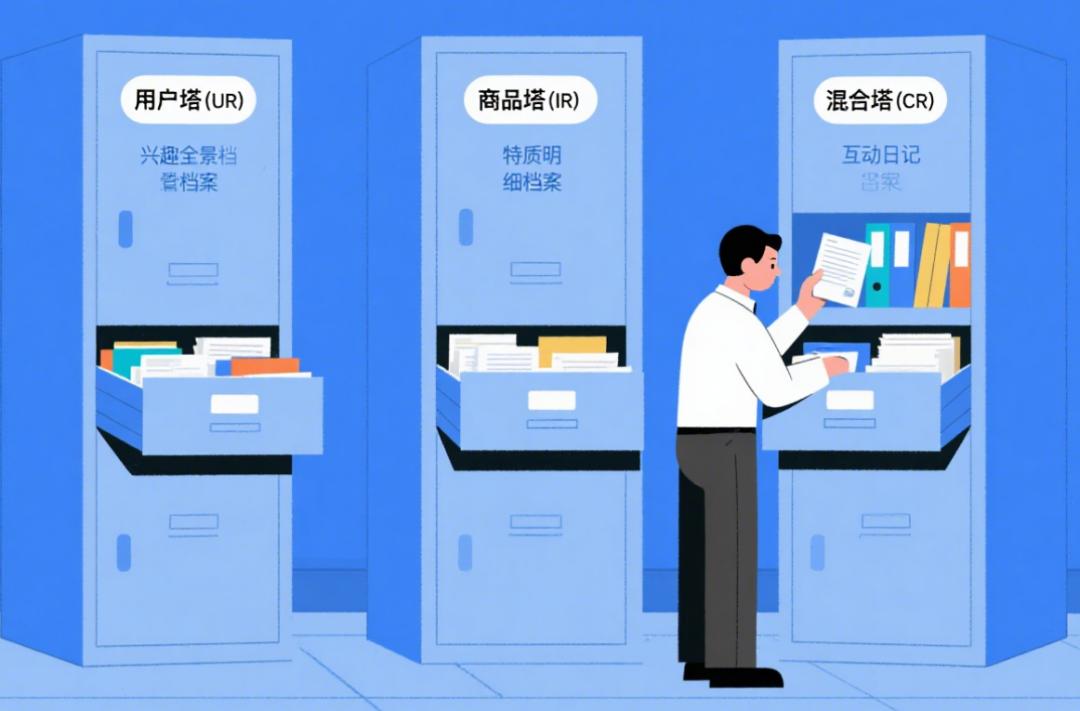
LFM4Ads设计了一个“ triple-tower(三塔)”架构,就像一个“精细的档案管理室”,同时管好三个核心档案:
• 用户塔(UR):给用户建“兴趣全景档案”。不只是记“喜欢户外”,还记“喜欢周末短途徒步、偏好轻量化装备、讨厌笨重帐篷”——相当于把用户的兴趣从“一句话描述”扩展成“一篇详细的爱好日记”。
• 商品塔(IR):给商品建“特质明细档案”。比如帐篷不仅记“防水”,还记“适合1-2人、重量1.2kg、适合零下5度环境”——就像商品的“说明书plus版”,所有细节都不落下。
• 混合塔(CR):记好“用户和商品的互动日记”。比如“用户看了帐篷详情页里的‘轻量化’描述后,停留了10秒”“用户划过了‘重2kg’的帐篷”——这些互动细节被转化成“互动表征”,相当于把“两人聊天的重点”记下来,而不是只记“聊过”。
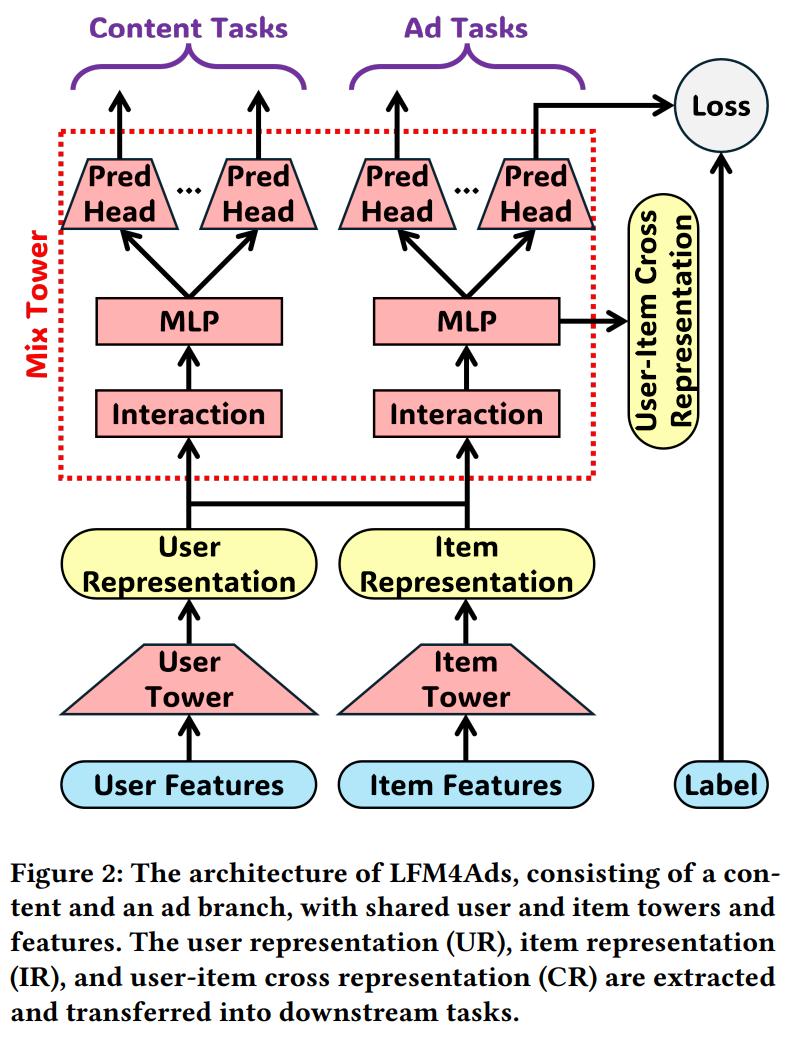
这个设计的巧妙之处在于,它把“人、货、场”的信息都装进去了。就像月老牵线时,不仅知道男方喜欢户外、女方是帐篷卖家,还知道“男方之前对轻量化帐篷感兴趣”,匹配度自然大大提升。
2. 第二板斧:跨表征优化——给“互动日记”做“智能更新”
光记下来“互动表征”还不够,因为用户和商品的互动是实时变化的——比如用户上个月喜欢徒步,这个月改成钓鱼了;商品上个月是新品,这个月成了爆款。如果还用旧数据,模型就会“刻舟求剑”。
LFM4Ads用了一个“时间衰减聚合”的方法,解决了这个问题。你可以把它理解成“朋友圈的动态回忆”:
• 如果你很久没和某个朋友互动(比如半年没聊过),再见面时,你们的聊天重点会更偏向“最近的新鲜事”(旧回忆权重低);
• 如果你昨天刚和朋友聊过徒步,今天再聊时,昨天的话题还能接着聊(旧回忆权重高)。
模型也是这样:对于很久没更新的用户/商品互动,新互动的权重更高,直接“刷新”档案;对于频繁互动的,就把新互动和旧互动“融合”,避免遗漏重要信息。
更关键的是,他们还找对了“提取互动表征的最佳位置”。通过实验发现,从混合塔的“倒数第二层DNN”提取互动表征,效果最好——就像你看一本书,最精华的观点往往在“倒数第二章”,而不是开头的引言或结尾的总结。这个细节看似小,却让模型的精准度提升了一大截。
3. 第三板斧:多粒度转移——像搭乐高一样灵活适配场景
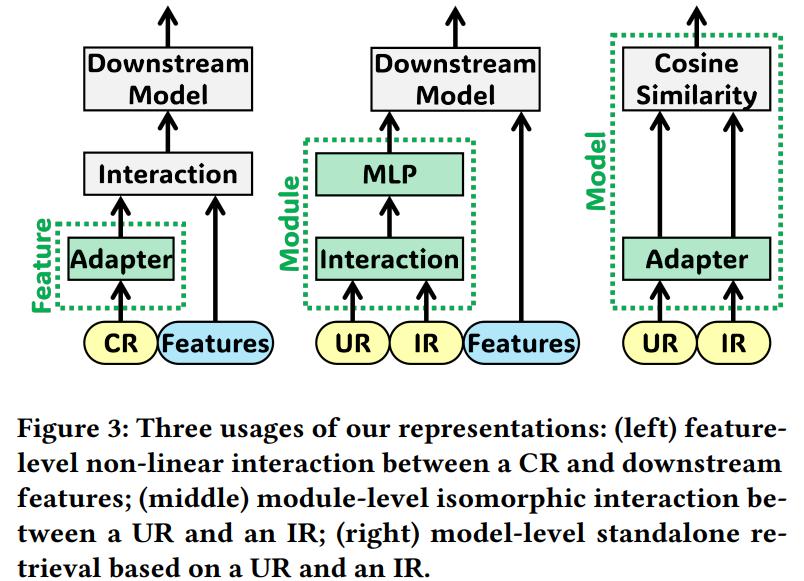
传统模型把“用户表征”当成“一块固定的积木”,不管下游是朋友圈广告还是视频号广告,都直接塞进去。而LFM4Ads把转移方式分成了“三个粒度”,就像乐高积木有“小颗粒、中颗粒、大颗粒”,可以根据场景灵活搭配:
• 特征级转移:给下游模型“加调料”。比如在朋友圈广告场景,把“用户喜欢轻量化帐篷”的互动表征,通过“非线性适配器”(可以理解为“调料配方”)变成“适合朋友圈短文案推荐的轻量化帐篷标签”——就像同样是辣椒,做火锅用火锅底料,做炒菜用干辣椒,适配不同场景的“口味”。
• 模块级转移:给下游模型“送料理包”。直接把LFM4Ads里“计算用户和商品匹配度的模块”(比如混合塔的部分结构)搬到下游模型,只需要微调参数——就像你买了预制菜,不用自己买菜切菜,加热一下就能吃,又快又准。
• 模型级转移:直接“送成品菜”。对于一些简单场景(比如商品检索),不用下游模型再计算,直接用LFM4Ads的用户和商品表征算相似度——就像你饿了不想做饭,直接点外卖,省时省力。
这个设计解决了传统模型“水土不服”的问题,让大模型的能力能在不同场景里“灵活落地”。
4. 在线系统:让 “精准匹配” 实时跑起来
LFM4Ads模型在实际广告场景里 “实时干活” 的系统就像给模型搭了个 “实时操作台”,形成“用户发请求→调数据→用模型→更数据→收反馈” 的闭环。当你触发广告请求时,系统会先从 “数据仓库” 里调出三个关键 “信息包”—— 用户的兴趣档案(UR)、新商品的特质档案(IR)、还有过往互动记录(CR),立刻传给推荐模型帮你匹配广告。等模型用完这些数据,还会把这次互动生成的新 “信息包”(比如你看了帐篷广告 5 秒)放回仓库更新,顺便等着收你后续的反馈:如果点击了,就把 “喜欢这款帐篷” 的信号加进去;如果划走了,就记上 “暂时不感兴趣”,下次调整推荐。
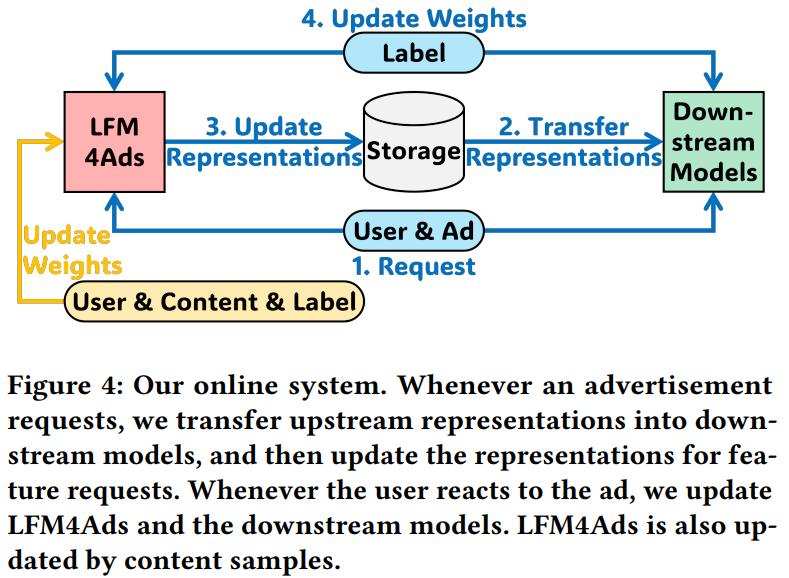
更贴心的是,系统还怕出问题:它会盯着 “信息包” 的状态,一旦数据异常(比如某个表征数值突然跑偏),就立刻暂停更新,还每天存一份 “数据快照”—— 像给数据留了备份,万一出事能马上恢复,不影响你刷广告的流畅度。另外,它还有个 “快速检查” 功能,不用等一周才能判断新数据好不好用,几小时就能出结果,帮模型快速调整,避免一直推 “不准的广告”。
四、落地效果:不只是“精准”,还能赚更多钱
再好的理论,也要用数据说话。LFM4Ads在腾讯的广告平台落地后,交出了一份很亮眼的成绩单:
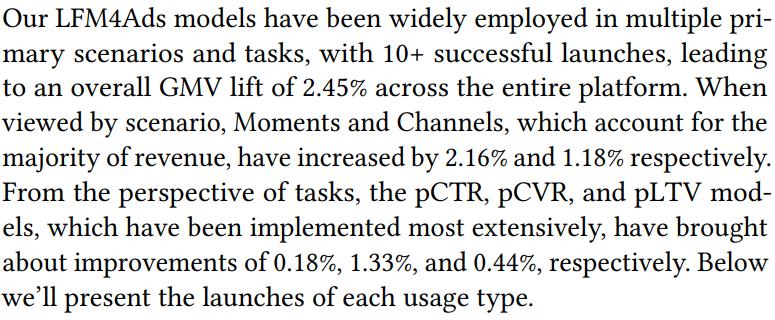
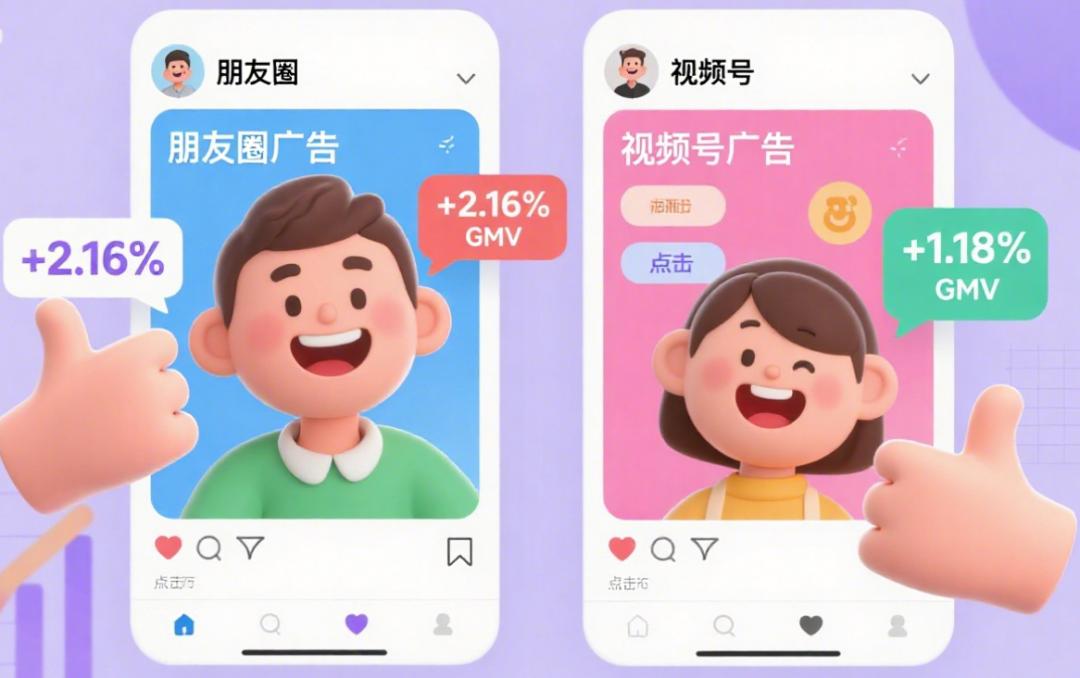
• 整体GMV提升2.45%:别小看这2.45%,腾讯广告平台每天的流水是个天文数字,换算下来,每年能多赚“数亿美元”——这可是真金白银的提升。
• 核心场景表现突出:朋友圈广告(腾讯广告的“现金牛”)GMV提升2.16%,视频号广告提升1.18%。要知道,朋友圈广告的推荐模型已经很成熟了,能再提升2%以上,难度非常大。
• 用户体验也变好了:在视频号的5% A/B测试里,虽然GMV没明显变化,但用户的点击率(CTR)提升1.83%,点击转化率(CTCTR)提升3.34%,“快速划走”(用户不满的信号)减少0.36%——这说明用户看到的广告更对胃口了,不是“为了推而推”。
我特别关注了他们对“冷启动商品”的优化效果:新商品的推荐精准度提升了不少,这对中小商家来说是个好消息——以前新商品只能靠“砸钱投流”,现在靠模型就能精准触达潜在用户,成本降了,效果还升了。
五、未来在哪?不只是广告,更是“推荐系统的新范式”
LFM4Ads的价值,不只是让广告更精准。在我看来,它其实提供了一种“大模型做推荐”的新思路:
• 跨域融合:把内容域(比如你看的视频、文章)和广告域的数据结合起来——就像你通过一个人的朋友圈内容,能更懂他的兴趣,而不只是他买过什么。这种融合能让模型的“视野更宽”。
• 细粒度表征:不再把用户和商品当成“简单标签”,而是用更细的粒度记录他们的特征和互动——就像你认识一个人,不仅知道他的职业,还知道他的爱好、习惯、甚至小洁癖,这样推荐自然更贴心。
当然,它也有需要改进的地方。比如模型的参数有4TB,部署成本很高,小公司很难复刻;而且对于“极端小众兴趣”(比如喜欢收藏老式相机的用户),模型还是容易“猜不准”。但这些都是技术发展中难免的问题,方向是对的。
六、广告推荐的未来,不是 “更精准”,而是 “更懂你”
读完这篇论文,我最大的感受是:广告推荐的竞争,已经从 “谁能抓准用户当下的需求”,升级到 “谁能更全面、更灵活地理解用户和商品的关系”。
LFM4Ads的核心不是 “发明了新技术”,而是 “补全了过去的漏洞”—— 它让模型不再只盯着 “用户是谁”,而是同时关注 “商品是什么” 和 “两者合不合拍”;不再只会 “硬套公式”,而是学会了 “灵活调整”;不再局限于 “广告数据”,而是拉上 “内容数据” 一起提升。
对我们普通用户来说,这意味着什么?未来的广告可能会更少 “打扰”,更多 “及时”—— 比如你刚想给猫换粮,广告就推过来;你买完笔记本,就不会再被反复推送同款。而对行业来说,LFM4Ads 的思路提供了一个重要方向:大模型在推荐领域的价值,不是 “替代传统模型”,而是 “整合更多信息、提升迁移能力”,让推荐系统从 “偏科生” 变成 “全科生”。
当然,它也有需要改进的地方 —— 比如 4TB 的参数对中小公司来说还是太大,跨域数据的隐私保护也需要更细致的设计。但不可否认,这是一篇 “既懂技术,又懂业务” 的好论文,值得推荐领域的研究者和工程师参考。
最后想问问你:你有没有遇到过 “精准到可怕” 或 “离谱到搞笑” 的广告?欢迎在评论区分享,或许我们能从 LFM4Ads 的思路里,找到背后的原因~
参考资料
• 标题:Large Foundation Model for Ads Recommendation
• 作者:Shangyu Zhang, Shijie Quan, Zhongren Wang, Junwei Pan, Tianqu Zhuang, Bo Fu, Yilong Sun, Jieying Lin, Jushuo Chen, Xiaotian Li, Zhixiang Feng, Xian Hu, Huiting Deng, Hua Lu, Jinpeng Wang, Boqi Dai, Xiaoyu Chen, Bin Hu, Lili Huang, Yanwen Wu, Yeshou Cai, Qi Zhou, Huang Tang, Chunfeng Yang, Chengguo Yin, Tingyu Jiang, Lifeng Wang, Shudong Huang, Dapeng Liu, Lei Xiao, Haijie Gu, Shu-Tao Xia, Jie Jiang
• 单位:腾讯;清华大学
• 链接:https://arxiv.org/pdf/2508.14948