精|9B开源模型榜一:阿里Ovis2.5重塑视觉语言模型(VLM)
在多模态大语言模型(MLLMs)领域,“看清楚”与“想明白”始终是两大核心难题——处理高分辨率复杂图表时,固定尺寸切片会破坏全局结构与细节;面对逻辑密集型任务时,线性思维链难以实现自我修正。2025年8月,阿里巴巴集团Ovis团队发布的Ovis2.5模型,通过两项关键技术创新,在这两大痛点上实现了突破,不仅在OpenCompass基准测试中创下子400亿参数开源模型的最佳成绩,更让小参数模型(2B)具备了“小模型、大性能”的落地潜力。本文将从技术原理到性能验证,系统解读这一多模态模型的创新路径。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
一、多模态模型的现存痛点:为何“看”与“想”难以兼顾?
在Ovis2.5之前,主流多模态模型的架构多采用“视觉Transformer(ViT)+语言模型(LLM)+MLP投影层”的组合,但研究员们发现,这种架构存在两大核心局限:
其一,视觉感知的“刚性瓶颈”。传统ViT需将图像压缩至固定分辨率(如512×512),或通过切片(Tiling)处理大尺寸图像——这会导致两类问题:复杂图表中的细微数据(如表格单元格、折线图拐点)丢失,同时全局布局(如多子图的逻辑关联)被割裂。例如,在分析包含多个子图表的财报时,切片会将同一逻辑组的子图拆分,导致模型无法理解数据间的关联。
其二,推理能力的“线性局限”。多数模型依赖线性思维链(CoT)进行推理,缺乏“自我检查-修正”的反思机制。在STEM领域(如几何证明、物理公式推导),一旦中间步骤出错,后续推理会完全偏离方向,且模型无法自主发现错误。例如,在求解光学折射问题时,若模型误判入射角与折射角的关系,后续计算将全部失效,且无法回溯修正。
正是针对这两大痛点,Ovis团队在Ovis2.5中提出了全新的技术方案——原生分辨率视觉编码与深度反思推理,同时通过优化训练架构实现了效率与性能的平衡。
二、核心技术创新:从“感知”到“推理”的双重突破
Ovis2.5的技术创新集中在四大维度,分别解决“看清楚”“想明白”“学得好”“跑得顺”的问题,形成了完整的技术闭环。
2.1 原生分辨率视觉编码:让模型“看见”细节与全局
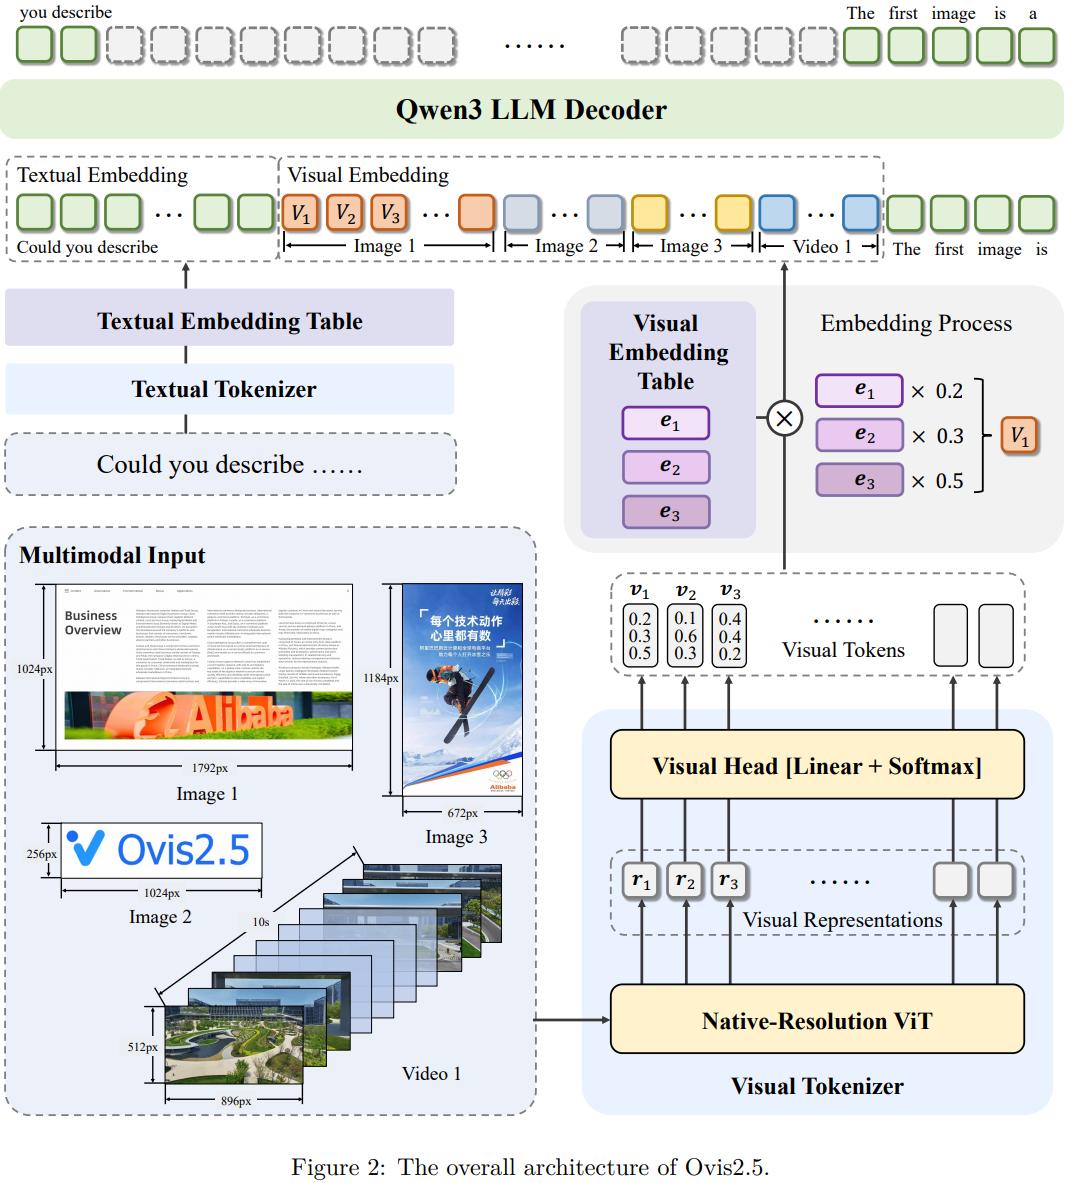
为解决固定分辨率的局限,Ovis2.5引入了原生分辨率ViT(NaViT),替代传统固定尺寸ViT。其核心原理是:不强制图像压缩或切片,而是直接以图像的原生分辨率(如1184px×1792px)进行处理,同时通过以下设计保障空间感知能力:
• Rotary Position Embedding(RoPE)嵌入:在每个ViT块中加入RoPE,强化模型对像素空间位置的感知。对于高分辨率图像(如3.2M像素的复杂图表),RoPE能精准捕捉像素间的相对位置关系,避免因分辨率变化导致的空间信息丢失。
• 动态分辨率适配:支持448²~1792²像素的动态输入范围,覆盖从普通图片到超高清图表的场景。例如,处理A3尺寸的工程图纸时,无需压缩即可保留所有标注文字与线条细节。
研究员们通过实验验证,NaViT在ChartQA Pro(复杂图表分析基准)中,相比传统ViT将细节识别准确率提升了18%,尤其在包含多层数据的热力图、嵌套表格的解读中表现突出。
2.2 深度反思推理:让模型“学会”自我修正
为突破线性推理的局限,Ovis2.5设计了可选“思考模式”,其核心是通过训练数据注入“反思机制”,让模型在推理时生成中间检查步骤:
• 反思数据构建:采用“LLM合成+人工验证”的方式,生成包含...<|FunctionCallEnd|>标签的反思型数据。例如,在求解数学题时,数据不仅包含“解题步骤+答案”,还加入“步骤检查点”——如“第一步需确认勾股定理适用条件,当前三角形为直角三角形,符合条件”“第二步计算时需注意单位换算,此处厘米需转换为米”。
• 推理时的模式切换:用户可根据任务复杂度选择是否启用“思考模式”:处理简单任务(如图片描述)时关闭模式以降低延迟;处理复杂任务(如STEM解题、图表分析)时启用模式,模型会自动生成反思步骤,修正中间错误。
以几何题“同心圆圆周角计算”为例,启用“思考模式”后,模型会先检查“泰勒斯定理是否适用”(确认直径对应的圆周角为直角),再验证“切线与半径的垂直关系”,最后核对计算过程中的公式代入,避免因定理误用导致的错误。在MathVista基准测试中,Ovis2.5-9B启用“思考模式”后,数学推理准确率提升了12.3%。
2.3 五阶段训练Curriculum:循序渐进构建能力
为让模型系统性掌握“感知-推理”能力,Ovis2.5设计了五阶段训练体系,从基础能力到高阶推理逐步递进,避免训练过程中的能力失衡:
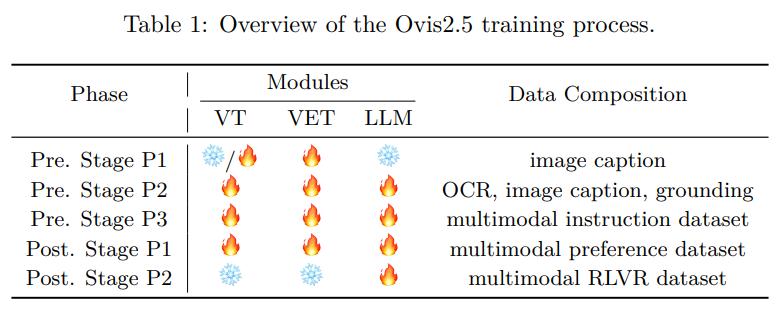
其中,视觉嵌入表(VET) 是Ovis系列的核心设计:类比LLM的文本嵌入表,VET为每个“视觉词”(图像 patch 的离散表征)分配专属嵌入,解决了传统MLP投影层导致的“视觉-文本模态结构不匹配”问题。研究员们验证,VET使视觉特征与文本特征的相似度提升了25%,显著改善跨模态理解能力。
2.4 高效训练基础设施:3-4倍速度提升的关键
为支撑大规模多模态数据训练(涵盖图像、视频、文本等),Ovis团队设计了多模态数据打包+混合并行框架,解决了训练中的“负载失衡”与“内存瓶颈”:
• 多模态数据打包:将短样本(如单句OCR指令)组合成 longer sequence,减少批量训练中的padding比例。例如,将5条短OCR任务指令打包为1条长序列,GPU计算效率提升40%,同时避免因padding导致的无效计算。
• 混合并行框架:基于Megatron实现“数据并行(DP)+张量并行(TP)+上下文并行(CP)”的组合:DP负责样本分发,TP拆分模型参数以降低单卡内存压力,CP处理长序列输入的上下文拆分。该框架使Ovis2.5-9B的训练内存占用降低50%,端到端训练速度提升3-4倍。
三、性能验证:开源模型中的“全能选手”
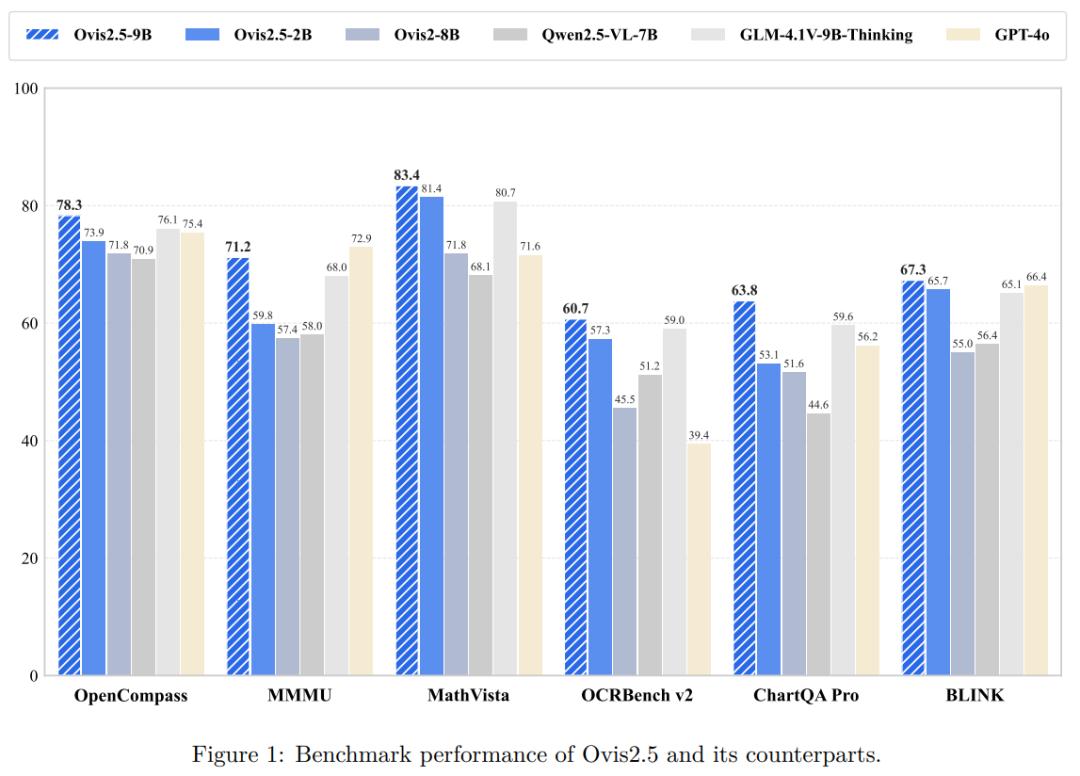
Ovis团队在OpenCompass、MMMU、ChartQA Pro等15+基准测试中对Ovis2.5进行了全面验证,结果显示其在同参数规模开源模型中表现突出,部分指标接近闭源模型(如GPT-4o、Gemini-2.5-Pro)。
3.1 综合性能:40B以下参数开源模型第一
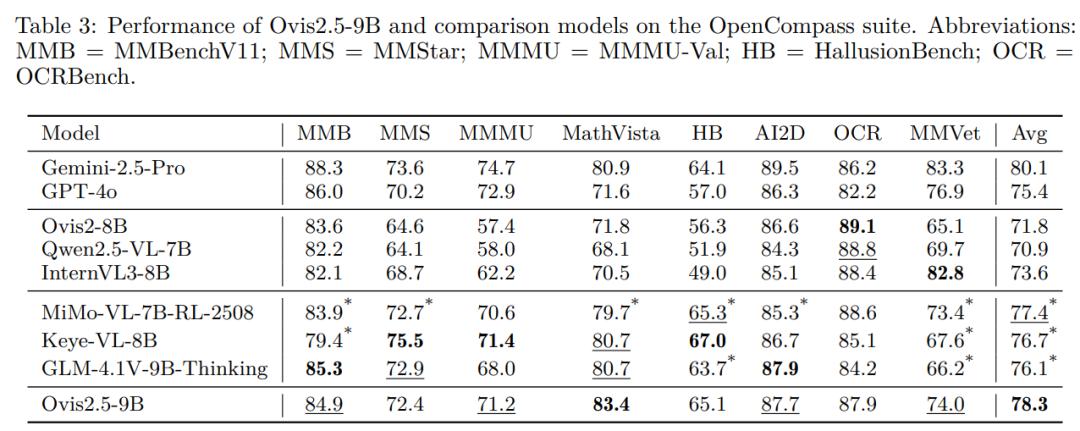
在OpenCompass多模态基准(涵盖MMBench、MMStar、MathVista等8项任务)中:
• Ovis2.5-9B以78.3的平均得分,超越前代Ovis2-8B(71.8),同时领先同规模开源模型(如Qwen2.5-VL-7B的70.9、GLM-4.1V-9B-Thinking的76.1),成为子40B参数开源模型的新标杆。
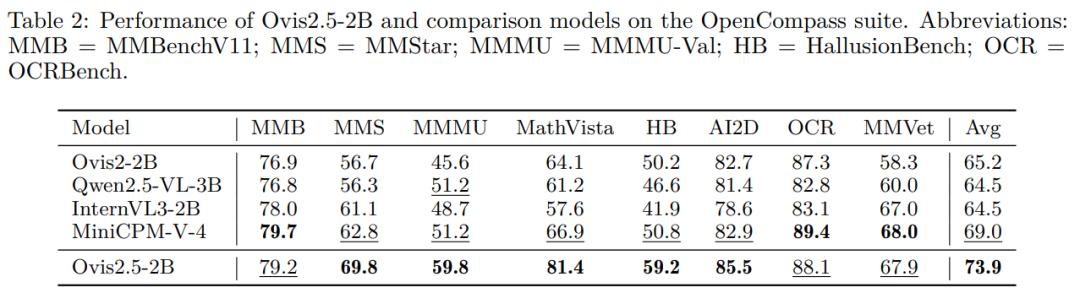
• Ovis2.5-2B以73.9的得分,在2B参数量级模型中创下最佳成绩,延续了Ovis系列“小模型、大性能”的定位,适用于边缘设备(如工业平板、智能终端)的本地化部署。
3.2 专项能力:STEM与图表分析的突破
在细分领域测试中,Ovis2.5展现出显著优势:
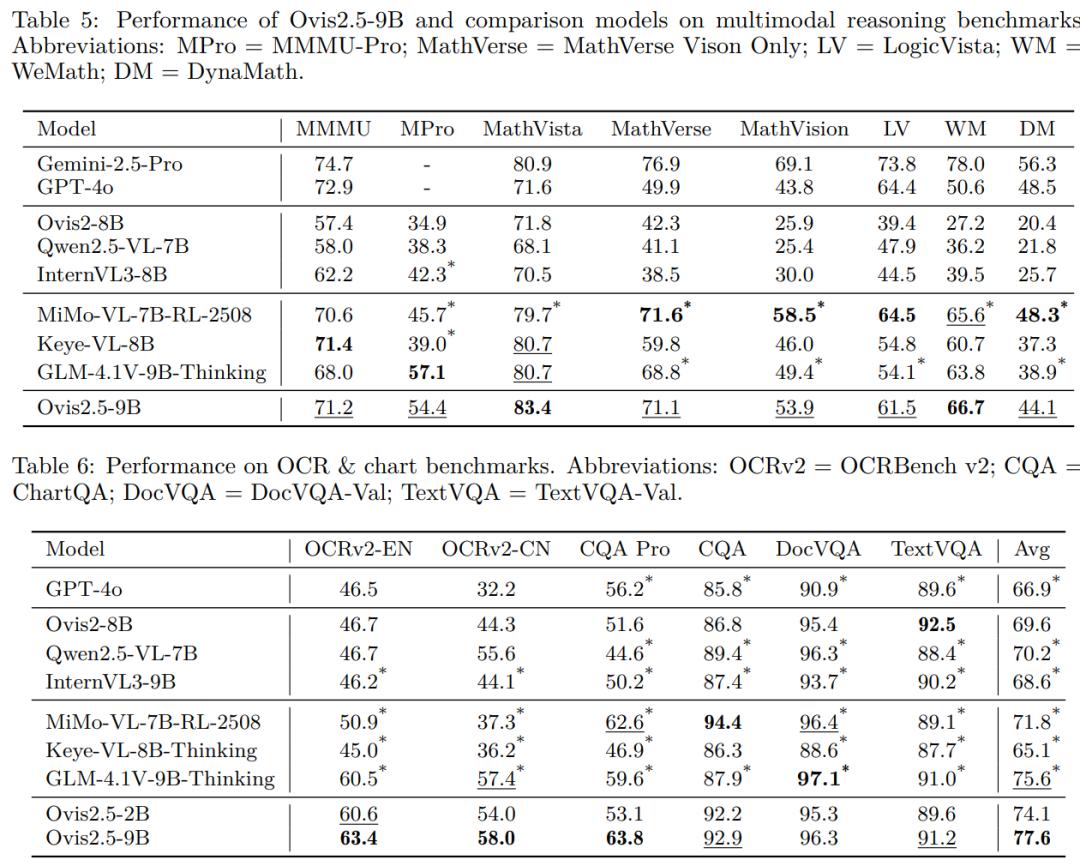
• STEM领域:在MMMU(多学科推理)中,Ovis2.5-9B得分71.2,超越Keye-VL-8B(71.4)与GLM-4.1V-9B-Thinking(68.0);在MathVista(视觉数学)中得分83.4,领先所有开源模型,接近Gemini-2.5-Pro(80.9)。
• 图表与OCR:在ChartQA Pro(复杂图表)中得分63.8,超越GPT-4o(56.2);在OCRBench v2(双语OCR)中,中英文识别准确率分别达63.4%与58.0,领先开源模型平均水平10%以上。
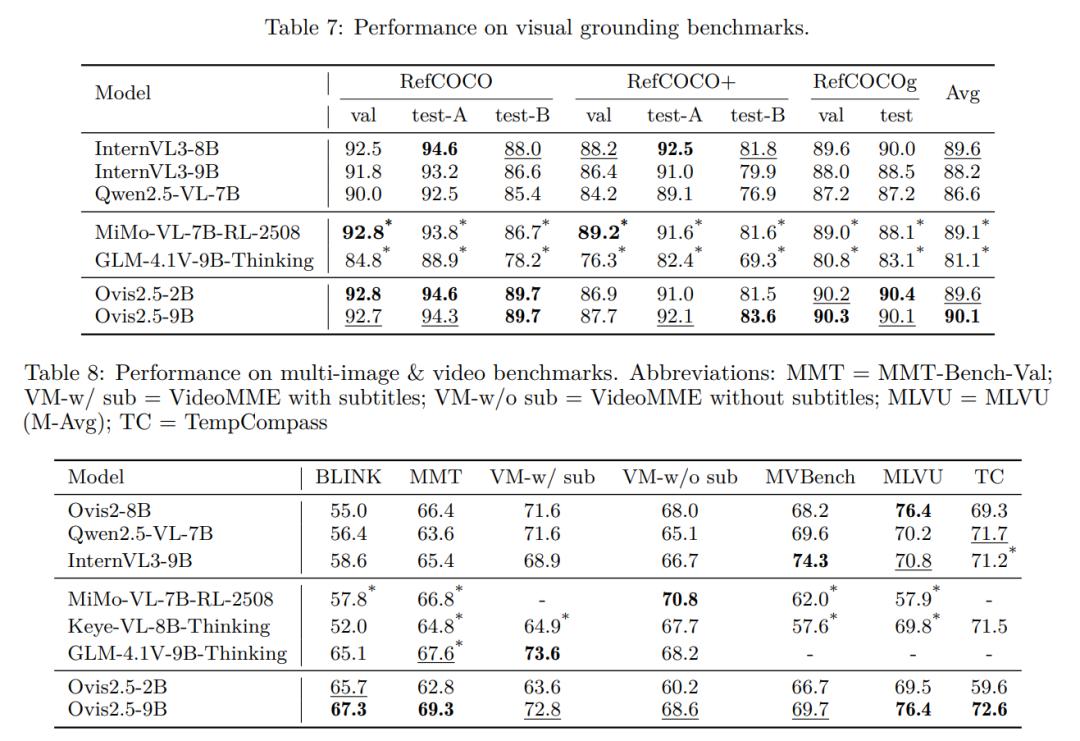
• 视觉Grounding:在RefCOCO系列(目标定位)中,平均得分90.1,在RefCOCOg(复杂描述定位)中表现尤为突出,超越InternVL3-8B(89.6),证明其精准的视觉-语言关联能力。
四、总结与展望:多模态模型的下一站?
Ovis2.5的发布,为多模态模型的发展提供了三个关键启示:其一,原生分辨率感知是解决复杂视觉任务的核心方向;其二,反思型推理机制是提升模型可靠性的关键;其三,小参数模型通过高效训练架构,可在边缘场景实现“性能不妥协”。
不过,研究员们也指出了未来的探索方向:一是将视觉分辨率提升至4K级别,以适应卫星图像、显微图像等超高清场景;二是强化长视频推理能力,解决当前模型对超过10分钟视频的时序信息丢失问题;三是融合工具使用能力,让模型通过调用计算器、图表生成工具等,进一步提升复杂任务的处理精度。
随着Ovis2.5-9B与Ovis2.5-2B的开源(可在Hugging Face与GitHub获取),多模态模型的技术门槛进一步降低,有望在工业质检、智能医疗、教育辅助等领域催生更多落地应用。
参考资料
• 标题:Ovis2.5 Technical Report
• 作者:Shiyin Lu, Yang Li, Yu Xia, Yuwei Hu, Shanshan Zhao, Yanqing Ma, Zhichao Wei, Yinglun Li, Lunhao Duan, Jianshan Zhao, Yuxuan Han, Haijun Li, Wanying Chen, Junke Tang, Chengkun Hou, Zhixing Du, Tianli Zhou, Wenjie Zhang, Huping Ding, Jiahe Li, Wen Li, Gui Hu, Yiliang Gu, Siran Yang, Jiamang Wang, Hailong Sun, Yibo Wang, Hui Sun, Jinlong Huang, Yuping He, Shengze Shi, Weihong Zhang, Guodong Zheng, Junpeng Jiang, Sensen Gao, Yi-Feng Wu, Sijia Chen, Yuhui Chen, Qing-Guo Chen, Zhao Xu, Weihua Luo, Kaifu Zhang
• 单位:Alibaba Group
• 链接:https://arxiv.org/pdf/2508.11737v1s