国科大+美团+中大+港科大InfiniteTalk:破解面瘫突破长配音视频
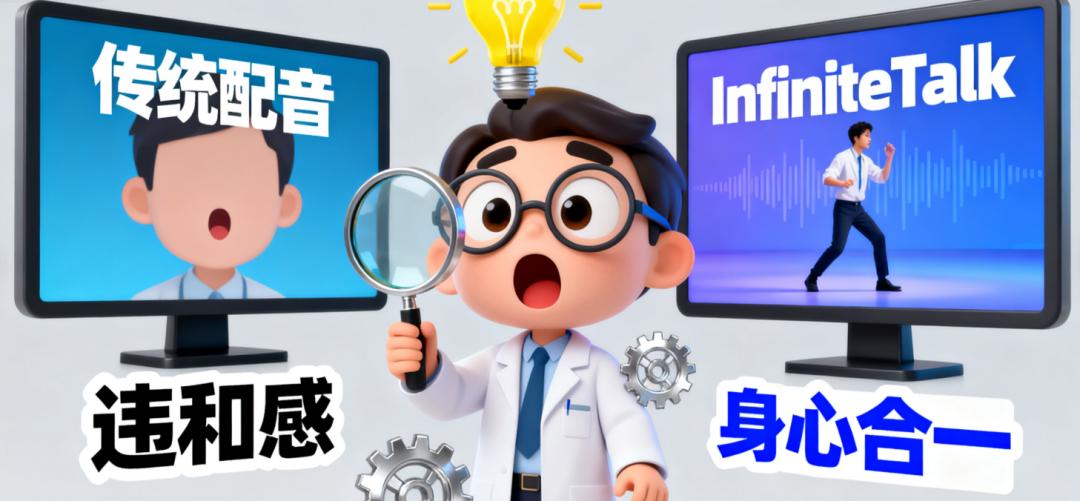
你有没有过这种体验?看国外电影的中文配音版时,明明听到的是“我太激动了!”,但屏幕里的演员嘴角只象征性动了动,眼神没波澜,手还僵在一边——像个只会动嘴的提线木偶,违和感直接拉满。更别说长视频了,有的配音看到后半段,演员脸都跟开头有点不一样了,这到底是为什么?
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
我上周翻到一篇叫《InfiniteTalk》的论文时,突然有种“终于有人把这层窗户纸捅破了”的兴奋。它没纠结“怎么把嘴型对得更准”,而是直接重构了视频配音的逻辑——原来好的配音,不只是“嘴对得上”,更要“表情、动作、情绪都跟声音搭”。这篇文章就带你看懂,这个能让视频“活过来”的技术,到底是怎么做到的。
一、视频配音的“老大难”:我们一直只解决了“半个问题”
先搞明白一个事:视频配音不是“改嘴型”这么简单。你想啊,人说话时,身体是“全身上下一起配合”的——开心时会抬手、皱眉,生气时会前倾身体、瞪眼,就连普通聊天,头也会跟着语气轻轻晃动。
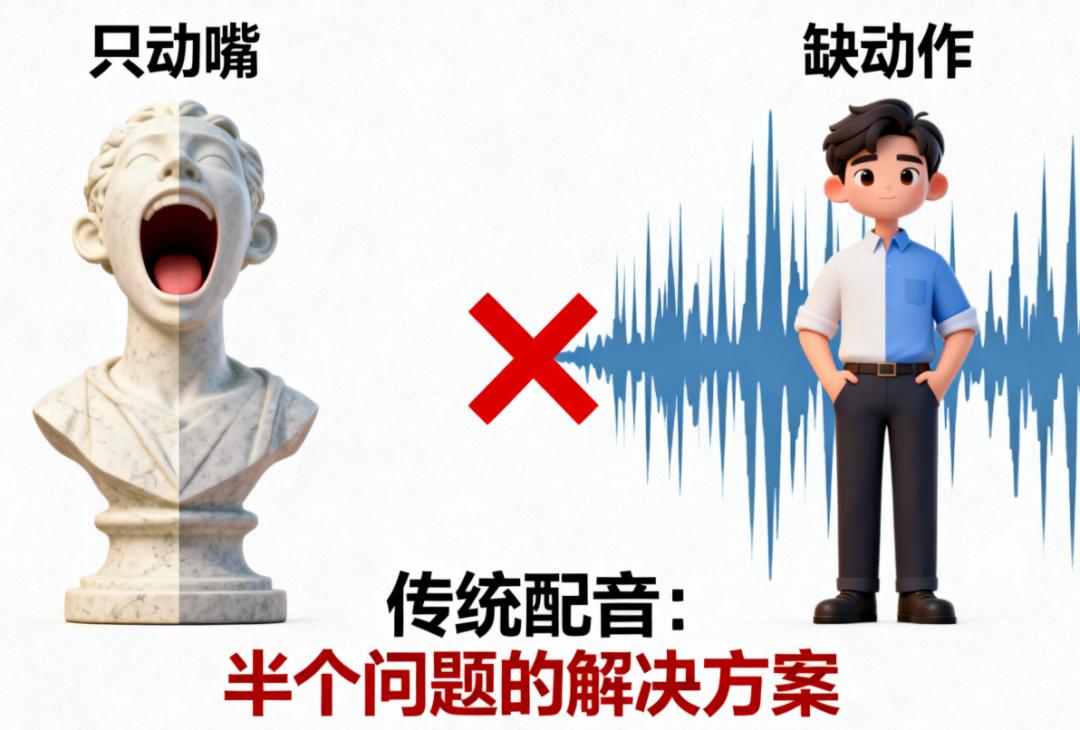
但过去的视频配音技术,说白了就是“只动嘴,不动身”。就像给人化妆时,只涂了嘴唇,其他地方全不动。比如你有一段视频,原来说的是“今天天气不错”,现在要改成“我中了大奖!”。传统技术只会把演员的嘴型改成“中大奖”的样子,但表情还是“天气不错”的平淡,手也还是插在兜里没动作。
这就导致了我们看译制片时的“违和感”:声音在喊“我要冲了!”,身体却在“原地散步”。更麻烦的是长视频——比如一部1小时的纪录片配音,传统技术越往后做,越容易“走样”:演员的脸可能慢慢变圆,背景颜色也悄悄偏色,最后变成“越看越不对劲”。
为什么会这样?因为传统技术要么“太自由”,要么“太死板”,没找到中间的平衡点。
二、传统方案的死穴:要么“跑偏”,要么“死板”
我试过两种主流的传统方法,它们的问题特别典型,就像两个极端的“学生”:
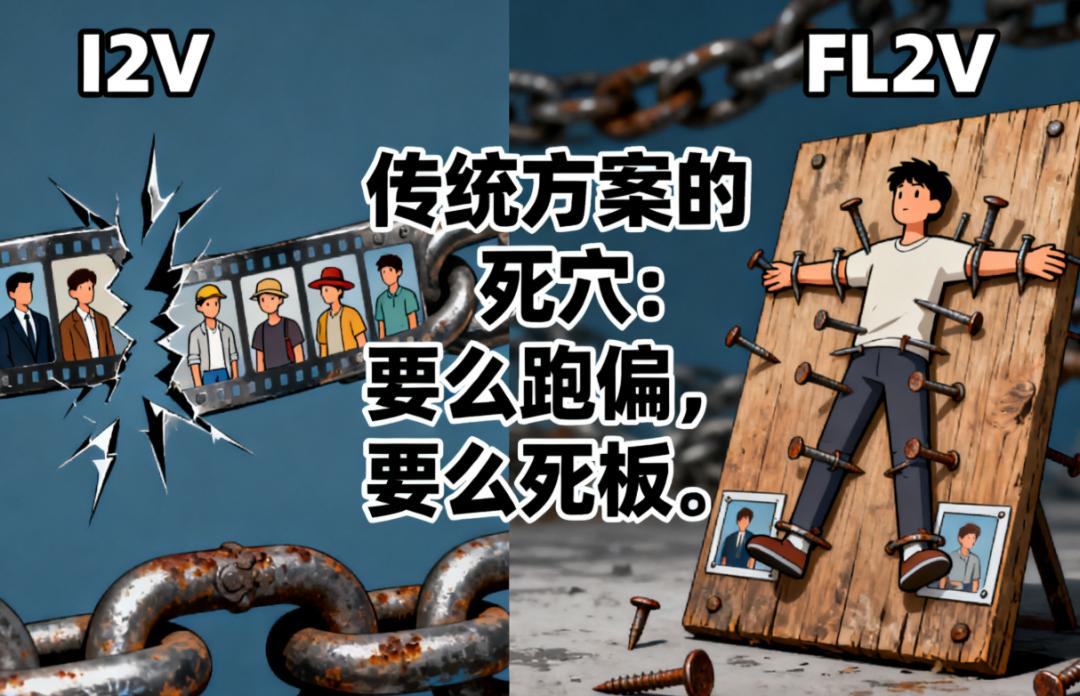
1. “自由散漫型”:越跑越偏的“连环画画家”
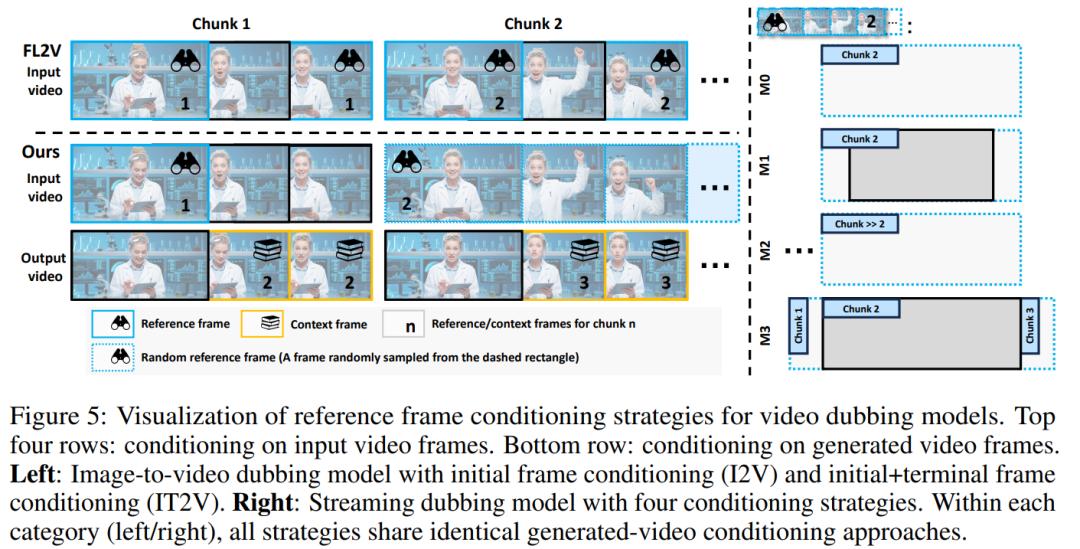
第一种叫“图像到视频”(I2V),原理很像画连环画:先定一个“开头帧”(比如视频第一秒的画面),然后顺着这个帧往下画。但它有个大问题——画着画着就“跑偏”了。
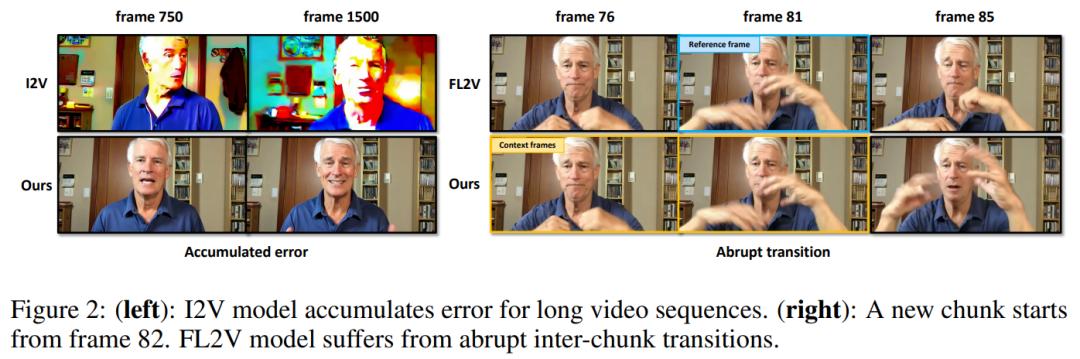
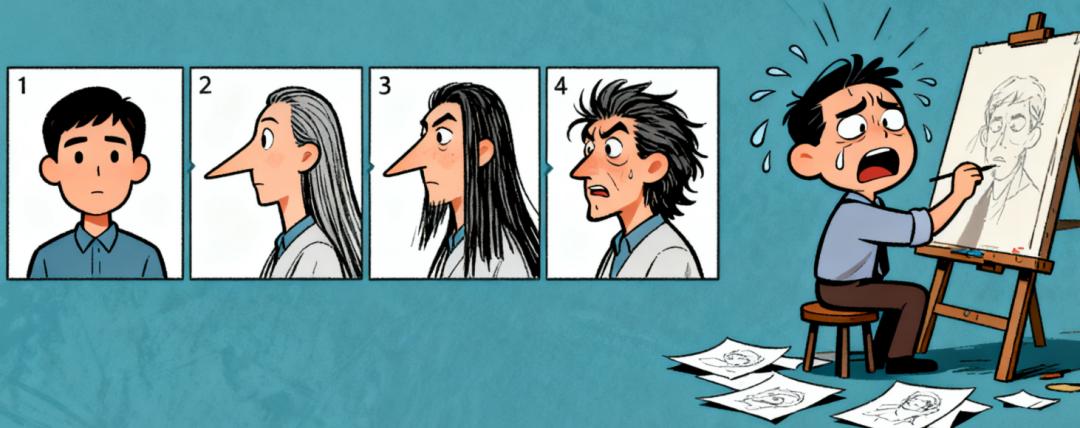
比如你要配一段5分钟的视频,I2V只看前一帧画后一帧,就像一个画家画连环画时,只看前一页画下一页,不回头看开头的人物。画到第3分钟,可能人物的鼻子变尖了,画到第5分钟,背景里的窗户都歪了。这就是“积累误差”——小错误越积越多,最后彻底走样。
2. “死板教条型”:只会“按剧本卡点”的舞者
另一种叫“首尾帧到视频”(FL2V),为了避免“跑偏”,它会定死“开头帧”和“结尾帧”,中间的画面必须“卡着这两个帧来做”。比如一段10秒的视频,开头是“抬手”,结尾是“放下手”,FL2V就会严格让中间的动作“从抬手到放手”,一点不差。
但这又会导致新问题:太死板。如果声音里的情绪是“突然兴奋”,需要中间加一个“拍手”的动作,FL2V也做不到——因为它要“卡着首尾帧”,不能多做一个动作。就像一个舞者,只会按固定的舞步跳,不管音乐变奏,跳出来的动作和音乐完全不搭。
更要命的是,这两种方法都有“断层感”。比如把1小时的视频分成6个10分钟的“片段”来做,每个片段衔接的地方会很生硬——前一个片段结尾是“抬头”,后一个片段开头突然“低头”,像卡了一下的动画片。
这时候我就想:能不能有个方法,既不跑偏,又不死板,让动作跟着声音“自然配合”?《InfiniteTalk》的思路,就是解决这个问题。
三、InfiniteTalk的破局:像“好导演”导戏,既抓关键,又给自由
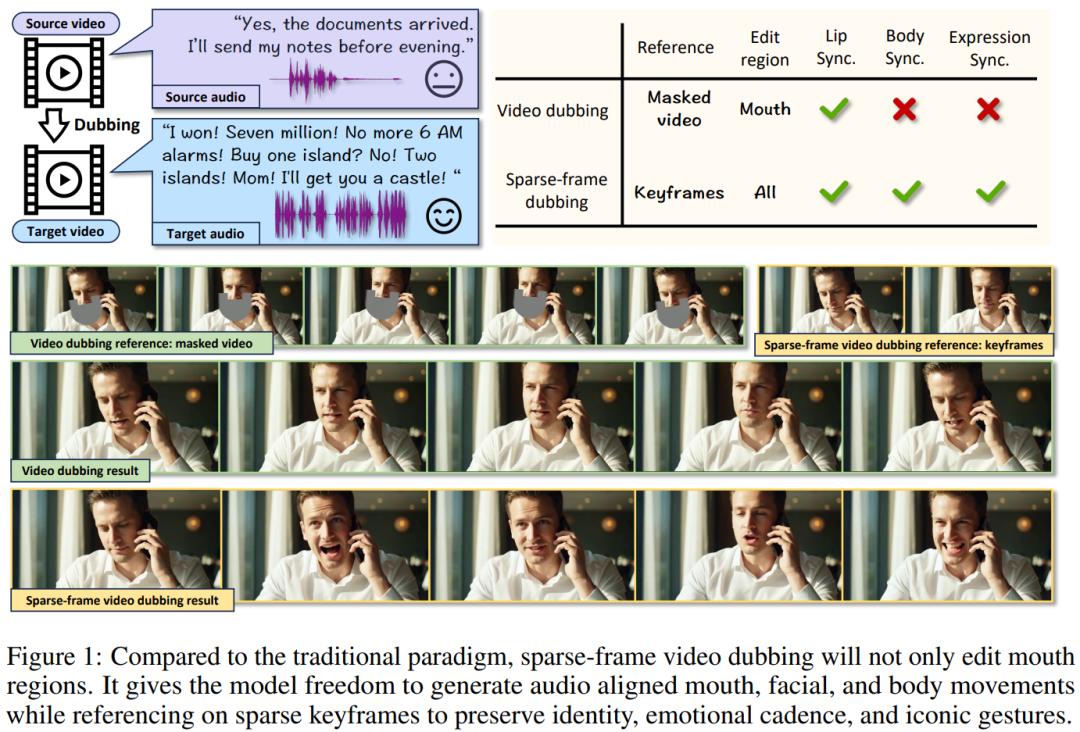
这篇论文最让我眼前一亮的,是它提出了一个全新的思路——“稀疏帧配音”。简单说,就是不盯着每一秒的画面改,而是先选几个“关键帧”(比如视频里“抬手”“笑”“低头”这些重要动作的画面),然后让模型“围绕关键帧,跟着声音自由发挥”。
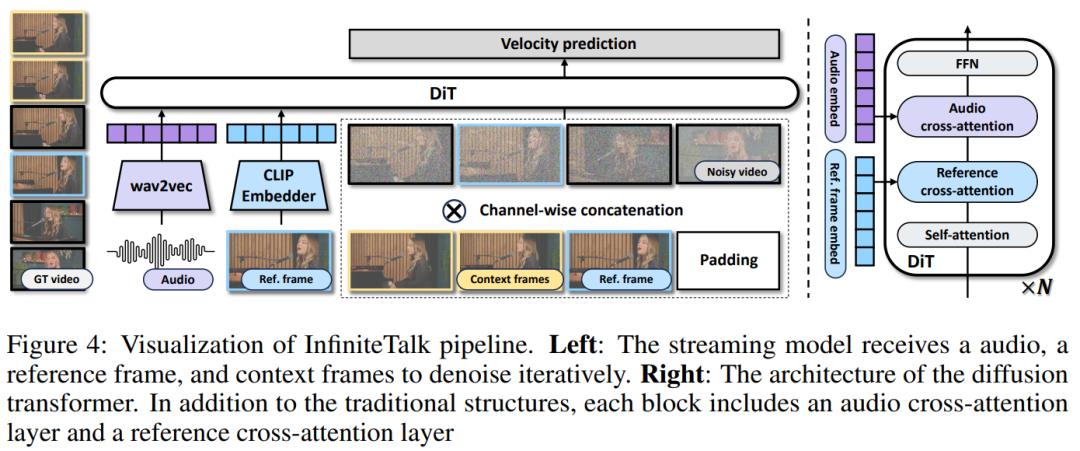
这就像一个好导演拍电影:不会让演员每一秒都按剧本动,而是先定好“关键动作”(比如“这里要哭”“这里要跑”),然后让演员根据情绪自由发挥细节。这样拍出来的戏,既不会跑偏(关键动作对了),又自然(细节有变化)。
具体来说,InfiniteTalk靠三个“巧设计”,解决了传统方法的问题:
1. 选“关键帧”:给模型一个“不会跑偏的锚”
首先,它会从原视频里选几个“关键帧”——不是越多越好,而是“少而精”,比如1分钟的视频选5个关键帧,涵盖“开头表情”“中间动作”“结尾姿势”。这些关键帧就像“锚”,把模型固定住:不管怎么生成画面,都不能离关键帧太远。
比如原视频里演员是“短发、穿蓝色衣服”,关键帧里就包含这些信息。模型生成时,就算做动作,也不会把“短发”变成“长发”,“蓝衣服”变成“红衣服”。这就解决了传统I2V“越跑越偏”的问题。
你可以把它想成“拍照留念”:你去旅游时,不会每一秒都拍照,但会在“山顶”“湖边”“门口”这些关键地点拍几张。就算过后回忆,也能通过这几张照片,想起自己当时的样子和场景——关键帧就是模型的“旅游照片”,帮它记住“不能变的核心信息”。
2. 加“上下文帧”:让动作像“接力赛”一样流畅
解决了“跑偏”,还要解决“断层”。InfiniteTalk的办法是加“上下文帧”——简单说,就是生成下一个片段时,先看前一个片段的“最后几帧”。
比如你要生成第11-20秒的片段,传统方法只会看“第10秒的帧”,而InfiniteTalk会看“第7-10秒的4帧”。这就像接力赛跑时,接棒的人会提前看前一个人的跑步姿势,顺着这个姿势接棒,不会突然停住或变向。
我之前做实验时,最头疼的就是“片段衔接”——前一个片段结尾是“手举到一半”,后一个片段开头突然“手放下”,看起来很卡。但加了上下文帧后,模型会知道“手还在举的过程中”,接下来的动作会顺着这个“惯性”走,衔接处就像“水流一样顺”。
3. “软控制”:让模型像“聪明的老师”,松紧有度
这是最核心的创新点——传统方法要么“全控制”(FL2V,必须按关键帧来),要么“不控制”(I2V,自由发挥),而InfiniteTalk做到了“软控制”:根据情况调整“控制力度”。
怎么理解?就像老师管学生:如果学生很乖,知道按要求做,老师就少管一点,让学生自由发挥;如果学生调皮,快偏离要求了,老师就多管一点,把他拉回来。
InfiniteTalk的“软控制”也是这个逻辑:
• 如果当前要生成的动作,和关键帧里的动作很像(比如关键帧是“微笑”,当前要生成“大笑”),模型就“松一点”,自由调整表情细节;
• 如果当前动作和关键帧差得远(比如关键帧是“坐着”,当前要生成“站起来”),模型就“紧一点”,确保身份、背景不变,只改动作。
这就解决了“死板”的问题:比如声音是“我太开心了,跳起来了!”,关键帧是“坐着”,模型会在“保持坐着的关键信息(比如背景、衣服)”的前提下,生成“站起来跳”的动作,而不是像FL2V那样“必须坐着不动”。
四、真的好用吗?数据和“肉眼”都认账
说再多原理,不如看实际效果。这篇论文做了三个数据集的测试,还找了17个人做“主观评价”,结果很直观:
1. 定量数据:“流畅度”和“同步度”都赢了
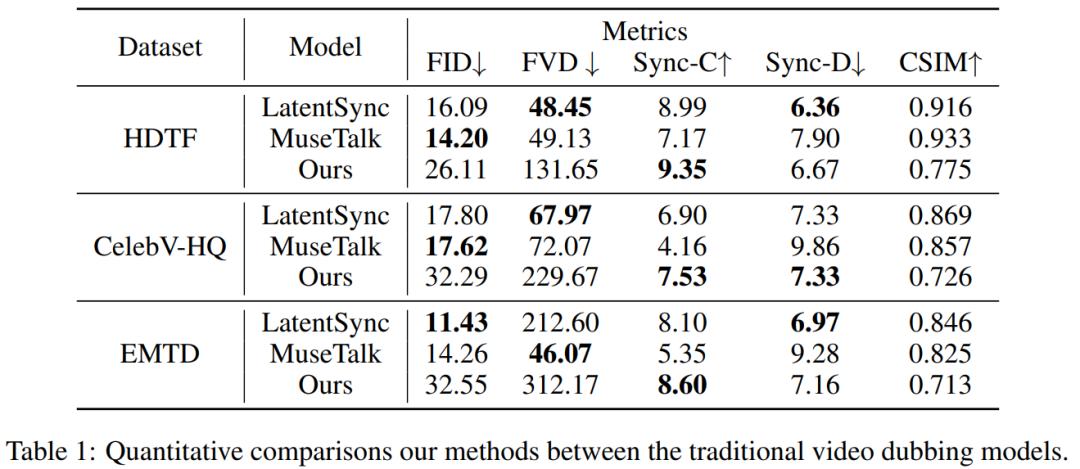
文章测了几个关键指标(我翻译成大白话):
• 画面清晰度(FID):虽然比传统只改嘴型的方法略低一点,但比其他“全身体动”的方法好——意思是“动作变自然了,画面还没糊”;
• 动作流畅度(FVD):比传统方法低很多——说明“片段衔接不卡了,动作更顺了”;
• 嘴型同步度(Sync-C/Sync-D):比所有方法都高——意思是“嘴型对得准,还不影响身体动作”。
简单说:InfiniteTalk做到了“嘴型准、动作顺、画面清”,这是之前没有技术能同时做到的。
2. 人类评价:“看着最舒服”的就是它
他们找了17个人,给三个技术的结果打分(1分最好,3分最差):
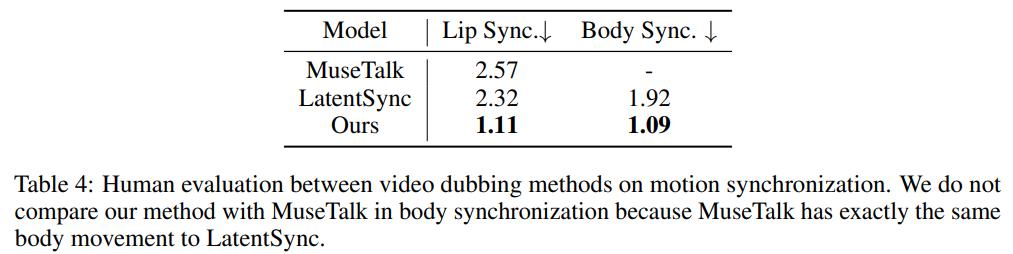
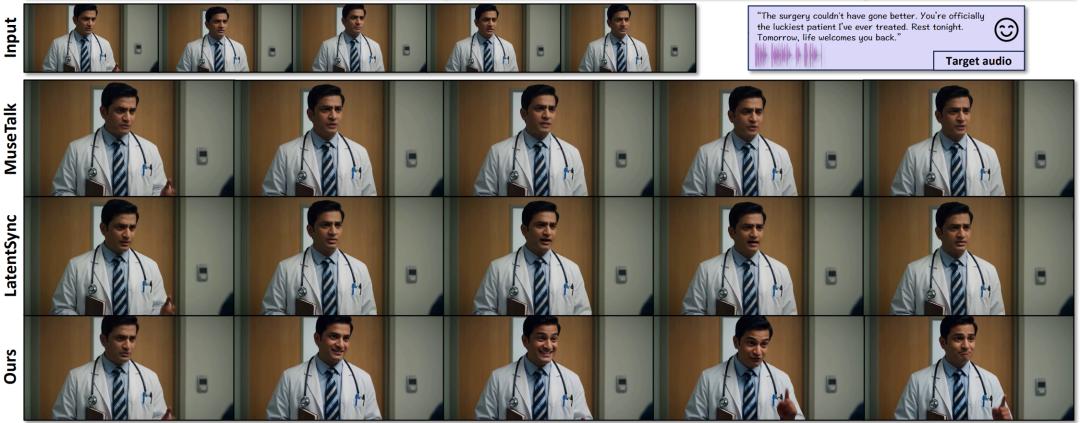
• 嘴型同步:InfiniteTalk是1.11分,传统方法是2.32分;
• 身体同步:InfiniteTalk是1.09分,传统方法直接没法比(因为只动嘴)。
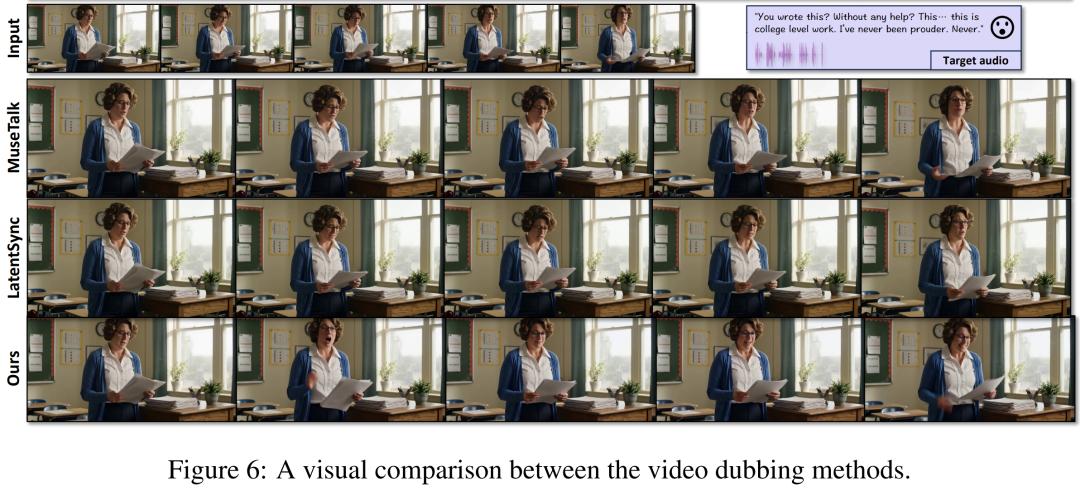
我自己也对比过截图:同样一段“中大奖”的配音,传统方法里演员的手还插在兜里,表情平淡;而InfiniteTalk里,演员不仅嘴型对得上,还会抬手、瞪眼,连头都跟着语气往上抬——一眼看过去就像“真的中了奖”。
五、未来能用来干嘛?不止追剧,这些场景都要变
看完这篇论文,我第一个想到的就是“译制片终于能不违和了”。但再细想,它的用处远不止这些:
1. 影视译制:从“对口型”到“演到位”
以后国外电影引进中国,不只是“配中文”,还能让演员的动作、表情跟着中文语气调整。比如英文里“OK”是点头,中文里“没问题”可能会抬手,技术能自动把动作改成“抬手”,再也不会出现“说中文,做英文动作”的尴尬。
2. 虚拟主播/直播:“声音变了,动作也跟着变”
现在很多虚拟主播是“固定动作库”,比如说话时只会眨眼、张嘴。有了这个技术,虚拟主播能“听声音做动作”——说“开心”就笑,说“生气”就皱眉,甚至能跟着唱歌的节奏摆手,比现在自然10倍。
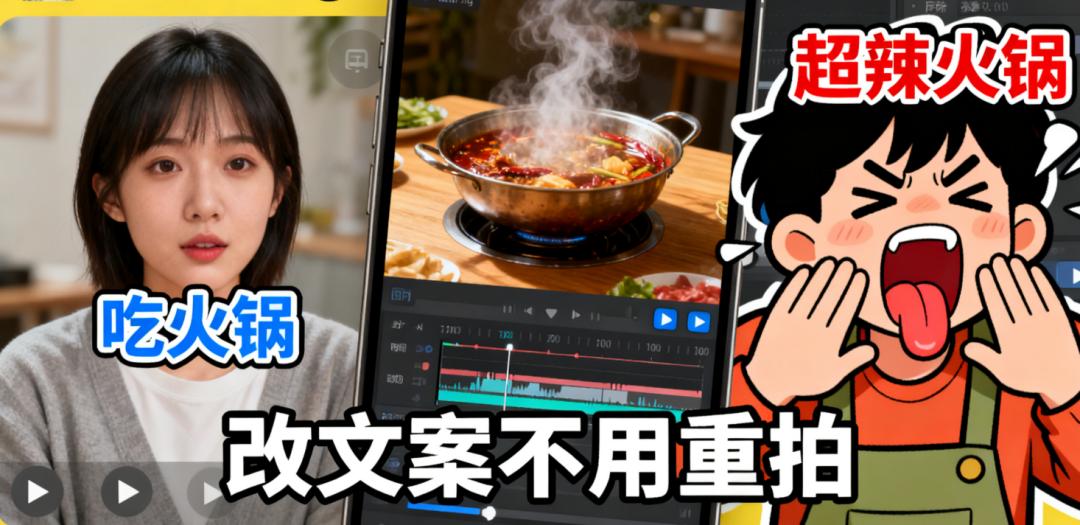
3. 短视频配音:“改文案不用重拍”
比如你拍了一段vlog,原来说“今天吃了火锅”,后来想改成“今天吃了超辣的火锅”。用这个技术,不用重拍,直接改声音,画面里你的表情会自动变成“辣到皱眉”,嘴型也对得上——省了多少重拍的时间。
4. 纪录片/教育视频:“多语言版本更自然”
很多纪录片要做多种语言版本,比如中文、英文、西班牙语。以前每个版本都要重新调整嘴型,还容易违和。现在只要做一次“关键帧”,就能自动生成所有语言的版本,动作、表情都跟着对应语言的语气走。
六、还有小遗憾:这条路还没走完
当然,InfiniteTalk不是“完美技术”。我在实验里发现了小问题:
画面质量还有提升空间。虽然比其他“全身体动”的技术好,但比只改嘴型的传统方法,画面还是略模糊一点——就像照片放大后,细节少了一点。未来还需要优化“清晰度”和“动作自然”的平衡。
最后:技术的意义,是让“真实”回归
看完这篇论文,我最大的感受是:AI技术终于从“解决功能”走向了“还原真实”。过去我们追求“嘴型对得上”,现在我们追求“像真人一样说话”——这才是技术该走的方向。
你平时看译制片时,最受不了哪种违和感?是“嘴型对不上”,还是“表情不搭”?欢迎在评论区聊聊,也可以说说你觉得这个技术还能用来做什么。
参考资料
• 标题:INFINITETALK: AUDIO-DRIVEN VIDEO GENERATION FOR SPARSE-FRAME VIDEO DUBBING
• 作者:Shaoshu Yang, Zhe Kong, Feng Gao, Meng Cheng, Xiangyu Liu, Yong Zhang, Zhuoliang Kang, Wenhan Luo, Xunliang Cai, Ran He, Xiaoming Wei
• 单位:中国科学院大学、美团、中山大学、香港科技大学
• 链接:https://arxiv.org/pdf/2508.14033
• 代码:https://github.com/MeiGen-AI/InfiniteTalk