晓|NeurIPS'25 人大+百度+CMU多智能体强化学习,多跳问答新SOTA
你有没有过这种经历?问AI“北京冬奥会的吉祥物是什么”,它却给你讲2008年的福娃;或者想知道“怎么判断芒果熟没熟”,它硬说“捏起来软就是坏了”——这些离谱回答,不是AI“故意骗人”,而是它的“知识检索系统”出了问题。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
最近我在研究Retrieval-Augmented Generation(简称RAG,通俗说就是“AI查资料再回答”)时,读到一篇来自中国人民大学、百度、CMU团队的NeurIPS 2025论文,居然用“团队协作”的思路解决了RAG的核心痛点。这篇论文提出的MMOA-RAG方法,把AI的“知识检索流程”拆成了几个“小助手”,还让它们学会了互相配合。我们今天讲讲为什么这个方法能让AI回答更靠谱。
一、先搞懂:AI答错题,问题出在“检索团队”不配合
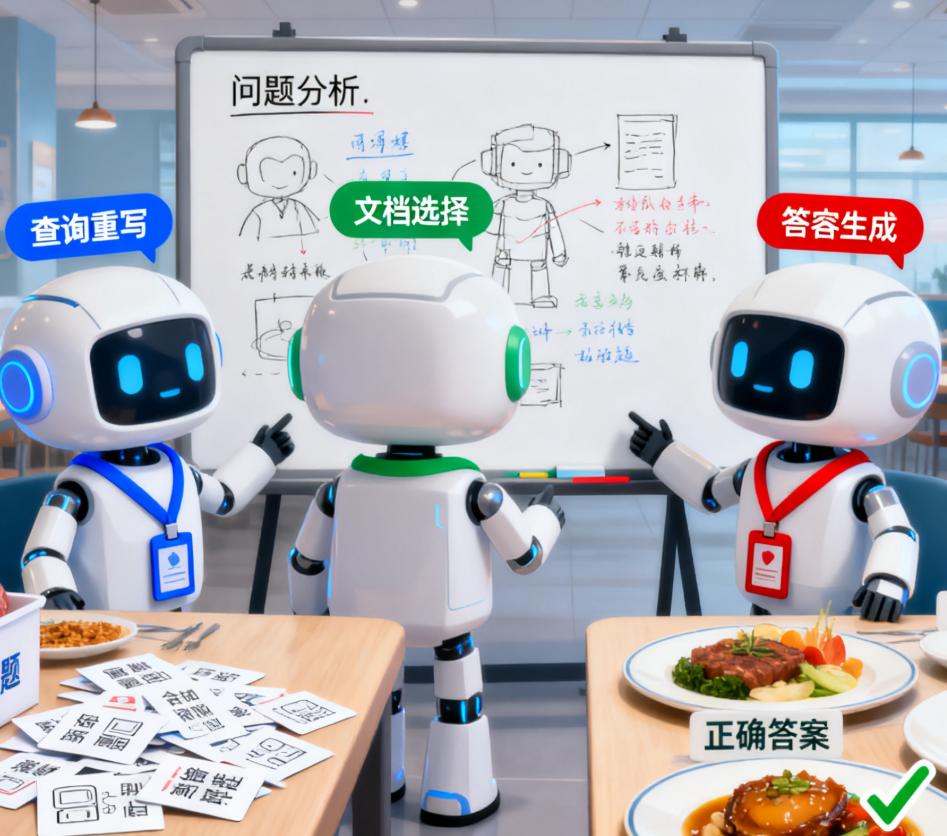
在讲新方法前,得先说说传统RAG是怎么工作的。你可以把RAG想象成一家“AI问答餐厅”,要完成一次回答,得经过三个关键步骤:
• “点菜翻译员”(查询重写):你说的问题可能含糊不清,比如“那个发明电话的人后来还干了啥”,翻译员得把它改成精准的“亚历山大·贝尔后续发明成就”,这样才能方便后面找资料。
• “食材筛选员”(文档选择):根据翻译后的问题,从海量资料里找出相关的“食材”(比如贝尔的传记、专利记录),再筛选掉没用的(比如其他人的发明故事)。
• “厨师”(答案生成):用筛选好的“食材”,做出你要的“菜”(最终回答)。
按说这三个角色配合好,回答应该很准才对。但问题就出在:传统方法里,这三个角色是“各练各的”,没人管它们配合得好不好。
比如“翻译员”只关心“我改的问题够不够标准”,哪怕改出来的问题让“筛选员”找不到关键资料,它也不管;“筛选员”只关心“我选的资料够不够多”,哪怕选了一堆重复的、没用的,给“厨师”添乱也无所谓;“厨师”更惨,拿到一堆乱七八糟的“食材”,只能硬着头皮做,最后端出来的“菜”自然一言难尽。
我之前跟团队做RAG优化时,就遇到过这种尴尬:查询重写模块的“改写相似度”得分很高,但最终回答的准确率却上不去——后来才发现,它改的问题太“书面化”,反而让检索模块抓不住重点。这就像乐队里的吉他手只顾炫技,不管主唱能不能跟上,最后整首歌肯定垮掉。
二、新解法:给“检索团队”配个“总教练”——MMOA-RAG的核心思路
那怎么让这三个角色“劲往一处使”?这篇论文的核心创新,就是把“AI问答餐厅”的管理模式改了——不再让三个角色各自为战,而是给它们配了一个“总教练”,用同一个目标来考核所有人。
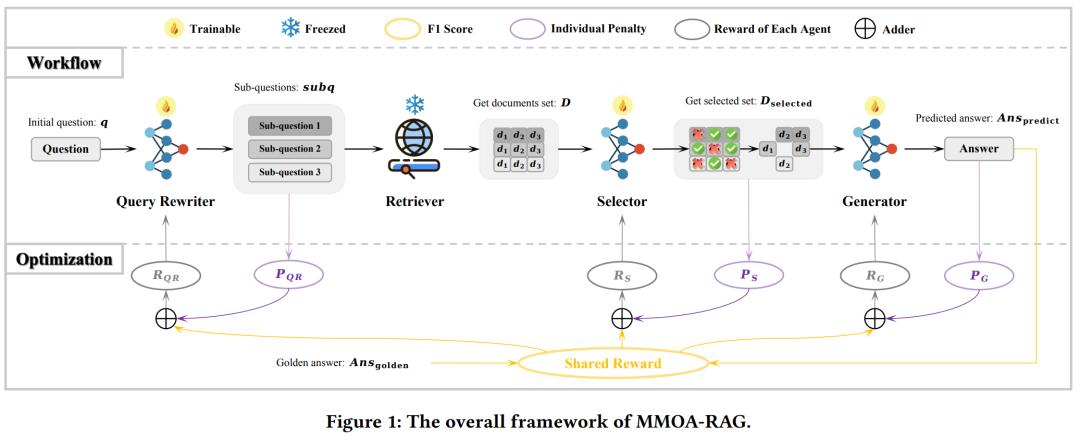
这个方法叫MMOA-RAG(Multi-Module joint Optimization Algorithm for RAG),说穿了就是“多模块联合优化”。我用餐厅的例子再给你拆解:
1. 明确“团队目标”:只看“顾客满不满意”
以前“翻译员”的KPI是“改写相似度”,“筛选员”是“选资料数量”,“厨师”是“回答流畅度”——现在不管这些,所有人的KPI只有一个:顾客最终对“菜”的满意度(对应论文里的“F1分数”,也就是回答的准确率)。
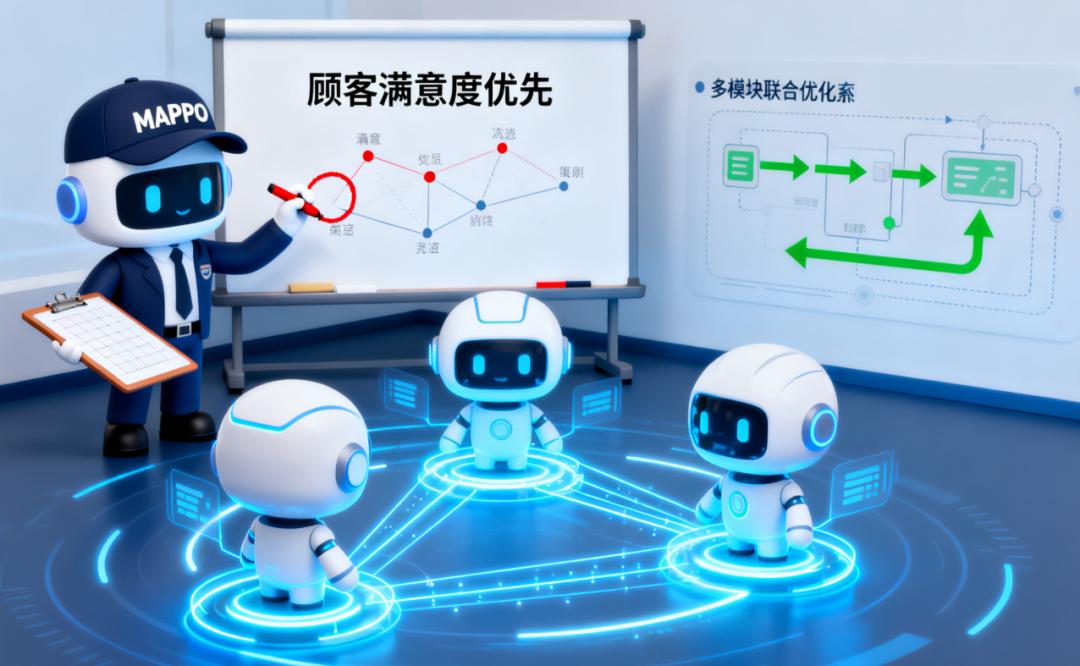
比如顾客说“这菜不好吃”(回答准确率低),那“翻译员”可能要反思“是不是我改的问题不对”,“筛选员”要想“是不是我选的食材不行”,“厨师”要琢磨“是不是我做法有问题”——所有人都围绕同一个目标调整,而不是各管各的。
2. 三个“角色”变“智能体”:学会互相补位
论文里把“查询重写”“文档选择”“答案生成”这三个模块,变成了三个“智能体(Agent)”。你可以把它们想象成餐厅里的三个老员工:
• 查询重写智能体:不光会改问题,还会观察“筛选员”能不能找到资料——如果发现“筛选员”总找不到,它会主动调整改写方式,比如把长问题拆成几个短问题(比如把“贝尔的发明和生平”拆成“贝尔的主要发明”“贝尔的生平经历”)。
• 文档选择智能体:不再盲目选多,而是会看“厨师”用不用得上——如果“厨师”总不用某类资料,它下次就少选这类,避免给“厨师”添乱。
• 答案生成智能体:拿到“筛选员”给的资料后,会反馈“哪些资料有用、哪些没用”,帮助“筛选员”下次改进。
这就像好的餐厅团队:服务员发现顾客不吃辣,会提前告诉后厨;后厨发现某种食材不新鲜,会让采购下次换供应商——不是各自封闭,而是互相反馈、补位。
3. “总教练”MAPPO:帮团队找最优配合
要让三个智能体学会配合,得有个“总教练”——论文里用的是“Multi-Agent PPO(MAPPO)”算法。这个“教练”的作用,就像餐厅经理:
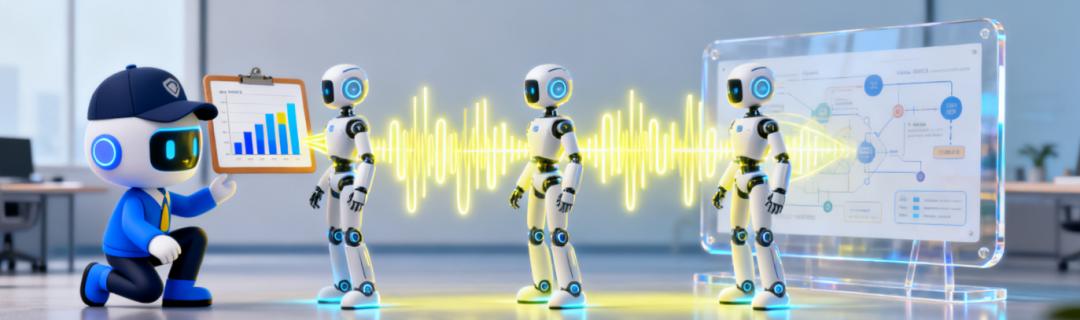
• 每天记录“顾客反馈”(比如“今天10个顾客说菜咸了”),然后分析是哪个环节的问题;
• 给每个智能体“提建议”:比如告诉“筛选员”“最近选的资料里有很多重复的,下次注意”,告诉“翻译员”“拆成3个问题比拆5个问题效果好”;
• 慢慢让团队找到最优配合方式:比如“翻译员拆2个问题+筛选员选8份资料+厨师侧重事实描述”,能让顾客满意度最高。
我刚开始看这部分时,还担心“多智能体会不会太复杂”——后来发现论文的巧思在于“不搞花里胡哨的”,就用最成熟的MAPPO算法,重点放在“目标对齐”上。这就像教练不用教队员新动作,只需要调整他们的配合节奏,效果反而更明显。
三、细节里的巧思:怎么避免“团队摸鱼”?
光有目标和教练还不够,还得防止有人“摸鱼”——比如“翻译员”为了省事,总把问题拆成10个(导致“筛选员”忙不过来),或者“筛选员”总选重复的资料(省事儿)。
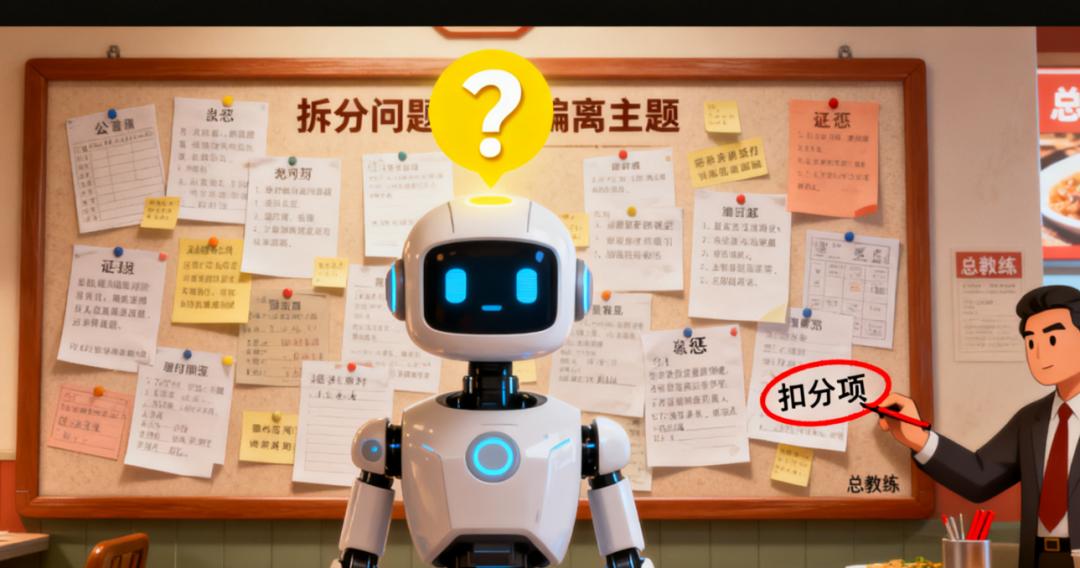
论文里加了个“扣分规则”(penalty项),就像餐厅的“罚款制度”:
• 如果“翻译员”拆的问题超过4个(太多了会增加检索负担),就扣它分;
• 如果“筛选员”选的资料有重复,或者格式不对(比如乱标文档ID),就扣它分;
• 如果“厨师”写的回答太长(比如明明3句话能说清,写了10句),也扣它分。
这个设计特别实用——我之前做实验时,就遇到过“查询重写模块”为了追求“覆盖全面”,生成十几个子问题,导致后续模块效率暴跌。加了这种“扣分规则”后,模块会更“克制”,不会为了自己的小目标牺牲团队效率。
四、实验说话:这个方法到底多好用?
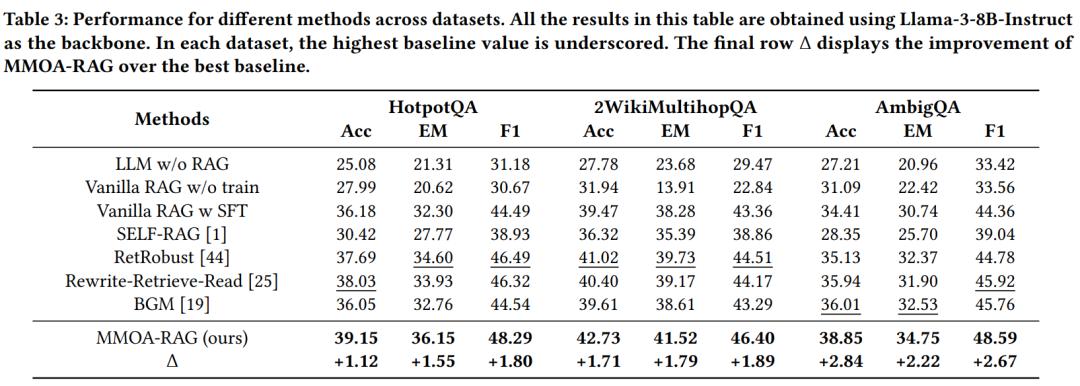
光说原理不够,得看实际效果。论文团队在三个公开数据集(HotpotQA、2WikiMultihopQA、AmbigQA,都是用来测试AI问答能力的“考题”)上做了实验,结果挺让人惊喜的。
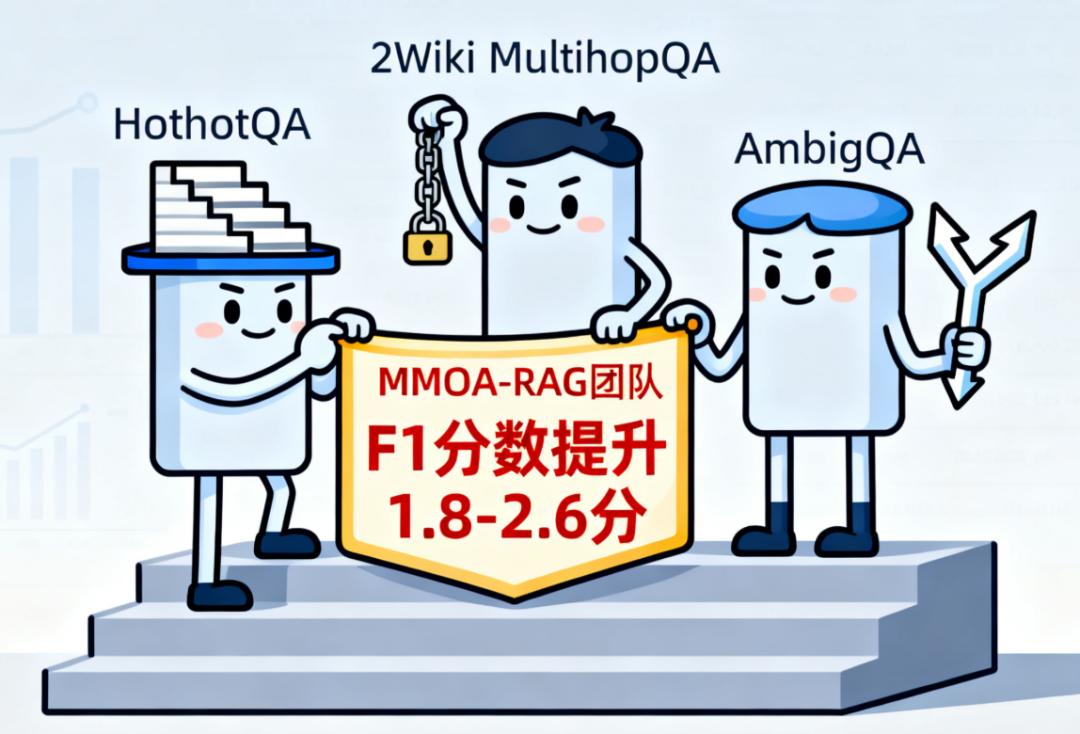
1. 比传统方法“分数更高”
在最难的“多跳问答”(比如“贝尔发明电话时,爱迪生在做什么”——需要查贝尔的时间线,再查爱迪生同期的经历)上,MMOA-RAG的F1分数比最好的传统方法高了1.8分。别小看这1.8分——在AI问答领域,0.5分的提升就已经很不容易,1.8分相当于从“良好”直接冲到“优秀”。
为什么能有这个提升?因为传统方法的“检索团队”总在“内耗”(比如翻译员和筛选员配合差),而MMOA-RAG的团队是“协同作战”,每个环节都在帮下一个环节铺路。
2. 换“考题”也好用:通用性强
更厉害的是,MMOA-RAG在不同“考题”(不同数据集)上都表现稳定。比如在“单跳问答”(比如“贝尔哪年发明电话”)和“多跳问答”上,都比传统方法好。这说明它的“团队协作”思路不是“针对性刷题”,而是真正提升了RAG的“通用能力”。
就像一个好的餐厅团队,不管顾客点“家常菜”还是“复杂大菜”,都能做好——因为他们的协作模式是通用的,不是只练过某一道菜。
3. 少了谁都不行:团队协作的重要性
论文还做了“ ablation实验”(就是故意去掉一个智能体,看效果变化):
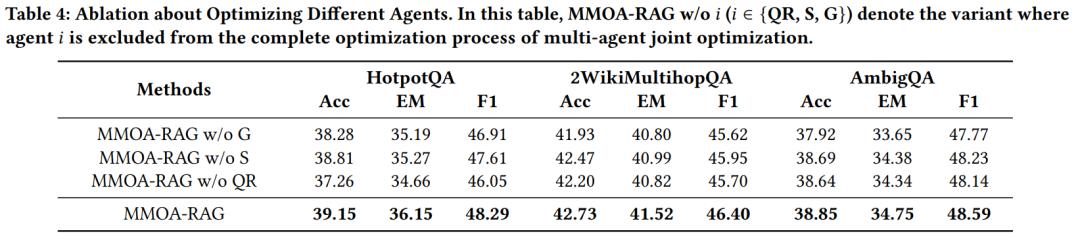
• 去掉“查询重写智能体”:分数掉了2.2分——说明“翻译员”很重要,没它“筛选员”找不到关键资料;
• 去掉“文档选择智能体”:分数掉了1.7分——说明“筛选员”能帮“厨师”省很多事,没它“厨师”要面对一堆没用的资料;
• 去掉“答案生成智能体”:分数掉了3.1分——这是最大的跌幅,说明“厨师”是最后一道关,没它前面的努力全白费。
这个结果也印证了“团队协作”的核心——三个角色缺一不可,少了任何一个,整个“检索团队”的效率都会大减。
五、未来能用到哪?给我们的生活带来什么改变?
看完这篇论文,我最直观的感受是:MMOA-RAG不是“炫技式创新”,而是真的能解决实际问题。以后它可能会用在这些地方:
1. 客服AI:不再“答非所问”
现在很多电商客服AI,你问“这个衣服能不能机洗”,它可能给你扯“衣服的颜色有哪些”——就是因为RAG的“检索团队”不配合。如果用MMOA-RAG,客服AI的“翻译员”会精准改写你的问题,“筛选员”会找到衣服的洗涤说明,“厨师”会直接给你答案,再也不会“驴唇不对马嘴”。
2. 教育AI:教知识更准确
比如学生问“牛顿第二定律怎么用”,教育AI需要先查教材里的定义,再找例题——如果“检索团队”配合不好,可能会把牛顿第一定律的内容混进来。MMOA-RAG能让AI的“检索团队”精准找到教材内容和例题,教给学生的知识更准确。
3. 医疗咨询AI:避免“误导”
医疗AI需要精准的医学资料支持,如果“筛选员”选了过时的资料,“厨师”可能会给出错误的建议。MMOA-RAG的“团队协作”能确保AI优先选最新、最权威的资料,减少误导风险。
六、一点小遗憾:这个方法还有哪些要改进的?
作为研究员,我得客观说:MMOA-RAG不是“完美解法”,还有一些可以优化的地方。
比如它目前把“文档检索器”(就是从海量资料里找候选资料的模块)固定了,没纳入“团队协作”——相当于餐厅里的“采购员”不参与团队优化,只负责拿食材。如果以后能把“采购员”也变成智能体,让它学会“根据顾客需求调整采购方向”,效果可能会更好。
另外,它目前主要针对“问答场景”,能不能用到“写报告”“做总结”等其他场景,还需要更多实验验证。不过总的来说,这个“团队协作”的思路,给RAG的优化指了一个很靠谱的方向。
最后:AI的进步,本质是“学会配合”
读完这篇论文,我最大的感悟是:AI的进步,不再是“单个模块变厉害”,而是“多个模块学会配合”。就像人类社会的进步,不是某个人变厉害,而是团队、行业、社会的协作更高效。
以后你再遇到AI答错题,不用急着吐槽——可能它的“检索团队”还没学会配合。而像MMOA-RAG这样的方法,正在慢慢教会AI“怎么组队干活”。
你觉得以后AI的“检索团队”还能加哪些角色?比如“事实核查员”(检查回答是不是真的)、“语言调整员”(根据用户年龄调整回答难度)?欢迎在评论区聊聊你的想法~
参考资料
• 标题:Improving Retrieval-Augmented Generation through Multi-Agent Reinforcement Learning
• 作者:Yiqun Chen, Lingyong Yan, Weiwei Sun, Xinyu Ma, Yi Zhang, Shuaiqiang Wang, Dawei Yin, Yiming Yang, Jiaxin Mao
• 单位:中国人民大学,百度,卡耐基梅隆大学
• 链接:https://arxiv.org/pdf/2501.15228