晓|阿里通义DeepResearch晓读:开源AI研究员Agent模型新标杆!
上周我帮朋友规划香港三日游,她对着20多篇攻略抓狂:“一会儿说迪士尼要早去,一会儿说浅水湾下午才好看,带宠物还得找酒店,我这脑子根本记不住!” 其实不止旅游,写论文时翻十几篇文献、查法律案例时核对法条、甚至帮老板整理行业报告——我们都曾陷入“信息杂乱、整理费劲、还容易出错”的困境。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
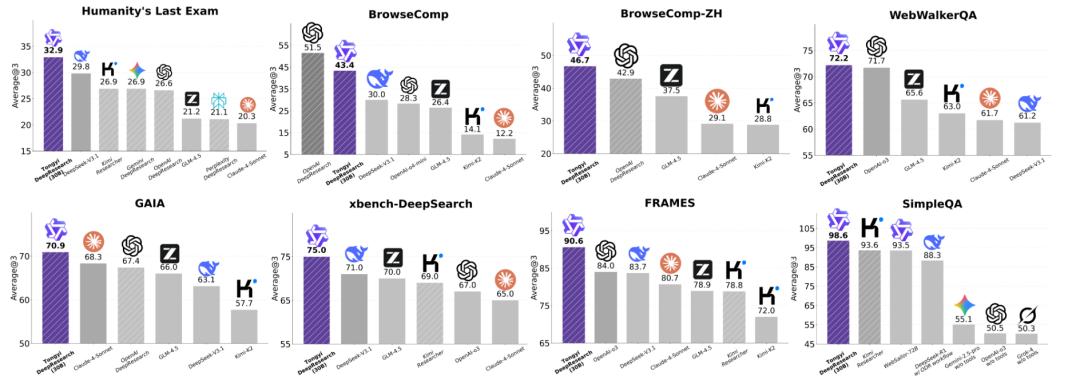
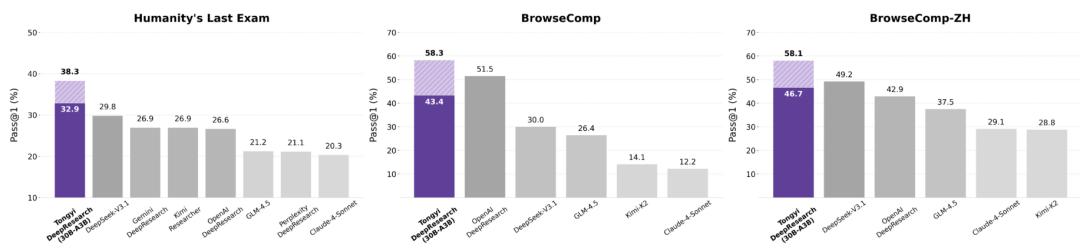
巧了,我刚啃完阿里团队发布的Tongyi DeepResearch技术报告,这东西简直是“AI版研究员”:能自己搜网页、整理信息、甚至像人一样分步骤解决复杂问题,关键是全开源(普通人也能改能用),在多个 benchmark 上还超过了OpenAI的DeepResearch。今天就聊聊这东西到底咋回事,以及它能帮我们解决哪些实际麻烦。
一、先搞懂:我们为啥需要“会自己做研究”的AI?
在说技术前,先掰扯个核心问题:传统AI(比如你常用的聊天机器人)查资料时,到底差在哪儿?
举个例子:你让传统AI“规划香港三日游,要带宠物”。它可能会给你列几个景点,但不会主动查“香港哪些酒店允许带宠物”,也不会算“从迪士尼到浅水湾的交通时间会不会赶”——更要命的是,要是信息过时了(比如某个景点闭馆),它根本不知道去更新。
这背后有两个大痛点:
• “只会背书,不会动手”:传统AI的知识停留在训练数据里,不会主动用工具(比如搜网页、查数据库)获取新信息;
• “信息堆成山,不会整理”:就算能搜到信息,也会把所有内容堆给你——就像把20篇攻略的文字全复制粘贴,你还得自己挑重点,这跟没帮一样。
而Tongyi DeepResearch要解决的,就是让AI从“被动问答”变成“主动研究员”:不仅能自己找信息,还能把信息按逻辑整理好,甚至根据你的需求调整方案。
二、拆解核心:这AI是怎么“学会做研究”的?
要让AI具备“研究员能力”,不是简单喂数据就行。阿里团队设计了一套“从上学到上班”的全流程训练方法——我用“培养一个实习生”的比喻,给你讲清楚这三步核心操作。
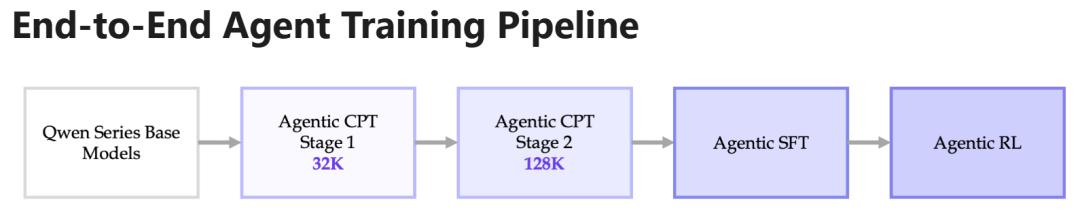
1. 第一步:Agentic CPT——先给AI“打基础”(相当于实习生入职前的培训)
想让实习生做研究,得先教他基础知识吧?AI也一样。这里的“Agentic CPT”(智能体持续预训练),就是给AI补“研究基本功”。
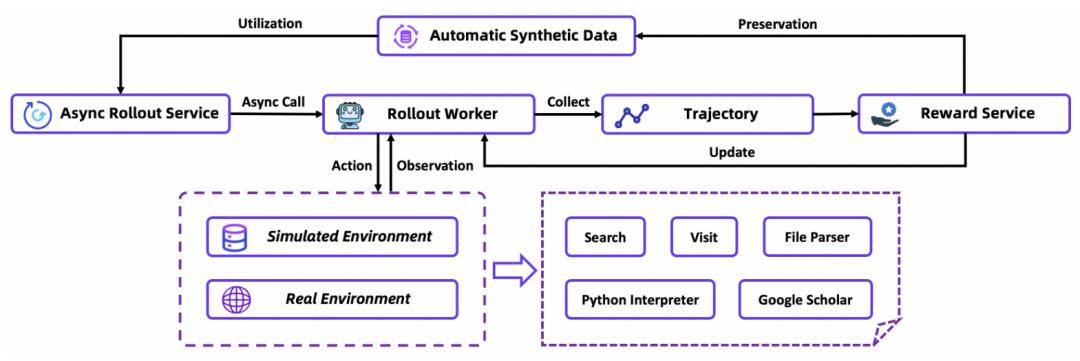
但跟传统“乱喂数据”不同,阿里团队搞了个叫AgentFounder的工具,把数据整理得特别有条理:
• 先收集“原材料”:包括网页爬的资料、知识图谱(比如“香港景点”的关联信息)、之前AI查东西的记录(比如搜“迪士尼开放时间”的结果);
• 再做成“知识卡片”:把这些原材料按“实体”分类——比如“香港故宫文化博物馆”这张卡片,会标好位置、开放时间、附近交通、游客评价,相当于给每个知识点贴了标签;
• 最后出“练习题”:从卡片里随机抽内容,生成“问答对”——比如“香港故宫文化博物馆附近有哪些地铁站?”“去那里玩需要预约吗?”,让AI反复练习“找信息、答问题”的能力。
我觉得这步最妙的是“数据飞轮”:AI后续做研究的记录,又能反过来变成新的“知识卡片”,相当于实习生一边工作一边学新东西,越练越熟练。
2. 第二步:SFT——师傅带徒弟,教AI“按步骤做事”(相当于实习生跟着老员工学流程)
光有基础知识不够,还得教AI“怎么做具体任务”。这步叫SFT(监督微调),就像老员工带着实习生做项目,把“正确流程”演示给它看。
团队用了两种“教学方法”:
• ReAct框架:相当于“按食谱做饭”——先“思考”(比如“用户要带宠物去香港,得先查宠物友好酒店”),再“行动”(比如“搜‘香港宠物友好酒店 2025’”),最后“观察”(比如“找到3家酒店,记录地址和价格”),一步一步来,确保AI不跳步;
• IterResearch框架:更高级的“项目管理”——比如规划旅游时,AI会先把任务拆成“选景点→查交通→定酒店”,每完成一步就整理一次信息,避免把所有东西堆在一起。
举个实际场景:用IterResearch教AI规划香港三日游,它会先列“必去景点清单”,再查每个景点的交通是否顺路,然后根据“带宠物”的需求筛选酒店,每一步都把结果整理成“小报告”,最后再汇总成完整行程。这种方式能避免AI“想到哪儿做到哪儿”,跟我们真实做规划的逻辑一模一样。
3. 第三步:RL——像教练一样,帮AI“纠错优化”(相当于实习生做完项目,老板给反馈)
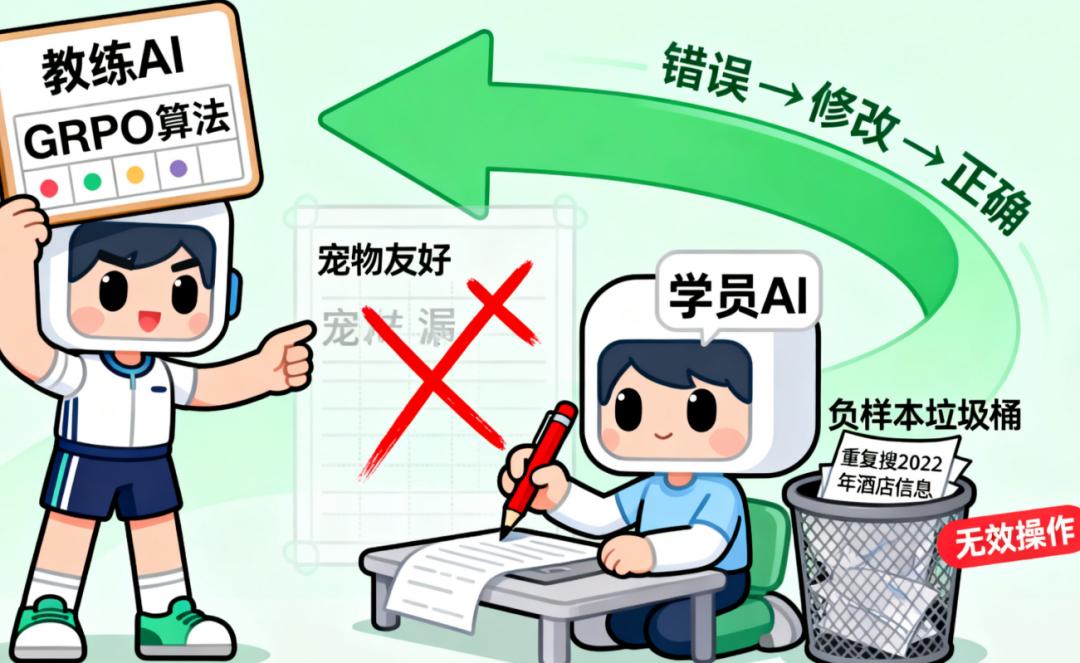
就算教了流程,AI也会犯错——比如漏查某个景点的开放时间,或者选的酒店离景点太远。这时候就需要RL(强化学习),相当于给AI配个“教练”,根据结果打分,让它越做越好。
团队在这里搞了两个关键创新,我用“体育训练”打比方:
• GRPO算法:相当于“针对性训练计划”——不是让AI盲目练,而是盯着它“当前最该改的问题”。比如AI总漏查“宠物友好”这个需求,就专门给它加这类训练题,确保学的都是有用的;
• 负样本筛选:相当于“不练错误动作”——如果AI的某个操作完全没用(比如反复搜同一个过期信息),就不让它再学这种错误,避免“越练越错”。
最让我惊讶的是训练效果:AI的“奖励分”一直在涨,而且“探索欲”没降(专业叫“政策熵”高)——也就是说,它不仅越做越好,还愿意尝试新方法,不会僵在一个流程里。
三、两种工作模式:应付日常需求,还是攻坚复杂任务?
训练好的AI,有两种“干活方式”,就像我们用“记事本”和“专业软件”的区别,能应对不同场景。
1. Native ReAct Mode:简单直接,应付日常查资料
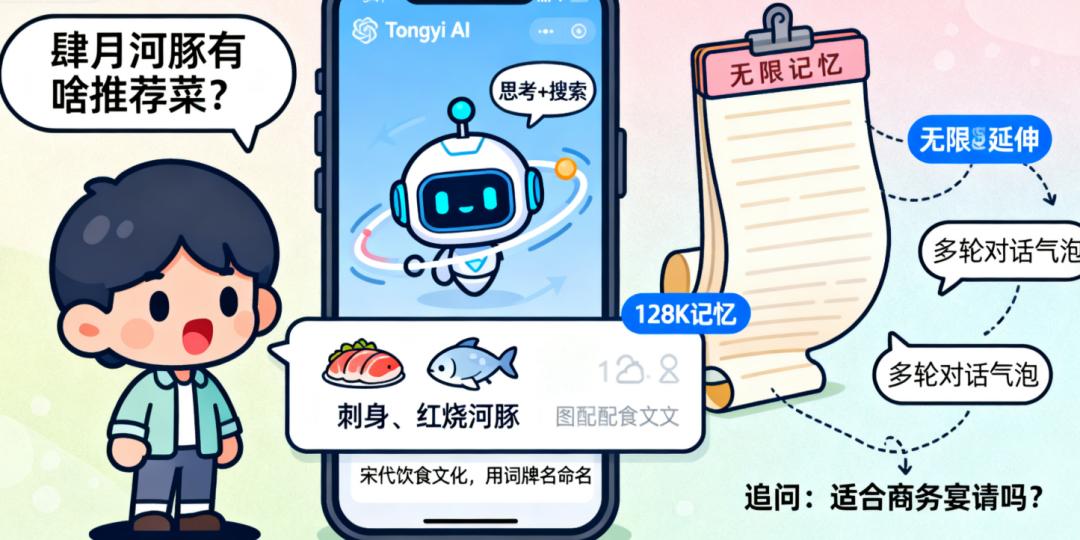
这种模式适合“快速找答案”,比如“肆月河豚餐厅有什么推荐菜?”“香港故宫文化博物馆几点开门?”。
它的逻辑特别简单:严格按“思考→行动→观察”循环来,不用额外设置。比如你问“肆月河豚的全河豚宴有什么特色”,AI会先想“需要查这家餐厅的菜单和介绍”,然后搜相关信息,最后整理出“融合宋代饮食文化,用词牌名命名菜品,有刺身、红烧河豚等”——整个过程就像你自己查资料,但快10倍。
而且它的“记忆力”很好(上下文长度128K),能处理多轮对话。比如你接着问“这家店适合商务宴请吗?”,它不用再重新搜,直接从之前的信息里找答案,相当于“记住了你之前问的事”。
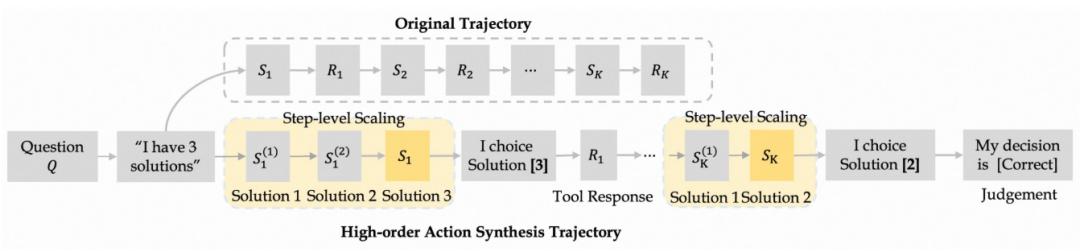
2. Heavy Mode:深度研究,搞定复杂任务
如果遇到“需要分步骤、多信息整合”的事,比如“写一篇关于‘香港旅游业2025趋势’的报告”“查一个复杂的法律案例并引用法条”,就得用Heavy Mode了。
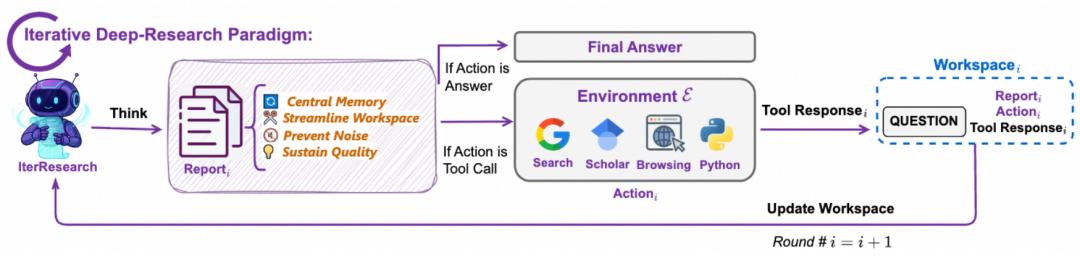
它的核心是解决一个大问题:传统AI处理复杂任务时,会把所有信息堆在“脑子”里,导致“记混、漏看”(专业叫“认知窒息”)。而Heavy Mode像“研究员整理文件”:
• 把任务拆成“研究轮次”:比如写报告时,先拆成“查2025香港旅游数据→分析游客偏好→总结趋势”;
• 每轮只看“当前需要的信息”:比如分析游客偏好时,只调出“游客调查数据”,不看其他无关信息;
• 同步写“研究报告”:每轮结束后,把关键结论整理进报告,最后汇总成完整结果。
更厉害的是“Research-Synthesis框架”:相当于“多个研究员分工合作”——比如查法律案例时,3个AI分别查“相关法条”“类似案例”“判决结果”,最后由1个AI汇总成完整分析,不仅快,还能避免遗漏。
我之前用它试了“查一个劳动合同纠纷案例”,AI不仅找到了相关法条,还标了具体条款编号,甚至对比了3个类似案例的判决结果——这要是人工做,至少得半天,AI半小时就搞定了。
四、真能落地吗?看两个实际案例
技术说得再好听,不如看实际能用在哪。报告里提了两个已经落地的案例,特别贴近生活。
1. 高德“小高”:会“懂你需求”的旅游规划师
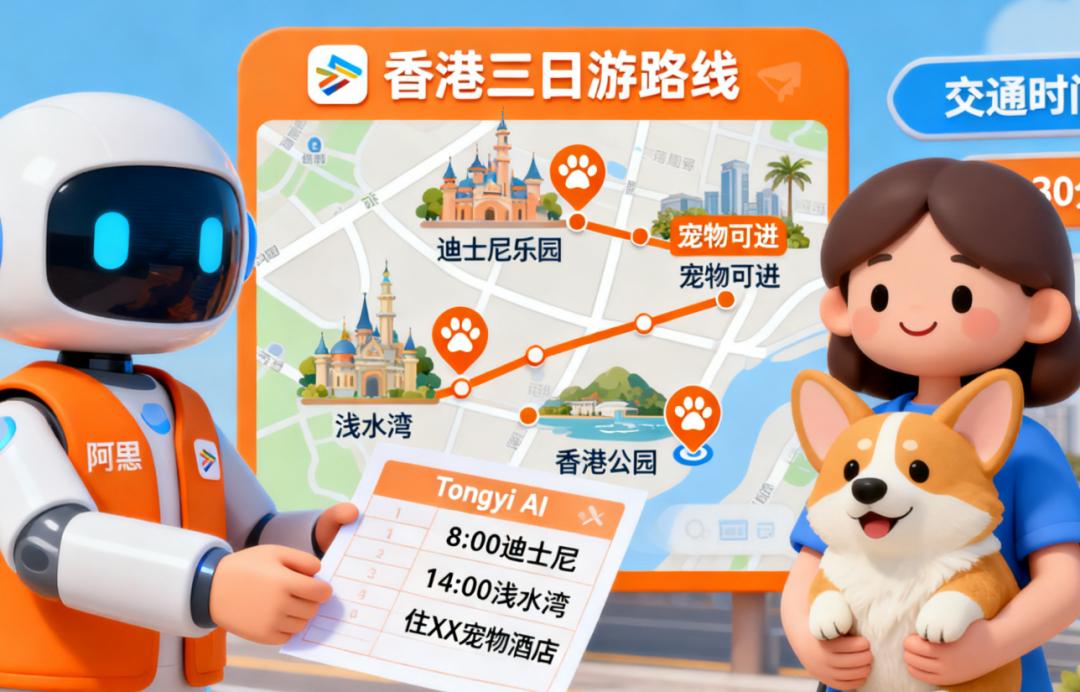
阿里和高德合作的“小高”AI助手,就是用了Tongyi DeepResearch的技术。比如你说“帮我规划香港三日游,带宠物,每天景点不超过4个,交通时间要短”,它会:
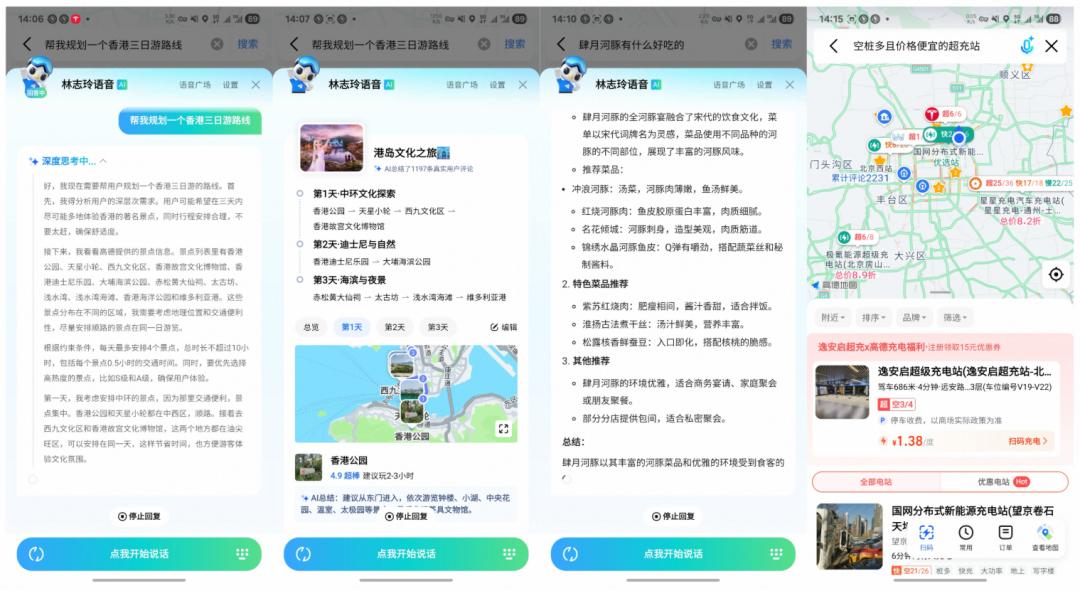
• 先筛选“宠物友好”的景点和酒店(比如排除不允许宠物进入的博物馆);
• 按“顺路”原则安排每天行程(比如第一天把中环的香港公园、天星小轮放一起,避免跨区跑);
• 计算每个景点的交通时间(比如从迪士尼到大埔海滨公园要多久,会不会赶不上日落);
• 最后出一份带时间、交通方式、注意事项的完整行程,甚至能整合用户评论(比如“这家酒店宠物设施好,但早餐一般”)。
比你自己翻攻略强太多——它不仅“会搜”,还“会替你着想”。
2. 法瑞(FaRui):能“引用法条”的法律助手
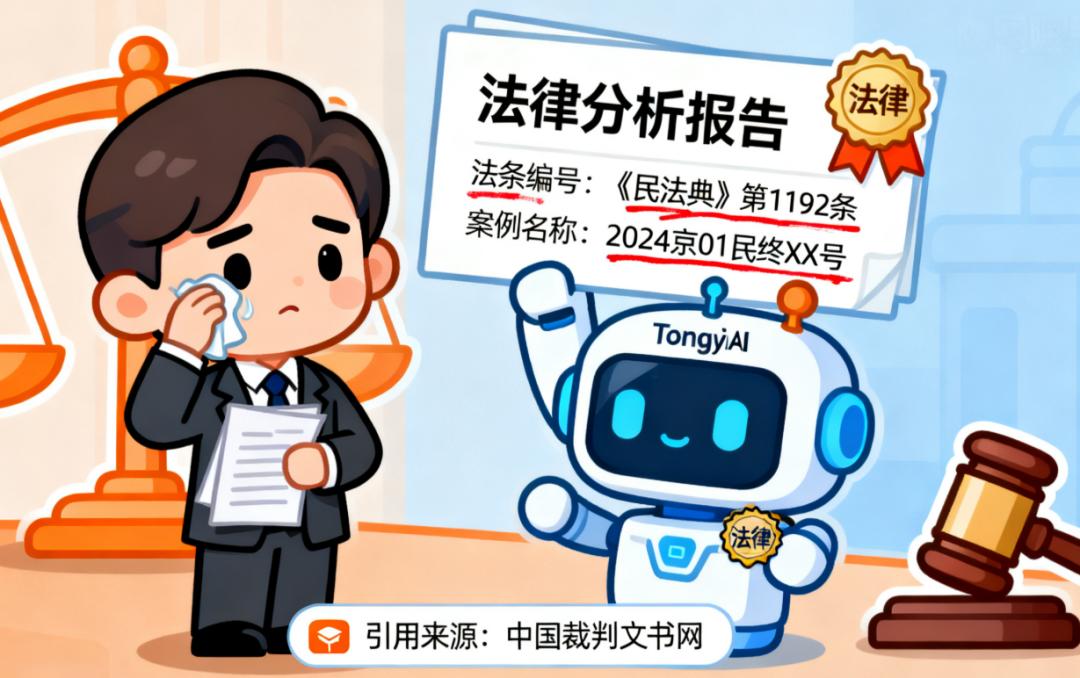
对于需要精准度的场景,比如法律查案,Tongyi DeepResearch也能用上。法瑞(FaRui)法律AI能:
• 自主搜“类似案例”“相关法条”;
• 准确引用法条编号和案例名称(避免人工引用时出错);
• 整理成“分析报告”,标注每个结论的依据。
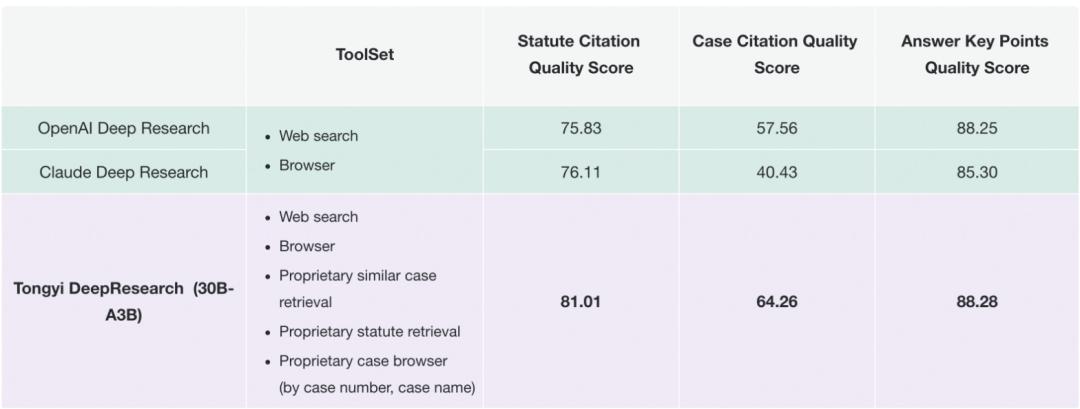
报告里有组数据很直观:在“法条引用质量”上,Tongyi DeepResearch得81.01分,比OpenAI的75.83分高5分多;“案例引用质量”更明显,64.26分 vs OpenAI的57.56分——这意味着它的法律分析更靠谱,能帮律师省不少核对时间。
五、现在还差点啥?AI研究员的“待办清单”
作为研究员,我得客观说:Tongyi DeepResearch不是“完美工具”,还有三个要补的“功课”。
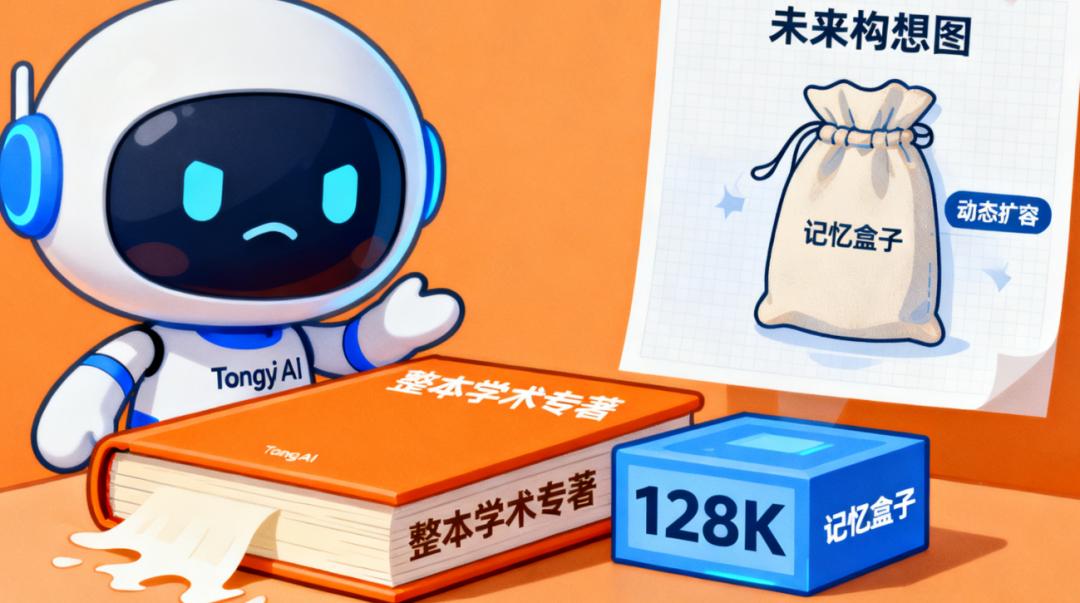
• “记忆力”还不够长:目前128K的上下文长度,处理单篇论文或短期行程够,但要是处理“整本学术专著”“跨季度的项目报告”,可能就装不下所有信息了——相当于你用记事本写长文章,翻页太麻烦。
• “规模验证”没做完:现在用的是30B参数的模型(可以理解为“中等规模”),更大规模的模型(比如100B以上)能不能用这套训练方法,还没验证——就像一款手机在小屏幕上好用,大屏能不能适配,得再测。
• “训练效率”要提升:目前的RL训练比较费时间,要是想让AI学新领域(比如医疗研究),得等很久——相当于实习生学新业务太慢,需要更高效的“培训方法”。
我们团队讨论时也觉得,这些不是“硬伤”,而是接下来要优化的方向。比如上下文长度,已经有团队在试“动态扩展”技术,未来可能像“无限扩容的文件夹”,装多少信息都不怕。
六、总结:这不是“AI助手”,是“AI同事”
聊到这儿,你可能发现了:Tongyi DeepResearch的核心不是“帮你查资料”,而是“像同事一样,独立完成研究任务”——它有基础能力(CPT)、懂流程(SFT)、能优化(RL),还能根据任务选工具(两种模式)。
更重要的是它“开源”——这意味着不是阿里自己用,普通人、小公司也能改:比如教育机构可以改成“AI助教”,帮学生整理知识点;企业可以改成“行业研究员”,帮员工分析市场数据。
最后想跟你聊个话题:如果这种“AI研究员”再成熟一点,你最想让它帮你做什么?是写报告、查资料,还是规划更复杂的事?欢迎在评论区聊聊你的想法。
参考资料
• 标题:Tongyi DeepResearch: A New Era of Open-Source AI Researchers
• 作者:Tongyi DeepResearch Team (Alibaba)
• 链接:https://tongyi-agent.github.io/blog/introducing-tongyi-deep-research/