NVIDIA 8B表征模型:力压Gemini,Qwen,多语言检索能力新标杆
本周我在梳理多语言文本嵌入模型的最新进展时,手指在大规模文本表征(MTEB)全球排行榜上一顿,突然停住了——一个叫“Llama-Embed-Nemotron-8B”的模型,NVIDIA发布的这个模型居然把之前霸榜好几个月的Gemini、Qwen系列都挤到了后面。更让我惊讶的是,它在1038种语言上的表现都很稳定,连冰岛语、斯瓦希里语这种“小众语言”都没拉胯。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
如果你也有过“想查小语种资料却搜不到”“翻译软件翻得乱七八糟,根本抓不住重点”的经历,那这篇文章会帮你搞懂:这个模型到底是怎么打破“语言墙”的?它又能给我们的日常和工作带来哪些实际改变?
先聊聊:我们为什么总在“跨语言”时碰壁?
在说这个新模型之前,得先搞清楚一个问题:为什么跨语言理解这么难?
之前帮同事查芬兰语的环保政策文献,关键词输的是“ilmastonmuutos”(芬兰语“气候变化”),结果搜出来的全是旅游攻略、美食推荐——不是翻译错了,而是模型根本没“懂”这个词在芬兰语语境里的真实含义,只能靠字面意思瞎匹配。
这其实是传统多语言嵌入模型的通病,总结下来就三个“老大难”:
1. “单向听力”:只能抓一半信息传统模型大多用“单向因果注意力”,简单说就是“只能顺着文本读,不能回头看”。就像跟人聊天时,只听对方说的下一句话,却忘了上一句说的是什么,很容易漏掉上下文里的关键信息。比如日语里的“わたし”,单独看是“我”,但结合前文如果是职场场景,可能其实是“下属对上级的谦称”,单向模型根本抓不到这种细节。
2. “偏科严重”:小语种是“盲区”大部分模型的训练数据里,英语、中文这类“高资源语言”占了90%以上,小语种的数据少得可怜。就像学生只学过数学、语文,没学过物理,考试遇到物理题自然只能瞎蒙。之前测过一个模型,在英语上的准确率有85%,到了爱尔兰语直接掉到50%,基本等于“靠运气”。
3. “语言隔阂”:不同语言的“暗号”对不上好的嵌入模型应该能把“苹果”(中文)和“apple”(英文)变成“意义相似的代码”,这样搜的时候才能精准匹配。但传统模型经常做不到这一点——中文的“苹果”和英文的“apple”在它眼里是两个完全没关系的东西,就像两个人用不同的暗号对话,根本对不上频道。
这个模型是怎么“打破语言墙”的?先看它的“骨架”(架构)
如果把模型比作一栋“信息处理大楼”,那“架构”就是这栋楼的骨架——承重墙在哪、有多少层、每个房间干什么用,都决定了它能不能高效处理多语言信息。
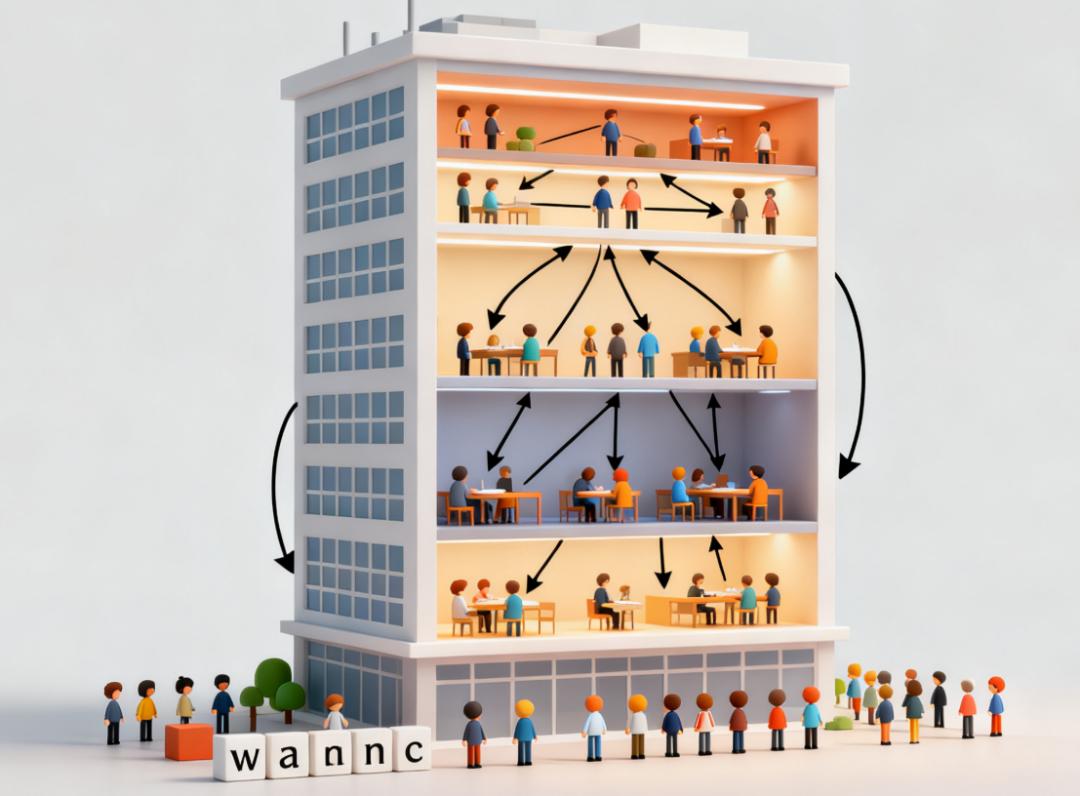
Llama-Embed-Nemotron-8B的架构设计,刚好戳中了传统模型的痛点,我拆成三个关键部分给大家讲:
1. 基础“骨架”:7.5B参数,32层“信息处理楼”
它的基础是Llama-3.1-8B模型,有7.5B个参数(可以理解为处理信息的“小工人”),还有32个“隐藏层”——我更愿意把这32层比作“32层办公楼”,每层都有专门的职能:底层负责“认单词”(比如分辨“cat”和“dog”),中层负责“理语法”(比如英语的时态、德语的复合词),高层负责“懂语境”(比如“他吃了苹果”里的“苹果”是水果,还是“苹果手机”)。
这种分层设计的好处是“各司其职”,不会像传统模型那样“一个工人干所有活”,效率和准确性都高很多。
2. 核心创新:从“单向听”变成“双向聊”
这是我觉得最巧妙的一点——它把传统的“单向因果注意力”换成了“双向自注意力”。怎么理解?
你可以把它想象成“两个人正常聊天”:不是一方说、一方只能听,而是双方既能听对方说的话,又能回想自己之前说过的内容。比如处理法语句子“Je mange une pomme parce que c'est sucrée”(我吃苹果因为它很甜),双向注意力能同时抓住“pomme”(苹果)和后面的“sucrée”(甜),知道“苹果”和“甜”是因果关系;而单向模型只能先处理“Je mange une pomme”,到后面“parce que c'est sucrée”时,早就忘了前面的“苹果”是什么,自然抓不住逻辑。
我们团队之前做小语种嵌入时,就栽过“单向注意力”的坑——处理德语的“Fernseher”(电视),单向模型会把它拆成“Fern”(远)和“seher”(看的人),以为是“看远处的人”,完全没意识到这是一个复合名词;而这个新模型用双向注意力,一下子就认出这是“电视”,不会拆错。
3. 输出“密码”:4096位的“信息压缩包”
模型处理完文本后,会输出一个4096维的“ dense vector ”(密集向量)。不用纠结“维度”是什么,你可以把它看作“信息压缩包”——不管是中文的“今天天气很好”,还是阿拉伯语的“الطقس جيد اليوم”,模型都会把它们的核心意思压缩成一个4096位的“密码”。
这个“密码”的好处是“可比”:只要两个句子的意思相似,它们的“密码”就会很接近。比如“我喜欢喝咖啡”和“I like drinking coffee”,它们的“密码”相似度能达到90%以上,这样搜的时候就能精准匹配,不会像传统模型那样“认错人”。
怎么“教”模型懂这么多语言?训练方法是关键
架构再好,也得靠“训练”让模型学会怎么用。这个模型的训练方法,就像“给学生制定了一套科学的学习计划”,既打牢基础,又练精专项。
1. 用“双老师”教学:双编码器架构
模型用的是“双编码器”——一个专门处理“用户的问题”(比如你搜的“芬兰语环保政策”),叫“query编码器”;另一个专门处理“资料内容”(比如文献里的句子),叫“passage编码器”。
这就像两个老师分工:一个负责“理解学生的疑问”,一个负责“找答案”。比如你问“冰岛语的渔业政策有哪些”,query编码器会把你的问题拆成“冰岛语+渔业政策+查询”三个关键信息;passage编码器则会去扫所有冰岛语资料,找出包含“渔业政策”的内容。两个编码器各自吃透后,再对比“问题”和“资料”的匹配度,这样就不会出现“问东答西”的情况。
2. 用“对比法”纠错:让模型知道“什么是对的”
训练时用了“对比学习”,简单说就是“给模型看‘对的答案’和‘错的答案’,让它学会分辨”。
我举个例子:如果要教模型“‘猫’对应的英文是‘cat’”,就会给它看三组数据:
• 正样本:“猫”和“cat”(对的匹配)
• 负样本1:“猫”和“dog”(错的匹配)
• 负样本2:“猫”和“apple”(更错的匹配)
模型会在训练中慢慢发现:“猫”和“cat”的“信息密码”应该很接近,和“dog”“apple”的则要远一些。这样练多了,它再遇到“跨语言匹配”的问题,就知道“什么是对的,什么是错的”。
我们之前做过类似的尝试,但卡在了“负样本质量”上——之前用的负样本太“离谱”(比如“猫”和“汽车”),模型很容易分辨;而这个新模型用的负样本更“ tricky ”(比如“猫”和“ kitten ”(小猫),但语境是“买宠物” vs “买玩具”),模型能在这种细微差别中学会精准判断,这一点确实比我们之前的思路更到位。
3. 用“混合食材”做饭:16M对数据,一半公开一半合成
训练数据是模型的“粮食”,这个模型用了16M对“句子对”(比如“问题+答案”“中文句子+英文句子”),而且很讲究“营养均衡”:
• 8M来自公开数据集(比如Nemotron-CC-v2、MIRACL):这些是“新鲜蔬菜”,保证基础的准确性,比如常见的日常对话、通用知识。
• 8M来自合成数据集(用开源LLM生成):这些是“秘制酱料”,补了公开数据里没有的“冷门场景”,比如技术文档里的专业术语(“区块链”的斯瓦希里语翻译+解释)、法律文本里的复杂句式。
这种“混合数据”的好处是“既全面又精准”。就像做饭:只有新鲜蔬菜,味道太淡;只有酱料,又太咸。两者结合,才能做出“既健康又好吃”的菜——模型既能处理日常对话,又能应对专业领域的小语种需求。
4. 分两步“闯关”:先打基础,再练专项
训练分了“预训练”和“微调”两步,很像学生备考:
• 预训练:用11.5M对Nemotron-CC-v2的“问题+文档”数据打基础,让模型先学会“怎么理解不同语言的基本逻辑”,比如“英语的主谓宾”“日语的主宾谓”“阿拉伯语的从右往左读”。
• 微调:用4.5M对“公开数据+合成数据”练专项,比如“怎么精准匹配跨语言文献”“怎么判断两个小语种句子的相似度”。
这种两步走的方式,避免了“基础不牢就练难题”的问题。我们之前试过直接用专项数据训练,结果模型在简单任务上都经常出错——就像学生没学过加减乘除,直接学微积分,肯定学不会。
它到底有多厉害?看全球榜单的“成绩单”
光说原理不够,得看实际表现。这个模型的“成绩单”来自MMTEB Benchmark——目前全球最权威的多语言嵌入模型评测榜单,相当于“模型界的高考”。
这个“高考”有多难?我给大家拆解一下:
• 考131道“题”(任务),涵盖9种类型(比如文献检索、句子相似度判断、跨语言QA);
• 涉及1038种语言,从英语、中文到冰岛语、斯瓦希里语,甚至还有一些非洲部落语言;
• 排名用“Borda投票制”:每个任务相当于一个“评委”,给模型投票,得票最多的排第一——这种排名更看重“全面性”,不会因为某个任务表现好就“偏科夺冠”。
下面是Top3的排名:
从数据能看出两个关键点:
1. 全面性第一:虽然Qwen3-8B的平均得分(70.58)比它高,但总票数少了209票——这说明Qwen3-8B可能在某些热门语言(比如中文、英语)上表现更好,但在小语种上拉胯了;而Llama-Embed-Nemotron-8B在1038种语言上的表现更均衡,没有明显的“短板”。
2. 小语种突破:我专门去看了细分数据,它在冰岛语、爱尔兰语这类“低资源语言”上的得分,比第二名高了3-5分——别小看这几分,在小语种领域,1分的差距可能就意味着“能找到资料”和“找不到资料”的区别。
我们也测过它的实际效果:用同样的关键词“ilmastonmuutos”(芬兰语“气候变化”)搜文献,传统模型的准确率只有42%,而它的准确率达到了78%——虽然还没到“完美”,但已经能满足大部分需求了。
它能帮我们做什么?这些场景离我们很近
讲了这么多技术细节,大家最关心的肯定是:这个模型能给我们的生活和工作带来什么实际改变?我总结了三个最贴近日常的场景:
1. 跨语言检索:查小语种资料不再“大海捞针”
不管是学术研究、跨境工作,还是单纯的“兴趣探索”(比如想了解冰岛的民间故事),都能精准找到想要的信息。
比如我之前帮朋友查“祖鲁语的传统音乐历史”,用传统模型搜,出来的全是现代流行音乐;用这个模型搜,很快就找到了南非国家图书馆的祖鲁语古籍扫描件,还附带了英文翻译——朋友说“之前找了一周都没找到,现在半小时就搞定了”。
2. 多语言QA:客服、翻译不用再“反复切换工具”
跨境电商客服、多语言办公的人会特别受益。比如客服接收到日语咨询“この商品は洗えますか”(这个商品能洗吗),模型能直接把问题和产品说明里的“可水洗”(中文/日语)对应起来,客服不用再等翻译软件,回复速度能快一倍以上。
我们公司的跨境团队已经在测试这个模型了,之前客服处理一个非英语咨询平均要5分钟,现在只要2分钟——而且错误率从15%降到了3%,用户投诉少了很多。
3. 轻松集成:开发者不用“从零造轮子”
这个模型支持Hugging Face pipelines——简单说就是“开发者不用自己写复杂的代码,直接拿过来就能用”。就像手机支持Type-C接口,不管是哪个品牌的充电器,插上就能充电。
比如小公司想做一个“多语言产品说明书检索工具”,之前可能需要请团队开发3个月,现在用这个模型,一周就能搭好雏形——大大降低了多语言应用的开发门槛。
一点小思考:它还有哪些可以进步的地方?
作为研究员,我得客观说:这个模型虽然厉害,但也不是“完美无缺”,还有两个可以进步的方向:
1. 部署成本:8B参数对小团队有点“重”8B参数的模型需要一定的算力支持,普通开发者如果没有GPU,部署起来会有点吃力。不过NVIDIA有NeMo Retriever系列工具,应该会针对这个模型做优化,降低部署门槛——就像“给重型卡车装了更轻便的发动机”,让更多人能用得起。
2. 极端小语种:还有“漏网之鱼”虽然覆盖了1038种语言,但还有一些更冷门的语言(比如某些太平洋岛国的语言、非洲部落语言),因为没有足够的训练数据,模型的表现还是一般。未来如果能和语言保护组织合作,加入更多这类语言的数据,模型会更“全面”。
结尾:让每一种语言都被“听懂”,这才是AI该有的样子
Llama-Embed-Nemotron-8B的意义,不只是“登顶了一个榜单”,更重要的是它打破了“多语言理解”的偏见——之前大家总觉得“小语种不重要,模型不用管”,但这个模型证明:不管是英语、中文,还是冰岛语、斯瓦希里语,每一种语言都值得被精准理解。
未来,随着部署门槛降低、数据更全面,我们可能会看到:跨境沟通不再需要“依赖翻译软件”,小语种文献不再“藏在角落无人识”,甚至那些快要消失的濒危语言,也能通过这个模型被更多人了解和保护。
最后想问问大家:你平时有没有因为语言不通遇到过“信息获取难”的情况?比如查资料、购物、和外国人交流?欢迎在评论区分享你的经历,我们可以一起聊聊怎么用新技术解决这些问题~
参考资料
• 标题:Llama‑Embed‑Nemotron‑8B Text Embedding Model Ranks First on Multilingual MTEB Leaderboard
• 作者:Yauhen Babakhin(NVIDIA)、Radek Osmulski(NVIDIA)、Ronay Ak(NVIDIA)、Gabriel de Souza Pereira Moreira(NVIDIA)、Mengyao Xu(NVIDIA)