晓|ICLR'25中科大提出MindSearch:AI查资料3分钟顶3小时
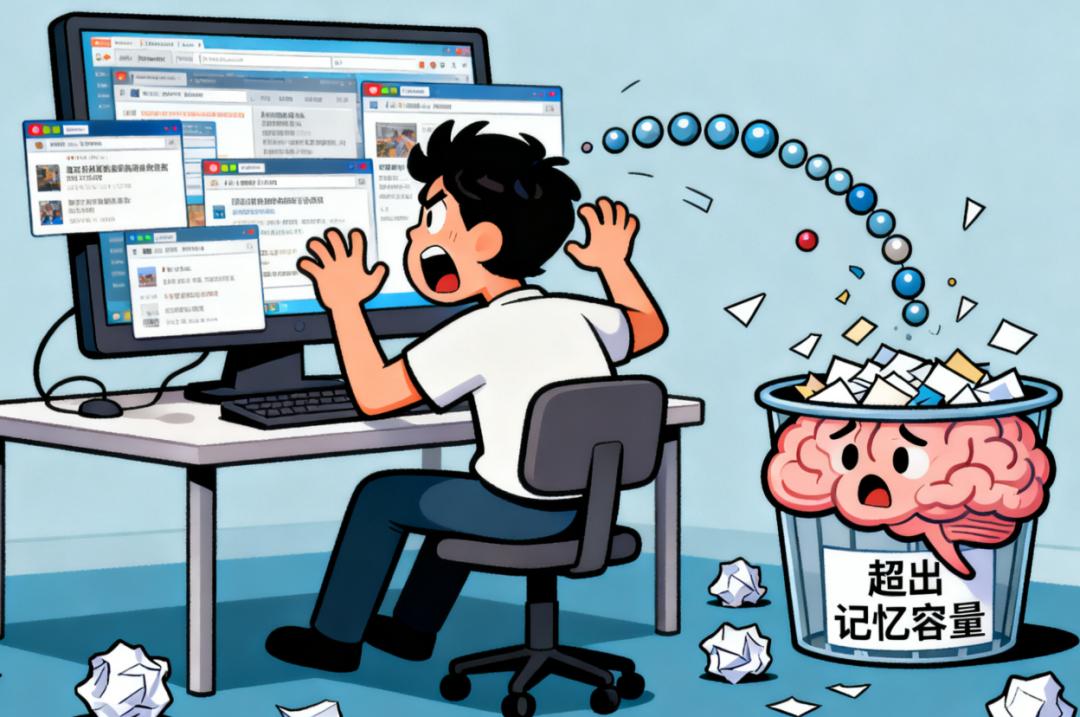
搜索“总结2023年NeurIPS、ICML、ICLR三大ML顶会的最佳论文,还要分析热门领域趋势”,搜了十几页结果:有的只说某个会议论文分析,有的提了最佳论文但是没有趋势,零散得像没串起来的珠子;让AI回答,它倒是说得头头是道,结果一半细节查不到来源,疑似“瞎编”;更糟的是,好不容易攒了一堆资料,AI又弹出“内容太多,超出我的记忆容量”——这是不是你查复杂信息时的日常崩溃?
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
最近我在读ICLR 2025的一篇论文时,突然眼前一亮:来自中科大和上海AI实验室的团队,搞出了个叫MindSearch(中文名“思·索”)的多智能体框架,居然把这些痛点优化了。它能像人一样“边思考边找信息”,3分钟就能完成原本要花3小时的资料搜集整合,甚至用开源的InternLM2.5-7B模型做出来的效果,比ChatGPT-Web(基于GPT-4o)和Perplexity.ai还受人类待见。今天就从研究员的角度,跟你聊聊这东西到底是怎么“读懂人心”的。
先搞懂:我们查复杂资料时,到底在“卡”什么?
在聊技术之前,得先说说我们面对“复杂问题”时,本质上在跟什么较劲。比如“总结2023年NeurIPS、ICML、ICLR三大ML顶会的最佳论文,还要分析热门领域趋势”,这种问题难就难在三点——这也是MindSearch要解决的核心痛点:
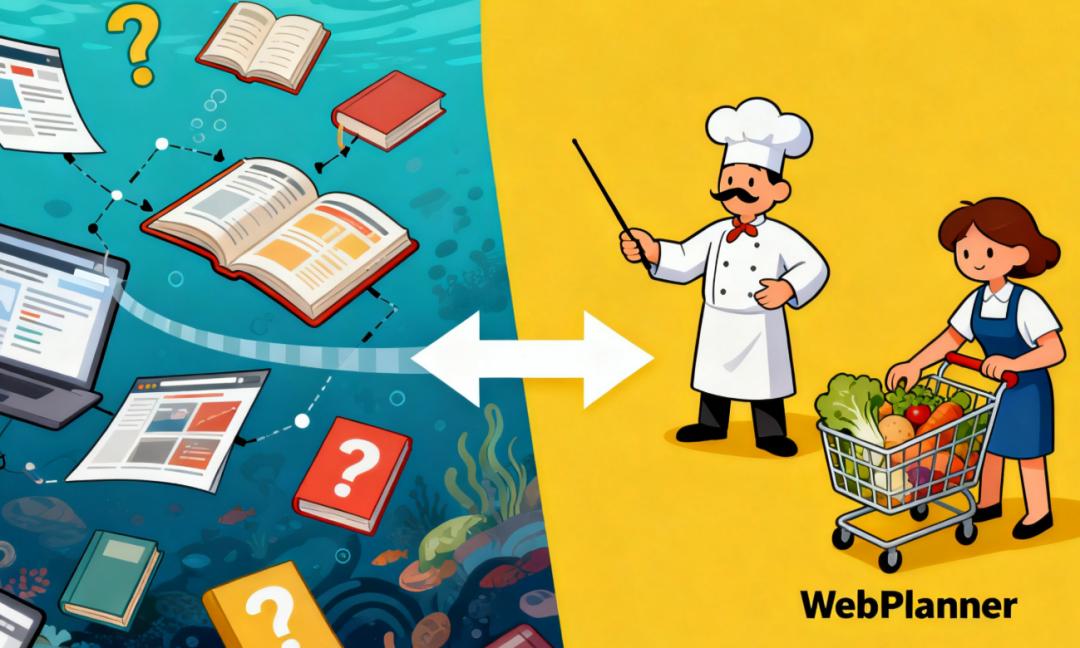
第一,“一次性搜不全”。你不可能用一个关键词就把三个顶会的最佳论文全揪出来,更别说还要趋势分析。就像你要办一场生日宴,不可能一趟超市就买齐蛋糕、食材、装饰——得拆成多个任务,可传统搜索工具要么“一次性乱买一堆”,要么“漏买关键项”。
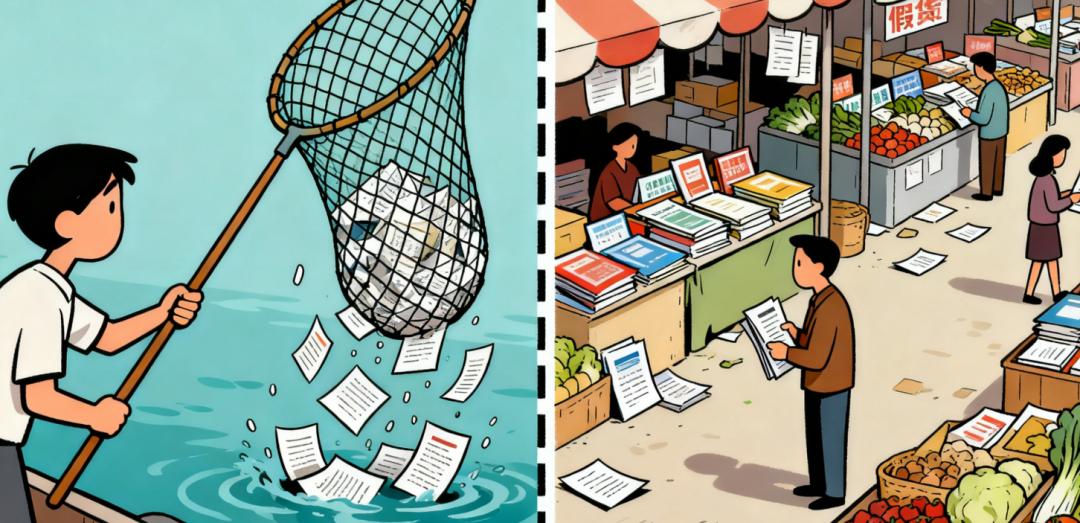
第二,“信息噪音太多”。搜出来的结果里,可能混着2022年的论文、非“最佳论文”的普通文章,甚至还有自媒体的片面解读。这就像你买食材时,摊位上混着不新鲜的菜、跟宴席无关的零食,挑半天才能找到能用的,特别费时间。
第三,“AI记不住太多东西”。就算你挑出20篇有用的网页,每篇几千字,LLM的“记忆容量”(也就是context length)根本装不下——相当于你买了一堆菜,厨房台面太小,根本摆不开,没法动手做饭。
我们团队之前也试过用传统的“检索增强生成(RAG)”解决这类问题,比如让AI先搜再写,但结果总是差强人意:要么搜得太浅,要么整合得太乱,本质上就是没解决这三个痛点。而MindSearch的巧妙之处,就在于它学了“人类解决复杂问题的思路”——先拆任务,再分工找信息,最后整合。
传统方法为啥不行?像“用勺子挖游泳池”
在MindSearch之前,行业里解决“AI+搜索”的思路主要有两种,都有点“治标不治本”:
第一种是纯LLM硬扛。就是让GPT-4o这类模型直接回答,实在不知道就“瞎编”。这就像你不查菜谱、不买食材,直接让厨师凭空做一桌宴席——偶尔能蒙对几道简单菜,但复杂的肯定翻车。实验里也能看出来,纯GPT-4o在HotpotQA(复杂多跳问答)的平均正确率只有53.5%,开源模型更是只有42.9%。
第二种是RAG或ReAct式搜索。RAG是“先搜一堆资料,再让AI总结”,像一次性买完所有菜再做饭,不管食材用不用得上;ReAct是“边搜边想”,比如先搜“NeurIPS 2023最佳论文”,拿到结果再搜“ICML的”,一步一步来。但这种方式效率太低,而且容易在中间步骤“走歪”——比如搜完NeurIPS,忘了还要分析趋势,最后漏了关键信息。实验里ReAct在GPT-4o上的正确率也只到55.1%,没比纯LLM好多少。
简单说,这些方法要么“没工具硬干”,要么“有工具但不会用”,就像用勺子挖游泳池,费了半天劲,进度还是慢得让人着急。
MindSearch的核心:让AI像“餐厅后厨”一样分工干活
MindSearch的突破,本质上是搞了个“AI版后厨团队”——两个核心角色:WebPlanner(相当于“主厨”)和WebSearcher(相当于“专业采购员”)。这俩角色分工明确、互相配合,完美解决了前面说的三个痛点。
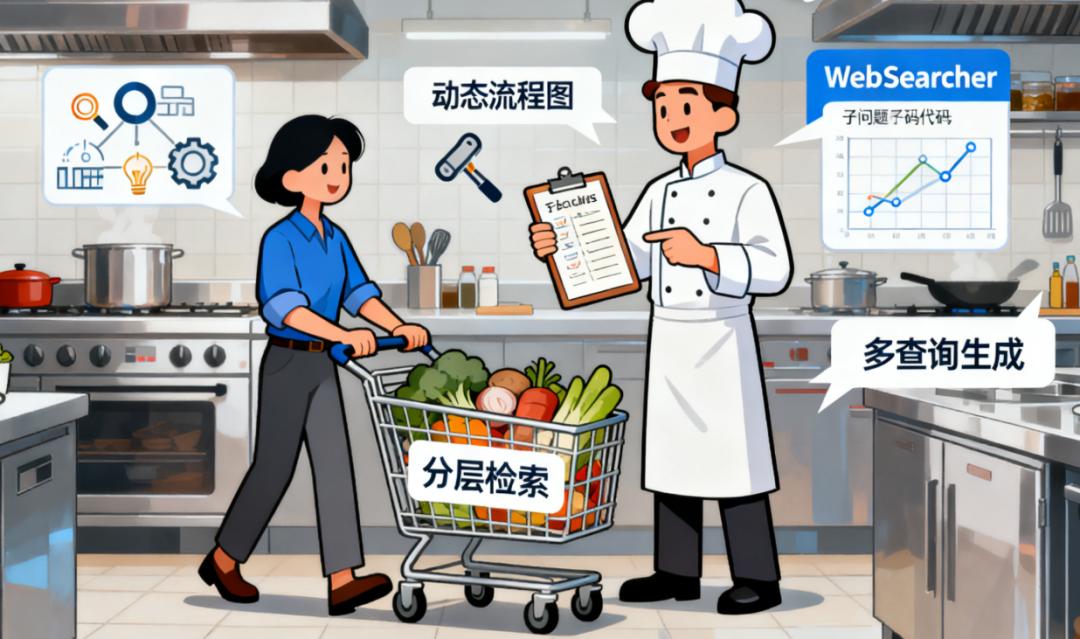
1. WebPlanner:“主厨”的活儿——把复杂问题拆成“可执行的采购清单”
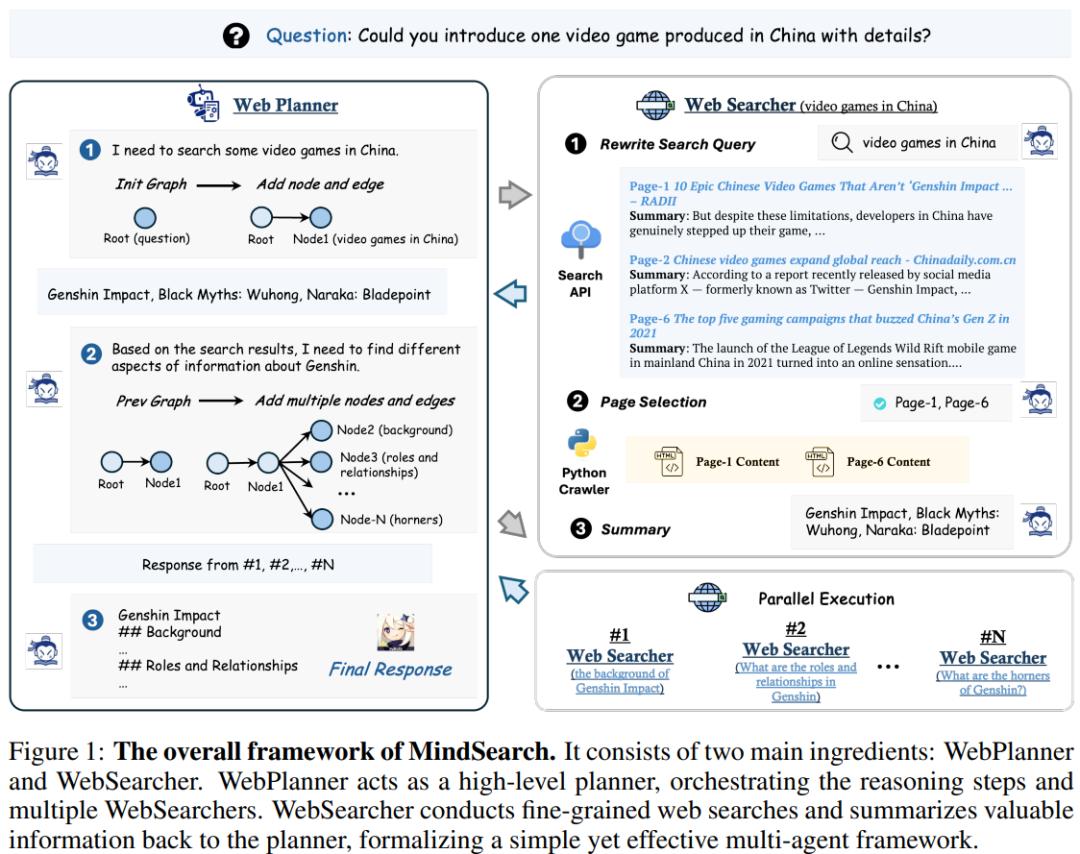
你去餐厅点“一桌融合菜”,主厨不会直接让采购员“买所有菜”,而是先拆成“买澳洲和牛”“买松露”“买日本米”这些具体需求,还会标清楚“哪些可以同时买”“哪些要等前一步买完再买”。WebPlanner干的就是这个活:把用户的复杂问题,拆成一个个“原子化子问题”,再用“动态流程图”(论文里叫DAG,不用记这个词)管理步骤。
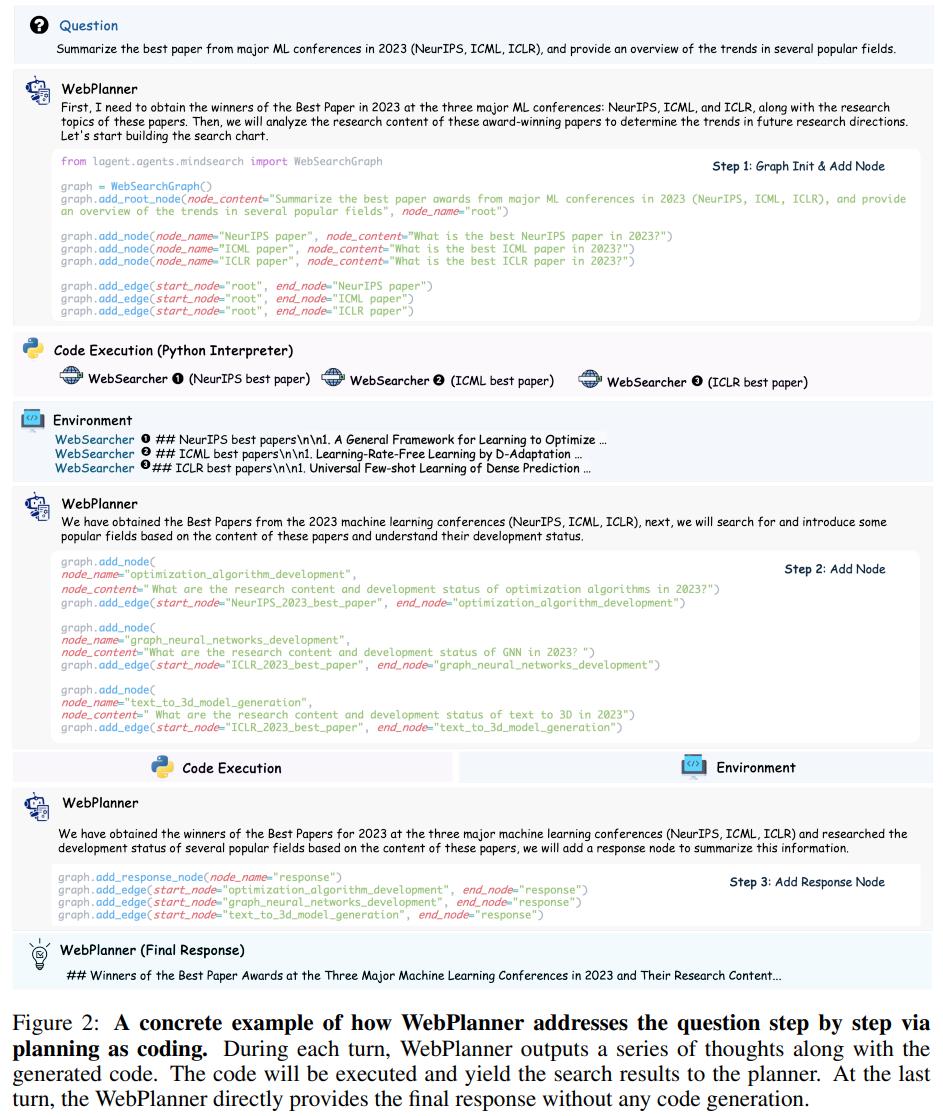
举个例子,用户问“介绍一款中国产的3A游戏,要细节”:
• WebPlanner先把问题拆成“中国有哪些3A游戏”“原神的开发背景”“原神的玩法核心”“原神的全球销量”这些子问题——每个子问题都像一个“采购需求”,只聚焦一个点,不贪心。
• 然后它会画个“流程图”:先搜“中国3A游戏列表”(这是第一步),拿到结果后,再同时搜“原神”“黑神话:悟空”的细节(这些可以并行,不用等一个搜完再搜)——就像主厨让采购员同时去肉铺和蔬菜铺,节省时间。
这里最让我惊讶的是,WebPlanner还用“写代码”的方式来管理这个流程图。你可能会问:“让AI写代码?这不是更复杂了吗?”其实反而是为了“更精准”。就像主厨写清楚“买500克M9和牛,不要冻肉”,比口头说“买些好牛肉”更不容易出错。如果代码写错了(比如子问题重复了),Python解释器会报错,WebPlanner能马上修正——相当于采购员发现清单写错了,立刻跟主厨确认,不会买错东西。
我们之前做类似任务时,最头疼的就是“AI拆问题拆得太粗”,比如把“原神玩法+销量”放一个子问题里,结果搜出来的信息混在一起,不好整合。MindSearch这种“代码化拆分工单”的方式,很好优化了这个问题。
2. WebSearcher:“采购员”的活儿——精准找信息,不买“没用的菜”
采购员接到清单后,不会随便乱买:先去多个市场看看(广撒网),再挑靠谱的摊位(选网页),最后只买新鲜的食材(提取关键信息)。WebSearcher的“分层检索”就是这个逻辑,显著优化了“信息噪音多”和“AI记不下”的问题。
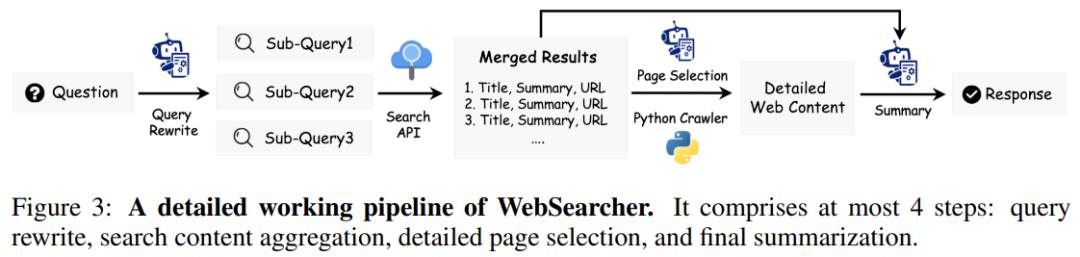
具体分三步:
• 第一步:“多问几个渠道”。比如要搜“原神全球销量”,WebSearcher不会只搜“原神销量”,还会生成“Genshin Impact global sales 2024”“原神各地区收入占比”等多个相关查询——就像采购员去超市、农贸市场、线上平台都问一遍,确保不漏掉关键信息。
• 第二步:“挑靠谱的摊位”。搜出来的结果可能有100个网页,WebSearcher会先看标题和摘要,挑出“米哈游官方财报”“Newzoo游戏行业报告”这种靠谱来源,排除“玩家论坛猜测”“过时的2021年数据”——相当于采购员只在口碑好的摊位买,避免买到假货。
• 第三步:“只带有用的食材回来”。WebSearcher会把挑中的网页内容提炼成“关键信息”(比如“2024年原神全球累计收入超60亿美元,移动端占比70%”),再交给WebPlanner——不会把整个网页的几万字都塞给AI,完美解决“记忆容量不够”的问题。
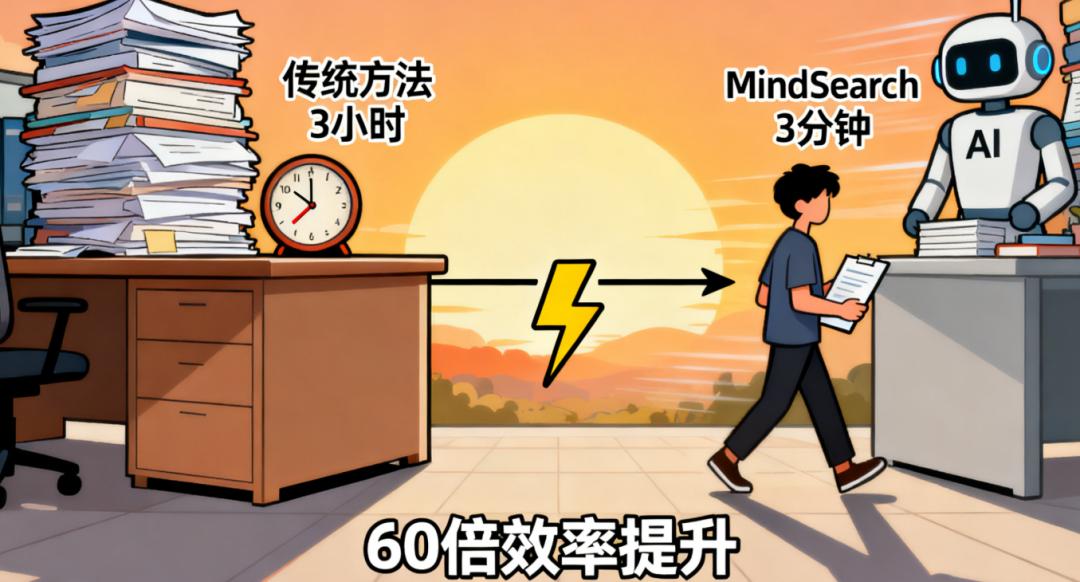
实验里能看出来,这种方式效率极高:MindSearch能在3分钟内处理300多个网页的信息,而人类要干3小时——相当于你花喝一杯咖啡的时间,搞定原本要一下午的查资料工作。
它到底比别人强在哪?三个“反常识”的创新
MindSearch能在实验里“打败”ChatGPT-Web和Perplexity.ai,不是靠“模型更牛”,而是靠“流程更聪明”。有三个创新点,我觉得特别值得说:
1. 不是“先搜再想”,而是“边想边搜,动态调整”
传统方法都是“先搜一堆资料,再整理”,就像采购员先买完所有菜,再让主厨想怎么做。而MindSearch是“主厨边想菜单,边让采购员补买食材”——比如WebPlanner先让WebSearcher搜“原神开发背景”,拿到结果发现“原神用了自研的Anime Shading技术”,马上新增一个子问题“原神的Anime Shading技术细节”,让WebSearcher再去搜。
这种“动态调整”特别适合复杂问题,就像你写报告时,越查越发现有新的关键点要补充,MindSearch能自动跟上这种“思考节奏”,而不是一开始就定死所有步骤。
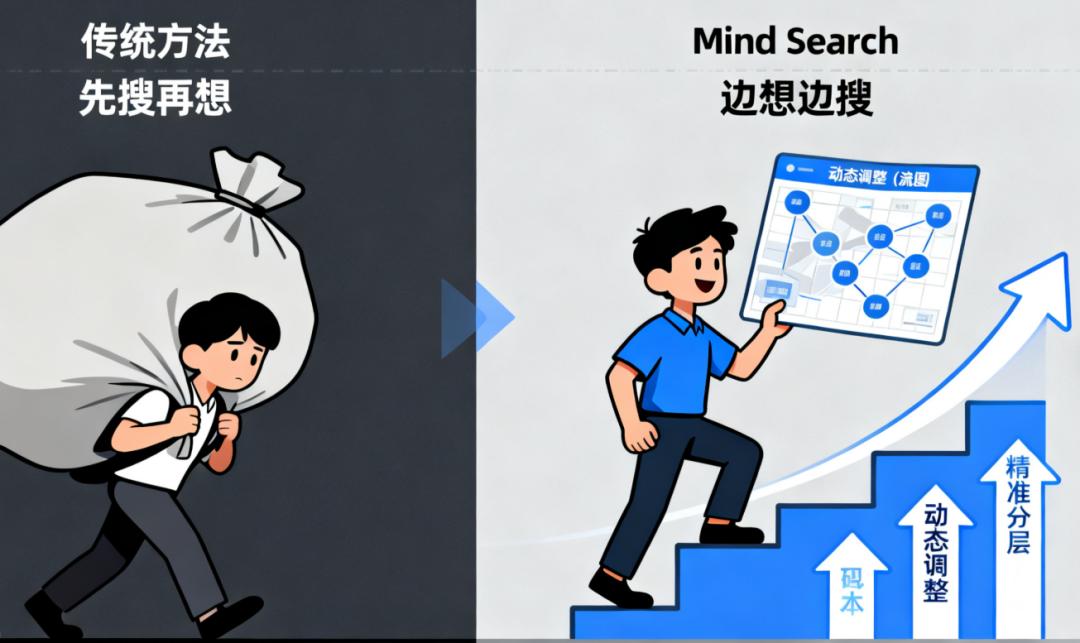
2. 不是“信息越多越好”,而是“精准分层,过滤噪音”
很多人觉得“AI搜信息,越多越好”,但MindSearch反其道而行之:通过“多查询生成→网页筛选→信息提炼”的分层步骤,主动“扔掉没用的信息”。就像优秀的采购员不会买一堆菜回来占地方,而是只买“用得上、质量好”的——这样既减轻了AI的“记忆负担”,又提高了信息的准确性。
实验里也能验证这一点:如果去掉“多查询生成”这个步骤,MindSearch的正确率会从64.0%降到60.6%;去掉“网页筛选”,会降到58.0%——可见“过滤噪音”比“多搜信息”更重要。
3. 开源模型也能打赢闭源,靠的是“流程优化”
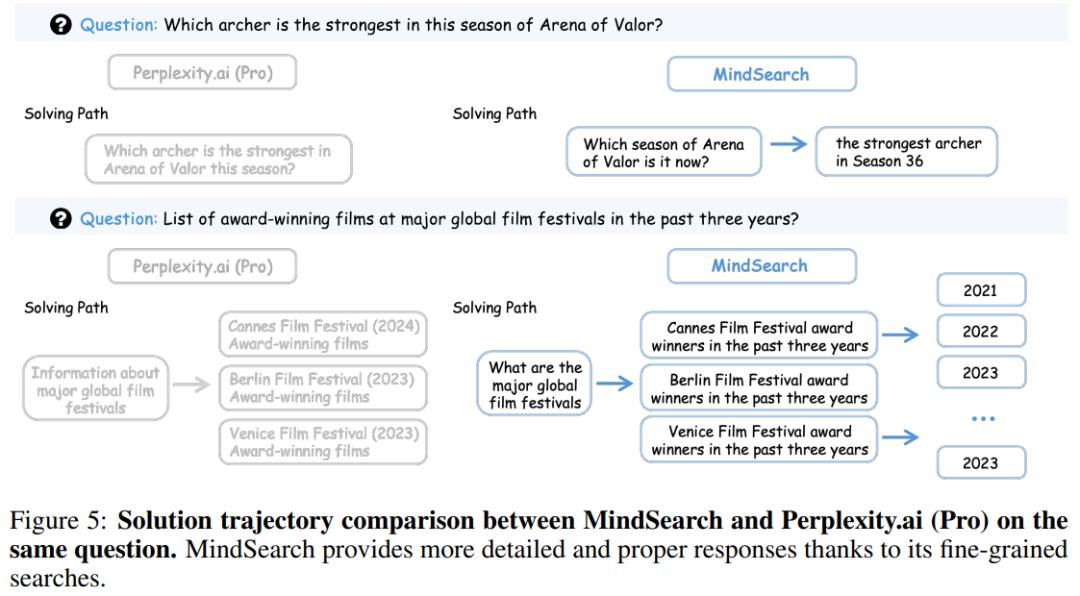
这是最让我意外的一点:用开源的InternLM2.5-7B(参数只有70亿)做的MindSearch,居然在人类评价中超过了用GPT-4o(闭源大模型)的ChatGPT-Web。原因很简单:闭源模型虽然“脑子好”,但没“好工具”;而MindSearch给开源模型配了“精准拆任务+高效找信息”的工具,相当于给普通厨师配了“专业采购员+精准菜谱”,最后做出的菜反而比“天才厨师但没工具”更好。
这对行业来说是个好消息:以后不用非得依赖闭源大模型,用开源模型+好的流程设计,也能做出高质量的AI搜索工具。
实际用起来怎么样?人类评估说了算
光说原理没用,得看实际效果。团队做了两个关键实验,结果很有说服力:
第一个是“人类主观评价”:找5个专家,盲测MindSearch(InternLM2.5-7B)、ChatGPT-Web(GPT-4o)、Perplexity.ai Pro的回答,从“深度”“广度”“事实性”三个维度打分。结果是:
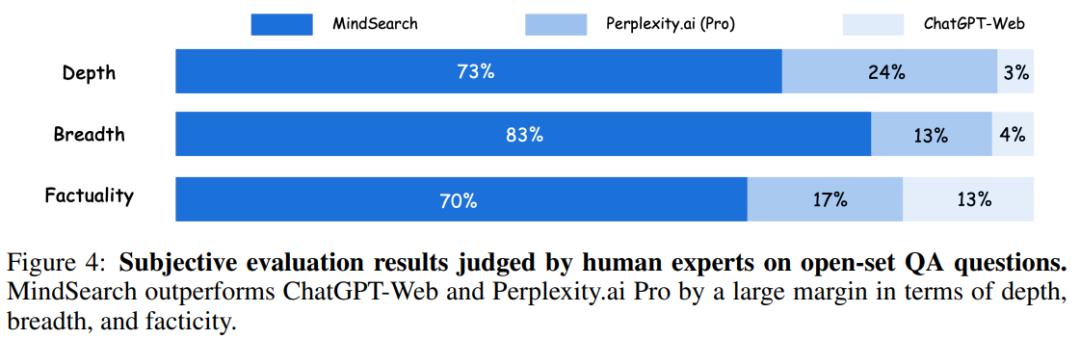
• 深度:MindSearch 83% vs ChatGPT-Web 73% vs Perplexity 70%——比如回答“嫦娥六号采样难点”,MindSearch会详细说“鹊桥二号中继卫星怎么解决通信”,而其他工具可能只提“有通信问题”。
• 广度:MindSearch 73% vs 其他两个分别是24%和17%——比如回答“3A游戏”,MindSearch会覆盖开发、玩法、销量、技术,其他工具可能只说玩法。
• 事实性:MindSearch 70%,跟其他两个差不多——这是目前的小短板,团队说未来会优化“信息溯源”,减少瞎编的可能。
第二个是“闭集QA测试”(比如HotpotQA):用GPT-4o和InternLM2.5-7B分别跑MindSearch和传统方法。结果是:
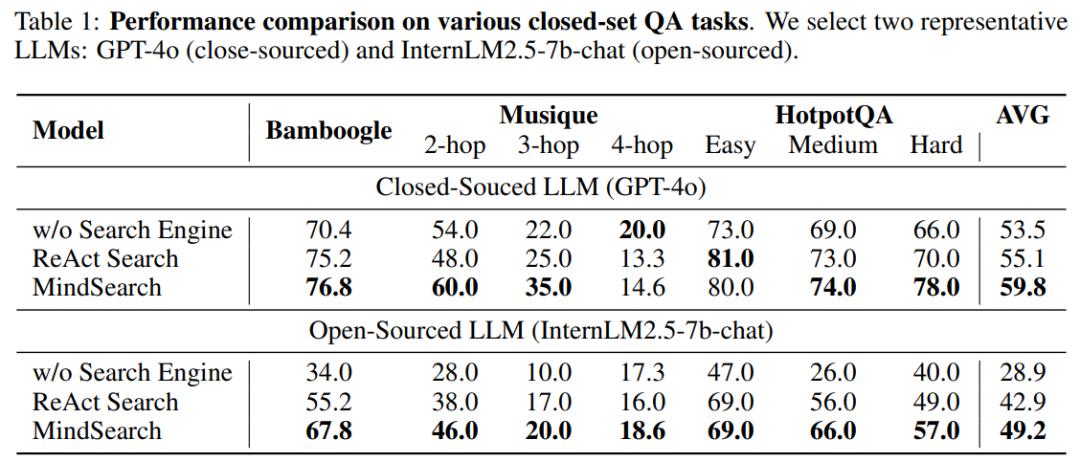
• GPT-4o+MindSearch的正确率是59.8%,比纯GPT-4o(53.5%)高6.3%;
• InternLM2.5-7B+MindSearch的正确率是49.2%,比纯开源模型(42.9%)高6.3%——而且越复杂的问题(比如“多跳问答”),MindSearch的优势越明显。
简单说:MindSearch不是“让AI更聪明”,而是“让AI更会干活”——就像一个普通团队,靠好的分工和流程,能打赢比自己“单兵能力强”但没章法的对手。
现在还不完美,但方向很亮
当然,MindSearch不是“万能的”,还有几个明显的局限,团队也在论文里坦诚说了:
第一,不能处理视觉信息。如果用户问“原神的角色设计风格有什么特点”,需要看图片对比,MindSearch现在还做不到——只能处理文字信息。
第二,不能跟网页互动。比如要查“某游戏的最新更新日志”,需要点进官网的“更新公告”页面,MindSearch现在只能搜现成的网页结果,不能主动“点击、跳转”网页。
第三,引用质量没评估。虽然它会标注信息来源,但没判断“这个来源靠不靠谱”——比如引用了“玩家论坛的猜测”和“官方财报”,现在还没法区分优先级。
但这些都是“可以改进的问题”,不是方向错了。我觉得MindSearch的最大价值,是给行业指了一条路:未来的AI搜索工具,核心竞争力不是“模型多大”,而是“能不能像人一样思考、分工、解决复杂问题”。
最后:这东西对我们普通人意味着什么?
可能你会说:“这跟我有啥关系?我又不做学术研究。”其实关系很大——以后你查复杂信息,可能再也不用“搜半天、理不清、怕瞎编”了:
比如你想“给父母选一款适合的养老医疗险”,MindSearch能拆成“2024年主流养老医疗险有哪些”“某款产品的报销范围”“60岁以上老人的投保条件”“用户理赔案例”这些子问题,自动找信息、整合答案,甚至对比不同产品的优缺点——不用你自己翻十几页保险条款,也不用怕AI瞎编“理赔成功率”。
再比如学生写论文,要“分析某部电影的社会影响”,MindSearch能自动搜“电影的票房数据”“影评人评价”“社会学论文对它的分析”“观众调研结果”,还会标注来源,避免抄袭风险。
就像当年搜索引擎把“查资料”从“跑图书馆”变成“在家点鼠标”,MindSearch这类工具可能会把“查复杂资料”从“崩溃的几小时”变成“轻松的几分钟”。
如果你也有过“查资料查到崩溃”的经历,或者对“AI怎么像人一样思考”感兴趣,欢迎在评论区聊聊——你平时查复杂信息时,最头疼的是什么?
参考资料:
• 标题:MINDSEARCH: MIMICKING HUMAN MINDS ELICITS DEEP AI SEARCHER
• 作者:Zehui Chen∗1, Kuikun Liu∗2, Qiuchen Wang1, Jiangning Liu2, Wenwei Zhang2, Kai Chen2†, Feng Zhao1†
• 单位:1MoE Key Laboratory of Brain-inspired Intelligent Perception and Cognition, USTC; 2Shanghai AI Laboratory
• 链接:https://openreview.net/pdf?id=xgtXkyqw1f