阿里通义DeepResearch技术报告解读:开源深度研究智能体新标杆
我们在做长周期科研型Agent时,曾连续卡壳两个核心问题:一是标注多步推理轨迹的成本高到离谱——为了训练模型“分解问题→搜文献→验证结论”的流程,标注千条高质量科研级轨迹花了近万元,还达不到训练所需的规模;二是RL训练后期总出现“策略崩溃”——明明前期模型能正常调用工具,越训反而越容易陷入“重复搜同一关键词”的死循环。直到看到阿里Tongyi Lab发布的Tongyi DeepResearch技术报告,才发现他们不仅用全自动化方案解决了数据标注难题,还通过分阶段训练让305亿参数量模型仅激活33亿/Token,效率远超同类型闭源模型(比如OpenAI o3)。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
如果你也在做Agent开发、长上下文推理或科研级信息检索,这篇论文值得仔细拆解——它不仅给出了可复现的技术方案,还开源了模型、框架和工具链,相当于把“AI研究员”的训练手册直接摆在了桌面上。
一、先搞懂:Deep Research Agent的3个核心科研痛点
在聊方案前,得先明确一个前提:“Deep Research Agent”和普通问答模型完全不是一回事。普通模型比如ChatGPT-4o能回答已知问题,但面对“2024年某西部矿区发现的新矿物,其成分与19世纪某纪念币的金属成分是否存在关联”这类需要多步推理、实时搜信息、跨源验证的问题,就会束手无策。而Deep Research Agent要做的,正是模拟人类研究员的工作流:从问题拆解到信息检索,再到结论合成,全程自主完成。
但实际开发中,这三类痛点几乎是所有团队的“必踩坑”:
1. 数据瓶颈:科研级轨迹标注“又贵又慢”
训练Agent需要大量“问题→多步行动→结论”的轨迹数据,但科研级问题的标注难度远超普通NLP任务。比如要标注“验证某历史人物的军事单位与货币发行的关联”,标注员不仅要懂历史背景,还要还原“先搜人物履历→确认军事单位→查货币发行年份→验证冲突时间”的完整逻辑链。论文里引用Wei et al. 2025的研究指出,这类数据的标注成本是普通对话数据的10倍以上,中小团队根本扛不住。
更麻烦的是,自然数据里几乎没有这类轨迹——你没法从网页上直接爬取“研究员思考+行动”的完整记录,只能靠人工造,这就陷入了“要训练模型先有数据,要有数据先有模型”的死循环。
2. 训练不稳定:从“会做事”到“乱做事”的策略崩溃
我们之前用Llama2-7B做Agent微调时,遇到过一个诡异现象:前5个epoch模型还能正常规划步骤(比如先搜“某矿物成分”再对比“纪念币成分”),到第6个epoch突然开始“瞎操作”——反复调用搜索工具搜同一个关键词,或者跳过关键验证步骤直接给结论。这就是论文里说的“policy collapse(策略崩溃)”。
后来才明白,问题出在“训练范式”上:普通LLM是先预训练再指令微调,但Agent需要“会行动”的直觉(比如什么时候该搜、什么时候该总结),而通用预训练数据里没有这种“Agent偏置”。直接在通用LLM上做RL训练,就像让没学过实验操作的学生直接进实验室,很容易走偏。
3. 效率与成本:大模型“吃资源”却不“干活”
之前试过用13B参数量的模型做Deep Research,结果发现两个问题:一是全参激活时单条轨迹推理要10多秒,训练一轮要一周;二是长上下文(比如64K)下,模型会“记不住前面的搜索结果”,导致推理断裂。而闭源模型比如OpenAI DeepResearch虽然效果好,但既看不到中间过程,也没法部署到私有环境,科研和产业落地都受限。
二、Tongyi DeepResearch的核心方案:从“数据→训练→环境”的全链路破局
这篇论文最让我惊艳的,不是某一个单点创新,而是把“数据合成、分阶段训练、环境设计”串成了一个闭环——就像给AI研究员设计了一套“从入门到精通”的培养体系,每个环节都解决了前面提到的痛点。
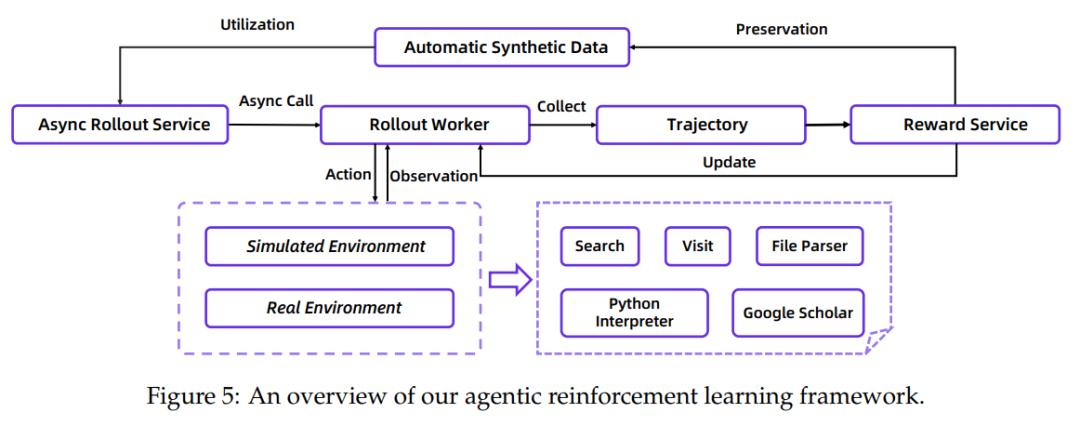
1. 先解决数据:全自动化合成,不用人工标注
他们设计了一套“全自动数据合成流水线”,相当于造了一个“AI标注员”,能批量生成科研级的Agent轨迹。核心逻辑分三步,每一步都针对性解决数据问题:
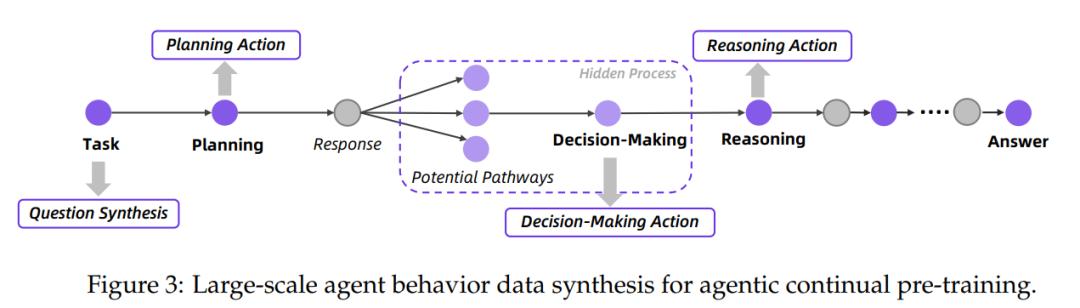
• 第一步:生成科研级问题——不是简单的“what/why”问题,而是需要多步推理的复杂问题。比如论文里的案例:“某18世纪游记改编的广播剧提到英国某港口走私猖獗,该港口还出了个16世纪绅士,其妻子因谋杀他被处决;19世纪初该港口有人获商业专利,同年某收藏家获油墨研磨专利,且某德国家族获贵族头衔——这个贵族头衔的德语称谓是什么?”(答案是Fürstenstand)。
生成这类问题的关键是“实体锚定”——先建一个包含实体(人物、地点、事件)和关联知识的知识库,再随机抽样实体组合成问题,保证问题的复杂性和真实性。这就像研究员设计实验时,会基于已有文献的知识点组合出新课题,而不是凭空捏造。
• 第二步:生成Agent行动轨迹——针对每个问题,自动生成“思考(Thought)→行动(Action)→观察(Observation)”的完整链。比如问题分解阶段,用开源模型生成“先查游记对应的港口→再查该港口的16世纪人物→接着查19世纪专利年份”的规划步骤;推理阶段,还会用“长度过滤+答案一致性验证”确保推理链没错(比如搜出港口是多佛尔,就不会把其他港口的人物混进来)。
这里有个细节很关键:他们把“决策”单独作为一种行动类型。比如模型在“继续搜还是总结结论”时,会生成“当前已有港口、人物、专利年份的信息,缺少贵族头衔的德语称谓,需要再搜‘19XX年德国家族贵族头衔 德语’”的决策过程。这恰好解决了我们之前模型“不知道什么时候停”的问题——因为数据里明确包含了决策逻辑,模型能学到“判断是否需要继续行动”的直觉。
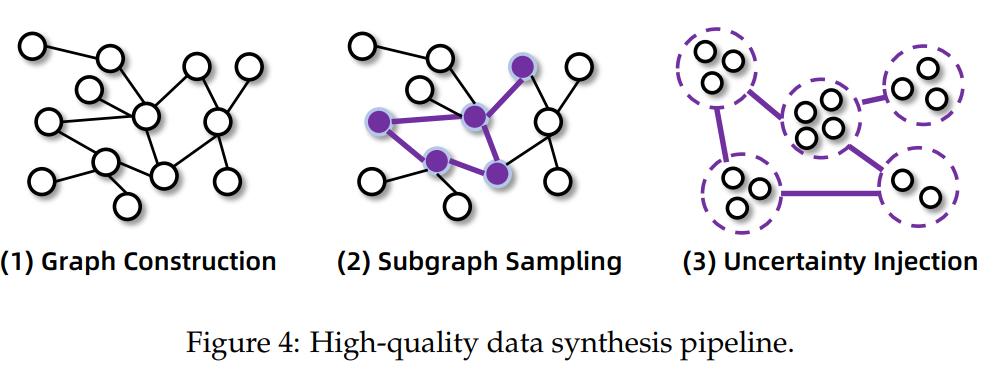
• 第三步:验证数据质量——合成的数据不是直接用,而是通过“自动验证”过滤低质量样本。比如数学问题会检查计算步骤是否正确,历史问题会验证时间线是否一致。这比人工验证快10倍以上,还能保证数据分布稳定——不会出现“有的样本简单,有的样本超难”的情况。
2. 再解决训练:中训+后训,避免策略崩溃
传统方案要么只做“预训练→后训”,要么直接在通用LLM上微调,而他们加了一个“Agentic Mid-training(中训)”阶段,相当于给模型加了“Agent启蒙课”,从根本上解决训练不稳定的问题。
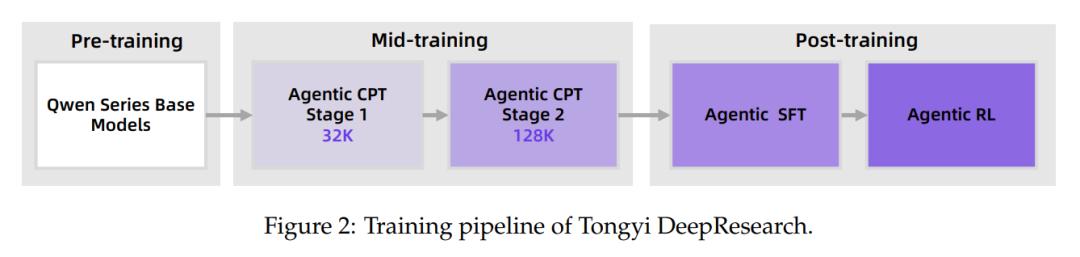
整个训练流程分三阶段,像极了研究生的培养路径:
这里有两个关键创新点,直接解决了我们之前的训练痛点:
• 中训阶段的“渐进式上下文”:先练32K再练128K,而不是一上来就用长上下文。我们之前试过直接用64K上下文训练,模型经常“记不住前面的步骤”,而这种渐进式训练让模型先掌握短序列的Agent逻辑,再扩展到长序列,就像研究员先做小实验,再做大课题,基础更牢。
• RL阶段的“动态数据筛选”:训练时会自动去掉两类样本——“模型每次都做对”的(没学习价值)和“模型每次都做错”的(太超纲,容易打击信心),只留“偶尔对偶尔错”的中等难度样本。我们之前就是因为没筛选样本,把太多超难样本混进去,导致模型越训越乱,而这个方法让RL训练的稳定性提升了不少。
3. 最后解决环境:分阶段设计,兼顾成本与真实度
Agent训练不能只靠数据,还需要和环境互动(比如调用搜索工具、访问网页),但真实环境贵、模拟环境假,这篇论文用“三种环境”解决了这个矛盾:
• Prior World Environment(先验世界环境):不用真实工具,靠模型已有的知识生成“模拟反馈”。比如模型调用“搜索‘多佛尔港口 16世纪人物’”,环境直接返回“多佛尔港口16世纪有XXX人物,其妻子因谋杀被处决”的模拟结果。这种环境零成本、无限量,适合中训阶段练基础动作,就像研究员先在“虚拟实验室”里练操作流程,再进真实实验室。
• Simulated Environment(模拟环境):基于2024年维基百科数据建本地知识库,用RAG工具模拟网页访问。比如模型要查“某纪念币发行年份”,环境会从本地维基数据里提取信息返回。这种环境比真实环境快10倍,成本低,适合RL阶段的快速迭代——我们之前用真实搜索API时,光QPS限制就导致训练中断过好几次,而模拟环境完全没这个问题。
• Real-world Environment(真实环境):对接真实的Google搜索、Google Scholar、Python解释器等工具,但加了一个“统一沙箱”——就像给工具加了“安全防护网”:比如搜索API超时会自动重试,关键数据会缓存,还能切换备用数据源(比如Google搜不到就用Bing)。这个设计解决了真实环境的“不稳定性”,我们之前因为API故障导致的训练数据污染,在这里几乎不会发生。
更聪明的是,他们会根据训练阶段切换环境:中训用Prior World+模拟环境,快速攒经验;后训先在模拟环境验证策略,再到真实环境做最终优化——既省成本,又保证了模型在真实场景的效果。
三、实验验证:3.3B激活参数量,干翻闭源模型?
看论文不能只看方案,关键要看实验能不能复现、效果是不是真的好。这篇论文的实验设计很扎实,覆盖了7个Deep Research核心 benchmark,还做了不少消融实验,能直接看到每个创新点的价值。
1. 核心结果:开源模型里的“性能天花板”
先看关键benchmark的对比:
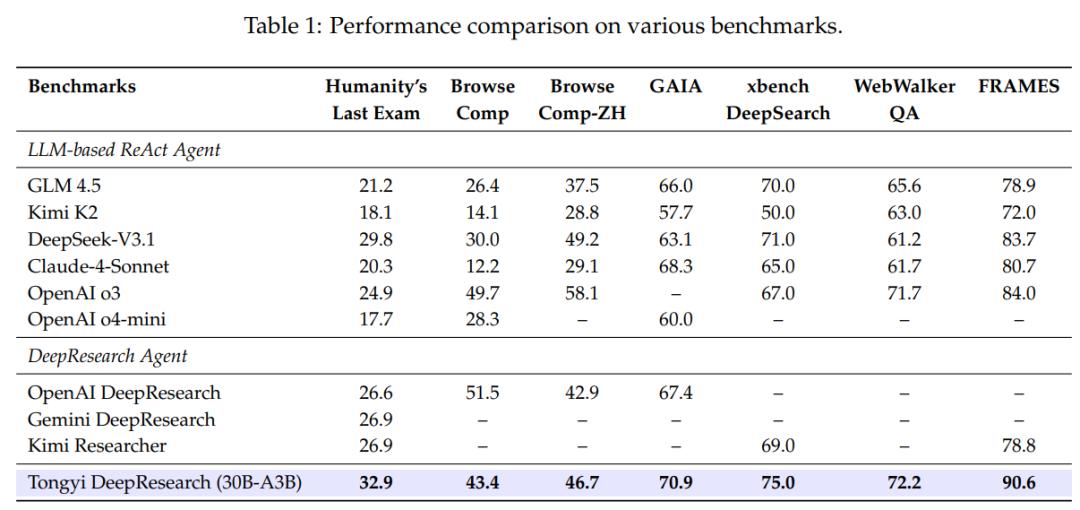
几个关键洞察:
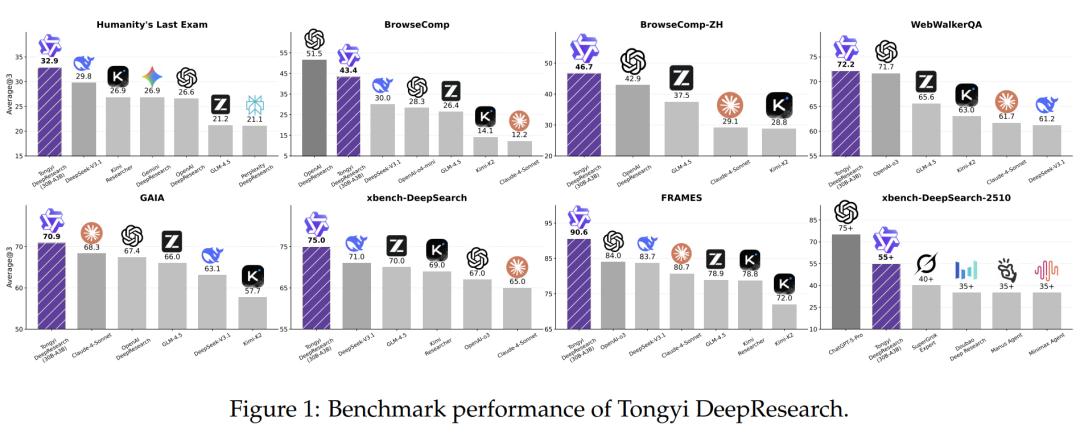
• 综合能力第一:在Humanity’s Last Exam(被称为“人类最后一场考试”,涵盖历史、科学等跨领域复杂问题)上,32.9分远超OpenAI o3的24.9分,甚至比DeepSeek-V3.1高3分——要知道这个benchmark里很多问题需要“搜文献+理时间线+验证结论”,模型能拿到这个分数,说明其多步推理能力确实过硬。
• 中文能力亮眼:BrowseComp-ZH虽然比OpenAI o3低,但作为开源模型,46.7分已经是优秀的开源模型(这里不得不提DeepSeekV3.1也在BrowseComp中是表现优秀的开源模型)。
• 效率优势明显:最关键的是,Tongyi DeepResearch总参数量305亿,但每Token仅激活33亿参——相当于用“低配硬件”跑出了“高配效果”。
2. Heavy Mode:靠“多Agent并行”再提性能
论文还提出了一个“Heavy Mode”,解决了“单Agent推理有局限”的问题——就像实验室里多个研究员分工合作,有人查文献、有人做实验、有人分析数据,最后汇总结论。
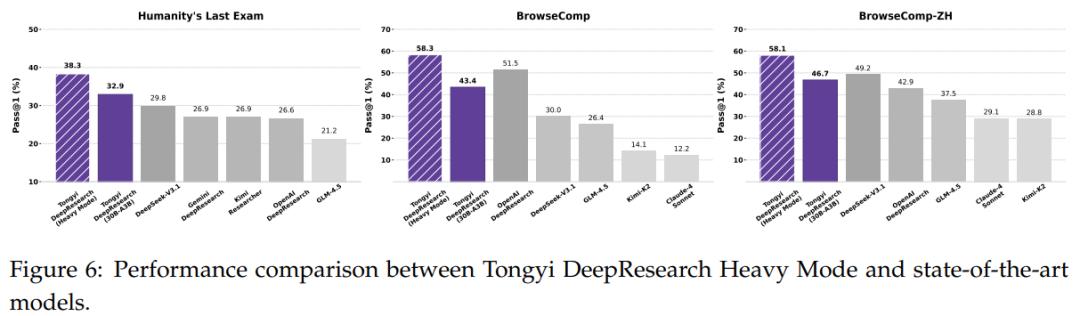
具体做法是:先让n个Agent并行处理同一个问题(每个Agent走不同的推理路径,比如A Agent先搜人物,B Agent先搜港口),每个Agent输出压缩后的“报告摘要”(只留关键信息,去掉冗余步骤);再让一个“合成模型”把这些摘要整合,给出最终答案。
这个模式的效果很明显:在Humanity’s Last Exam上,Heavy Mode把分数从32.9提到了38.3,BrowseComp-ZH从46.7提到58.1——直接追平了OpenAI o3的中文成绩。更重要的是,因为每个Agent输出的是“压缩摘要”,即使n=5,也不会超出128K上下文限制,这比“拼接全轨迹”的方案高效多了。
四、落地前景与待解挑战:这篇论文对科研和产业的意义
聊完技术,更要想它的实际价值——对我们做AI科研的人来说,这篇论文的意义不止是“一个新模型”,更是一套“可复现的Deep Research Agent开发范式”。
1. 对科研的价值:降低中小团队的研究门槛
之前做Agent研究,要么靠闭源API(看不到中间过程,没法做机理分析),要么自己搭框架(数据、训练、环境全要自己写,光调试工具调用就花1个月)。而Tongyi DeepResearch开源了三个关键东西:
• 模型权重:在Hugging Face和ModelScope上能直接下载(https://huggingface.co/Alibaba-NLP/Tongyi-DeepResearch-30B-A3B);
• 训练框架:包含数据合成、RL训练的完整代码:https://github.com/Alibaba-NLP/DeepResearch
• 工具链:搜索、访问网页、解析文件的工具实现,甚至还有模拟环境的维基数据集。
这意味着中小团队不用从零开始,拿过来改改就能做自己的Agent研究——比如要做“AI辅助材料科研”,直接用他们的数据合成 pipeline 生成“某材料的制备工艺→性能测试→文献对比”的轨迹,训练周期从2个月缩短到2周。
2. 对产业的价值:适合私有部署的“AI研究员”
产业场景里,很多企业需要“能在内部网络用的科研型Agent”——比如药企要分析临床试验数据、车企要查专利文献,这些都不能用公有云的闭源模型。而Tongyi DeepResearch的优势在于:
• 可私有部署:代码和模型全开源,能部署到内部服务器;
• 效率高:3.3B激活参数量,不用顶配GPU也能跑;
• 可定制:数据合成 pipeline 能接入企业私有知识库(比如药企的内部文献库),生成针对性的训练数据。
3. 待解的挑战:不要神化,还有改进空间
客观说,这篇论文也不是完美的,还有几个待解决的问题:
• 长上下文局限:128K虽然比很多模型长,但面对“整本学术专著的分析”还是不够——比如要对比某本书里10个章节的观点,模型可能记不住前面章节的内容;
• 报告生成质量:目前模型输出的是“准确的结论”,但缺乏“研究员式的叙事逻辑”(比如为什么这个结论重要、有哪些局限性),这对需要写科研报告的场景来说还不够;
• 多模态支持:目前只能处理文本,没法分析图片、表格(比如科研论文里的实验数据图),而真实科研中多模态信息很重要。
五、总结:这篇论文为什么值得你关注?
如果你是AI研究员,这篇论文给了你一套“从数据到落地”的全链路方案,能帮你跳过我们之前踩过的“数据贵、训练乱、效率低”的坑;如果你是产业界的技术负责人,这篇论文提供了一个“可私有部署、高性价比”的科研型Agent选项,能降低企业的AI落地成本。
最核心的是,它证明了“开源Deep Research Agent也能做到接近闭源模型的效果”——以前大家觉得“Agent是闭源模型的天下”,但这篇论文打破了这个认知,让更多团队有机会参与到Agent的研究中。
最后,抛一个我们在复现中遇到的问题:你们在训练RL阶段时,有没有遇到过“reward突然掉为0”的情况?我们后来发现是模拟环境的知识库没及时更新,导致模型搜不到正确信息,进而拿不到奖励。如果你们也遇到过类似问题,欢迎在评论区交流解决思路。
参考资料
• 标题:Tongyi DeepResearch: An Open-Source Agentic Large Language Model for Long-Horizon Deep Information-Seeking Research Tasks
• 作者:Tongyi DeepResearch Team (Alibaba Group Tongyi Lab)
• 链接:https://arxiv.org/pdf/2510.24701