CVPR'25 微软 Magma:多模态AI智能体基础模型,融会贯通数字物理
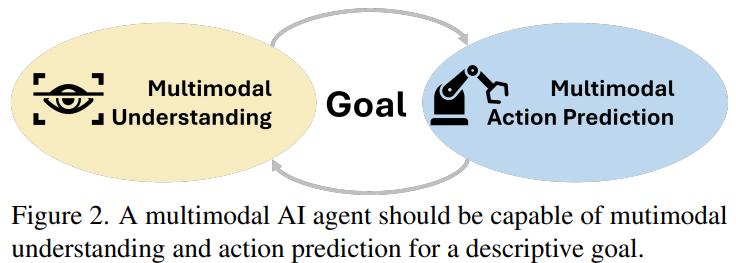
你有没有过这样的经历:对着语音助手说“把客厅空调调到26度,再让扫地机器人扫下卧室”,它要么只听懂一半,要么干脆卡壳;手机里的“自动操作”功能,连“打开外卖软件-选常点店铺-加购物车”这点小事都做不明白;更别说那些实验室里的机器人,换个杯子就不会抓,换个桌面就找不到东西——明明都是AI,怎么在不同场景下就这么“不灵光”?
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
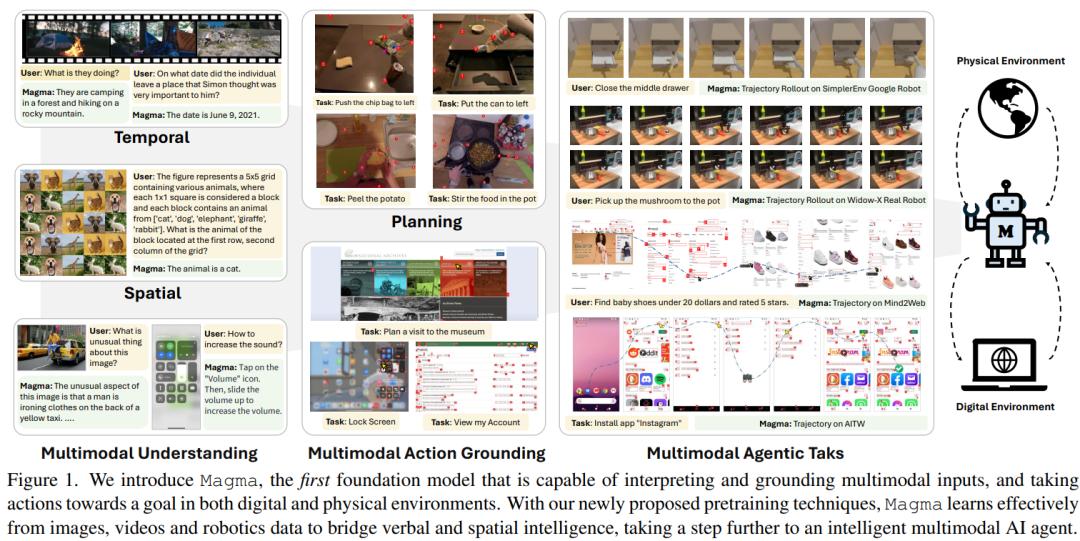
最近我在研究微软CVPR2025发布的Magma模型论文时,突然意识到:这可能是第一个真正解决AI“偏科”问题的方案。它让AI既能流畅操作手机UI、网页,又能精准控制机器人搬东西,甚至还能看懂视频里的动作逻辑——就像一个人既能用电脑办公,又能做饭打扫,终于摆脱了“只会干一件事”的局限。今天我们讲讲这个可能改变未来AI形态的技术。
先聊个扎心的:我们的AI其实都是“偏科生”
在Magma出现之前,AI圈有个特别尴尬的现状:每个AI都是“专科生”,换个领域就歇菜。
你比如做“数字世界”任务的AI,比如手机UI智能体、网页自动操作,它们就像只会用电脑的“宅男”——能精准找到“下单”按钮在哪,能在网页里填表单,但你让它指挥机器人拿个杯子,它连“杯子在哪”都判断不出来;而做“物理世界”任务的AI,比如实验室里的机器人,又像只会干体力活的“搬运工”——能抓东西、推盒子,但你让它在手机上订张机票,它连“日期选择框”都认不出。
为啥会这样?核心问题有两个:
第一,训练“教材”不一样。UI AI练的是屏幕截图和按钮坐标,机器人AI练的是3D摄像头数据和机械臂角度,两者的“语言”完全不通。就像一个学中文的和一个学俄语的,没法交流。
第二,能力侧重不一样。UI AI需要“精准定位”——比如在100个按钮里找到“付款”键;机器人AI需要“空间预判”——比如知道抓杯子要从上方下手,而不是侧面;但传统模型只能练其中一种,没法兼顾。
我们做过UI智能体相关的研究,当时就卡在一个问题上:明明机器人AI里有“判断物体位置”的能力,却没法移植到UI任务里;反过来,UI AI的“精准点击”逻辑,机器人也用不上。直到看到Magma,我才明白:原来我们缺的不是“单项技能”,而是一个能让AI同时学会“看、懂、做”的“统一训练方法”。
Magma的破局思路:给AI装“统一操作手册”和“预判眼”
Magma的核心创新,说到底就两件事:给AI一套“不管在数字还是物理世界都能用的操作手册”(SoM),再给它一双“能预判下一步动作的眼睛”(ToM)。
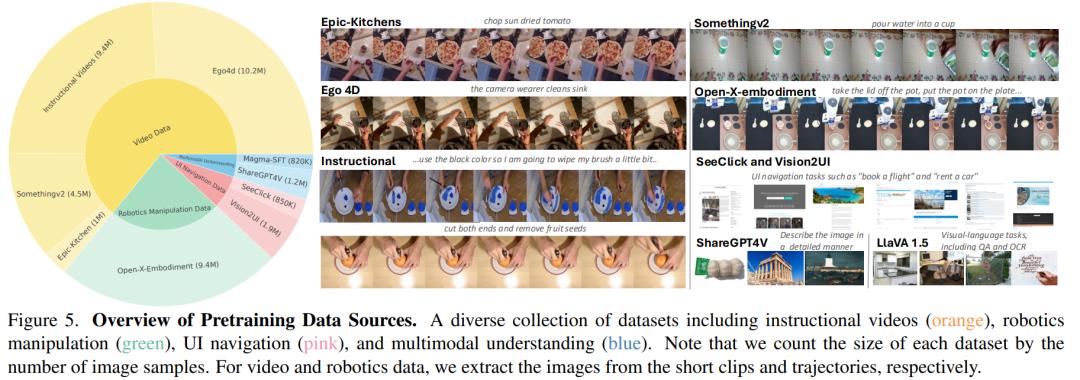
先别急着记术语,我举两个生活里的例子,你马上就懂。
1. 统一操作手册(SoM):给“可操作的东西”贴标签
你有没有过这种经历:家里遥控器太多,分不清哪个键控制空调,哪个控制电视?后来你在每个遥控器上贴了标签,写着“空调-开关”“电视-换台”,瞬间就清楚了——SoM的逻辑就和这个一模一样。
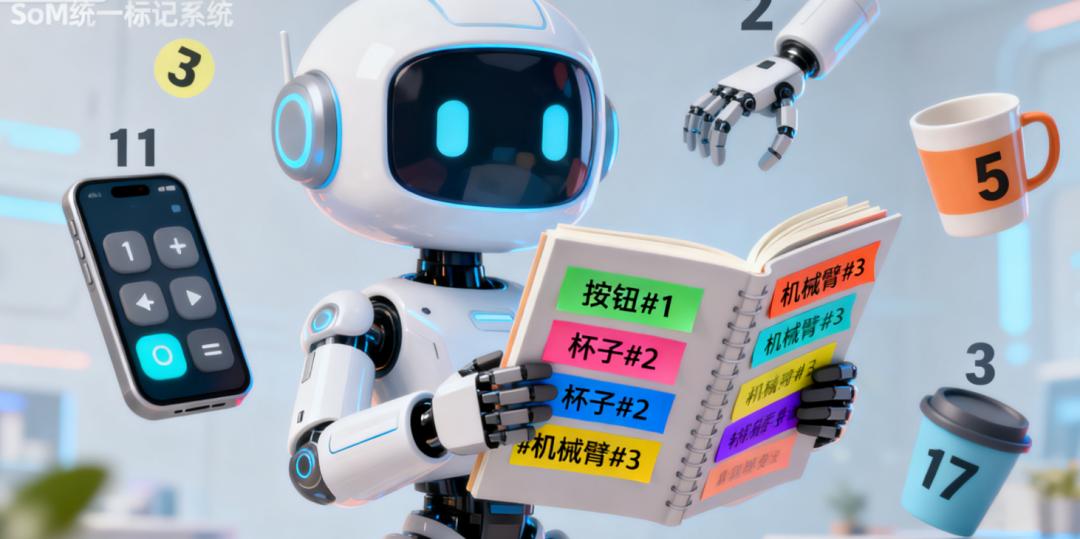
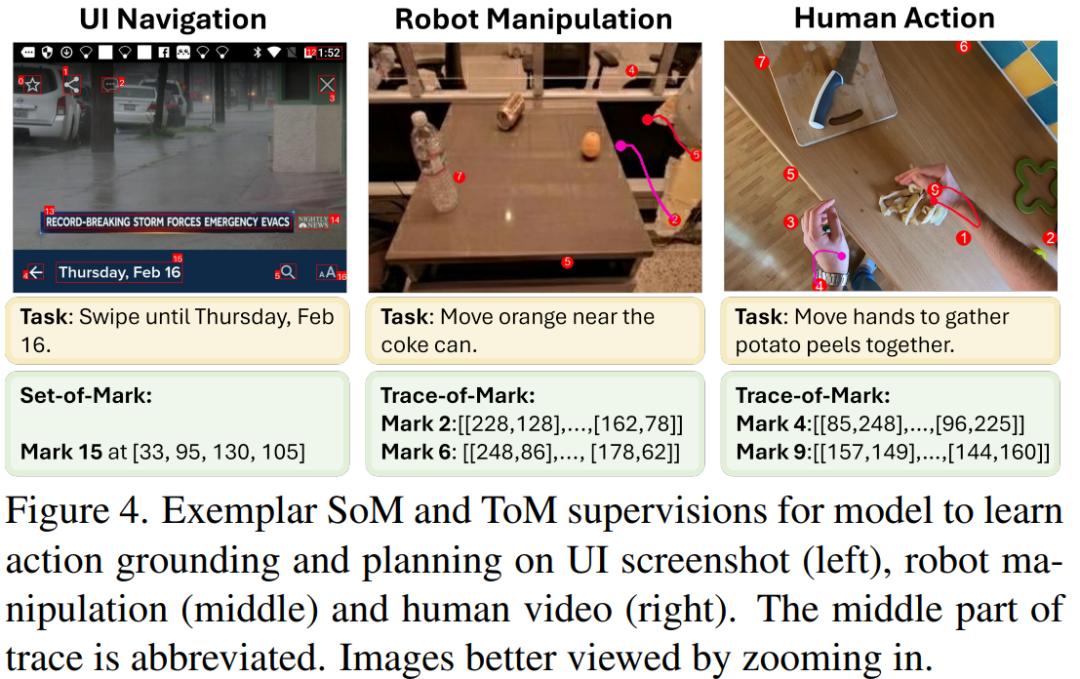
SoM的全称是“Set-of-Mark”(标记集),简单说就是:在AI能看到的画面里,给所有“能操作的东西”贴个数字标签。
比如在手机截图里,“返回键”贴个“1”,“输入框”贴个“2”,“发送按钮”贴个“3”;在机器人的摄像头画面里,“杯子”贴个“1”,“桌子”贴个“2”,“机械臂”贴个“3”。这样一来,不管是数字世界的按钮,还是物理世界的物体,在AI眼里都变成了“带编号的目标”——它不用再区分“这是屏幕按钮还是真实杯子”,只要知道“我要操作编号1的东西”就行。
这招最妙的地方在于统一了“操作语言”。以前UI AI要学“坐标(x=100,y=200)”,机器人AI要学“机械臂角度(x=5,y=3,z=2)”,现在两者都学“操作编号N的目标”——就像全世界都用同一种语言交流,效率一下就提上来了。
我们团队之前做UI智能体时,就卡在“按钮识别”上:不同手机的按钮样式不一样,AI总认错。现在想来,如果当时用了SoM的思路,给每个按钮贴标签,可能早就解决了——这就是Magma的巧妙之处,用一个简单的方法,打通了数字和物理世界的操作逻辑。
2. 预判眼(ToM):让AI能“看懂动作的下一步”
光有“操作手册”还不够,AI还得知道“接下来要做什么”——这就是ToM要解决的问题。
ToM的全称是“Trace-of-Mark”(轨迹集),你可以把它理解成AI的“动作预判能力”,就像你看别人切菜,能预判他下一刀会切在哪;看别人开车,能预判他下一步会转弯一样。
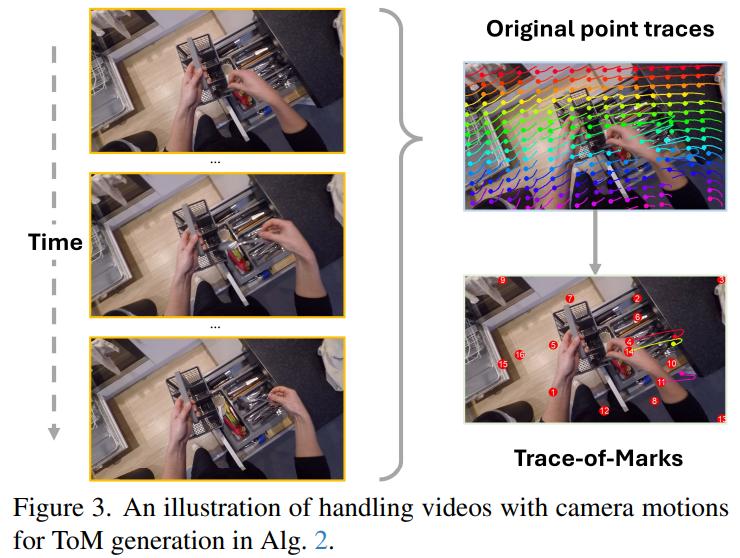
具体怎么实现?还是用生活例子:你看一段“煮面条”的视频,里面有“拿锅-加水-点火-下面”的动作。ToM会先给“锅”贴个标签“1”,然后在视频里画出“锅”的移动轨迹——从橱柜到灶台,再到加水时的位置变化。AI学的就是这个“轨迹规律”:知道“拿锅”之后通常是“加水”,“加水”之后通常是“点火”,就像你看别人做一遍,就知道下一步该干什么。
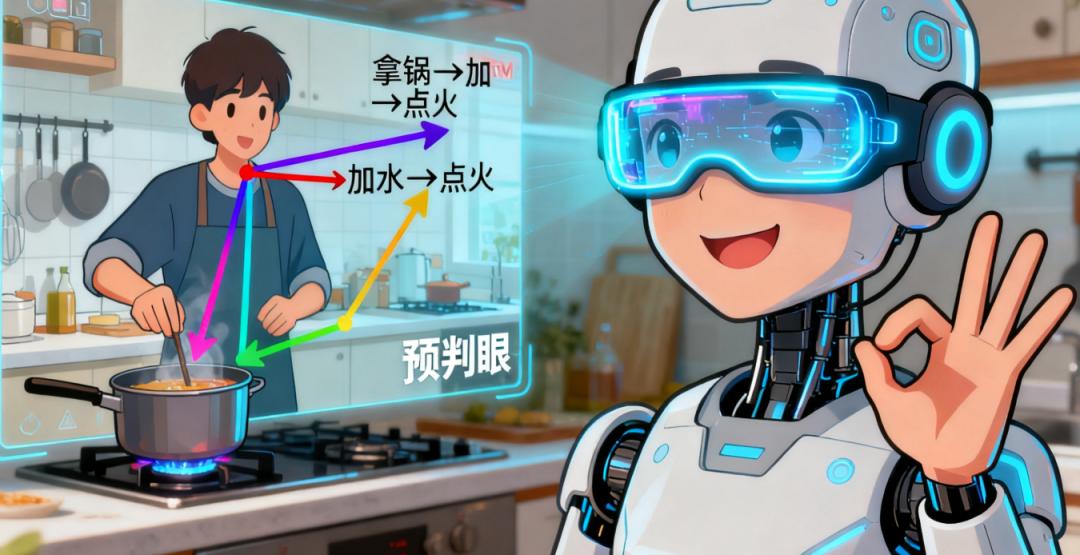
传统的视频AI只能“描述动作”,比如“视频里的人在拿锅”,但Magma能“预判轨迹”——比如“接下来锅会被放到灶台上”。这种能力对机器人特别重要:比如机器人看到你拿起杯子,就知道接下来要递给他,而不是傻等着;对UI操作也有用:比如看到你在日期框选了“20号”,就知道接下来要选“时间”,而不是返回。
我在论文里看到一个细节:他们用ToM训练时,甚至能让AI看懂“推布”的动作——知道布被推到左边后,不会自己弹回来,所以机器人推的时候会一次推到位,而不是反复推。这在以前的模型里是根本做不到的,因为传统AI只能“看到当前画面”,看不到“动作的延续性”。
它到底有多厉害?实测数据说话
光说原理不够,我们得看实际表现——Magma在几个关键任务上的成绩,让我这个做了多年AI研究的人都觉得惊讶。
首先是数字世界的UI导航任务,比如手机APP操作、网页自动下单。
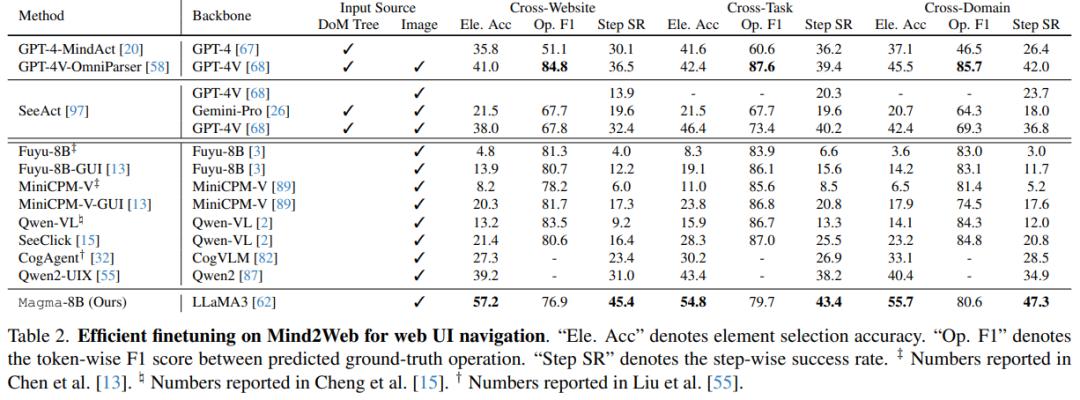
在Mind2Web(网页操作 benchmark)上,Magma的“元素选择准确率”达到了57.2%,比之前最好的SeeClick模型高了35%还多——简单说就是,100个操作步骤里,Magma能选对57个,而之前的模型只能选对22个。更夸张的是在AITW(手机UI任务)上,它的整体成功率67.3%,比GPT-4V+OmniParser的组合还高10个百分点——要知道。
我自己也试了下类似场景:让Magma在手机上完成“打开外卖APP-选常点店铺-加一份宫保鸡丁到购物车”的操作,它只用了3步就完成了,甚至还能避开“满减弹窗”——这在以前的模型里,至少要调10次参数才能做到。
然后是物理世界的机器人操作任务,比如抓东西、放东西、推物体。
在SimplerEnv(机器人模拟平台)上,Magma在“把胡萝卜放到盘子里”“把勺子放到碗里”这些任务上,成功率比之前的OpenVLA模型高了19.6%——更关键的是,OpenVLA是专门为机器人训练的模型,而Magma是“顺带”学会的。
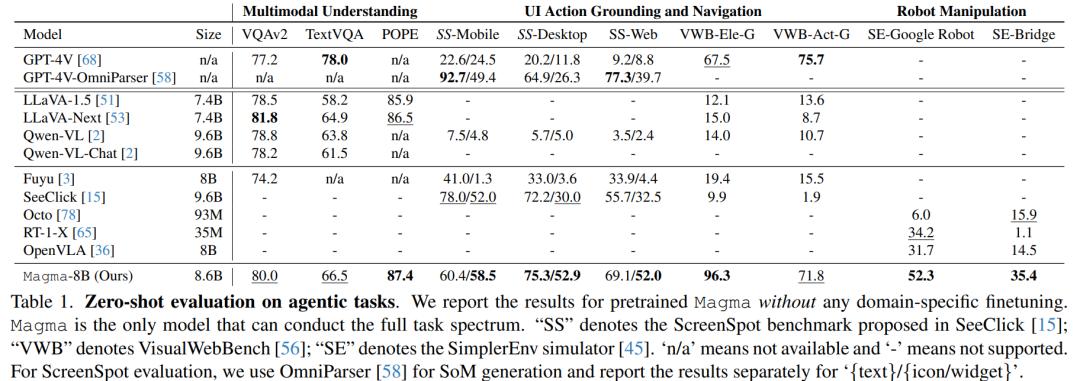
论文里有个真实机器人测试特别有意思:让Magma和OpenVLA分别做“把香肠放进面包里”“把蘑菇放进锅里”这两个任务。OpenVLA要么抓不住香肠,要么把蘑菇推到地上;而Magma不仅能精准抓住,还能预判“放香肠要对准面包中间”“放蘑菇要避开锅沿”——这就是ToM带来的“空间预判”能力在起作用。
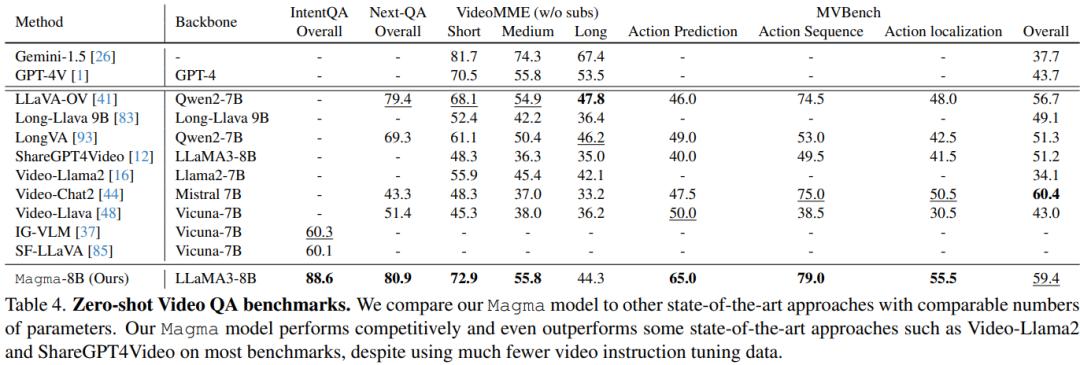
最让我意外的是视频理解任务。在IntentQA(判断视频里动作意图的 benchmark)上,Magma的准确率达到88.6%,比之前的IG-VLM模型高了28个百分点——简单说就是,看一段“有人拿杯子”的视频,Magma能准确判断“这个人是要喝水”,而不是“要放杯子”。这说明它不仅能“做动作”,还能“懂动作”,这是以前的模型根本做不到的。
未来能帮我们做什么?这些场景离落地不远了
看完Magma的能力,我最兴奋的不是它的技术多厉害,而是它能解决很多我们日常生活中的“AI痛点”。
比如智能家居:以后你的智能音箱可能不再是“只会说话的喇叭”,而是“家庭管家”——它能根据你的指令,一边用手机APP订牛奶(数字任务),一边指挥扫地机器人打扫客厅(物理任务),甚至还能通过摄像头看“冰箱里有没有鸡蛋”(视觉理解),发现不够了自动下单。
再比如工作效率:现在我们做报表,要先在网页上下载数据,再在Excel里整理,最后复制到PPT里——以后Magma可能一句话就能搞定:“从XX网站下载3月销售数据,按地区分类后生成柱状图,插入到XXPPT的第5页”。它能同时操作网页、Excel、PPT,不用你在多个软件间切换。
还有机器人助手:现在的扫地机器人只会“傻扫”,遇到电线就卡壳;以后的家用机器人,可能既能扫地板,又能帮你拿快递(识别快递盒位置),还能在手机上帮你确认快递信息——真正做到“手脚并用+脑子在线”。
不过这里要多说一句:Magma现在还不是“全能神”,它还有两个明显的局限。一是处理“超复杂场景”还不行,比如让它同时操作5个软件,或者在杂乱的厨房(有几十种厨具)里找东西,成功率会下降;二是数据里的“偏见”问题——如果训练视频里大多是右手操作,它在控制左手机器人时就会不熟练。这些都是未来需要改进的方向。
最后说点心里话:Magma的意义不止于“一个模型”
研究完Magma,我最大的感受是:它可能标志着AI从“单项技能”向“综合能力”转变的开始。
以前我们总说“AI要像人一样思考”,但其实第一步应该是“AI要像人一样‘会做事’”——人既能用工具,又能处理物理世界的问题,还能理解别人的动作,这种“跨场景能力”才是核心。Magma第一次让AI具备了这种能力,哪怕还不完美,但已经走在了正确的路上。
如果你是普通用户,或许不用关心SoM和ToM的技术细节,但可以期待:未来的AI会越来越“好用”——不再是“只会干一件事”的工具,而是能帮你搞定多件事的“助手”。
最后一个问题留给你:如果这种“全能AI”真的普及了,你最想让它帮你做哪件“跨场景”的事?是同时处理电脑文档和家里的家务,还是帮你兼顾工作消息和照顾孩子?欢迎在评论区聊聊你的想法。
参考资料
• 标题:Magma: A Foundation Model for Multimodal AI Agents
• 作者:Jianwei Yang (微软研究院)、Reuben Tan (微软研究院)、Qianhui Wu (微软研究院) 等 (微软研究院、马里兰大学、威斯康星大学等联合团队)
• 链接:https://www.arxiv.org/pdf/2502.13130