高通NeurIPS25提出GCL:小模型多模态组合检索,性能显著提升34%
我们在做跨模态检索Agent方案时,一直被两个问题卡壳:一是检索图文融合内容(比如带图片的Wikipedia页面)时,模型要么只匹配文本、要么只匹配图片,没法精准定位;二是为了适配不同模态组合,要花大量时间构建专用数据集,成本高还泛化性差。直到看到这篇NeurIPS 2025的论文,发现它用一个简单却精妙的损失函数,既解决了模态鸿沟,又不用重新造数据集。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
这篇研究的核心价值在于:用通用对比学习(GCL)打破多模态检索的模态壁垒,在不依赖专用数据集的前提下,让模型能处理所有9种模态组合的检索任务,不管是文本查图片、图文查文本,还是视频查图文,都能实现性能提升。不管你是做科研的研究生,还是负责AI落地的工程师,都能从这个“小改动大效果”的方案里找到灵感。
一、多模态检索的核心痛点:模态鸿沟+数据集枷锁
在AI检索领域,“跨模态”早已不是新鲜事——文本查图片、图片查文本的技术已经相对成熟。但现实场景里的需求要复杂得多:
• 你想找一篇“埃菲尔铁塔历史+图片”的Wikipedia页面,用文本“埃菲尔铁塔的历史”检索,传统模型可能只返回纯文本介绍,或者纯图片集合;
• 用一段带画面的监控视频(视频模态),想检索包含相似场景+文字说明的安全报告(图文融合模态),现有模型几乎无法完成。
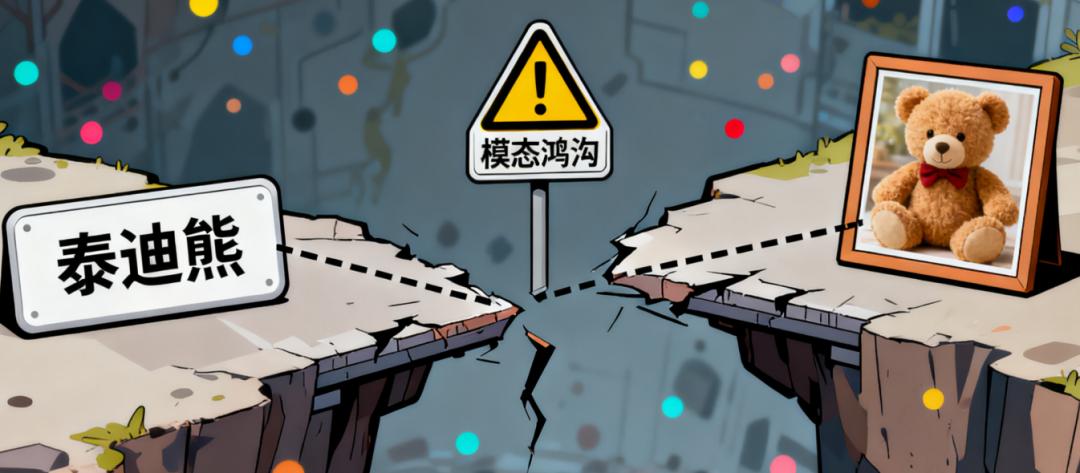
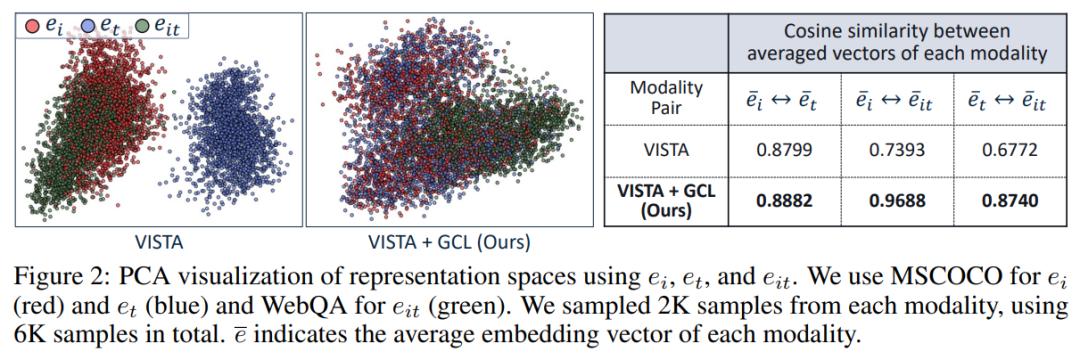
这些问题的根源的是模态鸿沟:语义相似的不同模态样本,在模型的嵌入空间里距离反而很远。比如一张泰迪熊图片和它的描述文本“a photo of teddy bears”,可能在嵌入空间里,图片离其他动物图片更近,而不是离自己的文本描述更近。
更棘手的是数据集枷锁。之前的解决方案(比如VISTA)为了适配特定模态组合,会构建专用的三元组数据集(比如IT2I:图文查询→图片候选;T2IT:文本查询→图文候选)。但这种方式有两个致命问题:
1. 成本极高:需要人工验证生成样本的准确性,耗时耗力;
2. 泛化性差:模型只学过训练过的模态组合,遇到没见过的(比如图文查询→视频候选)就歇菜。
实验数据也证明了这一点:VISTA在针对性任务(如q_it→c_i)上表现尚可,但在跨模态任务(如q_i→c_t)上,性能反而比预训练模型下降了——因为专门数据集的微调让模型“忘了”初始的跨模态对齐能力。
二、GCL的核心逻辑:让所有模态在一个“坐标系”里对齐
GCL的思路特别简单:既然现存的图文配对数据集(比如MSCOCO、LCS-558K)已经足够多,为什么不直接利用这些数据,让文本、图片、图文融合三种模态在同一个训练批次(mini-batch)里互相校准?
1. 核心原理:三种模态的“集体对比学习”
你可以把模型的嵌入空间想象成一个科研实验室的“测量坐标系”:
• 文本、图片、图文融合(IT)就像三个不同的测量仪器,之前是分开校准,结果各自的“刻度”不一样(模态鸿沟);
• GCL的做法是把三个仪器放在一起,用同一套标准(对比学习)校准:让语义相似的样本(比如泰迪熊图片、泰迪熊文本、泰迪熊图文)在坐标系里靠得更近,语义不相关的样本(比如泰迪熊图片和猫的文本)离得更远。
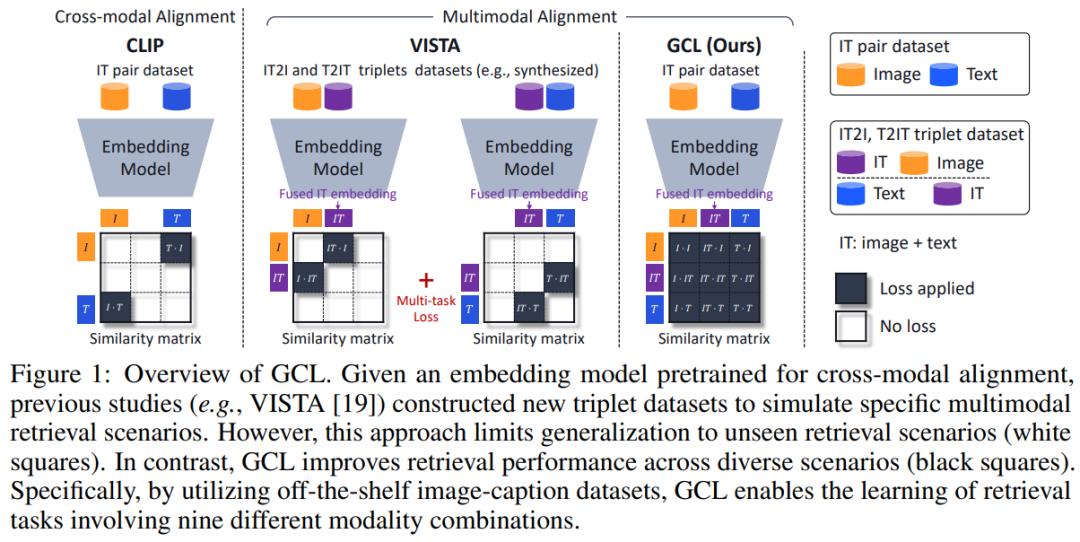
具体来说,GCL会同时处理三种嵌入:
• 文本嵌入(e_t):来自文本编码器;
• 图片嵌入(e_i):来自图片编码器;
• 图文融合嵌入(e_it):要么用模型自带的融合架构(如VISTA的文本编码器+视觉token),要么直接用e_i+e_t(CLIP类模型)。
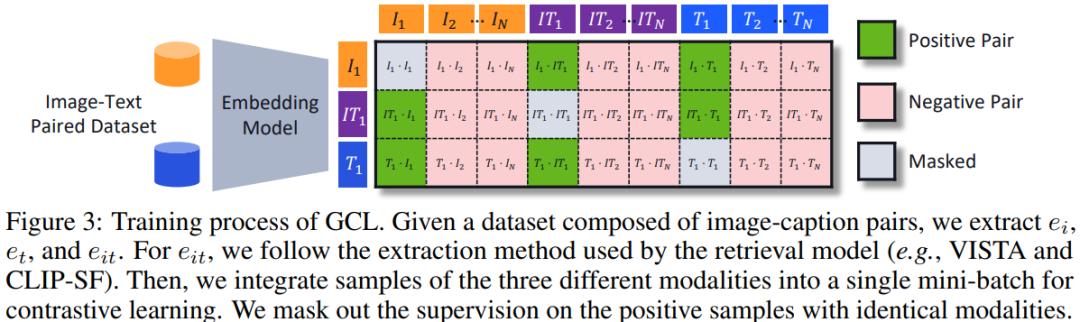
然后在mini-batch里定义:
• 正样本:不同模态的对应样本(比如e_i和e_t、e_i和e_it、e_t和e_it);
• 负样本:所有其他模态的非对应样本;
• 屏蔽样本:同一模态的自身样本(避免模型“作弊”)。
通过这种方式,模型能一次性学会所有9种模态组合的检索逻辑,而不是像传统方法那样逐个场景训练。
2. 与传统方案的关键差异:不造数据,只优化对齐
之前的对比学习(比如CLIP的对比损失)只关注文本和图片的双向对齐(e_i↔e_t),而GCL扩展到了所有模态组合(e_i↔e_t、e_i↔e_it、e_t↔e_it,以及反向)。
用一个直观的比喻:
• 传统对比学习:就像只训练“中文→英文”“英文→中文”的翻译能力;
• GCL:同时训练“中文→英文”“中文→中英双语”“英文→中文”“英文→中英双语”“中英双语→中文”“中英双语→英文”的全部能力,而且不用额外的翻译素材,只用现有的中英对照语料。
这种设计的好处是:完全复用现有图文配对数据集,不用花一分钱做数据扩充,却能实现泛化到所有模态组合的检索能力。
三、GCL的三大创新点:简单却直击要害
这篇论文的厉害之处在于,它没有设计复杂的网络结构,只通过损失函数的优化,就实现了三大突破:
1. 泛化性突破:覆盖所有9种模态组合
传统方法只能处理训练过的模态组合(比如VISTA只学了IT2I和T2IT),而GCL能覆盖所有可能的检索场景:
• 文本查询→图片候选(q_t→c_i);
• 文本查询→图文候选(q_t→c_it);
• 图片查询→文本候选(q_i→c_t);
• 图片查询→图文候选(q_i→c_it);
• 图文查询→文本候选(q_it→c_t);
• 图文查询→图片候选(q_it→c_i);
• 以及同模态检索(q_i→c_i、q_t→c_t、q_it→c_it)。
实验证明,即使是没专门训练过的场景(比如q_it→c_t),GCL也能保持高性能,而传统模型要么性能暴跌,要么完全无法处理。
2. 成本优势:零额外数据构建成本
之前的方案(如VISTA、MegaPairs)需要用生成模型造专用数据集,不仅要消耗大量计算资源,还要人工校验数据质量。而GCL直接使用现成的图文配对数据集(如LCS-558K、MSCOCO),甚至不需要对数据做任何修改。
对中小团队来说,这意味着:不用花几个月时间构建数据集,只用现有数据微调,就能获得多模态检索能力,大大降低了研究和落地门槛。
3. 兼容性强:适配所有主流多模态模型
GCL不是一个独立模型,而是一个可插拔的损失函数,能直接用到现有主流模型上:
• 实验中验证了VISTA、CLIP、TinyCLIP三种模型;
• 不管是有专门融合架构的模型(VISTA),还是简单求和融合的模型(CLIP-SF),都能获得稳定的性能提升。
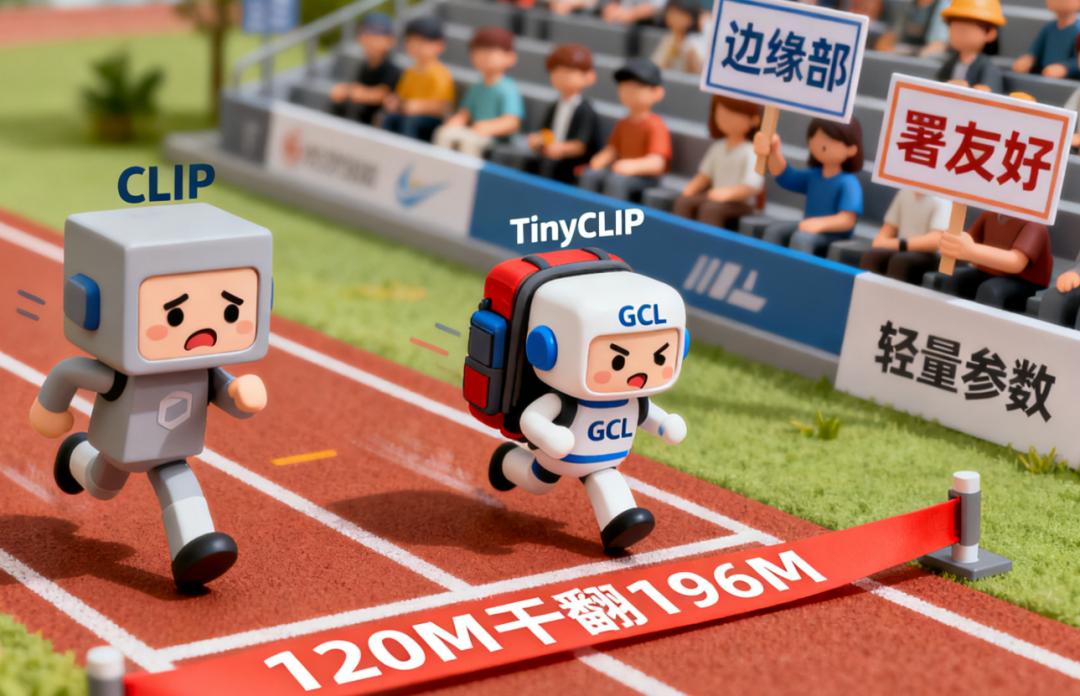
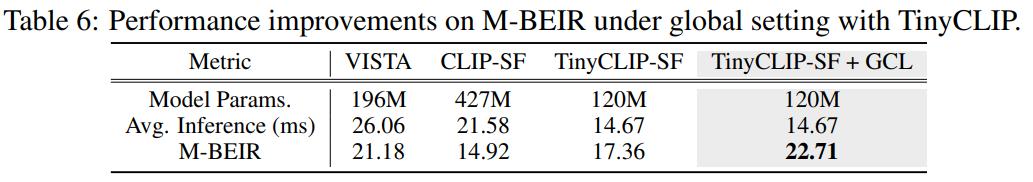
它能赋能轻量模型。比如TinyCLIP(120M参数)在加了GCL后,在M-BEIR上的性能从17.36提升到22.71,接近VISTA(196M参数)的原始性能(21.18),但推理速度保持14.67ms,比VISTA(26.06ms)快了近一半——这对移动端、边缘设备的落地至关重要。
四、实验验证:性能全面超越传统方案
论文在三个权威基准(M-BEIR、MMEB、CoVR)上做了全面验证,核心结果如下:
1. 核心指标:Recall@K全面提升
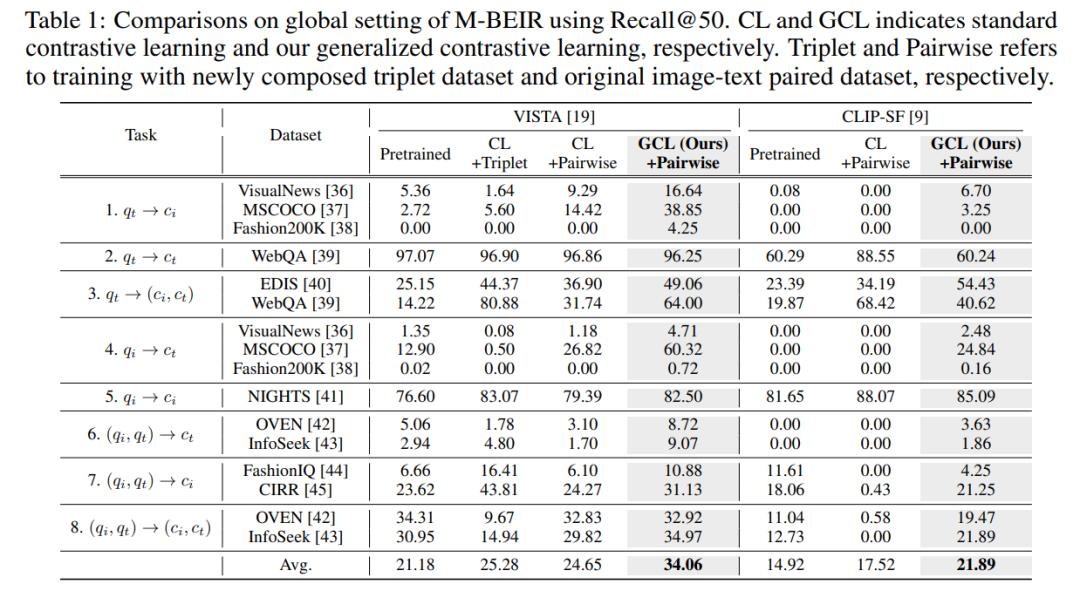
• 在M-BEIR全局设置(Recall@50)中,VISTA+GCL的平均性能从21.18提升到34.06,比用专用三元组数据集的VISTA(25.28)高8.78个点;
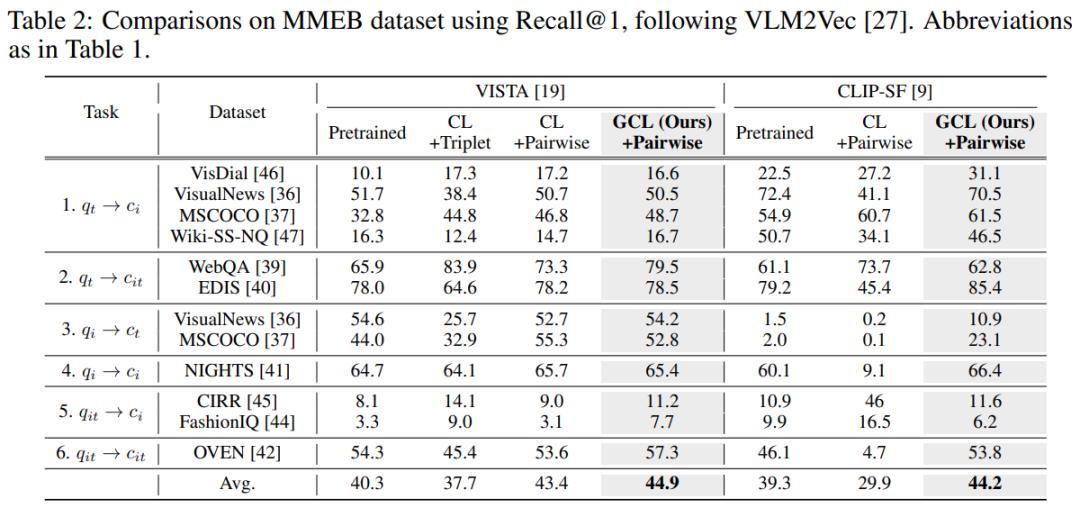
• 在MMEB(Recall@1)中,CLIP-SF+GCL的平均性能从17.52提升到21.89,尤其在图文检索任务(q_t→c_it)上提升最为显著;
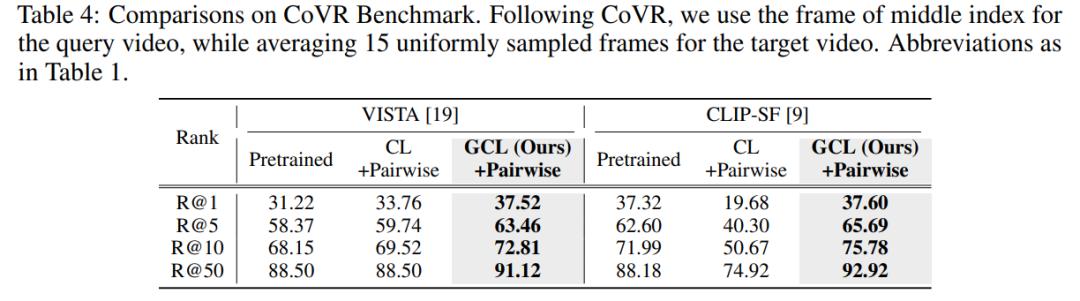
• 在视频检索基准CoVR(Recall@50)中,VISTA+GCL达到91.12,CLIP-SF+GCL达到92.92,比传统方案提升3-5个点——这证明GCL不仅适用于图片和文本,还能扩展到视频模态。
2. 关键发现:模态对齐效果显著
通过PCA可视化和余弦相似度分析,GCL训练后的模型:
• 三种模态的平均嵌入相似度大幅提升:VISTA+GCL的e_t↔e_it相似度从0.6772提升到0.8740,e_i↔e_it相似度从0.7393提升到0.9688;
• ground truth候选的排名显著提升:在q_t→c_i任务中,GCL训练后的模型,超过60%的真实候选能进入前500名,而原始VISTA有大量真实候选排名在1000名以后。
3. 消融实验:各组件缺一不可
论文通过消融实验验证了GCL各部分的作用:
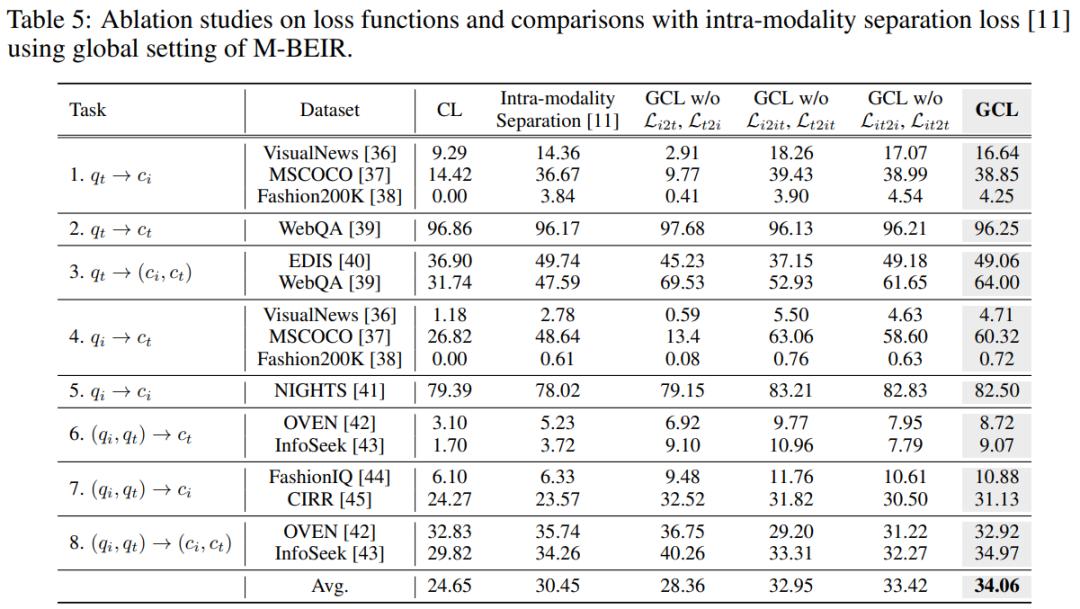
• 去掉跨模态对齐项(L_i2t、L_t2i):跨模态任务(q_i→c_t)性能暴跌30%以上;
• 去掉IT-候选学习项(L_i2it、L_t2it):文本查询→图文候选(q_t→c_it)性能下降15%;
• 去掉IT-查询学习项(L_it2i、L_it2t):图文查询→图片候选(q_it→c_i)性能下降12%。
这说明GCL的三大组件(跨模态对齐、IT-候选、IT-查询)分别对应不同的检索场景,共同构成了完整的多模态对齐能力。
五、落地前景与挑战:谁能从中受益?
1. 核心应用场景
• 移动端检索:TinyCLIP+GCL的轻量特性,适合手机端的图文检索(如相册按文本搜图片、电商按图片+文本搜商品);
• 企业知识库检索:处理包含文档、图片、视频的混合知识库(如企业内部的技术手册、安全报告);
• 视频内容检索:如监控视频检索相似场景的图文报告、短视频平台按文本+图片检索相关视频。
2. 现存挑战
• 领域适配性:在特定领域(如时尚、艺术),通用数据集(LCS-558K)的微调效果略逊于专用数据集,需要后续做少量领域数据微调;
• 融合嵌入质量:CLIP类模型用e_i+e_t的简单融合方式,在复杂场景(如多图+长文本)的效果不如专用融合架构,未来可结合MLLM的融合能力;
• 计算成本:虽然不用造数据,但多模态嵌入的对比学习会增加训练时的计算量,需要优化mini-batch大小和温度参数(τ)。
3. 未来研究方向
论文提到,将GCL与多模态大语言模型(MLLMs)结合是一个重要方向——比如用GCL优化MLLM的嵌入空间,让检索到的多模态信息能直接用于生成式任务(如基于检索到的图文内容生成报告)。这正是我们课题组接下来要尝试的方向,相信能大幅提升检索-生成一体化系统的性能。
六、总结:多模态检索的“低成本泛化”新范式
这篇论文最打动我的地方,是它回归了AI研究的本质:用最简单的方案解决最核心的问题。GCL没有追求复杂的网络结构,而是通过重新设计对比学习的损失函数,一次性解决了模态鸿沟和泛化性两个关键痛点,同时还降低了数据构建成本。
对科研人员来说,GCL提供了可扩展的多模态对齐框架,不管是做基础研究(如模态嵌入优化),还是应用研究(如特定场景检索),都能直接复用;对工程师来说,GCL的兼容性和轻量特性,让它能快速集成到现有系统中,不用重构代码就能获得性能提升。
如果你正在做跨模态检索、多模态Agent相关的工作,强烈建议仔细读一下原文——它不仅能解决你当前的技术卡点,还能启发你思考“如何在不增加成本的前提下提升模型泛化性”。
最后想问:你们在做多模态对齐时,有没有遇到过“模态嵌入相似度高但检索效果差”的问题?欢迎在评论区分享你的解决思路!
参考资料
• 标题:Generalized Contrastive Learning for Universal Multimodal Retrieval
• 作者:Jungsoo Lee, Janghoon Cho, Hyojin Park, Munawar Hayat, Kyuwoong Hwang, Fatih Porikli, Sungha Choi
• 机构:Qualcomm AI Research
• 链接:https://openreview.net/pdf?id=TEAASoJWsb