NeurIPS'25港城大+腾讯+浙大Retrv-R1:压缩+推理多模态检索SOTA
搭建跨模态检索系统时,有两个难题:一是处理图文混合候选集时,token数量爆炸导致GPU直接内存溢出;二是用RL训练模型时,要么收敛不了,要么推理过程漏洞百出,检索准确率始终上不去。直到看到这篇 NeurIPS 2025 的 Retrv-R1 论文,才发现原来不用复杂架构,只要针对性解决“信息冗余”和“训练不稳定”两个核心痛点,就能让多模态检索的准确率和效率同时突破瓶颈——这篇研究给出了新的技术方案,更提供了“推理驱动检索”的全新思路。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
一、AI多模态检索的核心痛点:准确率与效率的两难困境
信息检索早已不是单一文本或图像的匹配任务,现在的搜索引擎、推荐系统、RAG应用,都需要处理“文本查图像”“图文混合查视频”等多模态场景。但实际落地中,科研和工程团队都会遇到两个绕不开的难题:
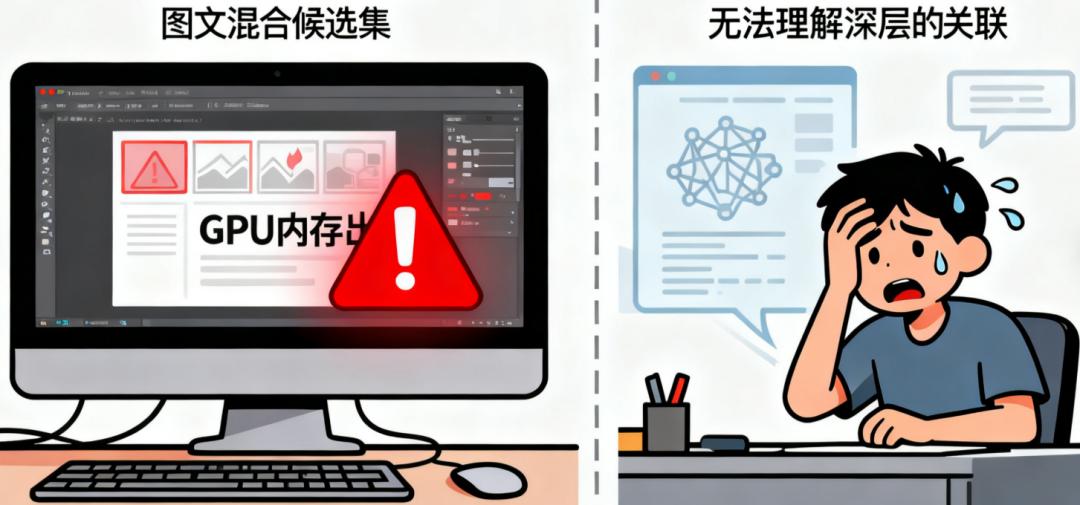
1. 复杂场景检索不准:传统MLLM做检索,要么靠嵌入向量计算相似度(像盲人摸象,容易忽略关键关联),要么直接当QA任务处理(跳过推理过程,复杂查询根本扛不住)。比如在“找一张和白天照片同角度的夜景图”这类任务中,传统模型要么分不清角度差异,要么忽略“夜景”这个核心约束。
2. 多候选场景效率极低:当候选样本超过20个,尤其是包含图像、视频等模态时,token数量会呈指数级增长,不仅推理时间拉长(我们之前测试过,K=50时单条查询要10秒),还容易超出模型上下文窗口,导致检索失败。
3. RL训练水土不服:之前DeepSeek-R1用RL提升LLM推理能力的思路很火,但直接套用到检索任务上完全行不通——一方面多候选+推理过程的token消耗太大,计算成本扛不住;另一方面模型容易生成错误推理链,越训练越跑偏,准确率反而下降。
这些问题本质上是“检索任务的特殊性”与“通用MLLM框架”的不匹配:检索需要快速筛选海量候选,而MLLM的推理过程天然需要充足上下文,两者就像“要快速跑马拉松”和“带着沉重背包”的矛盾。
二、传统方案的局限:为什么之前的尝试都失败了?
我们在Retrv-R1之前,也试过三种主流方案,结果都不尽如人意:
• 方案1:基于CLIP的嵌入检索:优点是快,但只能捕捉表面特征,比如无法理解“同角度不同时间”这种深层关联,在M-BEIR数据集的复杂任务上,根本达不到实用标准。
• 方案2:MLLM直接QA式检索:把查询和候选拼成指令,让模型直接输出结果。这种方式准确率稍高,但完全没有推理过程,遇到“排除明显负样本后再对比相似候选”的场景就歇菜,而且候选超过10个就会严重卡顿。
• 方案3:直接套用DeepSeek-R1的RL训练:我们用GRPO算法训练Qwen2.5-VL,结果训练了3个epoch都没收敛,而且错误推理链占比高达30%——就像让新手直接上战场,不仅不会打仗,还会拖慢整体节奏。
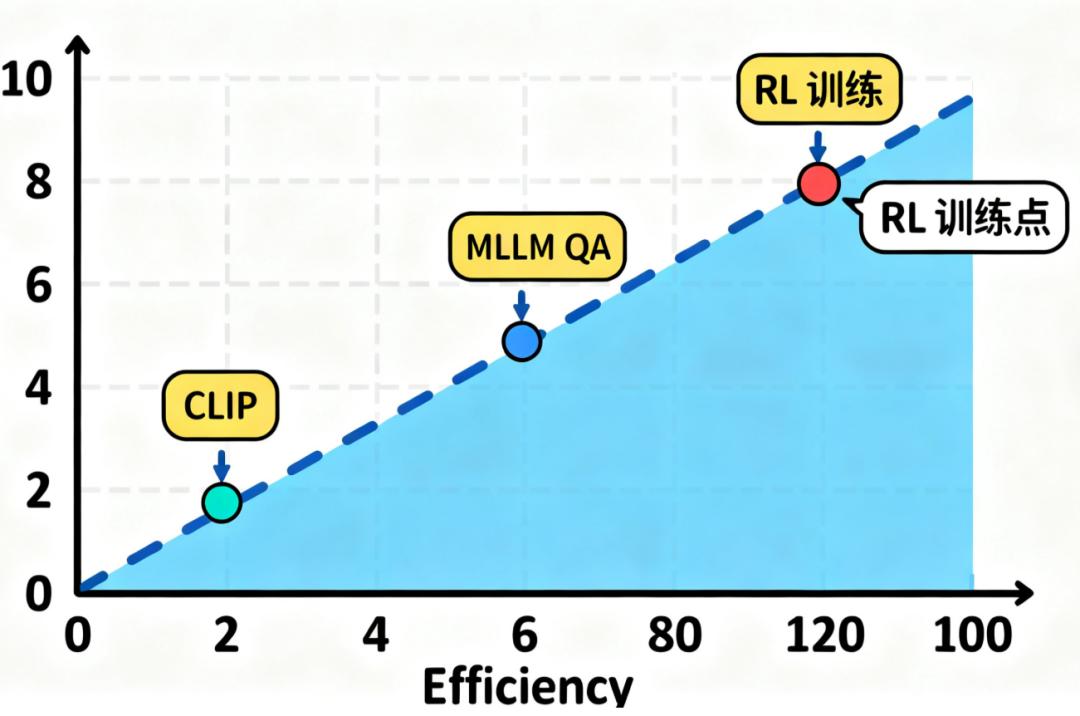
这些失败让我们意识到:检索任务需要的“推理”,不是像数学题那样的复杂推导,而是“快速筛选-重点核查-精准匹配”的高效流程;同时,多模态候选的信息必须“瘦身”,但不能丢关键信息。而Retrv-R1恰好踩中了这两个关键点。
三、Retrv-R1的核心创新:用“信息压缩+分阶段训练”破局
Retrv-R1的本质是“为检索任务量身定制的R1风格MLLM框架”,核心思路很简单:让模型只处理关键信息,让训练循序渐进贴合检索场景。整个框架的创新点集中在两个模块,既好理解又好实现:
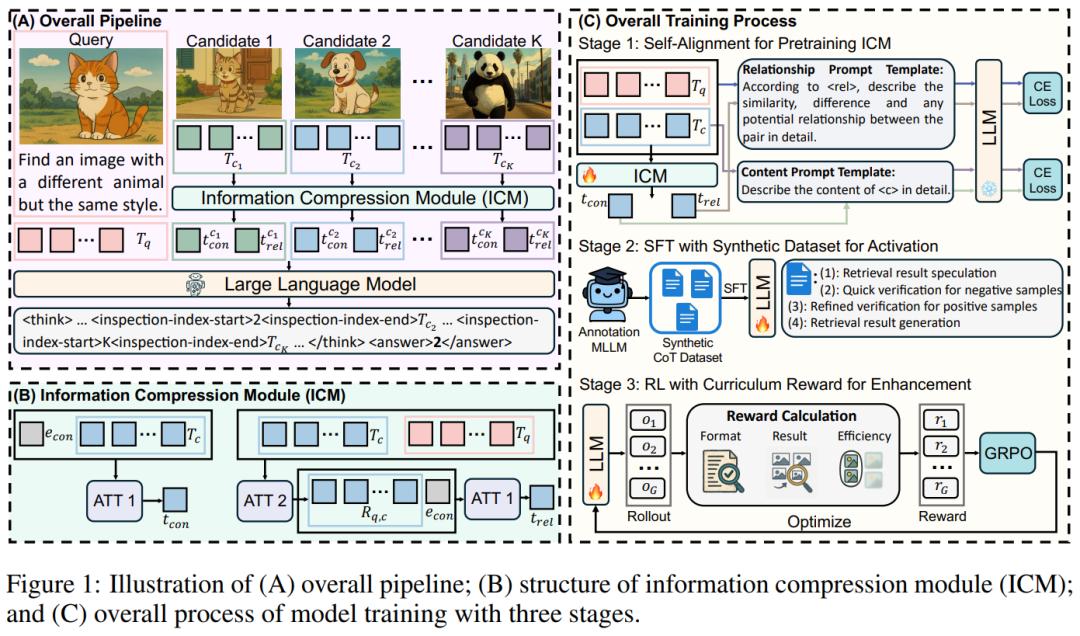
1. 信息压缩模块(ICM):给候选样本“瘦身后备重点”
如果把每个候选样本比作一篇实验报告,传统模型会逐字逐句读完所有报告,而ICM做的是“提炼摘要+标注重点”——既减少阅读量,又不会错过关键信息。
• 核心设计:把每个候选样本压缩成2个token:
• 内容token(t_con):提炼样本核心内容,比如一张夜景图的“地点+构图+光线”,就像实验报告的“核心发现”;
• 关系token(t_rel):捕捉样本与查询的关联,比如“这张图和查询的角度一致但时间不同”,就像实验报告的“与研究目标的相关性分析”。
• 自对齐预训练:为了避免压缩后丢关键信息,作者用了一个巧妙的方法:让MLLM根据压缩后的2个token,还原出完整样本的描述。这就像让研究员根据摘要还原实验报告,确保摘要里包含所有关键信息——这个预训练过程让ICM的压缩损失降到最低。
• 细节检查机制:最妙的是,模型在推理时如果发现某个候选“不好判断”(比如两个样本看起来都符合查询),会自动触发“查原文”机制,调用该候选的完整token序列进一步分析。这就像研究员看摘要拿不准时,再翻完整实验记录,既保证效率又不牺牲准确率。
用生活化的比喻来说,ICM就像快递分拣系统:大部分包裹(候选样本)通过标签(压缩token)快速分流,只有少数模糊包裹(难判断样本)需要拆开检查,既快又准。
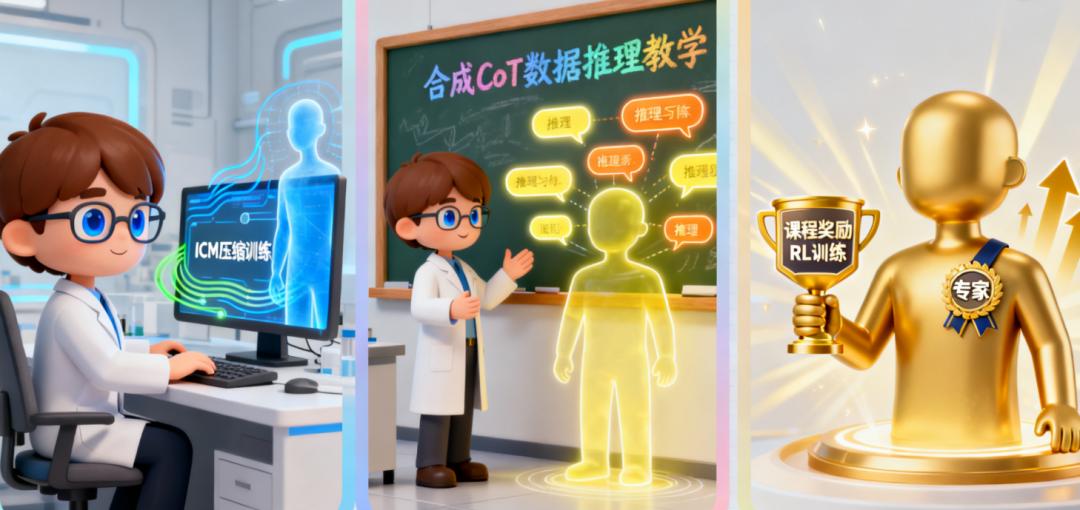
2. 三阶段训练:让模型“先会做再做好”
直接用RL训练检索模型,就像让新手直接参加竞赛;而Retrv-R1的训练过程,更像科研人员的成长路径:先打基础,再练技巧,最后冲成绩。
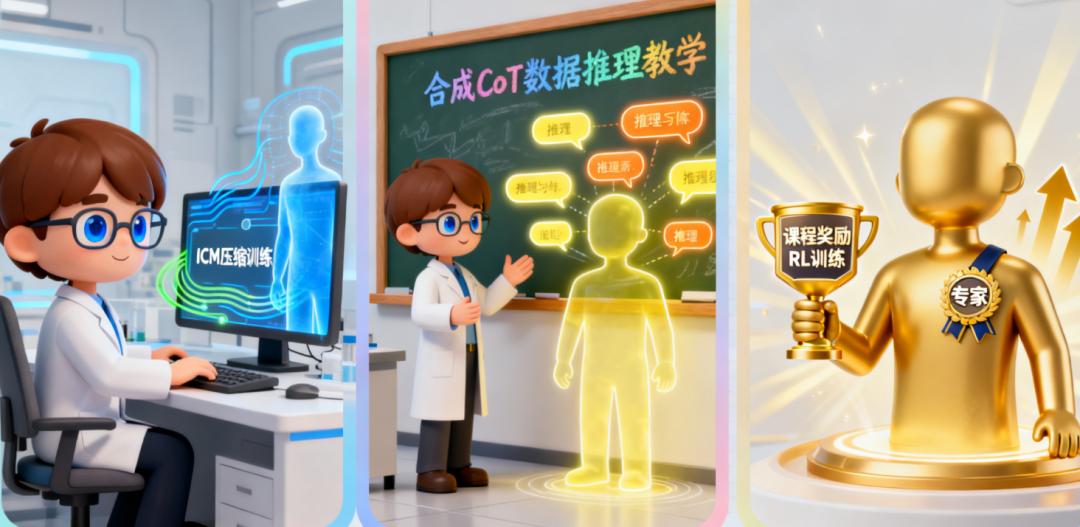
• 阶段1:ICM预训练:先冻结MLLM,单独训练ICM的压缩能力,确保它能提炼出关键信息——这一步解决“信息冗余”的基础问题。
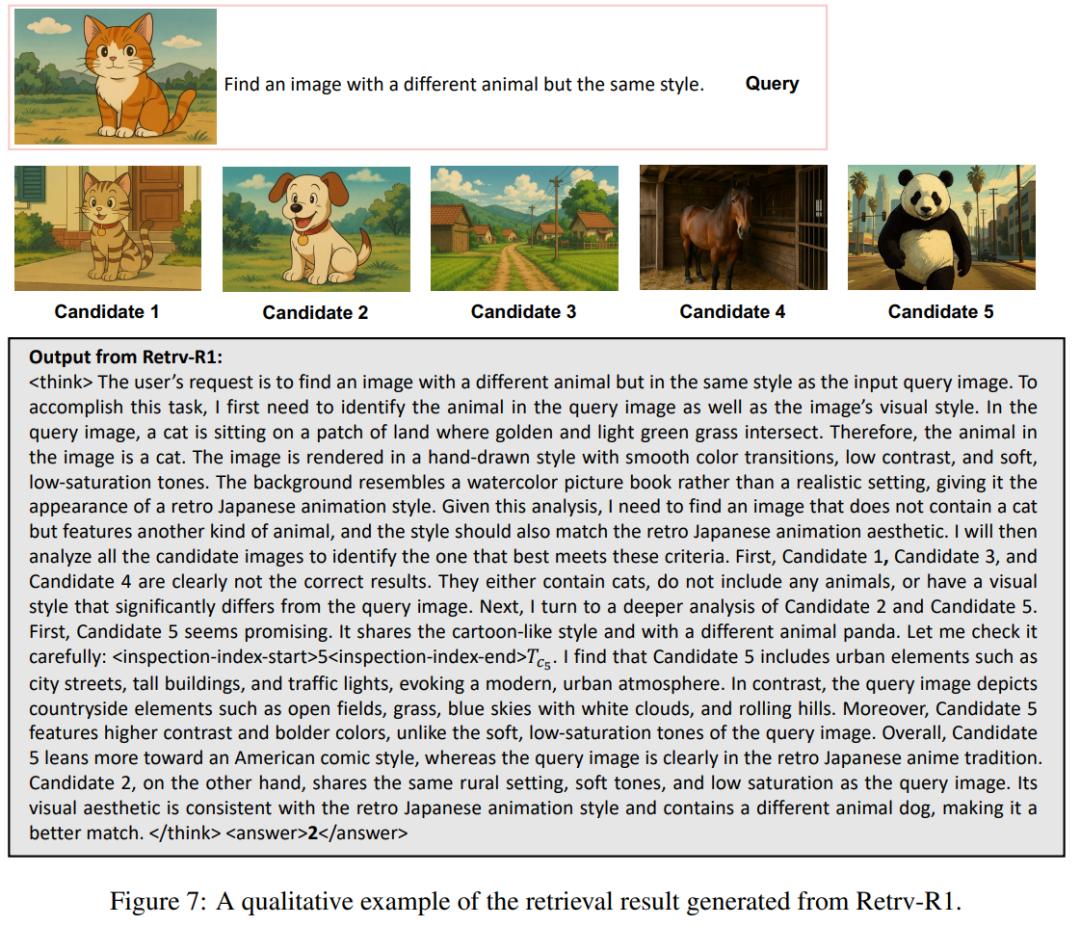
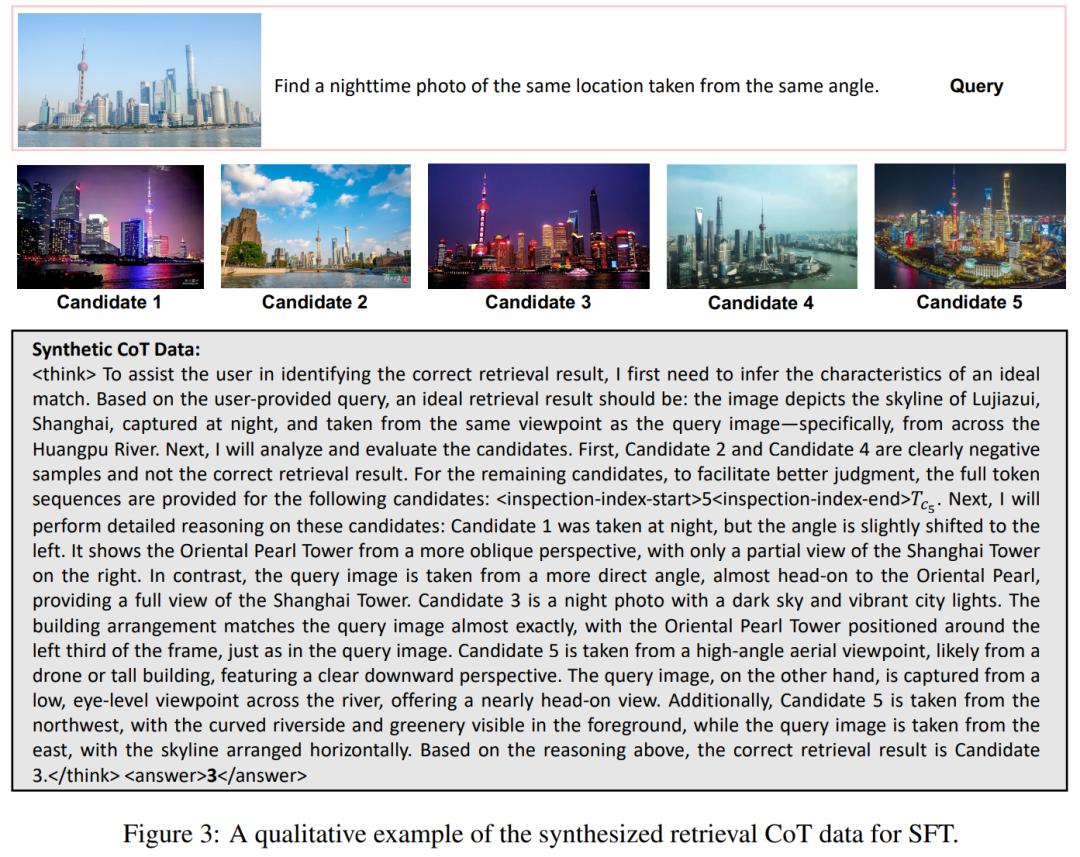
• 阶段2:合成CoT的SFT激活:由于没有现成的“检索推理数据集”,作者用Qwen2.5-VL-72B生成了10万条合成CoT数据,每条数据包含四步推理:
1. 推测理想结果(比如“用户要的是同角度夜景图,应该有XX特征”);
2. 快速排除负样本(比如“这张是白天的,直接排除”);
3. 重点核查难样本(比如“这两张都是夜景,调用完整信息对比角度”);
4. 输出最终结果。这一步让模型先学会“检索该怎么推理”,避免RL训练时跑偏。
• 阶段3:课程奖励RL增强:用GRPO算法训练,但设计了一个“渐进式奖励”:
• 奖励包含两部分:结果准确率(有没有找对)+ 效率(少调用完整token);
• 效率权重λ从0逐渐增加到1:训练初期让模型优先保证准确率,后期再强调效率。这就像科研任务:初期先把实验做对,熟练后再优化流程提效率,避免一开始就追求速度而犯低级错误。
四、实验验证:准确率和效率双突破,泛化性拉满
作者在16张A100上做了全面实验,无论是核心指标还是泛化能力,都证明了方案的有效性—。
1. 核心指标:M-BEIR数据集SOTA
在包含16个亚任务的多模态检索基准M-BEIR上,Retrv-R1-7B在K=50时的R@5达到72.3,比之前的SOTA模型LamRA高6.1个百分点;而推理时间只有1秒,是Qwen2.5-VL的1/4.79,GPU内存占用也只有后者的1/2.44。
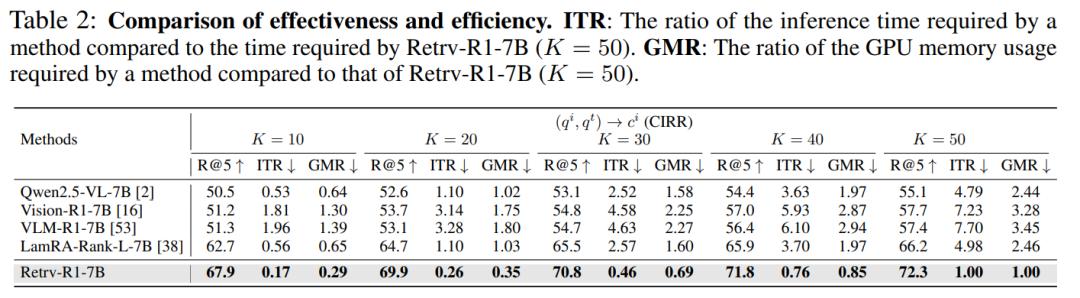
更关键的是,即使是3B参数的Retrv-R1-3B,也能超过7B参数的LamRA——这说明“推理驱动+信息压缩”的架构,比单纯堆参数更有效。在“图文混合查图像”这种最难的任务上,Retrv-R1的优势更明显,R@5比Vision-R1高14.6个百分点,因为它能通过推理排除角度、时间等干扰因素。
2. 泛化性:跨任务、跨数据集都能打
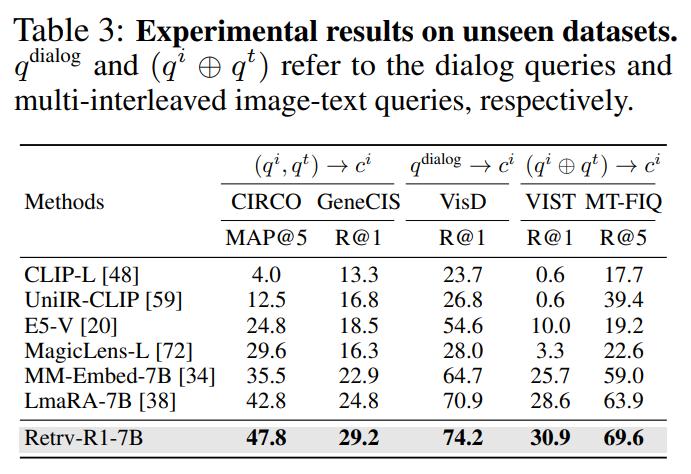
• 不可见数据集:在没训练过的对话检索、 interleaved图文检索任务上,Retrv-R1的R@5比基线模型高10个百分点以上,说明它学到的推理能力可以迁移。
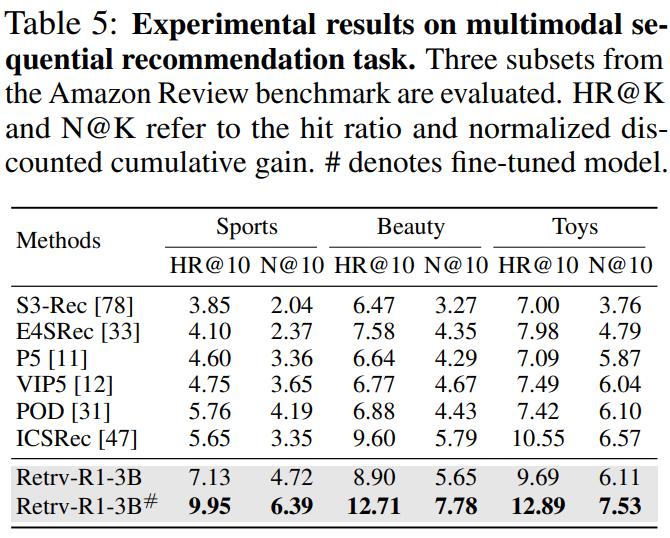
• 推荐系统任务:把Retrv-R1用到多模态推荐上,不用改模型结构,只调整输入指令,HR@10就达到12.71,比专门的推荐模型ICSRec高3.11个百分点——这意味着它不仅能做检索,还能适配需要关联匹配的其他任务。
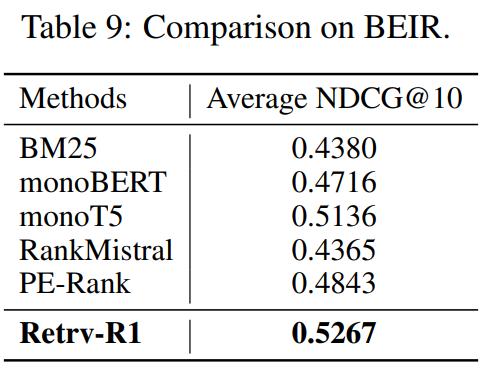
• 文本检索任务:在BEIR文本检索基准上,Retrv-R1的平均NDCG@10达到0.5267,超过专门的文本检索模型,证明它的框架是“通用”的,不是只适用于多模态。
3. 消融实验:关键模块不可或缺
作者做的消融实验,也验证了我们之前的猜想:
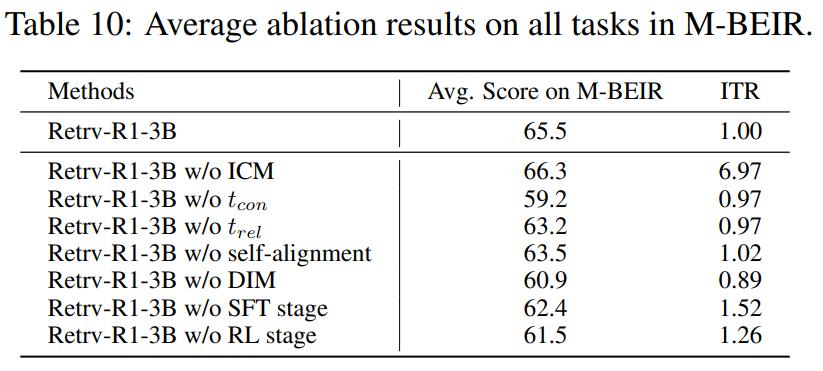
• 去掉ICM:推理时间增加7倍,R@5只提升0.9个百分点,完全得不偿失;
• 去掉细节检查机制:R@5下降5.6个百分点,说明难样本的完整信息对准确率至关重要;
• 跳过SFT直接RL:模型收敛不了,R@5下降6.8个百分点,证明“先激活推理能力”是必要的;
• 不用课程奖励:R@5下降4.2个百分点,说明渐进式优化能平衡准确率和效率。
五、落地前景与挑战:谁该用Retrv-R1?
这篇研究的价值,不仅在于提出了一个SOTA模型,更在于提供了一套“推理驱动检索”的工程化方案——无论是科研团队还是产业界,都能值得借鉴:
1. 适用场景
• 搜索引擎:处理图文混合查询、跨模态检索(比如“找一个和这段文字描述相符的视频片段”);
• 推荐系统:多模态商品推荐、内容推荐(比如根据用户浏览的图文内容,推荐相关视频);
• RAG应用:处理多模态知识库检索(比如在包含论文、图表、数据的知识库中,查找相关信息);
• 低资源场景:3B参数的Retrv-R1性能就足够强,中小团队不用堆大算力也能部署。
2. 现存挑战
• 轻微性能损失:ICM压缩会导致部分场景的R@5下降0.9%-1.1%,虽然效率提升7倍,但对极致准确率场景(比如医疗检索)可能需要权衡;
• 合成数据依赖:SFT阶段依赖Qwen2.5-VL-72B生成CoT数据,没有大模型的团队可能难以复现——不过作者提供了详细的生成prompt,用其他大模型也能尝试;
• 长视频检索适配:目前实验主要针对图像和文本,长视频的token压缩和推理逻辑可能需要进一步优化。
六、总结:推理驱动检索的未来方向
Retrv-R1的成功,本质上是“任务适配”的胜利——它没有盲目跟风大模型堆参数,而是针对检索任务的“效率+准确率”核心需求,做了精准的架构和训练优化。这给我们的启发是:未来的多模态检索,不再是“嵌入匹配”或“单纯推理”的二选一,而是“高效筛选+精准推理”的结合。
对于科研人员来说,这篇论文提供了两个可复用的思路:一是用“压缩+按需解压”解决多模态信息冗余问题;二是用“合成CoT激活+课程RL”解决检索模型的训练不稳定问题。对于产业界来说,Retrv-R1的工程化成本低,3B参数版本就能满足大部分场景需求,部署门槛远低于其他大模型检索方案。
最后想问大家:你们在做检索模型时,是否遇到过token爆炸或训练不收敛的问题?如果用Retrv-R1的方案,你觉得最需要调整的是哪个模块?欢迎在评论区交流你的复现经验或改进思路!
参考资料
• 标题:Retrv-R1: A Reasoning-Driven MLLM Framework for Universal and Efficient Multimodal Retrieval
• 原作者:Lanyun Zhu, Deyi Ji, Tianrun Chen, Haiyang Wu, Shiqi Wang
• 机构:香港城市大学、腾讯、浙江大学
• 链接:https://openreview.net/pdf?id=8y18QBU2s6