MTEB国际文本表征新标杆:腾讯+深河套提出KaLM,刷新表征天花板
在做RAG系统落地时,经常遇到一个棘手的问题:大参数量嵌入模型(比如7B、13B)性能够强,但部署时显存占用太高,小模型又总是在语义区分度上掉链子。直到看到KaLM-Embedding-V2这篇论文,才发现原来通过训练技术和数据质量的系统性优化,紧凑模型也能实现性能跃迁——这篇研究用0.5B参数模型,在中英文MTEB基准上超越了众多同尺寸模型,甚至能和3-26倍参数量的大模型掰手腕,给低资源场景的嵌入模型设计提供了全新思路。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
一、AI嵌入模型的核心痛点:性能与效率的两难抉择
文本嵌入作为NLP的基础技术,支撑着检索、分类、语义相似度计算等众多任务,尤其在RAG系统中,嵌入模型的质量直接决定了外部知识检索的准确性。但当前行业面临两个核心难题:
1. 性能瓶颈:多数嵌入模型要么依赖海量数据堆砌,要么专注于模型规模扩大,却忽视了训练技术的精细化设计和数据质量的把控,导致模型泛化能力弱,在跨领域场景中表现拉胯。
2. 落地困境:state-of-the-art的大尺寸嵌入模型(如13B、7B)虽然性能出色,但计算成本高、推理速度慢,难以满足在线应用(如实时检索、智能客服)的效率需求;而小参数量模型又普遍存在语义表征能力不足的问题,难以区分细微的语义差异。
3. 开源壁垒:工业界的优秀嵌入模型大多闭源, 数据和训练代码不公开,导致学术研究难以复现,中小团队难以享受技术红利。
二、传统方案的局限:为何小模型难有大作为?
在KaLM-Embedding-V2之前,行业解决嵌入模型问题的思路主要有两种,但都存在明显短板:
1. 单纯扩大模型规模
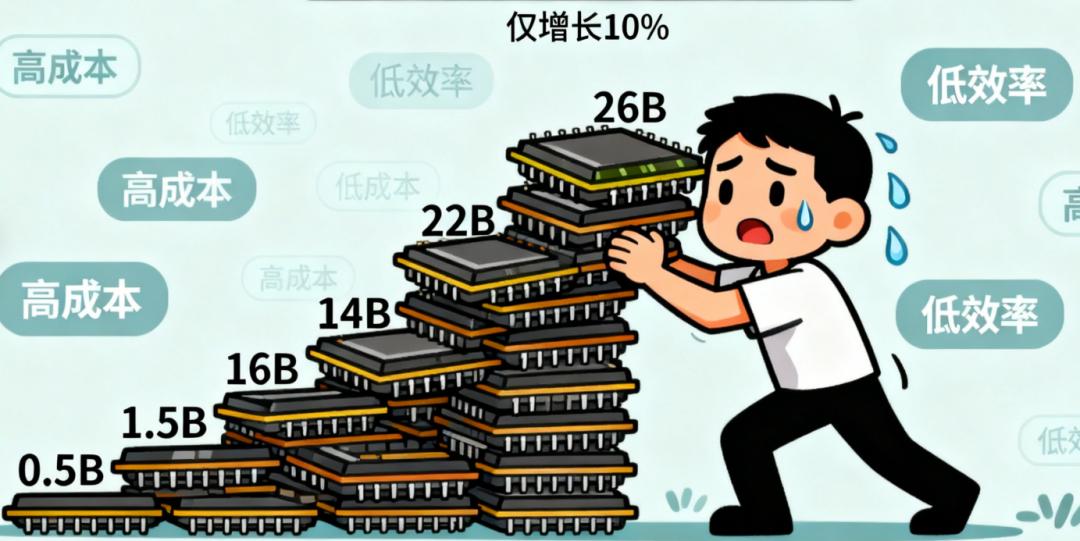
通过增加参数量提升表征能力,比如从0.5B扩容到7B、13B。这种方案的问题很直接:
• 计算成本呈指数级增长,训练需要数十甚至上百块GPU,推理时显存占用极高;
• 边际效益递减,参数量超过一定阈值后,性能提升变得微弱,反而加剧了部署难度。
2. 依赖海量数据训练
用大规模甚至合成数据进行预训练,试图让模型“见多识广”。但这种方案的缺陷在于:
• 数据质量参差不齐,噪声数据会干扰模型学习核心语义;
• 缺乏针对性的训练目标设计,模型难以聚焦关键样本,容易在简单样本上“浪费精力”,在困难样本上学习不足。
3. 架构设计固化
多数基于LLM的嵌入模型沿用了生成式模型的因果注意力掩码(只能单向关注前文),这种设计适合语言生成,但不利于语义表征——就像阅读文章时只能从头读到尾,不能前后对照,自然难以全面理解文本含义。
三、KaLM-Embedding-V2的创新突破:用精细化设计实现“小模型大作为”
KaLM-Embedding-V2的核心思路是:不盲目堆参数量和数据量,而是通过架构优化、训练流程革新、目标函数改进、数据质量把控的系统性设计,充分挖掘小模型的表征潜力。其技术方案可以拆解为四大核心模块:
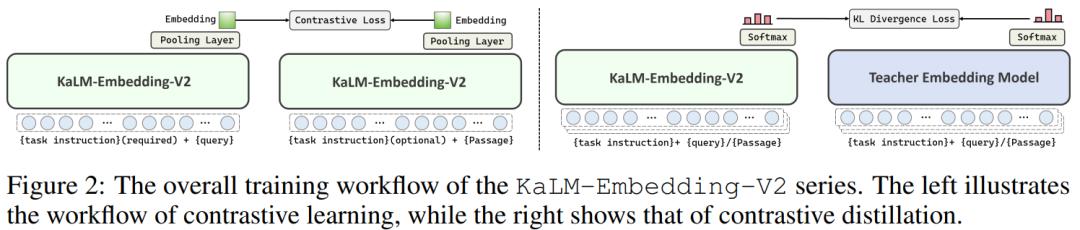
1. 架构优化:轻量且高效的基础设计
模型基于Qwen2-0.5B构建,保持494M参数量的紧凑尺寸,同时做了两个关键改进:
• 移除因果注意力掩码:启用全双向注意力机制,让模型在处理文本时能同时关注上下文信息——这就像看论文时可以前后翻阅对照,而不是只能从头读到尾,能更全面地捕捉语义关联。
• 采用均值池化(mean-pooling):用简单却有效的均值池化生成固定长度嵌入,避免了复杂池化操作带来的计算开销,同时保证了表征的稳定性。
这种设计的优势很明显:在不增加参数量的前提下,通过架构调整提升了表征效率,为后续训练打下了良好基础。
2. 训练流程:三阶段递进式学习
不同于传统的“预训练+微调”两阶段模式,KaLM-Embedding-V2设计了“预训练→微调→对比蒸馏”的三阶段流程,就像科研工作的“初步探索→精细验证→吸收先进经验”三个步骤,逐步提升模型的表征能力:
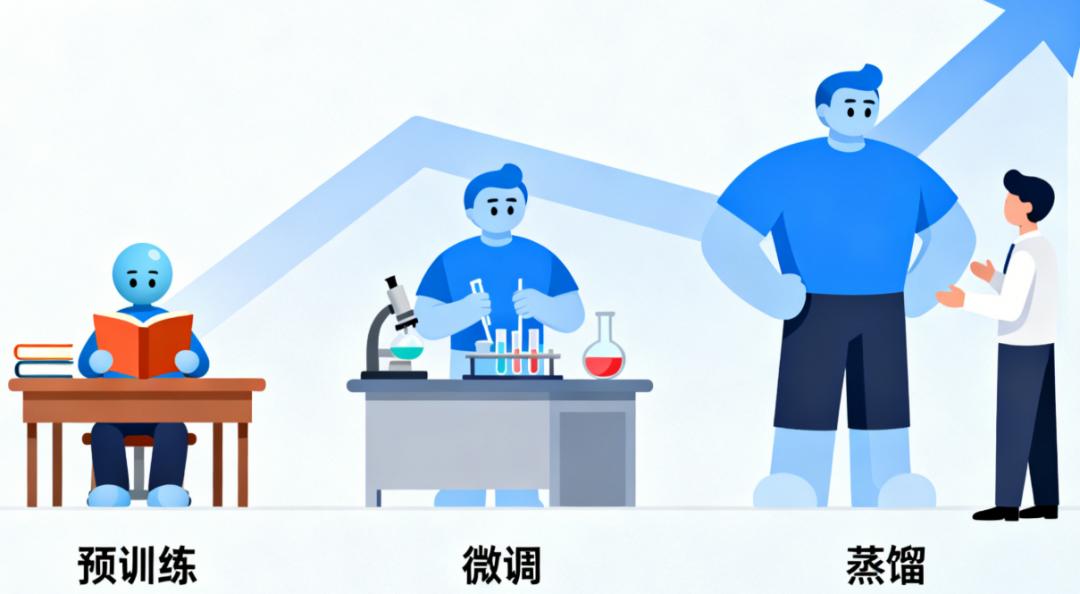
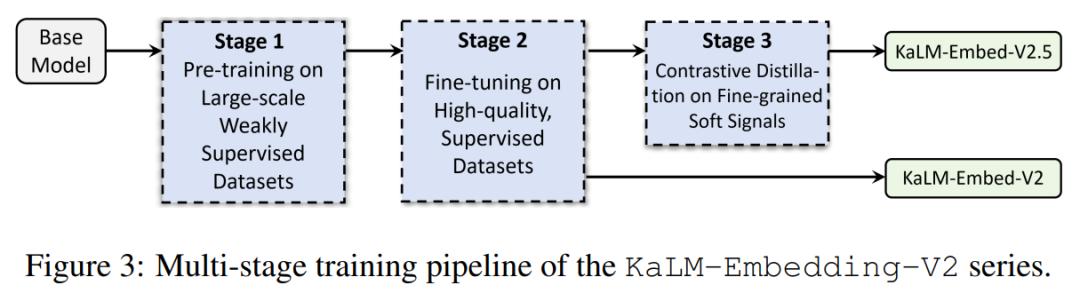
• 第一阶段:弱监督预训练:在20多个类别的大规模弱监督数据集(约470M样本)上训练,让模型学习通用语义表征——这一步相当于科研入门,广泛涉猎不同领域知识,建立基础认知。
• 第二阶段:高质量微调:在100多个类别的高质量监督数据集(约6M样本)上微调,涵盖检索、分类、语义相似度等多种任务——类似科研中的聚焦方向,在具体场景中打磨技能,提升任务适配性。
• 第三阶段:对比蒸馏:以更强的Qwen3-Embedding-8B为教师模型,蒸馏细粒度的软信号——相当于向领域大牛学习,吸收先进经验,捕捉语义中的细微差异。
这种递进式训练让模型从粗粒度到细粒度逐步优化,避免了一次性训练带来的表征偏差。
3. 训练目标:聚焦关键样本与动态难例
针对传统训练中“平等对待所有样本”的缺陷,KaLM-Embedding-V2设计了两个核心机制,让模型把精力花在“刀刃上”:
• 焦点式重加权(Focal-style reweighting):给困难样本(语义区分度低的样本)分配更大的损失权重,让模型重点学习这些“硬骨头”——就像老师辅导学生时,会花更多时间讲解难题,而不是反复强调已经掌握的简单知识点。实验显示,移除这个机制后,模型在MTEB英文基准上的得分从69.33下降到68.70,是所有机制消融实验中下降最明显的,可见其重要性。
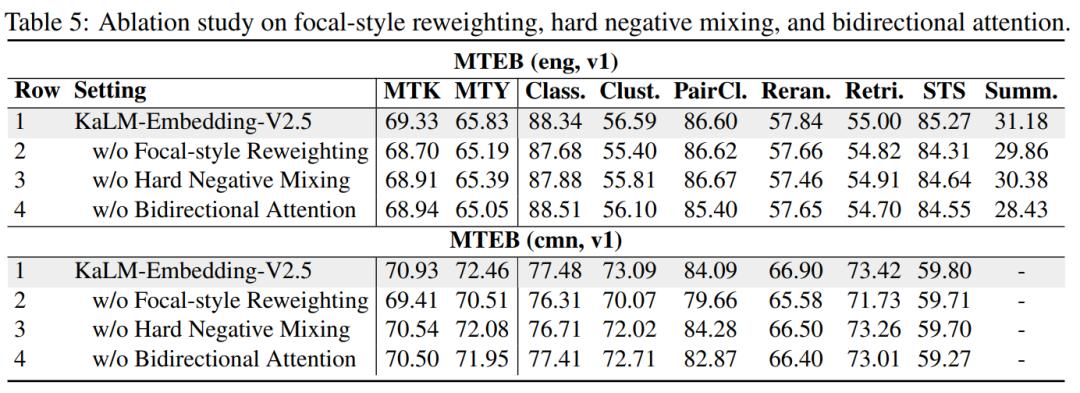
• 在线硬负样本混合:随着训练推进,离线挖掘的硬负样本会逐渐失去挑战性,模型容易陷入“舒适区”。为此,研究提出通过 pairwise 或 list-wise 混合现有硬负样本,动态生成新的硬负样本——相当于不断给模型出“新难题”,避免其懈怠。这种方式不仅保持了负样本的挑战性,还大幅降低了重新挖掘硬负样本的计算成本。
此外,模型还融合了对比学习(InfoNCE损失)和KL散度损失,分别保证语义区分度和蒸馏效果,让模型既“学得会”又“学得精”。
4. 数据质量:多类别、精细化的数据集构建
数据是模型的“燃料”,KaLM-Embedding-V2在数据构建上花了大功夫,核心策略包括:
• 覆盖广泛类别:预训练数据涵盖20多个类别,微调及蒸馏数据涵盖100多个类别,兼顾检索、分类、聚类等多种任务,提升模型泛化能力。
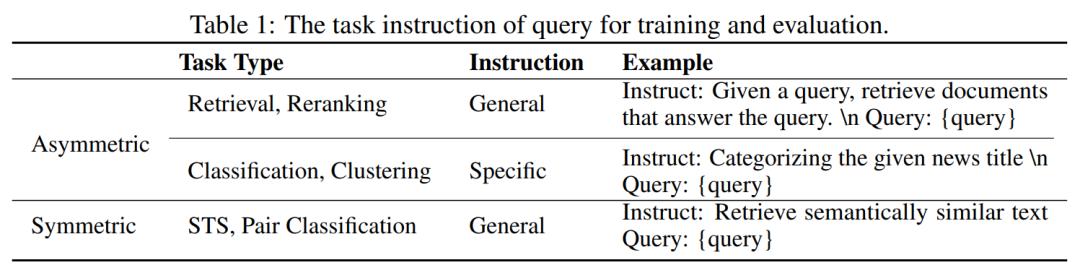
• 任务特定指令:给不同任务的查询添加专属指令(如检索任务指令为“给定查询,检索回答该查询的文档”),让模型理解任务意图,提升指令跟随能力。
• 硬负样本挖掘:通过已训练模型检索候选段落,筛选排名50-100的段落作为硬负样本,增强模型的语义区分能力。
• 示例级多类标注:对于分类、聚类任务,不仅使用标签信息,还从同一类别中采样示例作为正样本,从其他类别采样作为负样本,让模型学习更细粒度的类别特征。
这种精细化的数据构建方式,确保了模型训练的“燃料质量”,避免了垃圾数据对模型性能的拖累。
四、实验验证:0.5B参数的性能逆袭
KaLM-Embedding-V2在中英文MTEB基准上的表现堪称惊艳,充分证明了其技术方案的有效性:
1. 核心基准性能
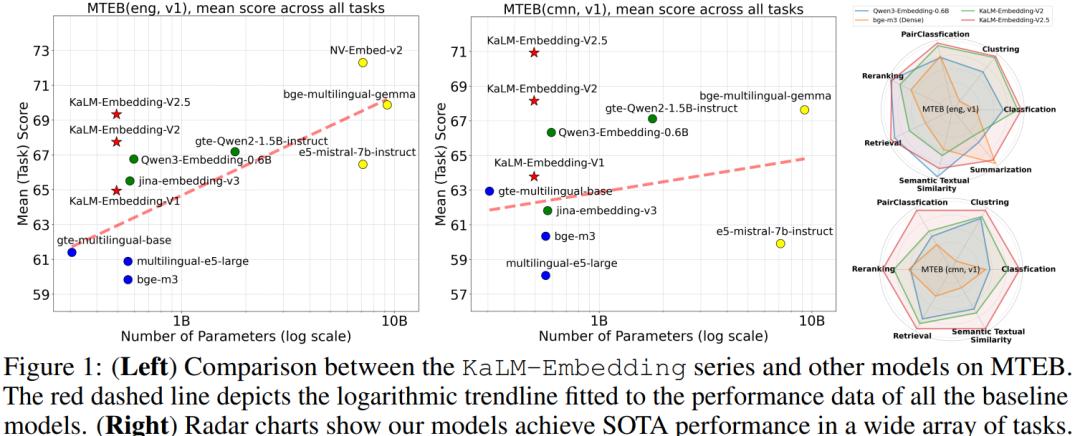
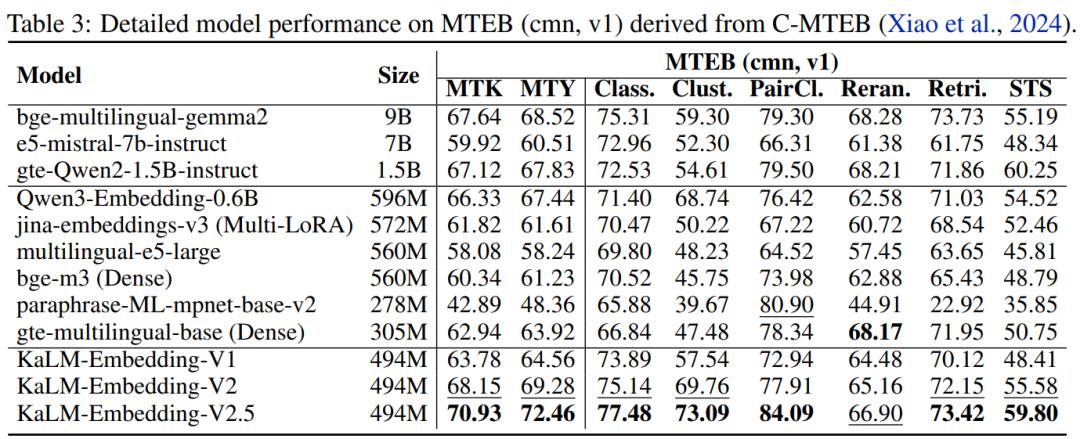
在MTEB英文基准(eng, v1)上,KaLM-Embedding-V2.5(蒸馏后版本)的平均得分为69.33,超过了所有0.5B级别的开源模型,甚至超过了1.5B参数的gte-Qwen2-1.5B-instruct(67.19分);在中文基准(cmn, v1)上,其平均得分达到70.93,大幅领先同尺寸模型,仅次于9B参数的bge-multilingual-gemma2(67.64分)。
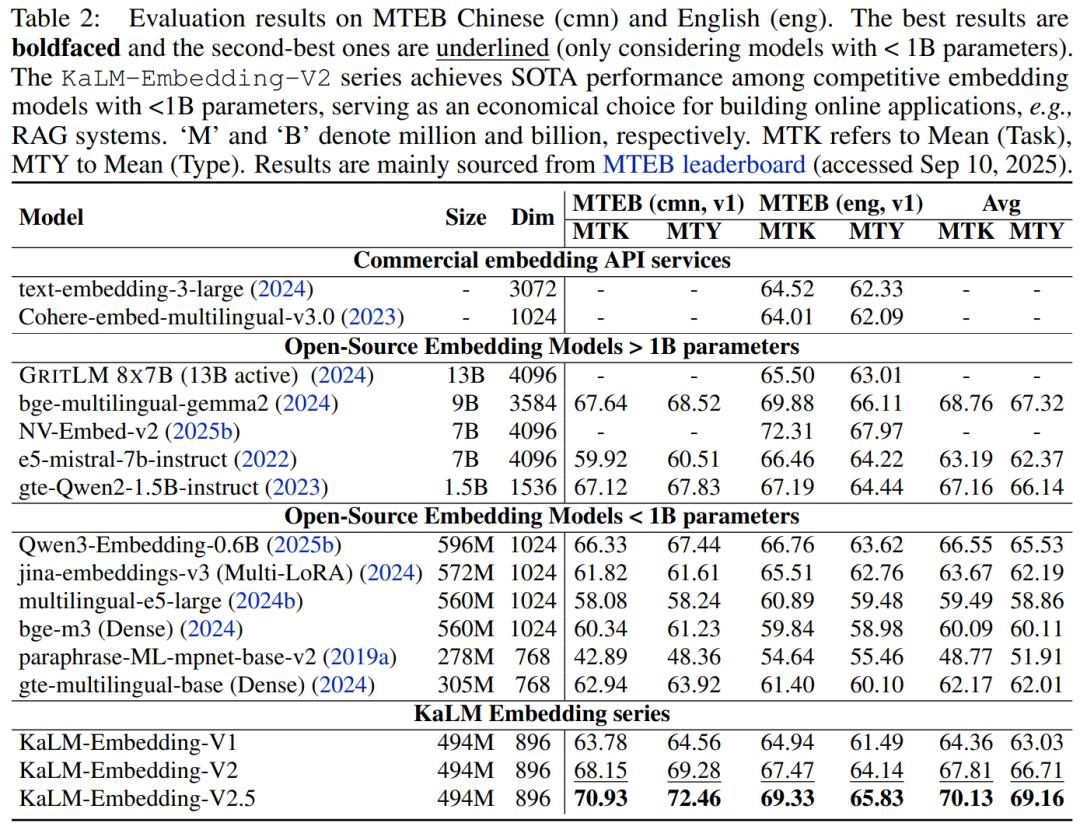
更值得关注的是,这个仅0.5B参数的模型,性能足以媲美3-26倍参数量的大模型——比如在中文检索任务中,它的表现接近7B参数的NV-Embed-v2,而参数量仅为后者的1/14。
2. 关键特性验证
• 跨领域泛化(OOD):在客服FAQ检索和游戏文档搜索两个真实工业场景中,KaLM-Embedding-V2.5的召回率和MRR(平均倒数排名)均超过同尺寸模型,甚至在部分指标上超越了7.57B参数的Qwen3-Embedding-8B,证明其强大的真实场景适配能力。
• 嵌套嵌入(Matryoshka):支持896、512、256等多种维度的嵌入输出,即使在256维的紧凑维度下,性能仅下降0.76%,远优于同类模型——这意味着在低带宽、低存储场景中,可通过降低维度进一步提升效率,而无需大幅牺牲性能。
• 语义区分度:在HotpotQA数据集的案例研究中,KaLM-Embedding-V2.5对正样本和硬负样本的区分能力显著强于V1版本和Qwen3-Embedding-0.6B,其正样本与负样本的相似度得分差距更大,说明模型能捕捉更细微的语义差异。
3. 训练效率优势
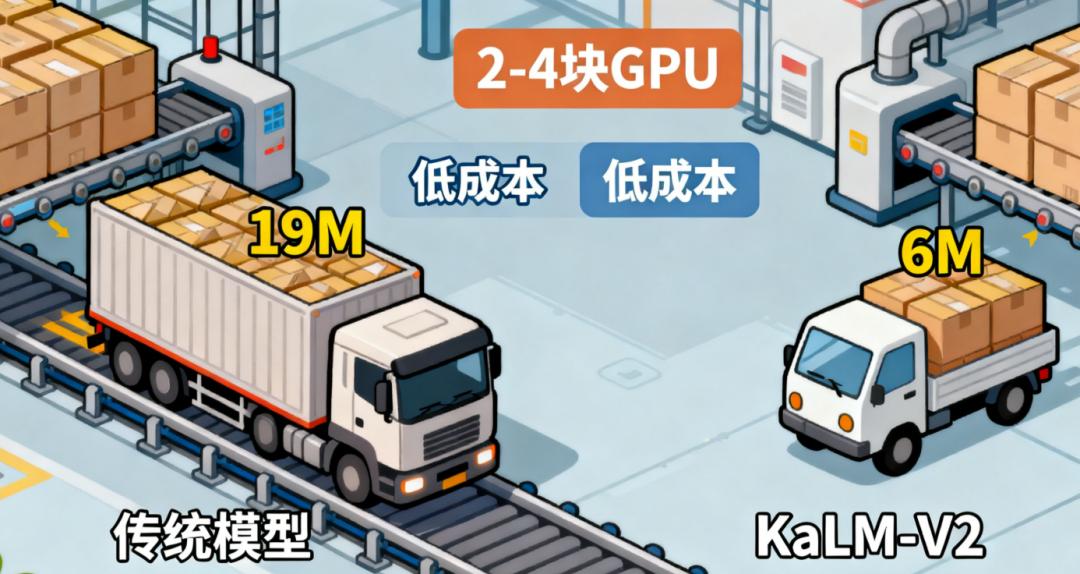
更难得的是,KaLM-Embedding-V2的训练成本极低:仅用2-4块GPU,在6M样本上完成微调与蒸馏,相比Qwen3-Embedding-0.6B使用的19M样本,数据量减少了近70%,却实现了更优的性能——这对于中小团队来说,无疑降低了技术复现的门槛。
五、落地前景与挑战
1. 适用场景
KaLM-Embedding-V2的核心优势是“紧凑+高性能”,尤其适合以下场景:
• RAG系统部署:作为检索模块的嵌入模型,在保证检索准确性的同时,降低服务器显存占用和推理延迟,提升并发能力。
• 实时语义匹配:如智能客服的FAQ匹配、实时推荐系统的内容匹配等,需要快速响应的在线场景。
• 低资源环境:中小团队、边缘设备等算力有限的场景,无需大规模硬件投入即可获得高质量嵌入效果。
2. 现存挑战
尽管表现出色,KaLM-Embedding-V2仍有进一步优化的空间:
• 多语言扩展:当前模型在中英文上表现优异,但在小语种场景的性能尚未充分验证,需要更多跨语言数据支持。
• 超长文本处理:最大输入长度为512 tokens,对于长文档(如论文、报告)的嵌入效果可能受限,需探索更长文本的处理方案。
• 极端低维场景:在64维等极端低维场景下,性能下降约4%,对于超紧凑嵌入需求(如大规模聚类),仍有优化空间。
六、总结:嵌入模型的“精耕细作”时代已来
KaLM-Embedding-V2的成功,打破了“大模型=高性能”的固有认知,证明了通过架构优化、训练技术革新和数据质量把控,小模型也能实现性能跃迁。这篇研究的核心启示在于:嵌入模型的发展已从“粗放式堆参/堆数据”进入“精耕细作”的阶段,精细化的技术设计比单纯扩大规模更能提升性价比。
对于科研人员来说,它提供了一套可复现的“小模型高性能”方案——从双向注意力架构、三阶段训练流程到焦点式重加权机制,每个模块都有明确的设计逻辑和实验支撑,便于后续研究借鉴;对于产业界而言,开源免费且支持商业使用的特性,让中小团队无需投入巨额成本,就能获得工业级的嵌入模型,加速了技术落地。
如果你正在做嵌入模型相关研究或RAG系统落地,不妨试试复现这个方案——或许能解决你在性能与效率之间的两难抉择。当然,复现时也可能遇到数据构建、蒸馏参数调整等问题,比如如何平衡硬负样本的难度与训练稳定性,如何适配自己的业务场景调整指令设计等。
参考资料
• 标题:KaLM-EMBEDDING-V2: SUPERIOR TRAINING TECHNIQUES AND DATA INSPIRE A VERSATILE EMBEDDING MODEL
• 作者:Xinping Zhao, Xinshuo Hu, Zifei Shan, Shouzheng Huang, Yao Zhou, Xin Zhang, Zetian Sun, Zhenyu Liu, Dongfang Li, Xinyuan Wei, Youcheng Pan, Yang Xiang, Meishan Zhang, Haofen Wang, Jun Yu, Baotian Hu, Min Zhang
• 机构:深圳河套学院、腾讯
• 链接:https://arxiv.org/pdf/2506.20923