Meta提出TTE先思考后表征新范式,突破多模态表征天花板
大家用视觉语言模型(VLM)做表征模型有没有遇到这样的问题:用7B模型,面对“找出视频里第三段出现的红色交通工具”这种需要推理的查询,精度很低,换成更大的72B模型,推理成本又涨了很多倍,根本没法落地。直到看到这篇2025年10月刚更新的Meta论文(Think Then Embed),才发现之前完全忽略了VLM的一个关键能力——生成式推理。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
这篇研究最惊艳的地方在于:让小模型先“思考”再“表征”,居然在国际知名多模态表征MMEB基准上超过了用海量私有数据训练的闭源模型,还把部署成本砍了一半。不管你是做多模态检索、搜推广系统,还是在为模型效率发愁,这篇论文的思路都能考虑借鉴——接下来我们会拆解它的核心逻辑、实验细节。
一、先聊个扎心的现实:多模态表征的“复杂指令死穴”
做过跨模态任务的人都知道,现在的通用多模态表征(UME)有个致命短板:遇到需要“拐弯”的指令,就像没带地图的导航——比如这些场景:
• 视觉定位任务:查询是“离相机第二近的车辆”,传统模型只会匹配“车辆”“相机”这些关键词,不会先排序车辆距离、再描述目标特征,结果把最远的车辆也检索出来;
• 视频QA任务:问“无人机拍摄的视频里,第20秒出现的建筑是什么风格”,模型没法解析“第20秒”对应的视频片段,只能瞎猜所有建筑的风格;
• 文档检索任务:需要从图表里找“2025年比2020年增长50%的指标”,模型不会先计算增长率,直接按“2025”“增长”关键词匹配。
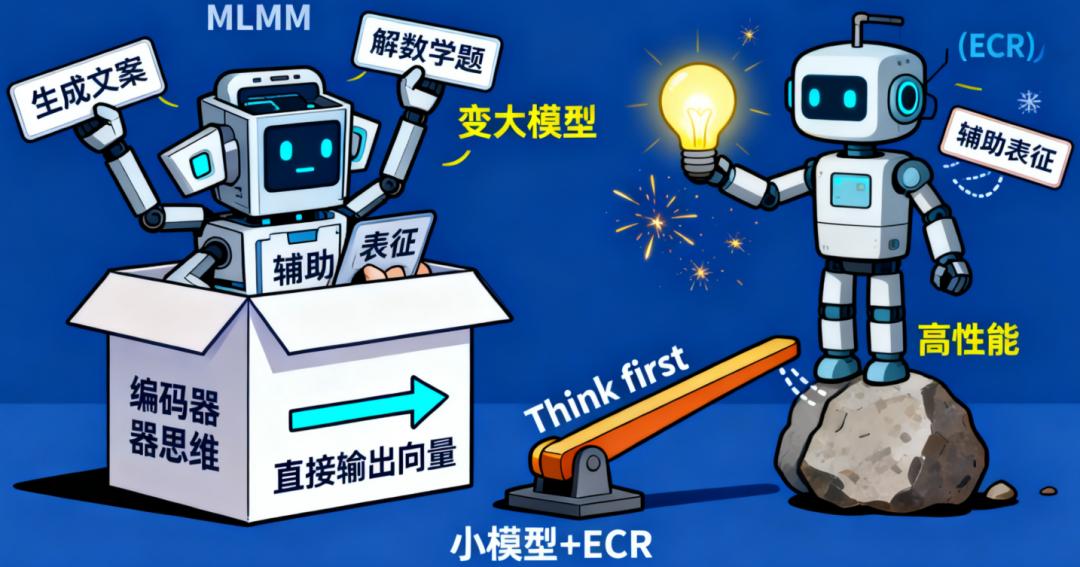
这些问题的根源,其实是传统方案把MLLM(多模态大语言模型)当成了“纯编码器”——就像让研究员只看题目直接写答案,不让他打草稿、理思路。比如VLM2Vec、UniME这些主流模型,都是把原始查询(图+文+指令)喂给MLLM,直接取最后一个token的隐藏态当表征向量,完全没用到MLLM的生成能力。
二、TTE框架:让模型先“打草稿”再“写答案”,核心就两步
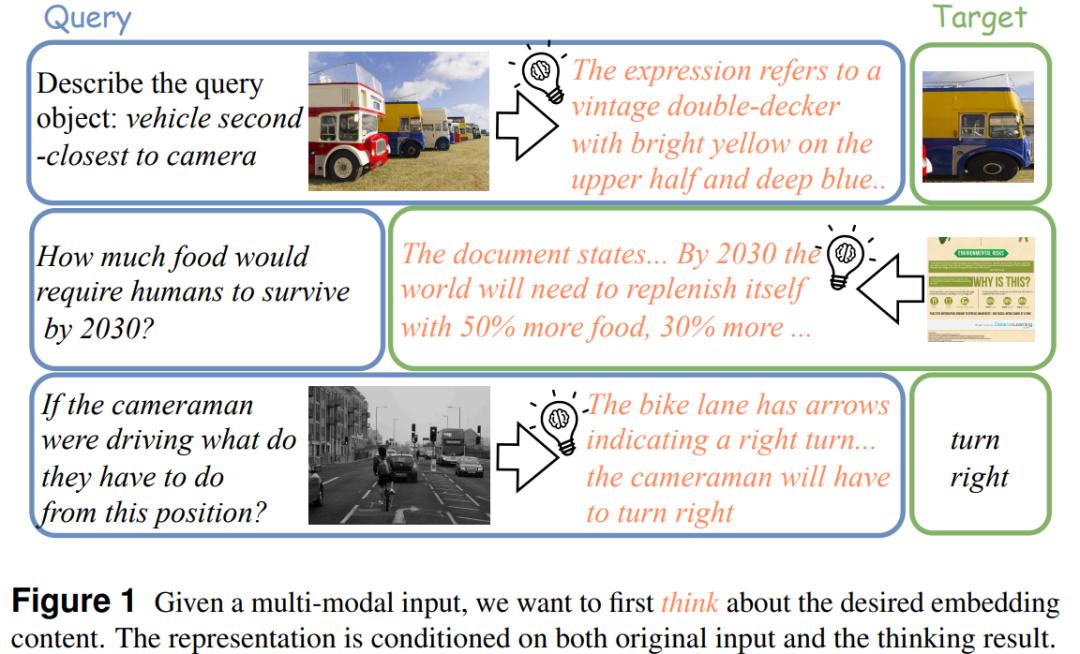
这篇论文提出的Think-Then-Embed(TTE)框架,解决思路特别直观:像训练研究生做科研一样,先让模型把推理过程写出来(打草稿),再根据草稿和原始问题,提炼出精准的表征向量(写答案)。整个框架就两个核心模块,我们一个个拆:
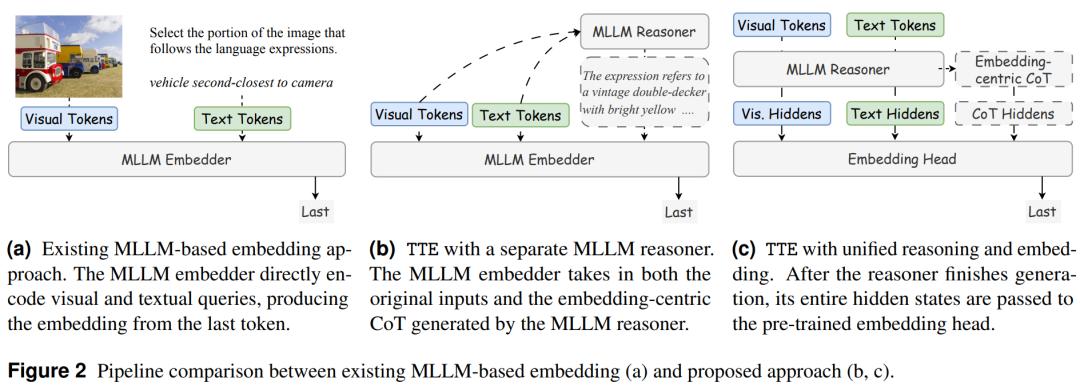
1. Reasoner:模型的“科研助理”,专门生成“表征导向的草稿”
Reasoner的作用不是直接给答案,而是生成一份“面向表征的推理轨迹(ECR)”——这和普通的Chain-of-Thought(CoT)不一样。普通CoT可能只说“答案是A”,而ECR会把对表征有用的细节全列出来,比如:
• 面对“离相机第二近的车辆”查询,ECR会写:“首先需要识别图像中所有车辆,按距离相机由近到远排序;第二近的车辆特征是‘上半部分亮黄色,下半部分深蓝色,属于双层巴士’,周围有绿色植被”;
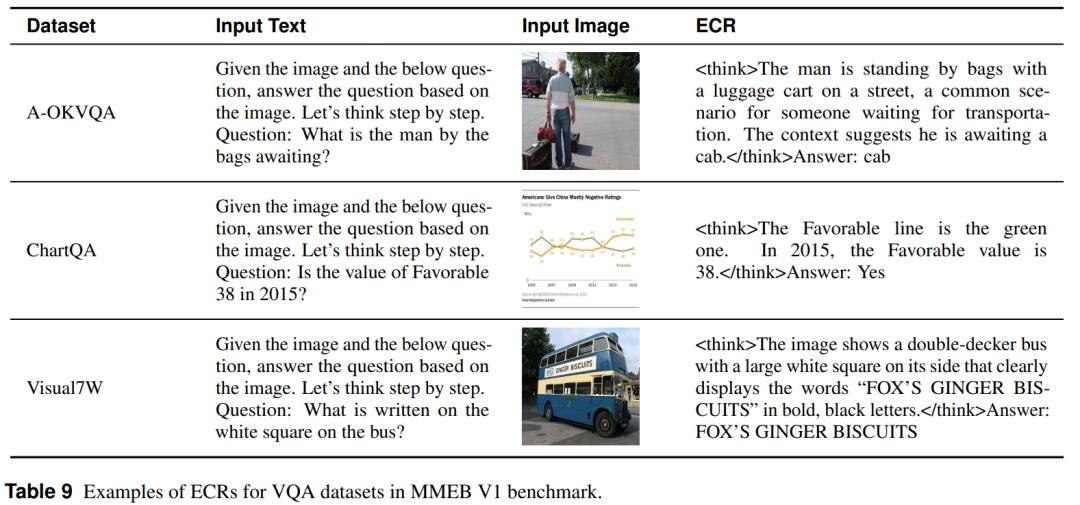
• 面对图表QA,ECR会写:“先定位2020年和2025年的指标数据,计算差值(2025年数值-2020年数值),再除以2020年数值,得到增长率50%的指标是‘粮食产量’”。
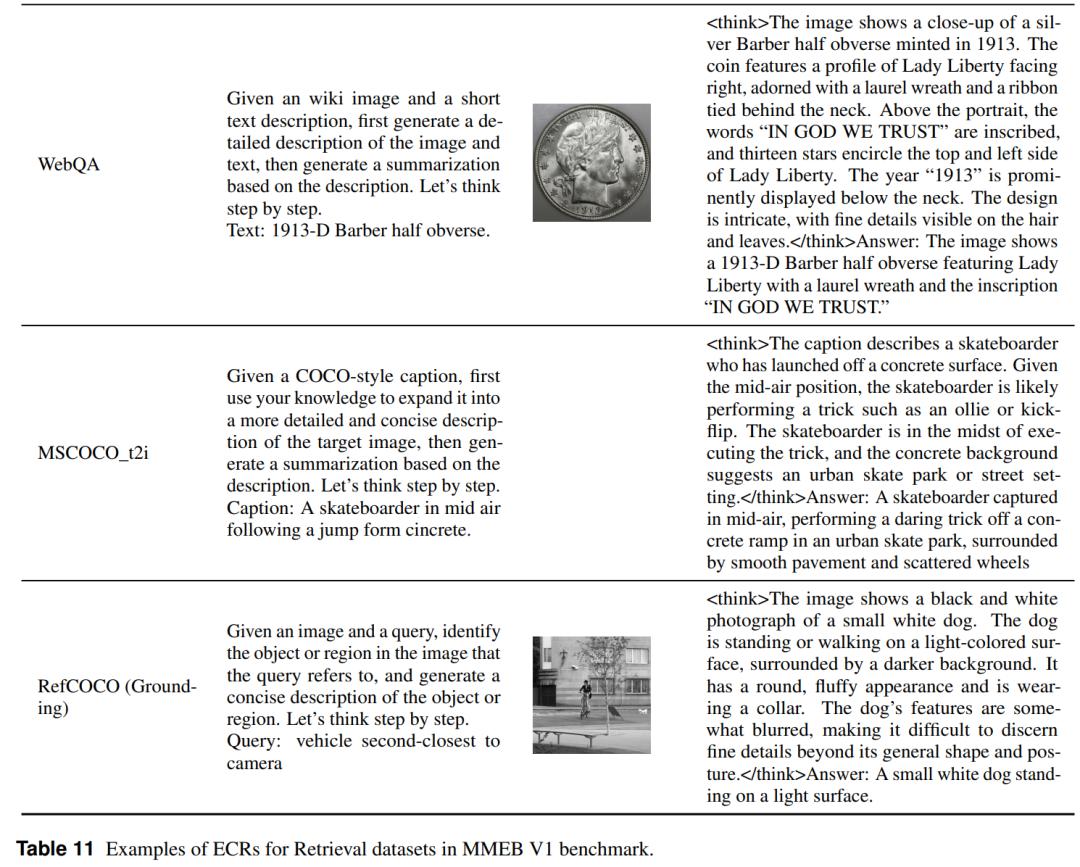
你可以把Reasoner理解成“科研助理”:拿到复杂任务后,先拆解步骤、标注关键信息,帮后续的“表征模块”省去推理步骤,直接聚焦核心特征。原文里用的Reasoner有两种:
• Teacher Reasoner:用大模型(比如Qwen2.5 VL 72B)生成高质量ECR,相当于让资深研究员写草稿;
• Student Reasoner:把小模型(比如Qwen2-2B/7B)用Teacher生成的ECR微调,相当于让研究生模仿资深研究员的思路,成本低还能复用。
2. Embedder:模型的“研究员”,结合草稿和问题出结果
Embedder的任务很明确:把原始查询(图+文+指令)和Reasoner生成的ECR,一起喂进模型,再输出表征向量。这里的关键是“双向结合”——不是只看ECR,也不是只看原始问题,而是像研究员写论文时,既参考自己的草稿,又核对原始数据,确保结论精准。
举个具体例子:做“视频里第三段的红色交通工具”检索时,Embedder会同时接收“原始视频+查询文本”和ECR(“第三段对应视频时间00:01:20-00:01:50,红色交通工具是消防车,特征是红色车身、顶部有云梯”),然后生成表征向量。这时候向量里不仅包含“消防车”“红色”这些关键词,还包含“第三段”“00:01:20”这些推理后的时空信息,检索准确率自然更高。
这里有个容易误解的点:ECR不是用来直接检索的。原文做过对比实验:把ECR单独用Jina-V3文本编码器做表征远低于TTE的结果。这说明ECR更像“辅助线索”,需要和原始查询结合才能发挥作用——就像研究员的草稿不能直接当论文发表,必须结合原始数据整理成正式内容。
三、三个核心创新:从“能做到”到“能落地”的关键
这篇论文不止提出了TTE框架,更解决了三个落地难题:大模型依赖、参数冗余、推理成本高。这三个创新点,也是我们觉得最有复用价值的地方:
1. 用“大模型教小模型”:小Embedder也能超越闭源大模型
第一个创新是“Teacher-Student范式”:用超大模型(Qwen2.5 VL 72B)当Teacher Reasoner生成ECR,再用小模型(Qwen2-7B)当Embedder。这么做的好处是“鱼和熊掌兼得”——既利用了大模型的推理能力,又保持了Embedder的轻量化。
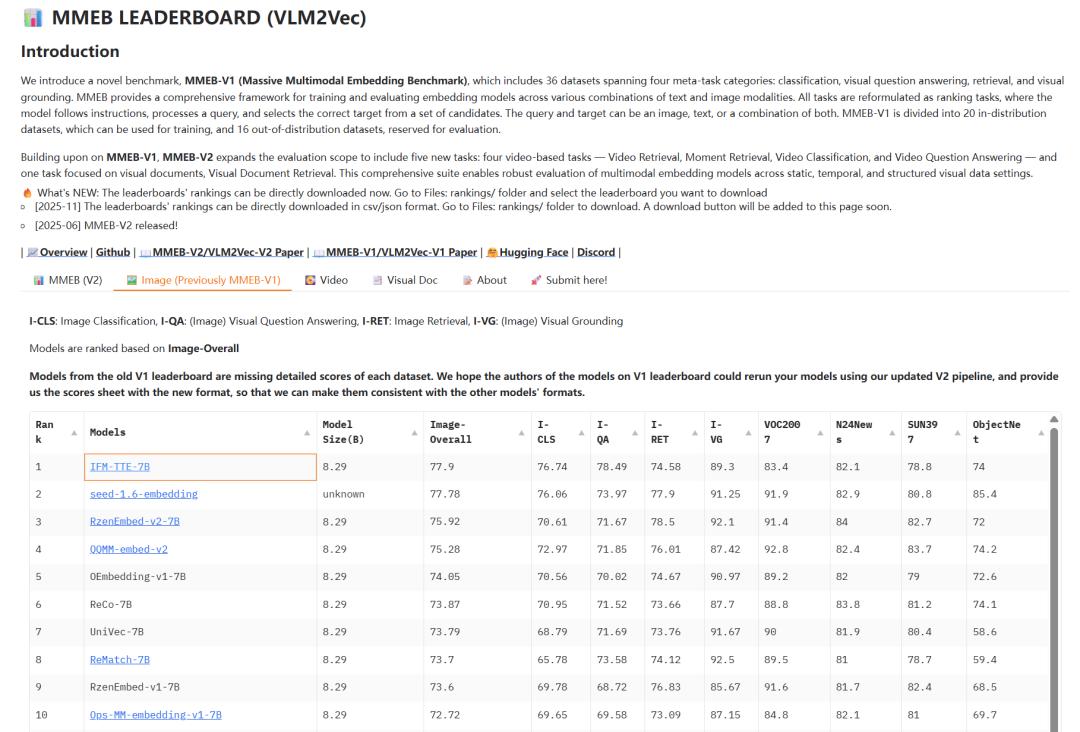
原文的实验结果特别有说服力:TTE_t(Teacher版本)在MMEB-V2上Overall得分71.5%,超过了用海量外部数据训练的闭源模型seed-1.6-embedding(71.3%)。要知道seed模型可是用了海量私有数据,而TTE只用了MMEB基准的公开数据,靠的就是ECR带来的推理增益。
2. 微调小模型当Reasoner:摆脱对大模型的依赖
第二个创新是解决“Teacher Reasoner太贵”的问题。虽然大模型生成的ECR质量高,但推理一次要占十几GB显存,没法部署。所以作者用Teacher生成的ECR数据,微调了一个小Reasoner(和Embedder同backbone,比如都是Qwen2-2B)。
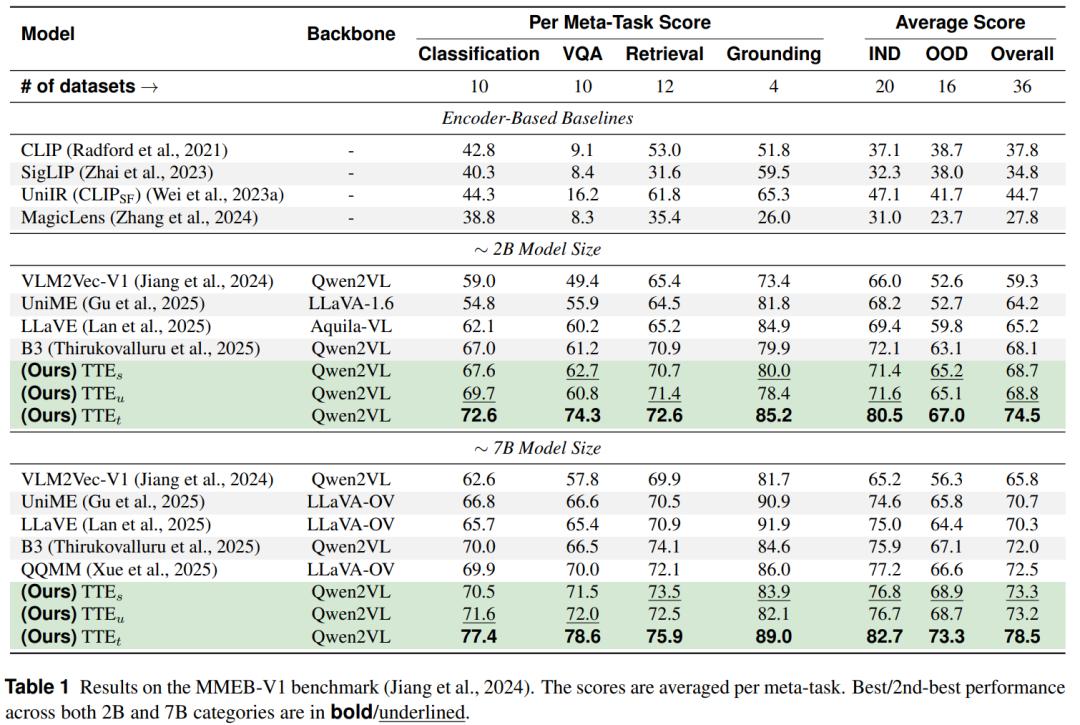
微调的逻辑很简单:让小Reasoner学习“输入原始查询→输出ECR”的映射,用的是标准的自回归损失。结果很惊喜:微调后的TTE_s(Student版本)在MMEB-V1上,Overall得分68.7%,比未训练的小Reasoner高6个百分点。
这对中小课题组太友好了——不用买大模型算力,只用公开ECR数据微调小模型,就能获得接近大模型的推理能力。
3. 统一Reasoner和Embedder:参数减半,性能不丢
第三个创新是解决“两个模型太冗余”的问题。之前的TTE需要单独训Reasoner和Embedder,部署时要加载两个模型,显存占用高。作者提出“统一模型”方案,核心是“两阶段训练+可插拔表征头”:
• 第一阶段:把 backbone(比如Qwen2-7B)全量微调成Reasoner,专注生成ECR;
• 第二阶段:冻住backbone,只训一个“表征头”(比如MHSA模块),让表征头从Reasoner的隐藏态里提取表征向量。
这么做相当于让“科研助理”和“研究员”合二为一——同一个人先写草稿,再根据自己的草稿整理答案,不用两个人分工。原文的实验显示:统一后的TTE_u在MMEB-V1上Overall得分68.8%,和单独训练的TTE_s几乎持平,但模型参数少了一半(不用再加载两个独立模型)。
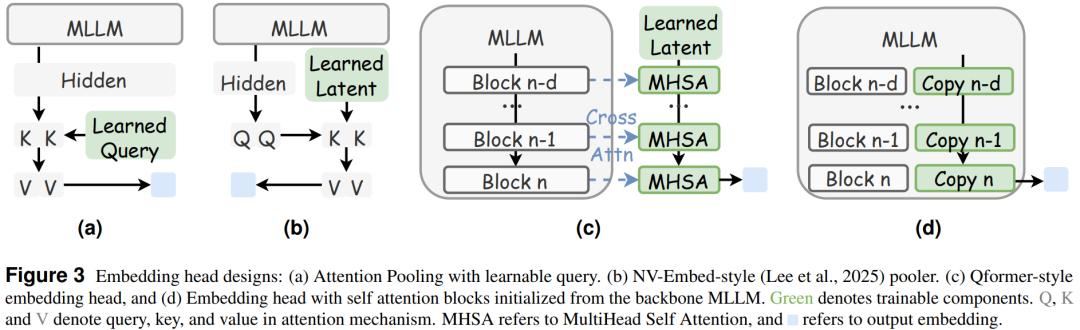
这里有个关键细节:表征头的设计很影响效果。作者对比了4种表征头(注意力池化、NV-Embed风格、QFormer风格、MHSA),发现用“从backbone复制最后8层初始化的MHSA头”效果最好——这是因为MHSA能更好地捕捉ECR里的长程依赖,比如“先排序再识别”的逻辑关系。
四、实验验证:哪些场景效果最明显?落地要注意什么?
看论文不能只看SOTA,还要搞清楚“在什么场景有用”“需要什么条件”。原文做了大量消融实验,我们挑几个关键的讲:
1. 最受益的场景:需要多步推理的任务
TTE的优势在复杂任务上最明显。比如:
• 视频QA任务:TTE_t-7B的准确率是68.2%,比VLM2Vec-V2-7B的33.9%高了近一倍;
• 视觉Grounding任务:TTE_t-2B的Precision@1从VLM2Vec的77.3%涨到87.2%;
• 文档检索(VisRAG):TTE_t-7B的NDCG@5达到91.4%,比模型RzenEmbed高5个百分点。
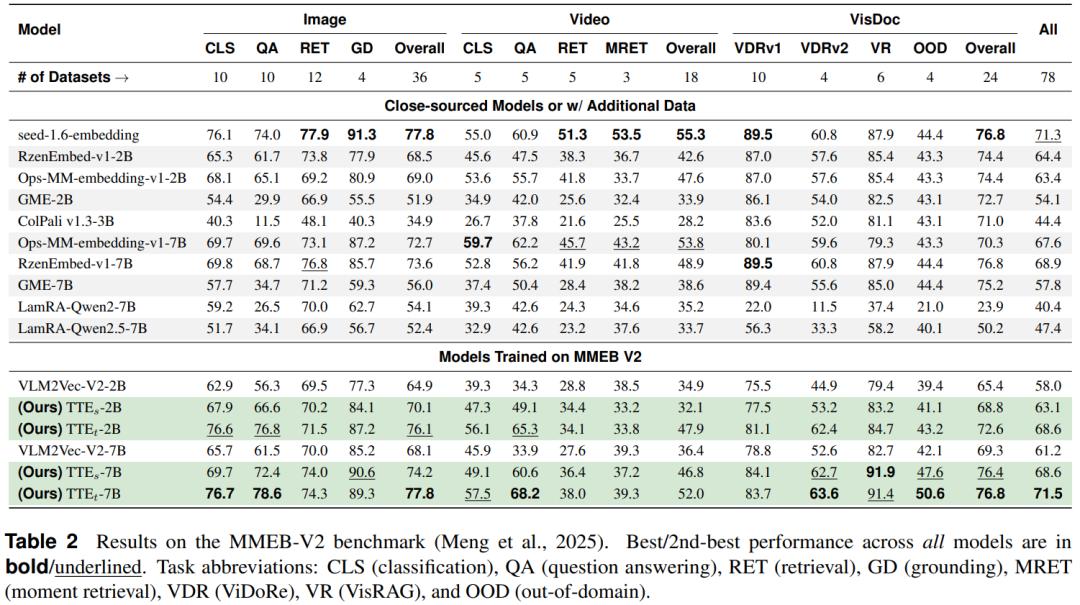
反而在简单的图像分类任务上,TTE的提升不多(比如ImageNet-1K上只高2个百分点)——这很合理,因为简单任务不需要复杂推理,ECR的增益有限。所以如果你做的是简单的图文匹配,可能不用上TTE;但如果是视频检索、复杂QA、图表分析,TTE的效果会特别突出。
2. 关键消融实验:ECR里的“草稿”不能省
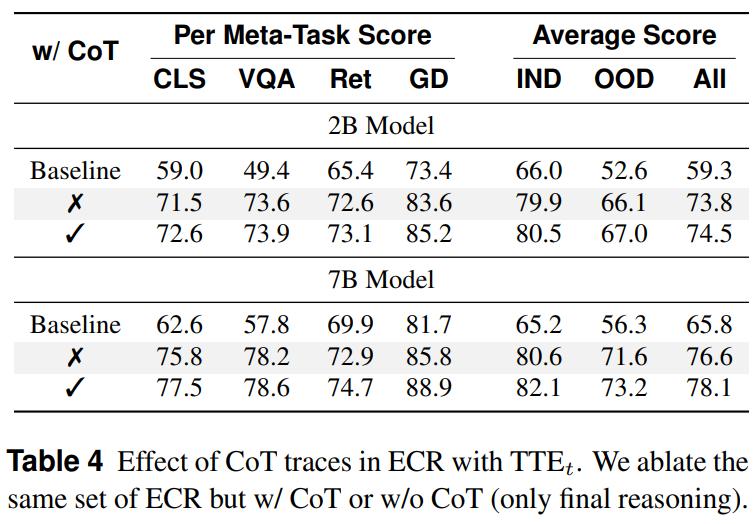
作者做了组对比实验,去掉ECR里的中间推理步骤(只保留最终结论),结果TTE_t-7B在MMEB-V1的Overall得分从78.1%掉到76.6%,尤其是检索和Grounding任务,掉分更明显。这说明“中间思考过程”比“最终结论”更重要——就像研究员的草稿里,推导步骤比答案本身更能体现思路。
还有个实验很有意思:作者在ECR里加入10%的“错误推理”(比如把“第二近”写成“第三近”),结果TTE的性能只掉了1.2个百分点。这说明Embedder很“聪明”,不会盲目相信ECR,而是会结合原始查询验证——相当于研究员看草稿时,会核对原始数据,发现草稿里的小错误并修正。
3. 落地成本参考:硬件和训练细节
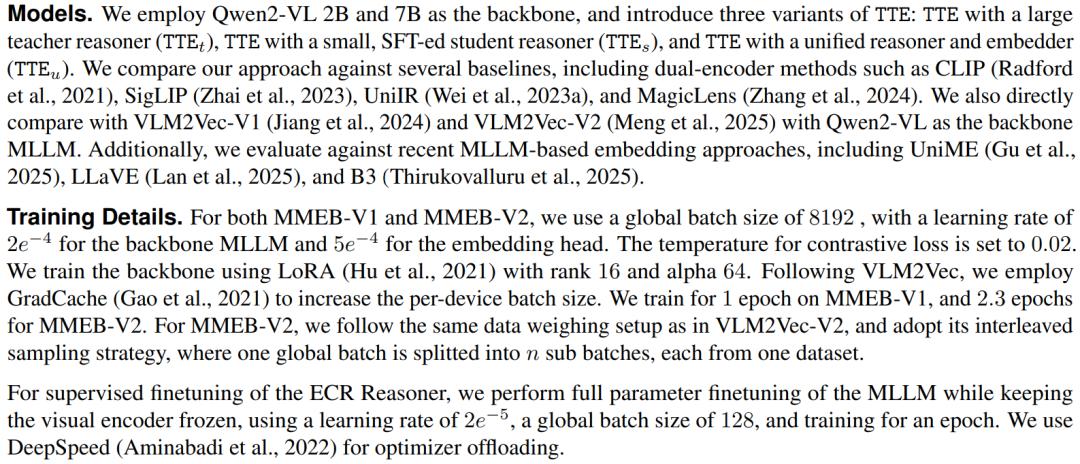
原文的训练细节对复现很重要,我们整理了关键参数:
• 训练策略:
• Embedder用LoRA微调(rank 16,alpha 64),学习率2e-4,用batch size 8192(用GradCache提升单卡batch size),对比学习温度系数0.02,MMEB-V1训练 1 epoch, MMEB-V2 训练 2.3 epochs;
• Reasoner全量微调,学习率2e-5,用batch size 128,使用DeepSpeed优化负载,训练 1 epoch。
• 数据处理:ECR训练数据里混入50%的“噪声”(比如改写表述、隐藏部分ground truth),避免Embedder过拟合到完美ECR。
五、前景与挑战:这篇研究能复用在哪?有什么坑要避?
1. 值得复用的方向
• 跨模态检索系统:比如智能客服里的“根据用户描述找产品视频”,用TTE能提升复杂查询的准确率;
• 个性化推荐:比如“推荐视频里出现过的红色运动鞋”,ECR能帮模型精准定位视频片段和商品特征;
• 多模态Agent:让Agent先推理“用户需要什么信息”,再生成表征向量去检索知识库,比直接检索更高效。
2. 需要注意的挑战
• ECR生成速度:虽然统一模型降低了部署成本,但Reasoner生成ECR还是会增加 latency——比如在视频检索里,生成ECR要多更多时延,对实时性要求高的场景(比如自动驾驶)可能不适用;
• Prompt设计依赖:ECR的质量很依赖Reasoner的Prompt——用不同Prompt生成ECR,结果性能波动达8个百分点,需要针对具体任务调Prompt;
• 小样本场景泛化性:在数据少的领域(比如医疗影像检索),微调Reasoner的效果会下降,这时候可能需要结合少量人工标注的ECR。
六、最后:这篇论文最值得学的,是“反直觉”的思路
这篇论文没有用复杂的Transformer改进,也没有搞新的损失函数,却能在MMEB基准上拿SOTA,核心是跳出了“编码器思维”——原来MLLM的生成能力,不仅能用来写文案、解数学题,还能帮表征学习“提效”。
对科研人员来说,这一点特别有启发:有时候卡壳不是因为技术不够难,而是因为没把现有工具的能力用透。就像我们之前一直纠结“怎么把Embedder模型变大”,却没想到“让小模型先思考”就能解决问题。
如果你也在做多模态表征或检索相关的研究,强烈建议看看原文(链接在下面),尤其是ECR的Prompt设计和表征头的对比实验,这些细节能帮你少走很多弯路。
最后想问下:你们在复现类似方案时,有没有遇到过ECR生成不稳定的问题?我们试过用温度参数控制生成多样性,效果还不错,欢迎在评论区交流更多调参技巧~
参考资料
• 标题:Think Then Embed: Generative Context Improves Multimodal Embedding
• 作者:Xuanming Cui, Jianpeng Cheng, Hong-you Chen, Satya Narayan Shukla, Abhijeet Awasthi, Xichen Pan, Chaitanya Ahuja, Shlok Kumar Mishra, Yonghuan Yang, Jun Xiao, Qi Guo, Ser-Nam Lim, Aashu Singh, Xiangjun Fan
• 机构:Meta AI、中佛罗里达大学、纽约大学
• 链接:https://arxiv.org/pdf/2510.05014