清华+上交NeurIPS'25最佳提名奖论文解读:评估RLVR真实能力边界
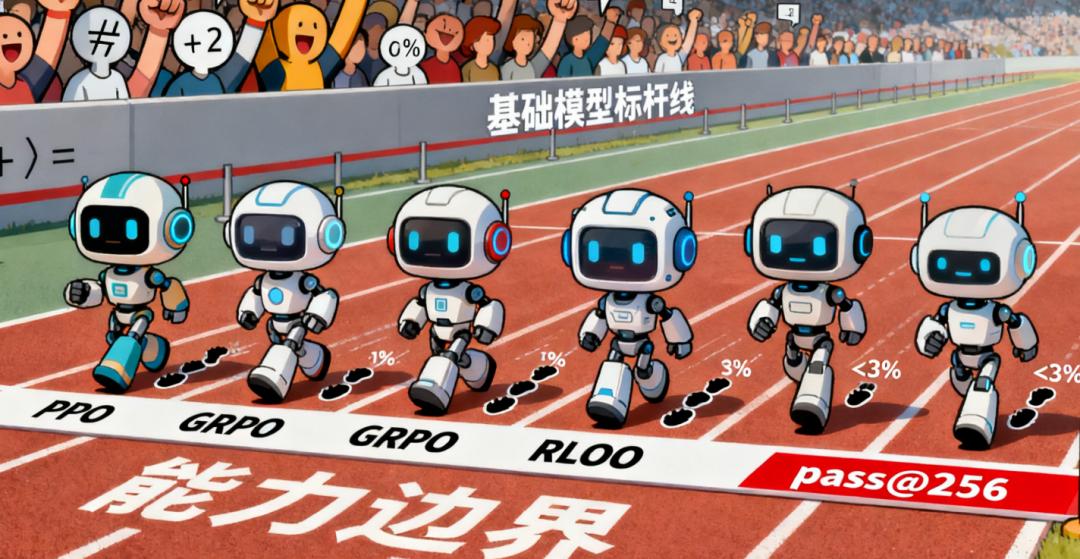
大家用GRPO等强化学习算法训练大模型是不是碰到过训练不稳定、训练效果过早饱和、更多数据没有带来效果提升等棘手问题。直到看到这篇NeurIPS 2025的最佳提名论文,我才恍然大悟:原来当前的带可验证奖励的强化学习(RLVR)只是“优化了效率”,并没有“扩展能力”。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
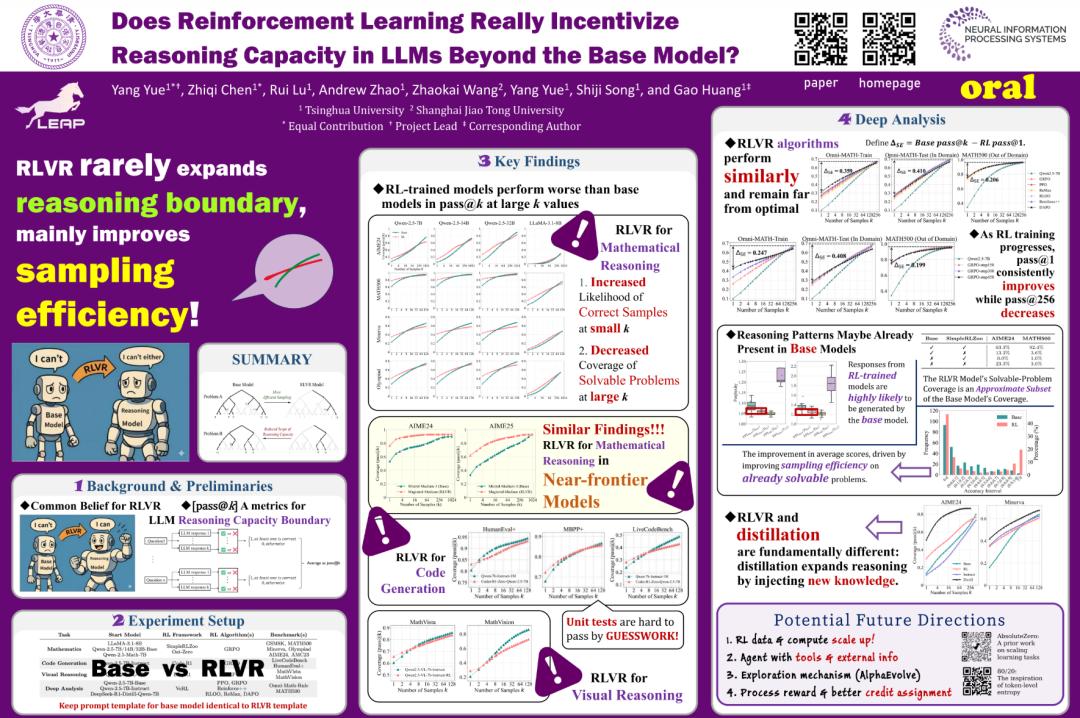
这篇来自清华LeapLab和上海交大的研究,用8个模型家族(Qwen2.5、LLaMA-3.1等)、6种主流RL算法(PPO、GRPO、DAPO等)和3类核心任务(数学推理、代码生成、视觉推理),彻底扒清了RLVR的真实边界。如果你也在做LLM推理调优,或者正纠结“要不要用RLVR提升模型能力”,这篇解读能帮你避开“效率陷阱”,找到真正的能力扩展方向。
一、先搞懂一个核心误区:我们为什么会高估RLVR?
做LLM推理研究的人,大多有个默认认知:RLVR能像AlphaGo一样,让模型自主探索新策略。毕竟AlphaGo从零开始,靠RL探索出了人类没见过的围棋招式;那LLM用RLVR,理应也能探索出新的解题思路——比如更简洁的数学推导步骤、更高效的代码逻辑。
但论文用实验戳破了这个误区:当前的RLVR不是“探索新策略”,而是“优化已有策略的效率”。
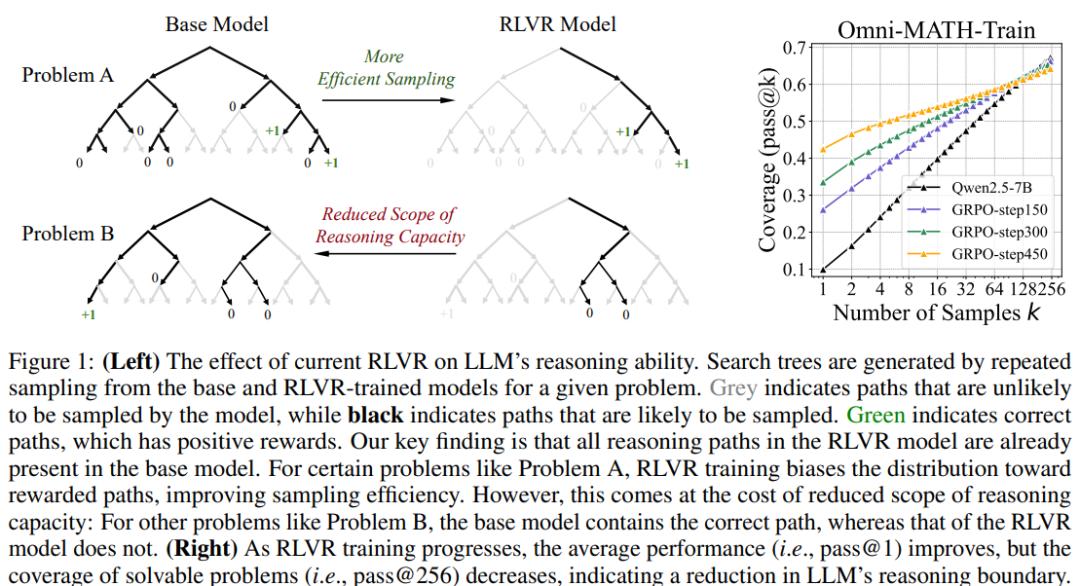
先简单解释下RLVR的工作逻辑:它给LLM加了个“可验证的奖励”——比如数学题,答案对了就给1分,错了给0分;代码题,能通过所有单元测试给1分,否则0分。然后用RL算法(比如PPO)优化LLM,让它更大概率生成能拿到奖励的输出。
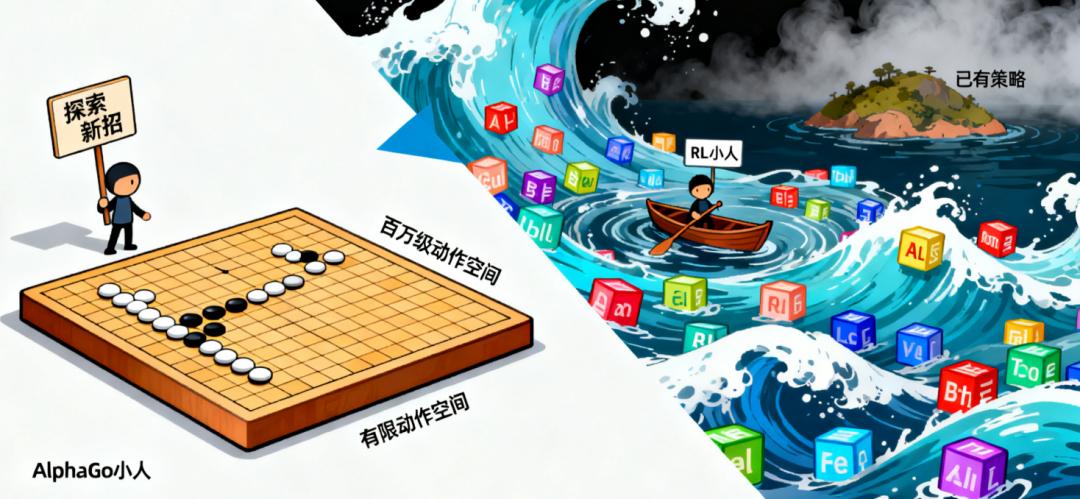
这个逻辑看似没问题,但问题出在“LLM的动作空间”上:围棋的动作空间是有限的(19×19棋盘,约361个落点),RL能慢慢探索;但LLM的动作空间是“词汇表+序列组合”,动辄百万级的可能,RL根本没办法探索到“基础模型没见过的路径”——就像你在一个巨大的图书馆里找书,RLVR只是让你更快找到“你本来就知道在哪的书”,却不会带你发现“新的藏书区”。
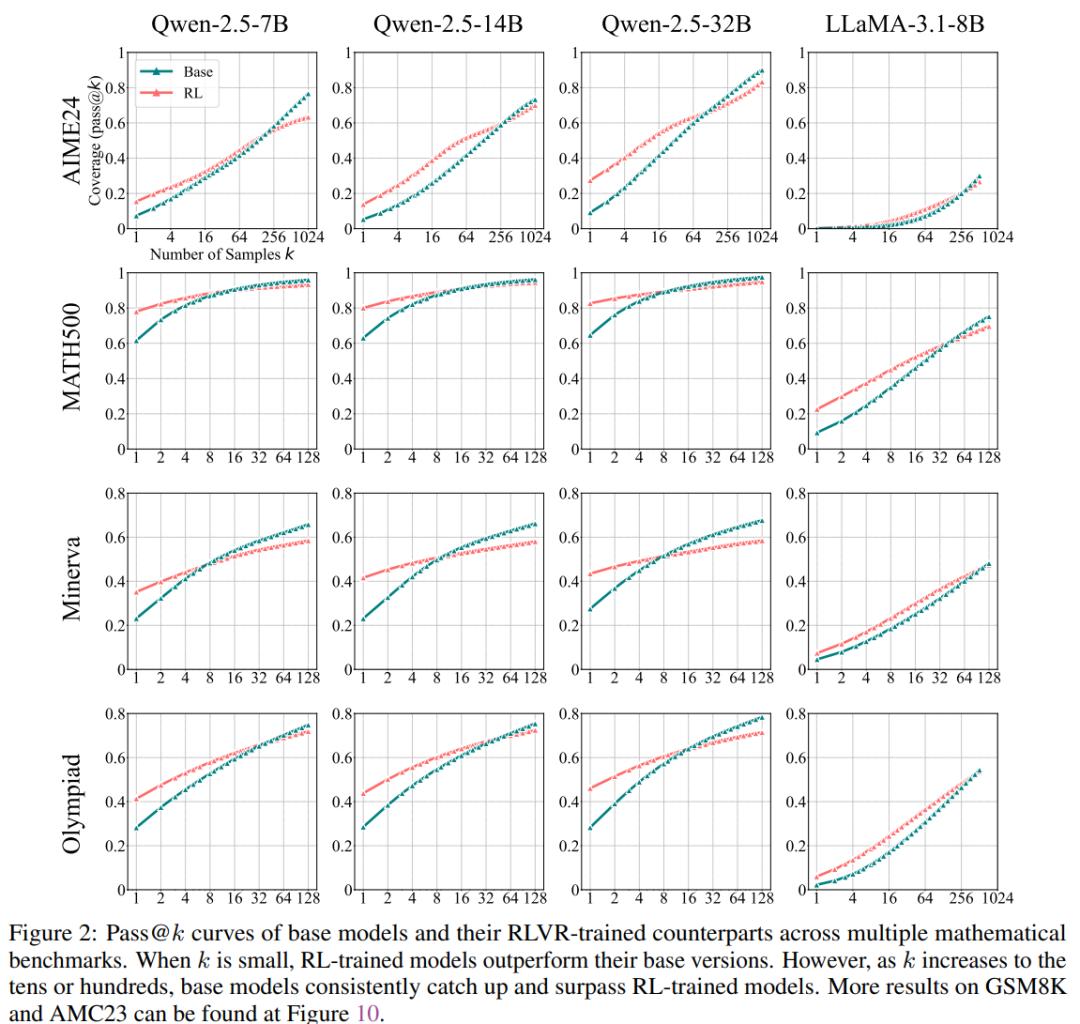
我们之前的错误,就是把“更快找到正确答案”当成了“能解更多题”。比如在AIME24、Minerva等数据集上,RL模型一次采样的正确率(pass@1)高于基础(Base)模型是,我们就觉得RL模型更强;但当采样次数增加到128时,基础模型的正确率反而超过了RL模型——这说明基础模型本来就能解这些题,只是需要多试几次,而RL模型虽然快,却丢了一部分基础模型能解的题。
二、三个关键实验:扒清RLVR的真实能力边界
论文最核心的价值,是用一套“从现象到本质”的实验,证明了“RLVR没扩展推理能力”。这三个实验的思路,甚至能直接复用到你自己的模型评估中,避免踩坑。
实验1:准确率分布——RLVR在“做取舍”,不是“做加法”
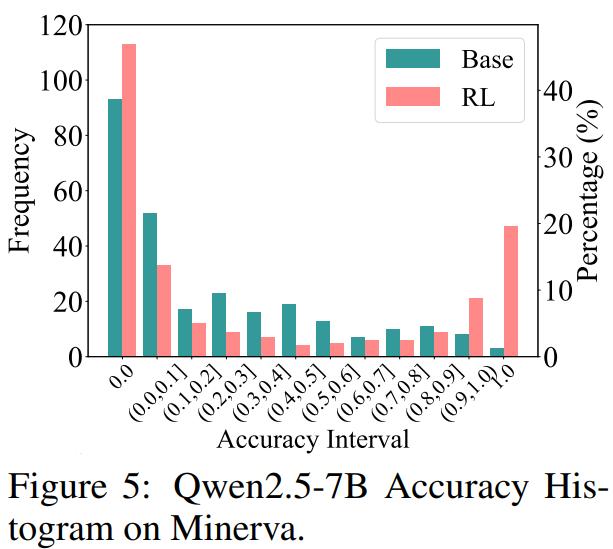
论文团队分析了Qwen2.5-7B在Minerva数据集上的准确率分布(每个问题的正确采样概率),发现了一个反直觉的规律:
• RLVR训练后,高准确率(接近1.0)的问题变多了:比如原本3%的问题有80%概率一次做对,RL训练后变成10%;
• 但低准确率(0.1-0.2)的问题变少了,准确率0的问题反而变多了:比如原本38%的问题完全解不出,训练后变成45%。
这就像一个学生:RLVR不是帮他学会新知识点,而是让他更擅长“把会做的题做对”,但代价是“把原本偶尔能蒙对的题彻底搞不会了”。比如有些数学题,基础模型多采样几次能给出正确的CoT(思维链),但RLVR训练后,模型只会生成“它认为能拿分的路径”,反而把其他可能正确的路径给“忘了”。
实验2:困惑度分析——RL模型的“新路径”,其实是基础模型的“旧库存”
为了证明RL模型没生成新路径,论文做了个困惑度(PPL)实验:困惑度越低,说明模型越“熟悉”某段文本——如果RL模型生成的正确路径,在基础模型里的困惑度很低,就说明这段路径本来就在基础模型的“认知范围内”。
实验过程很简单:让Qwen2.5-7B基础模型和RL模型,各自生成16个AIME24题目的解答,然后用基础模型计算RL模型解答的困惑度。结果发现:
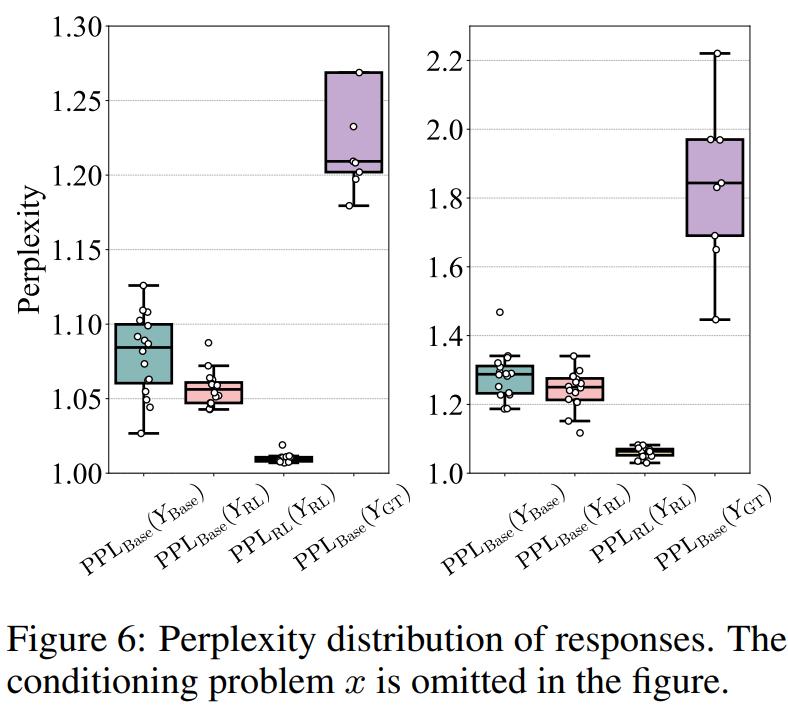
• RL模型生成的正确解答,其困惑度分布和基础模型自己生成的“高概率正确解答”几乎重合;
• 甚至随着RL训练的推进,RL模型解答在基础模型中的困惑度还在降低——这说明RL训练只是让模型“更聚焦于基础模型本来就擅长的路径”,而不是“探索新路径”。
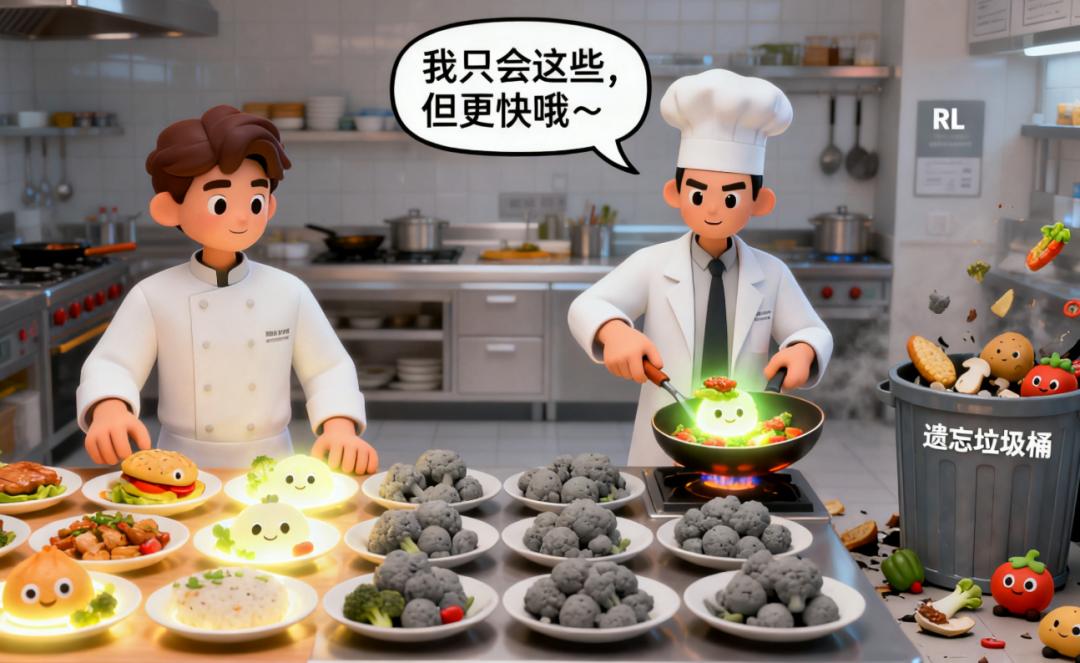
这个结论彻底改变了我们对RLVR的认知:之前我们以为RL模型能想出“基础模型想不到的解法”,其实只是RL模型更会“挑基础模型里对的解法”。就像两个厨师,基础厨师会做100道菜,其中20道做得好;RL厨师不会做新菜,只是把那20道做得好的菜练得更熟练,其他80道反而越做越差。
实验3:对比蒸馏——真正的“能力扩展”是什么样的?
论文团队还做了个关键对比:把RLVR和“蒸馏”放在一起比。蒸馏的逻辑是“让学生模型学老师模型的推理路径”——比如用DeepSeek-R1(强推理模型)的CoT数据, fine-tune Qwen2.5-7B。
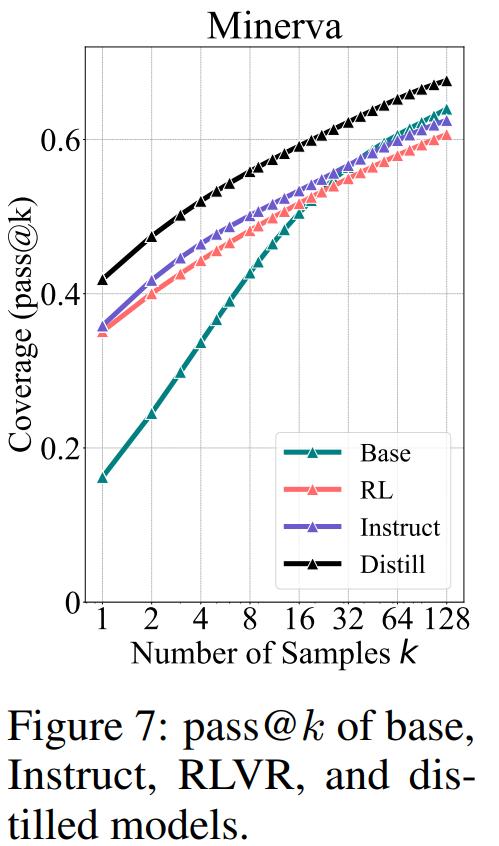
结果差异非常明显:
• RL模型的pass@k曲线,始终在基础模型曲线的“下方或交叉”
• 蒸馏模型的pass@k曲线,全程在基础模型上方。
更重要的是,蒸馏模型能解“基础模型和RL模型都解不出的题”。
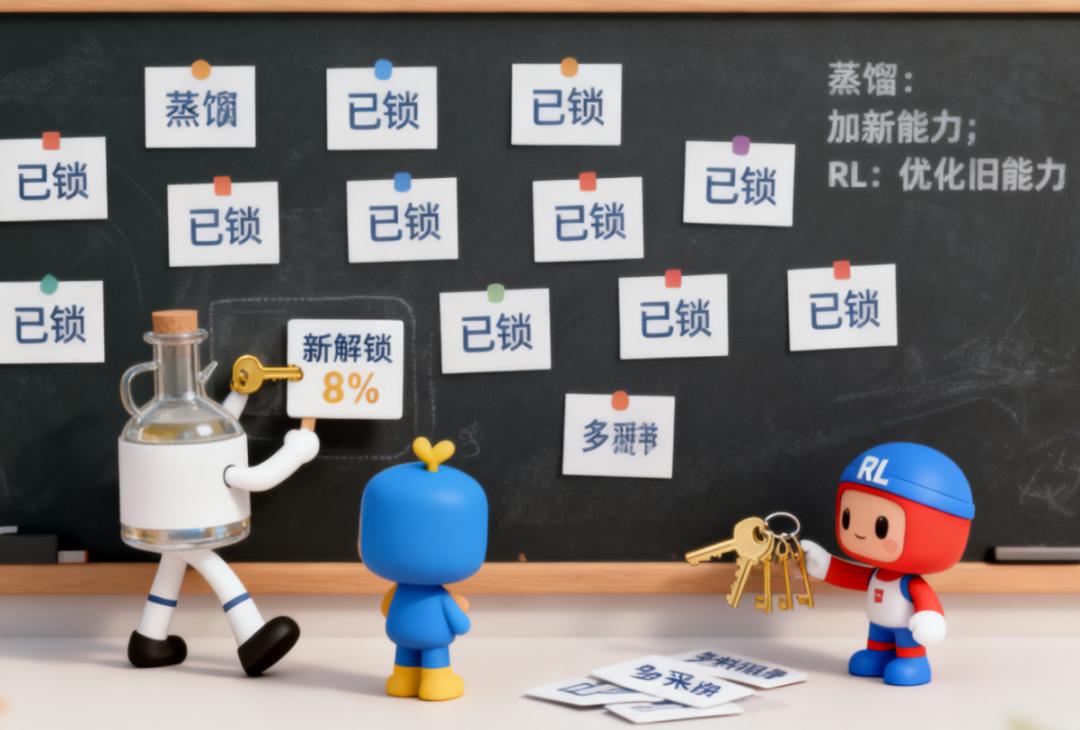
这说明什么?蒸馏是“给模型加新能力”,RLVR是“优化已有能力的效率”。如果你想让模型解更多难题,蒸馏才是方向;如果只是想让模型在“必须一次出结果”的场景(比如实时问答)表现更好,RLVR才有用。
三、6种RL算法大比拼:没有“最优算法”,只有“都不够好”
论文团队还做了个很实用的实验:对比了6种主流RL算法(PPO、GRPO、Reinforce++、RLOO、ReMax、DAPO)的表现,结果有点出人意料——
结论1:所有算法的“能力边界”都一样
不管用哪种算法,训练后的模型都逃不过“小k领先、大k落后”的规律。比如在Omni-MATH-Test数据集上:
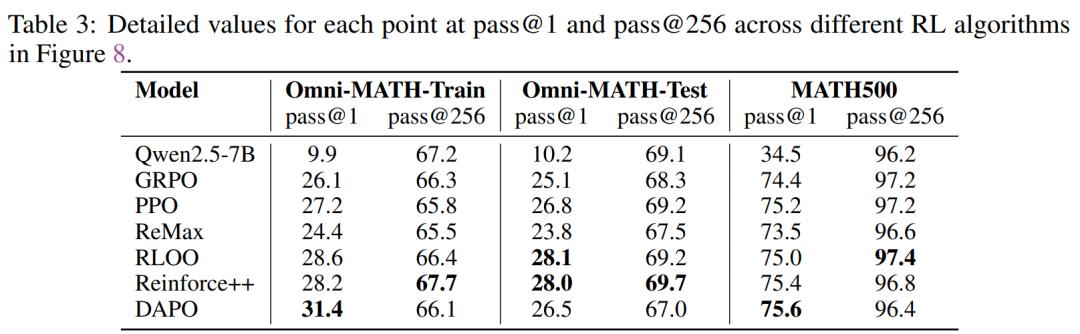
• GRPO(当前很火的算法)的pass@1是25.1%,pass@256是68.3%;
• PPO的pass@1是26.8%,pass@256是69.2%;
• 最好的RLOO,pass@1是28.1%,pass@256是69.2%。
结论2:采样效率差距(ΔSE)都很大,说明都没挖透基础模型潜力
论文提出了一个新指标“采样效率差距(ΔSE)”:用“RL模型的pass@1”减去“基础模型的pass@256”(pass@256近似基础模型的能力上限)。ΔSE越小,说明RL算法越接近“充分利用基础模型潜力”。
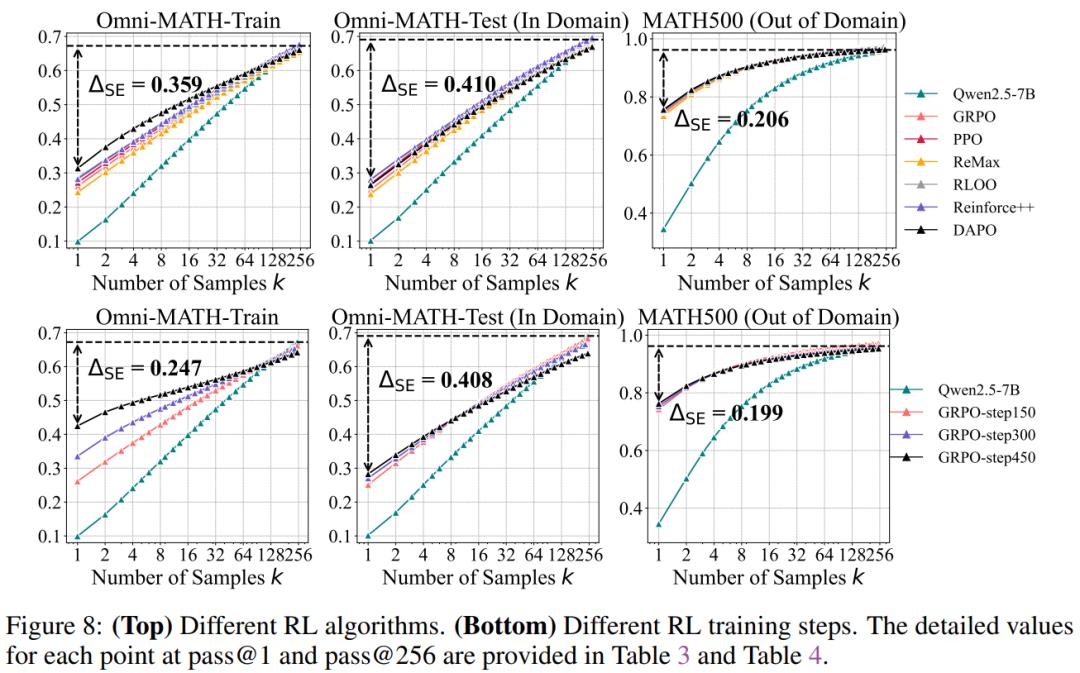
结果发现,所有算法的ΔSE都在40左右(比如GRPO是43.2,RLOO是41.0)——这意味着即使是最好的RL算法,都没有充分利用基础模型潜力。
四、落地启示:RLVR该怎么用?未来方向在哪?
这篇论文不是“否定RLVR”,而是“给RLVR找对定位”。结合实践,分享几个落地建议:
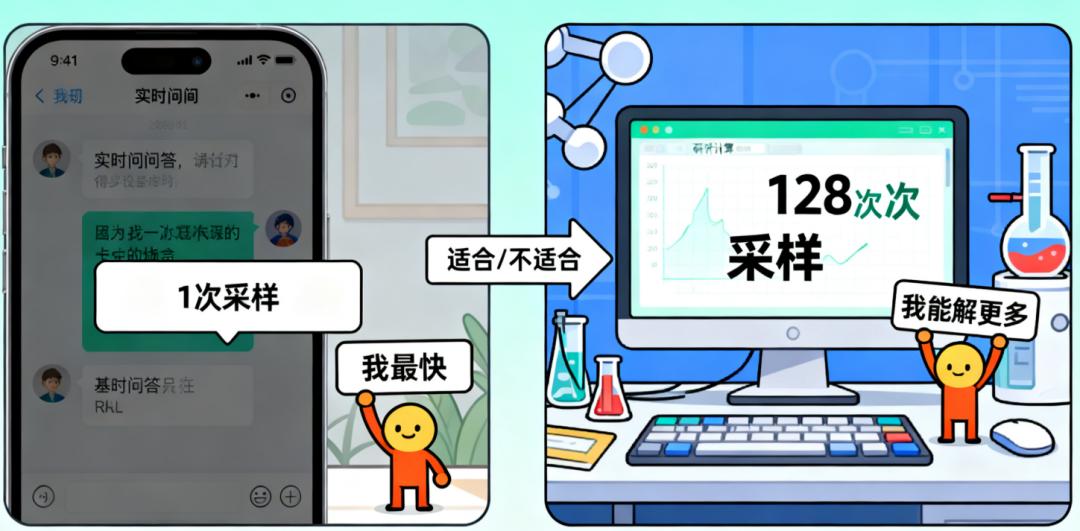
1. 场景选择:RLVR适合“低采样”场景,不适合“深度推理”场景
• 能用RLVR的场景:实时问答(只能采样1次)、代码补全(用户等不及多轮生成);
• 别用RLVR的场景:科研计算(可多采样找最优解)、复杂数学推理(需要探索多种路径)。
2. 评估方法:别只看pass@1,一定要看“大k pass@k”
之前评估模型只看pass@1,结果踩了坑。现在建议要求:所有推理模型必须测pass@1、pass@16、pass@128、pass@256四个指标——
• 如果pass@k曲线随着k增长而上升,且能超过RL模型,说明基础模型潜力大;
• 如果pass@k曲线很快饱和,甚至下降,说明模型可能被RLVR“限制了能力”。
这个评估方法虽然增加了计算成本(需要生成更多样本),但能避免“误判模型能力”,反而节省了后续的调优时间。
3. 未来突破方向:多轮交互+有效探索
论文最后提出了两个可能突破RLVR局限的方向:
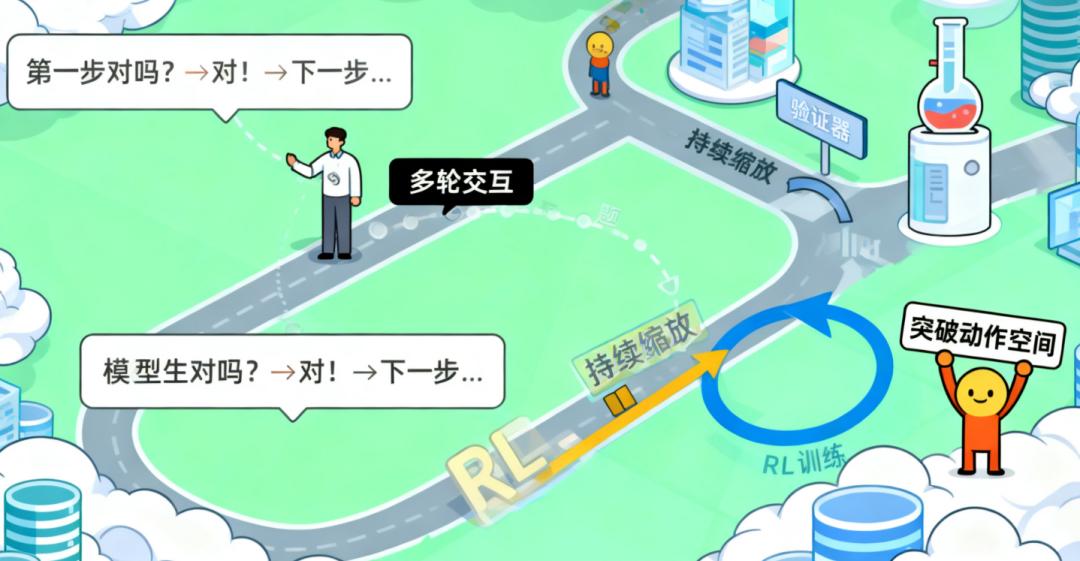
• 多轮交互:当前RLVR是“一次生成定生死”,未来可以让模型“生成中间步骤→根据反馈调整”——比如数学题,模型先给出第一步推导,系统验证后告诉它“对了”或“错了”,再让它生成下一步。这种方式能缩小动作空间,让RL有机会探索新路径;
• 持续缩放:现在的RLVR训练数据量太小(比如用1万道数学题),未来可以结合“自监督数据生成”——让模型生成大量题目的解答,再用验证器筛选出正确的,作为RL训练数据,扩大探索范围。
五、总结:这篇论文给AI研究者的3个核心价值
1. 纠正认知偏差:RL效率提升≠能力扩展,别再为了“pass@1涨几个点”盲目做RLVR,先想清楚你的场景需要“快”还是“能解更多题”;
2. 提供评估工具:“大k pass@k”+“准确率分布”+“困惑度分析”,这三套方法能帮你快速判断模型是“真变强”还是“假效率”;
3. 指明研究方向:RLVR的未来不在“优化现有算法”,而在“突破动作空间限制”——多轮交互、持续缩放可能是更值得投入的方向。
最后,如果你也在做LLM推理调优,不妨试试论文里的实验思路:用你的基础模型和RL模型,测一次pass@256——说不定你会发现,你本来就有一个“潜力更大”的基础模型,只是被RLVR的“短期效率”迷惑了。
你们在复现RLVR方案时,有没有遇到过“模型越训越‘死板’”的情况?比如代码模型RL后,简单题通过率高了,但复杂场景下反而报错更多?欢迎在评论区分享你的解决思路。
参考资料
• 标题:Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?
• 作者:Yang Yue, Zhiqi Chen, Rui Lu, Andrew Zhao, Zhaokai Wang, Yang Yue, Shiji Song, Gao Huang
• 机构:清华大学LeapLab、上海交通大学
• 链接:https://openreview.net/pdf?id=4OsgYD7em5