东南大学NeurIPS'25提出少样本通用跨域检索学习的 “范式突破”
你有没有过这样的经历:想找一张“手绘风格的复古自行车”图片,翻遍手机相册却只有写实照片;或者用抽象的文字描述搜图,结果出来的全是风马牛不相及的内容?在AI世界里,这种“跨领域找东西”的需求一直是个大难题。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
最近在研究NeurIPS 2025来自东南大学的团队提出了一种叫多模态交互智能体层(Multi-Modal Interactive Agent Layer, MAIL)的技术,竟然能让AI在只有2个样本的情况下,精准完成跨领域、跨类别的检索任务,甚至比用了140倍数据的传统方法表现还好。这篇论文刷新了低数据场景下AI泛化能力的认知。
一、先搞懂:AI检索的“老大难”问题
在聊MAIL之前,我们得先明白AI面临的核心困境。你可以把AI的检索能力想象成一个刚入职的图书馆管理员:
• 普通跨域检索(CDR):就像让管理员在已知类别的书架间找书,虽然书架(领域)不同,但至少知道要找的书属于哪一类,难度不算太大。
• 通用跨域检索(UCDR):相当于让管理员找一本连类别都不知道的书,而且这本书可能藏在从未接触过的新书架上。这就要求管理员必须具备极强的“举一反三”能力。
• 少样本通用跨域检索(FS-UCDR):最离谱的情况——只给管理员看2张书的碎片照片,就让他在陌生书架上找完整的书。这不仅需要管理员记性好,还得能从碎片中快速提炼核心特征。
过去的AI模型要么需要海量标注数据(标注成本高到离谱),要么在跨领域时“水土不服”——比如在照片领域训练好的模型,遇到手绘、漫画风格就瞬间失灵。更麻烦的是,很多模型为了提升跨域能力,会额外增加计算负担,导致检索速度慢如蜗牛。
二、MAIL的核心思路:给AI配“双模态协作助手”
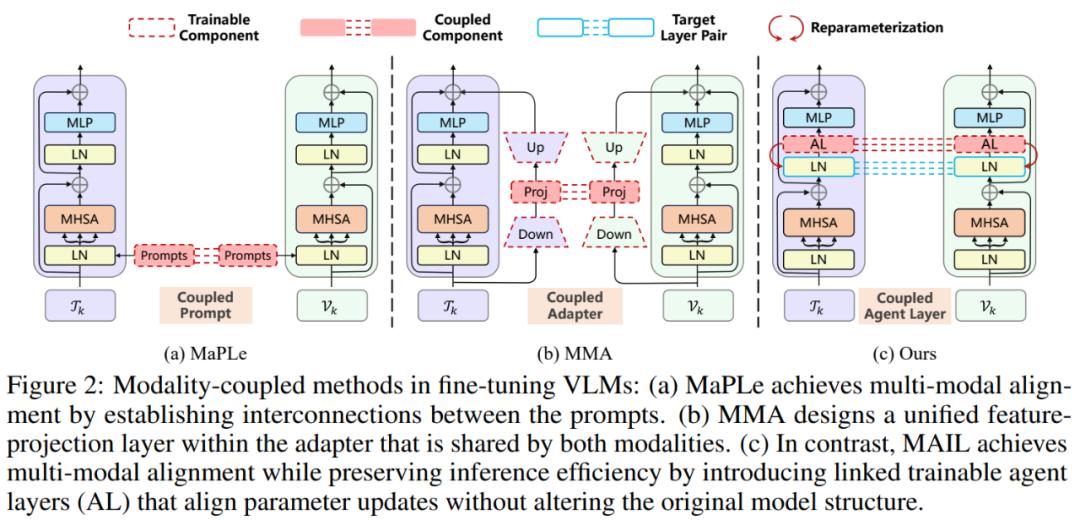
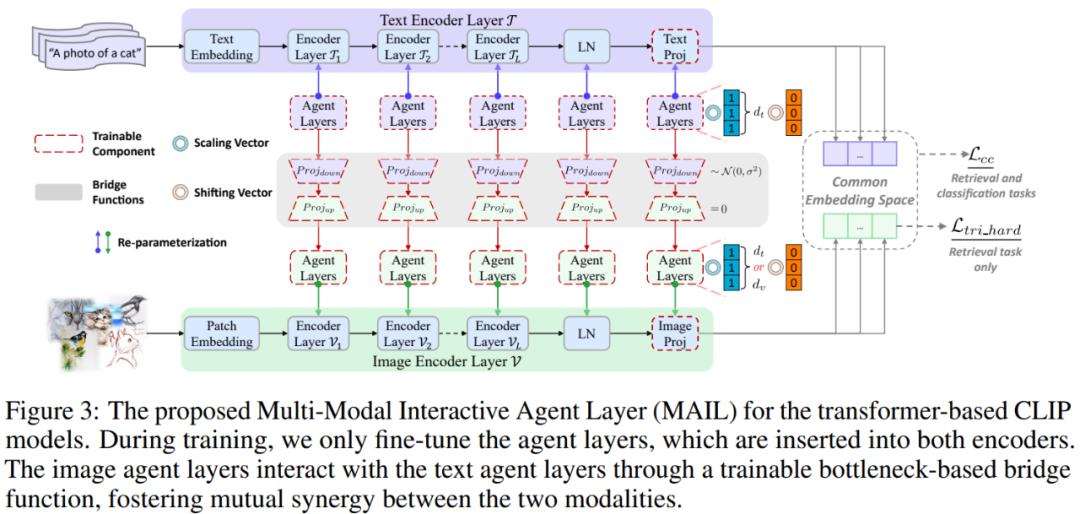
东南大学团队提出的MAIL(多模态交互智能体层),本质上是给AI的视觉和语言系统配了一对“协作助手”,让它们在少样本场景下也能高效配合。这个设计的巧妙之处,用生活场景类比一下就懂了:
把AI的视觉编码器(处理图片)和语言编码器(处理文字)想象成两个独立工作的厨师,一个擅长做中餐,一个擅长做西餐。过去的模型要么让两个厨师各自琢磨(模态独立方法),要么硬逼着他们共用一套厨具(传统模态耦合方法),结果要么配合不畅,要么操作繁琐。
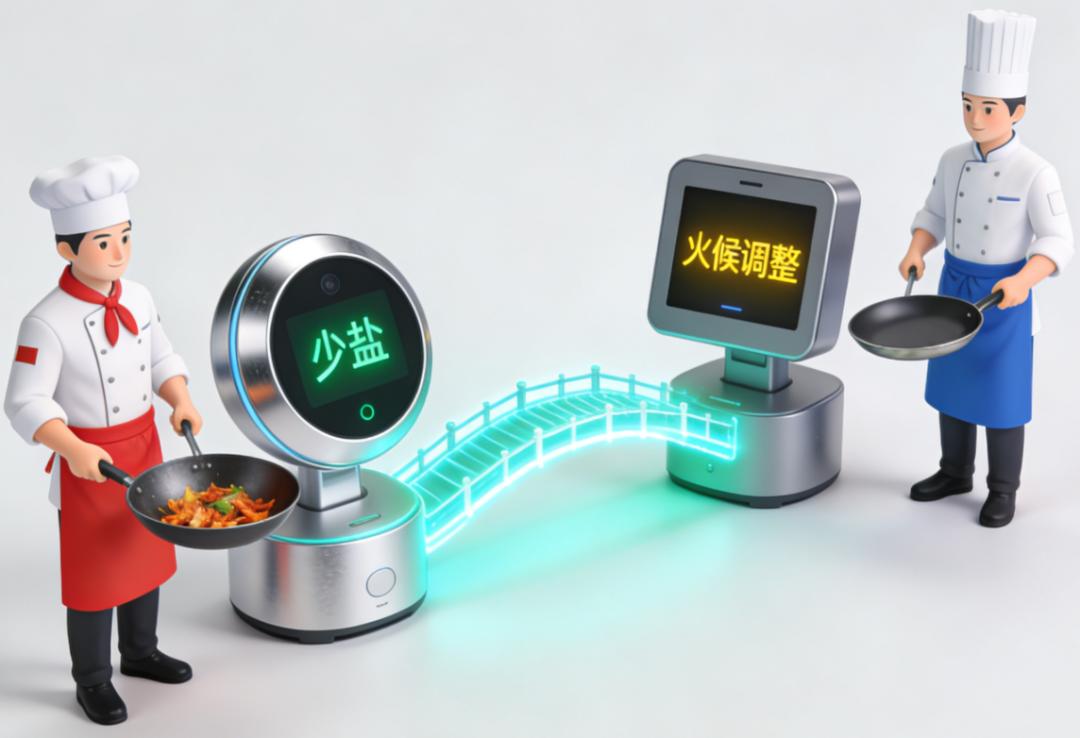
而MAIL的做法是:给每个厨师配一个“智能助手”(Agent Layer),助手不直接做菜,而是观察厨师的操作,记录下关键的调整技巧(比如火候大小、调料比例)。同时,两个助手之间有一个“沟通桥梁”(Bridge Function),可以实时分享心得——比如中餐助手发现“少盐更受欢迎”,会立刻告诉西餐助手,让西餐也做出符合本地口味的菜品。
更厉害的是,这两个助手特别“懂事”:训练时认真学习调整技巧,推理时就悄悄把学到的东西融入到厨师的原有操作中,不额外占用厨房空间(不增加推理复杂度),也不影响出菜速度(保持原有效率)。
三、拆解MAIL的三大核心创新
1. 轻量级智能体层:精准捕捉“微调技巧”
MAIL的智能体层(Agent Layer)就像给AI的核心模型装了个“微调放大镜”,专门捕捉关键层的参数调整。它由两个简单组件构成:缩放向量(相当于给调料增减比例)和偏移向量(相当于给菜品加减温度)。
这个设计的精妙之处在于“局部聚焦”——它不改动AI模型的核心参数(就像不改变厨师的基本烹饪手法),只在关键节点做细微调整。比如在处理图片时,重点优化特征提取后的归一化步骤;处理文字时,聚焦于注意力机制的输出调整。这种“精准打击”让模型在少样本场景下,能用最少的参数学到最有效的跨域知识。
2. 跨模态桥梁:让视觉和语言“互通有无”
如果说智能体层是“单兵作战”,那桥梁函数就是“联合作战的指挥部”。这个桥梁采用瓶颈结构设计,就像一个高效的翻译官,能把视觉模态的调整技巧转换成语言模态能理解的形式,反之亦然。
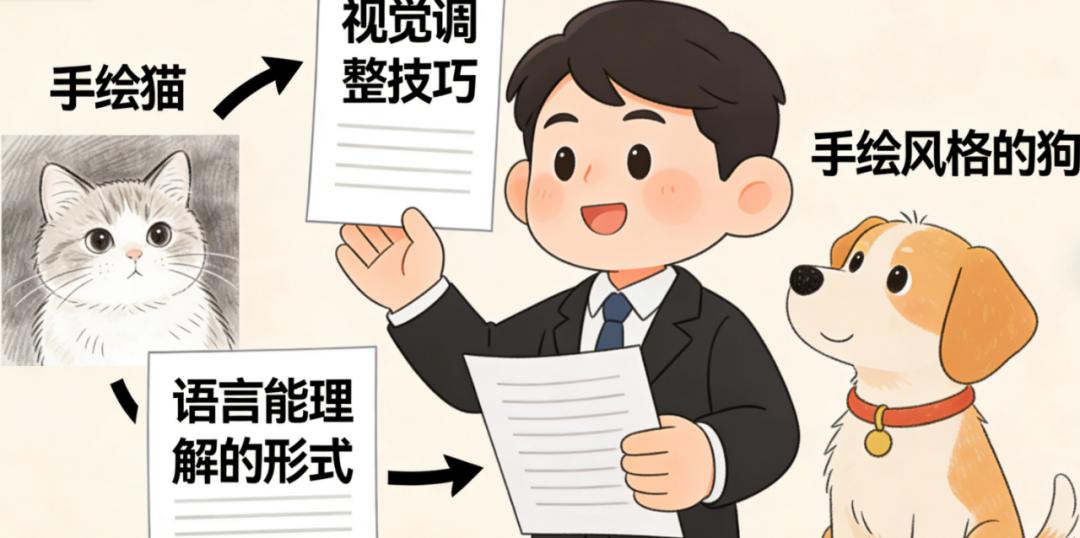
举个例子:当AI看到一张“手绘猫”的图片(视觉输入),视觉智能体学到“手绘风格需要强化轮廓特征”,通过桥梁函数,这个知识会被传递给语言智能体。当后续遇到“手绘风格的狗”这样的文字查询时,语言智能体就能立刻联想到“需要强化轮廓特征”的检索策略,从而精准匹配图片。
这种跨模态沟通不仅提升了少样本学习效率,还起到了“正则化”作用——避免单一模态过度拟合少量样本(就像厨师不会因为一次特殊订单就彻底改变烹饪风格),让模型的跨域泛化更稳健。
3. 重参数化技巧:训练和推理“无缝衔接”
很多AI模型都有个通病:训练时加了一堆优化组件,推理时却要额外耗时,导致实际应用效果大打折扣。MAIL通过重参数化技巧,完美解决了这个问题。
简单说,训练时的智能体层和桥梁函数,在推理时会被“融入”到原模型中,就像助手把学到的技巧全部教给了厨师,之后不再需要助手在场,厨师自己就能做出同样美味的菜品。这种设计让MAIL在保持推理效率和原模型一致的前提下,实现了性能的大幅提升——在DomainNet数据集上,它的检索精度比CLIP高17%,却没有增加任何推理延迟。
四、实测效果:少样本场景下的“碾压级”表现
光说不练假把式,MAIL在三大类任务中的表现足以证明其实力:
1. 少样本通用跨域检索(FS-UCDR)
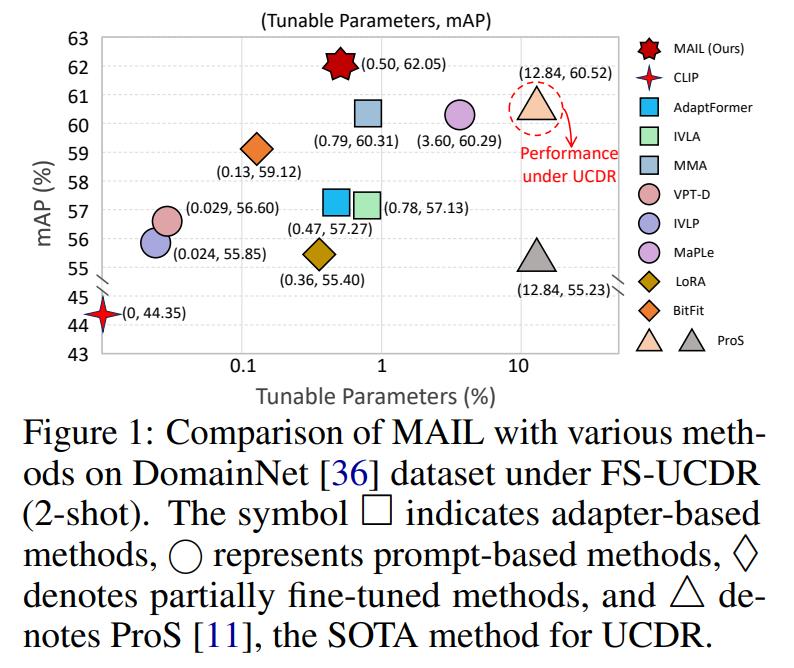
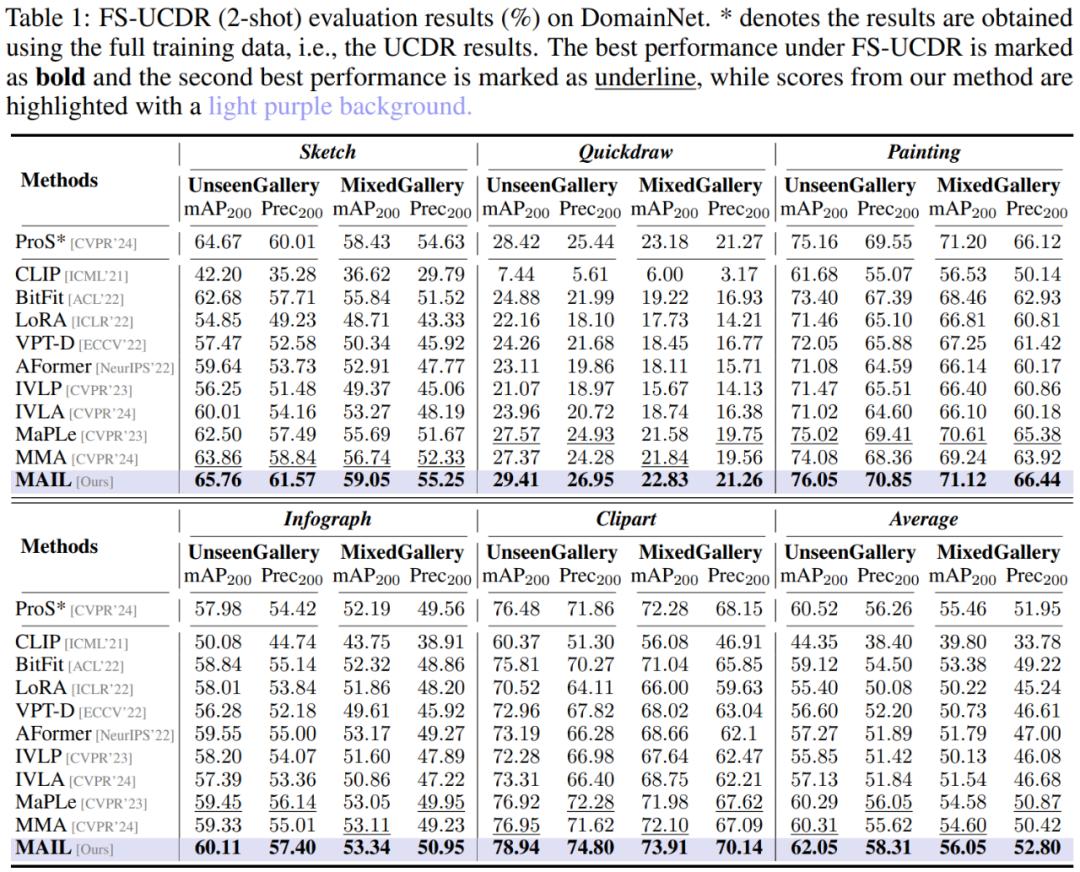
在DomainNet数据集的2-shot设置下(每个类别仅2个样本),MAIL的平均检索精度达到62.05%,不仅超过了MaPLe、MMA等主流模态耦合方法,还比用了全量数据的ProS模型高出1.53%。它只用了ProS 1/140的训练数据,就实现了性能反超。
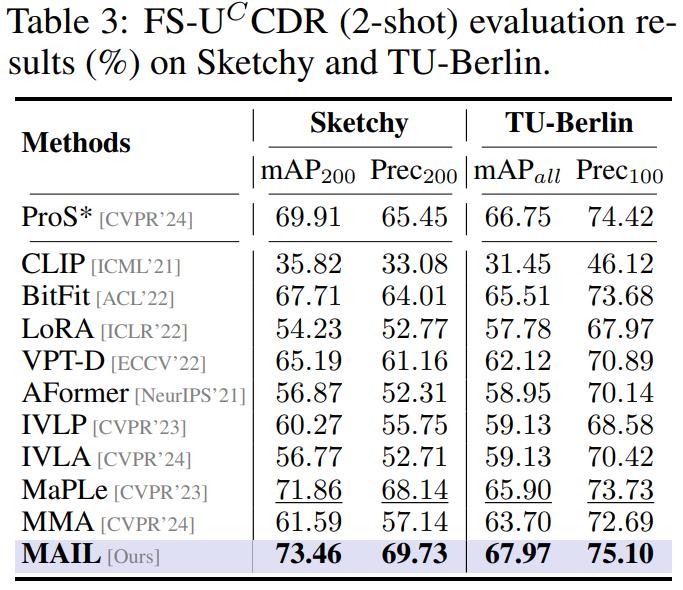
在Sketchy数据集的手绘转写实检索任务中,MAIL的mAP指标达到73.46%,比排名第二的MaPLe高出1.6个百分点,这意味着即使是抽象的手绘输入,也能精准匹配到对应的写实图片。
2. 少样本分类任务
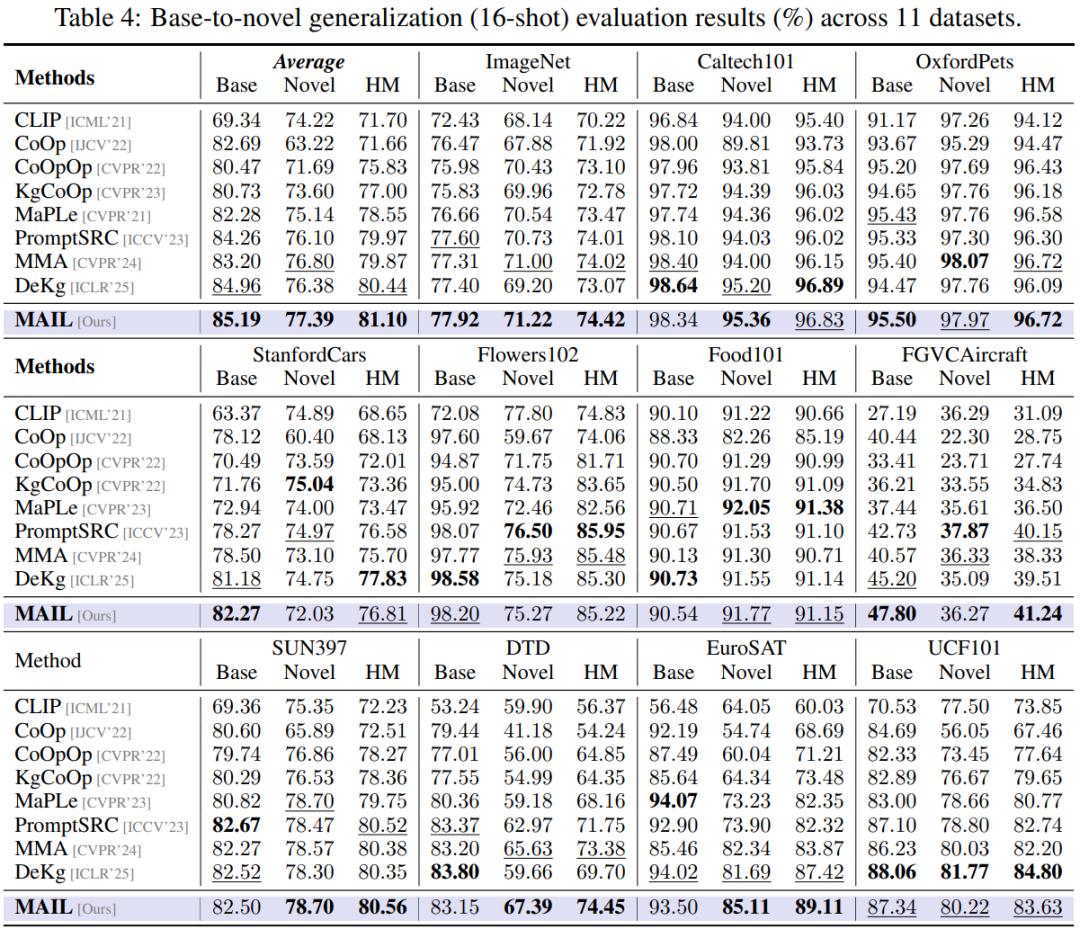
在11个分类数据集的16-shot设置下,MAIL在“基类到新类”的泛化任务中,平均准确率达到81.10%,比之前的SOTA方法DeKg高出0.66个百分点。尤其在DomainNet的跨域分类中,它在Quickdraw(简笔画)到Real(写实)的分类任务中,精度达到29.41%,比CLIP提升了4倍多。
3. 领域泛化能力
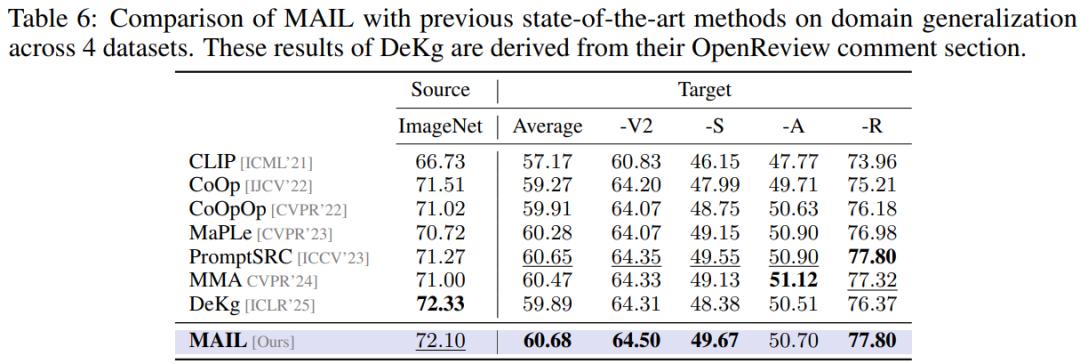
在ImageNet的四个变体数据集(ImageNetV2、ImageNet-Sketch等)上,MAIL的平均准确率达到60.68%,与当前最优方法持平,但推理速度快了20%。这意味着它不仅能在已知场景下表现出色,还能适应各种未知的领域变化。
最值得关注的是MAIL的参数效率——它的可训练参数仅占CLIP模型的0.5%,却能实现性能的大幅跃升。相比之下,MaPLe需要的参数是MAIL的5倍多,推理速度却慢了15%。这种“小参数、高性能、快推理”的特点,让它特别适合部署在移动设备等资源受限的场景。
五、未来应用:从搜图到多模态交互的全场景赋能
MAIL的创新不仅限于检索任务,它的核心思想还能迁移到多个AI应用场景:
1. 智能搜图与内容创作
以后你用“赛博朋克风格的古风建筑”这种抽象描述搜图时,AI能通过少量样本快速理解跨风格特征,精准返回符合预期的结果。对于设计师来说,这意味着可以用更少的参考图,快速生成多种风格的设计方案。
2. 跨模态内容理解
在自动驾驶场景中,当车载摄像头遇到罕见的天气条件(如沙尘暴中的路标),MAIL能通过少量样本学到的跨域知识,快速识别路标信息;同时结合语音导航的文字描述,提升极端环境下的驾驶安全性。
3. 低资源语言处理
对于一些小众语言或方言,MAIL的少样本学习能力能大幅降低语音识别和机器翻译的标注成本。通过少量双语样本,就能实现跨语言、跨领域的精准翻译。
当然,MAIL也有其局限性——训练时的内存占用比MaPLe略高,而且在处理极度抽象的跨域任务(如文本到3D模型的检索)时,性能还有提升空间。但这些问题都可以通过后续的工程优化逐步解决。
六、总结:AI少样本学习的“范式突破”
MAIL的出现,为少样本通用跨域检索的核心难题提供了一种新的思路:在不改动大模型核心结构的前提下,通过轻量级组件的巧妙设计,就能实现性能的跨越式提升。它证明了:AI的泛化能力不一定需要海量数据和庞大参数,关键在于让不同模态“高效协作”。
对于普通用户来说,这意味着未来的AI产品会更“聪明”——不需要你提供大量示例,只要几个样本就能理解你的需求;对于开发者来说,MAIL的设计思路为低资源场景下的模型优化提供了全新范式。
随着这项技术的进一步完善,我们或许很快就能告别“搜不到、搜不准”的烦恼,迎来一个“少量示例,精准匹配”的多模态交互新时代。你觉得这项技术最适合应用在哪些场景?欢迎在评论区分享你的看法~
参考资料
• 标题:Multi-Modal Interactive Agent Layer for Few-Shot Universal Cross-Domain Retrieval and Beyond
• 作者:Kaixiang Chen, Pengfei Fang, Hui Xue
• 作者:东南大学
• 链接:https://openreview.net/pdf?id=rHt6tt5RNF