CVPR'25苹果突破 0.5B VLM 瓶颈:FastVLM让高分辨率读图快85倍
最近读到苹果团队发表在CVPR 2025的新论文FastVLM,才发现原来0.5B的视觉语言模型“读图”可以这么快这么好!这篇论文提出的FastVLM模型,不仅解决了高分辨率图像理解的效率难题,还在精度上不落下风。我们聊聊这个轻量级视觉语言模型的奥秘。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
一、先搞懂:AI“读图”为什么这么慢?
在聊FastVLM之前,我们得先明白一个核心问题:AI看图片,到底慢在哪儿?
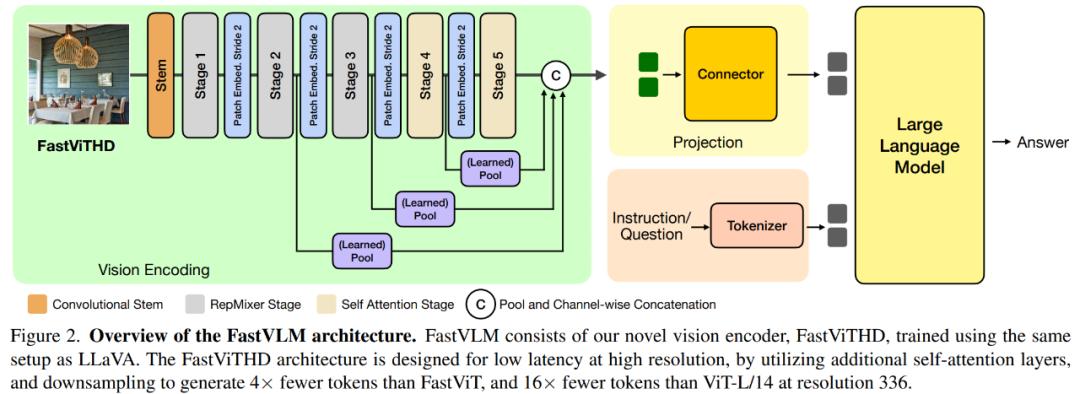
你可以把视觉语言模型想象成一个“图文翻译官”——它需要先通过一个“视觉编码器”把图片翻译成AI能看懂的“视觉文字”(也就是视觉令牌),再把这些“文字”传给大语言模型(LLM),最后由大语言模型生成我们能看懂的答案。这个过程就像我们看外文资料:先找翻译把外文翻译成中文,再阅读理解。
而“读图慢”的问题,恰恰出在“翻译”和“阅读”两个环节:
1. 翻译环节耗时久:如果图片分辨率高(比如清晰的合同、复杂的图表),传统的视觉编码器(比如ViT系列)需要处理海量像素,就像翻译一本厚书,逐字逐句翻译自然慢;
2. 阅读环节负担重:高分辨率图片会生成大量“视觉令牌”,大语言模型要读完这些“令牌”才能工作,相当于让翻译把一本书拆成几千个词语,再让你快速读完理解,工作量直接翻倍。
更麻烦的是,这两个问题是恶性循环:想让AI看懂细节,就得提高图片分辨率,结果令牌变多,速度更慢;想加快速度,降低分辨率,又会丢失关键信息,AI就会“看错”。这就是长期困扰我们研究员的“分辨率-速度-精度”三角难题。
二、关键创新:FastViTHD——一个“聪明的翻译官”
苹果团队的核心突破,就是设计了一个全新的视觉编码器FastViTHD。如果说传统编码器是“逐字翻译的老学究”,那FastViTHD就是“抓重点的高效翻译”,它的聪明之处体现在三个方面:
1. 混合架构:既有“大局观”又能“抓细节”
FastViTHD采用了“卷积+Transformer”的混合架构,这就像一个经验丰富的翻译:先用卷积层快速浏览全文(相当于看图片的整体结构),快速过滤掉无用信息;再用Transformer层聚焦关键部分(相当于仔细研读重点段落),提取核心细节。
对比之下,传统的ViT编码器就像“一根筋”的翻译,不管重要不重要,都用同样的方式逐字处理,自然效率低下。而FastViTHD的混合架构,让它既能像卷积模型一样快速处理大图像,又能像Transformer一样精准捕捉关键信息,完美平衡了速度和精度。
2. 少而精的“令牌”:让大语言模型“少读快跑”
这是FastVLM最亮眼的设计!传统编码器处理高分辨率图片时,会生成成千上万的视觉令牌,就像翻译把一本书拆成了一万个词语,大语言模型读半天才能理清楚逻辑。
而FastViTHD通过巧妙的下采样设计,能在保证信息不丢失的前提下,大幅减少令牌数量。比如在336×336分辨率下,它生成的令牌数是ViT-L/14的1/16,是之前的FastViT的1/4。这就像翻译把一本书浓缩成了几百个核心短语,大语言模型一眼就能看完,速度自然飙升。
更厉害的是,这种令牌减少不是通过“裁剪图片”或“丢弃信息”实现的,而是通过架构优化让模型自动聚焦关键信息——就像优秀的翻译能精准提炼核心观点,而不是简单删减内容。
3. 原生支持高分辨率:不用“拼图”也能看大图
之前的模型处理高分辨率图片时,常用“拼图”策略:把大图切成小块,分别处理后再拼接起来。这就像翻译一本厚书,却要先切成几十页,逐页翻译后再整合,不仅麻烦,还容易丢失上下文信息。
而FastViTHD原生支持高分辨率输入,不用切块就能直接处理1024×1024甚至2048×2048的大图。这就像翻译能直接通读厚书,不需要拆分,既节省了拼接时间,又能完整理解上下文,精度自然更高。
三、实测效果:快85倍,精度还不打折?
最关心的还是实际效果——FastVLM到底有多快?精度有没有牺牲?
苹果团队在M1 MacBook Pro上做了详细测试,结果让人惊喜:
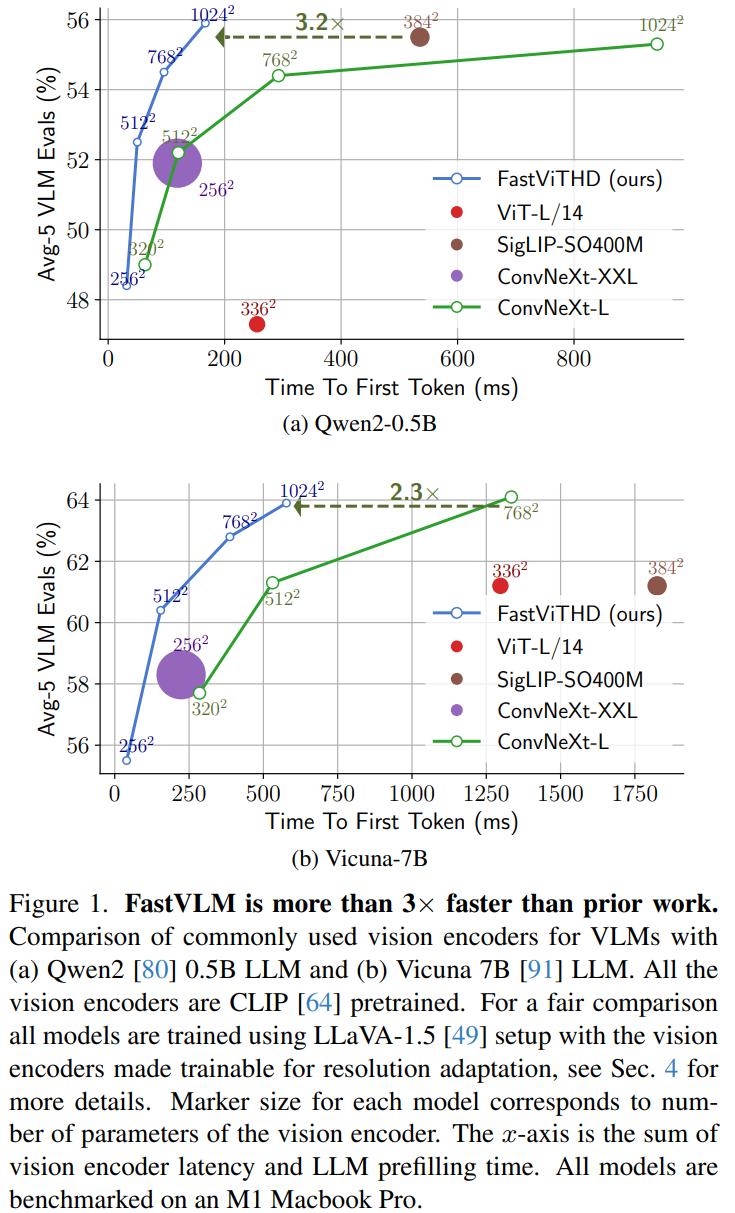
• 对比LLaVA-OneVision(同样用0.5B大语言模型),在最高分辨率下,FastVLM的首次令牌生成时间(TTFT,也就是从输入图片到得到第一个回复的时间)快了85倍,视觉编码器的体积还小了3.4倍;
• 对比基于ViT-L/14的传统模型,FastVLM的TTFT快了3.2倍,而在GQA、TextVQA等核心 benchmarks上的精度基本持平;
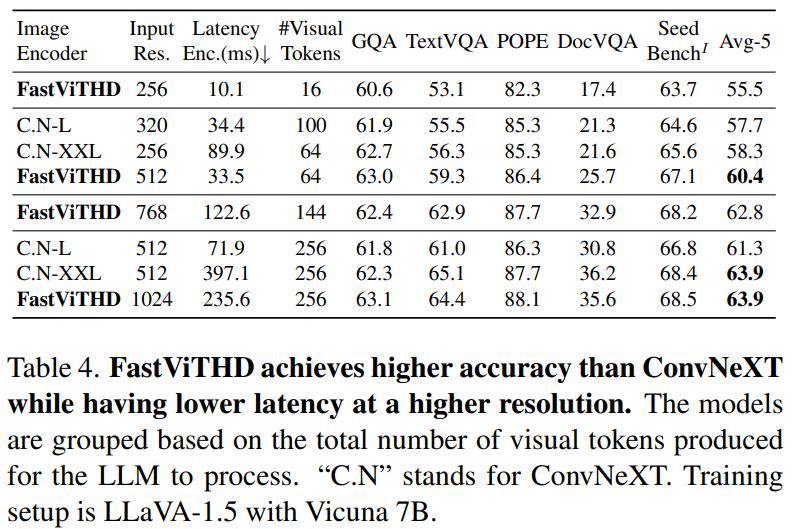
• 即使在1024×1024的高分辨率下,FastVLM处理一张满是文字的文档图片,TTFT也只有几百毫秒,相当于你刚按下发送键,AI就给出了回复。
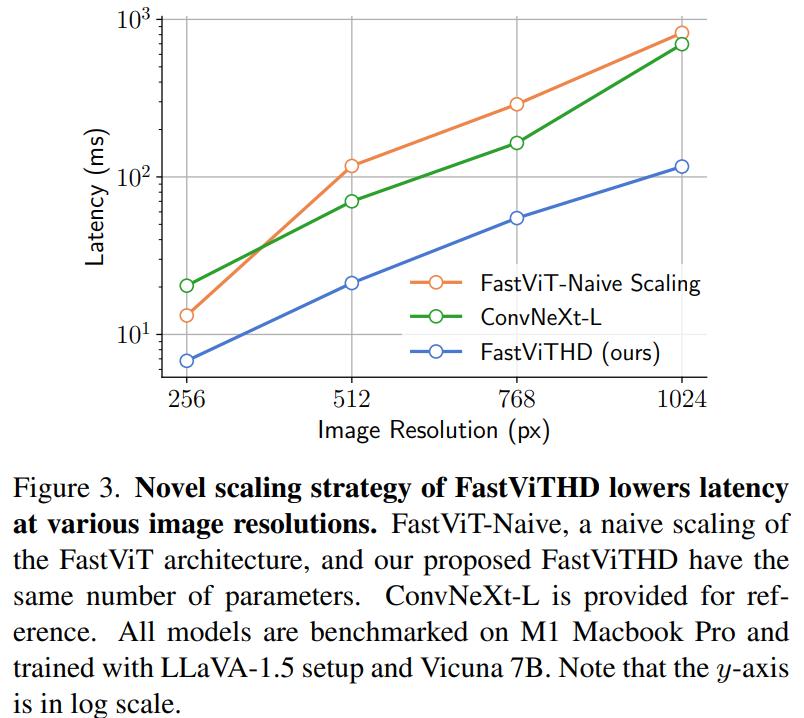
这里最让我惊讶的是,FastVLM在“快”和“准”之间找到了完美平衡。之前我们也尝试过减少视觉令牌,但往往会导致精度下降——比如AI看不清文档里的小字体,或者误解图表中的数据关系。而FastVLM通过优化编码器架构,实现了“令牌少但信息全”,这才是真正的技术突破。
举个实际应用场景:用AI处理一份10页的PDF合同,传统模型可能需要几十秒才能识别完所有条款,还可能遗漏关键信息;而FastVLM几秒钟就能完成处理,并且精准提取出合同中的金额、期限、责任条款等核心内容。这对于需要大量处理图文资料的职场人来说,简直是“效率神器”。
四、为什么说FastVLM的思路值得关注?
除了亮眼的性能,FastVLM的设计思路更让我觉得有启发——它没有走“堆参数、堆数据”的老路,而是从架构优化入手,解决了实际应用中的核心痛点。这对整个视觉语言模型领域来说,都有重要的借鉴意义:
1. 告别“为了精度牺牲速度”的妥协
之前的很多模型,要么追求精度而忽视速度(比如需要强大算力才能运行的大模型),要么追求速度而牺牲精度(比如轻量化模型处理不了复杂图片)。而FastVLM证明,通过合理的架构设计,我们可以同时拥有“高速度”和“高精度”,这为VLM的落地扫清了重要障碍。
2. 更适合移动端和边缘设备
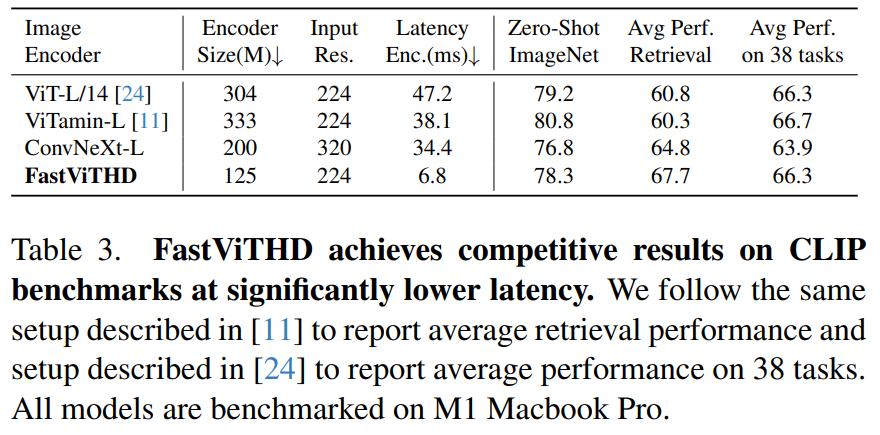
FastVLM的视觉编码器只有125M参数,体积小、效率高,非常适合部署在手机、平板等移动端设备上。想象一下,未来你用手机拍一张合同照片,不需要上传到云端,手机本地就能快速识别关键信息;或者在没有网络的环境下,平板也能处理复杂的图表数据——这都是FastVLM这类高效模型能带来的改变。
3. 为高分辨率场景打开大门
对于文本密集型图像(如文档、图表、代码截图)、医疗影像、卫星图像等需要高分辨率的场景,FastVLM的优势更加明显。之前很多VLM在处理这些场景时,要么速度慢得无法接受,要么精度不足导致误判,而FastVLM的出现,让这些场景的实用化成为可能。
五、未来可期,但仍有挑战
当然,作为一项前沿技术,FastVLM也不是完美的。从研究员的角度来看,它还有一些可以进一步优化的方向:
• 处理极端高分辨率图像(如4K、8K图片)时,虽然比传统模型快很多,但仍然需要一定的算力支持,未来还可以进一步优化推理效率;
• 在一些需要精细定位的场景(如识别图片中某个具体位置的文字),FastVLM的表现还有提升空间;
• 目前FastVLM主要针对英文场景优化,在中文等其他语言的图文理解上,还需要更多的适配和训练。
但瑕不掩瑜,FastVLM的核心创新已经为视觉语言模型的发展指明了方向——高效编码才是未来。随着技术的不断迭代,我相信这些问题都会逐步得到解决,而FastVLM带来的“快而准”的体验,也会很快普及到我们的日常生活中。
总结:AI“读图”进入高效时代
FastVLM的出现,就像给视觉语言模型装上了“涡轮增压发动机”,它通过创新的FastViTHD编码器,打破了“分辨率-速度-精度”的三角困境,让AI在处理高分辨率图像时,既能看得快,又能看得准。
对于普通用户来说,这意味着未来用AI处理图文资料会更高效、更流畅;对于行业来说,这为VLM在移动端、边缘设备、高分辨率场景的落地提供了可能;而对于我们研究员来说,这也提醒我们:技术创新不一定需要“大而全”,有时候“小而巧”的架构优化,反而能解决更大的问题。
如果你也经常被AI“读图慢”“看错图”的问题困扰,不妨关注一下FastVLM的进展(代码和模型已开源)。相信在不久的将来,我们都能用上“秒级响应”的图文AI助手。
最后,你平时用AI处理图文资料时,遇到过哪些痛点?你觉得FastVLM这样的高效模型,能解决你的问题吗?欢迎在评论区留言讨论!
参考资料
1. 标题:FastVLM: Efficient Vision Encoding for Vision Language Models
2. 作者:Pavan Kumar Anasosalu Vasu, Fartash Faghri, Chun-Liang Li, Cem Koc, Nate True, Albert Antony, Gokul Santhanam, James Gabriel, Peter Grasch, Oncel Tuzel, Hadi Pouransari
3. 单位:Apple
4. 链接:https://openaccess.thecvf.com/content/CVPR2025/papers/Vasu_FastVLM_Efficient_Vision_Encoding_for_Vision_Language_Models_CVPR_2025_paper.pdf