阿里NeurIPS'25语言中枢全模态表示学习:多模态表征降维打击
在做低资源多语言图像检索时常常卡在一个难题——缺少大规模跨模态标注数据,模型性能始终上不去。直到看到这篇NeurIPS 2025的新研究,才恍然大悟:原来MLLM早就通过生成预训练悄悄完成了跨模态对齐,我们只需要用文本数据做一次轻量微调,就能解锁全模态的表征能力。这篇研究不仅提出了可直接落地的LCO-EMB框架,还揭示了生成能力与表征性能的核心关联,给多模态研究提供了全新思路。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
一、AI多模态研究的核心痛点:数据和效率的双重枷锁
多模态任务(如图文检索、音视频语义匹配)的核心需求是让模型“看懂、听懂、还能关联语言”,但现实中两个痛点让科研和落地都举步维艰:
• 数据依赖严重:传统方案(如CLIP)需要海量标注好的跨模态数据(比如上亿对图文),中小团队根本负担不起采集和标注成本;
• 复杂任务性能瓶颈:在多语言检索、长文档理解、跨模态组合推理等复杂场景,传统模型的性能会快速饱和,就算堆更多数据也难突破;
• 计算成本高昂:为了对齐不同模态,模型需要进行大规模对比学习训练,动辄消耗数百GPU小时,普通实验室根本扛不住。
更关键的是,很多实际场景都是“低资源”的——比如东南亚小语种的文档检索、特定领域的音视频标注数据稀缺,这些场景下传统多模态模型几乎无法落地。
二、传统方案的死穴:只顾“显性对齐”,忽略了MLLM的“隐性天赋”
在这篇研究之前,多模态对齐主要有两条路,但都有明显局限:
• CLIP路线:像“从零搭建一套跨模态联动系统”,用大规模对比学习把图像、文本等模态强行拉到同一个表征空间。但这种方式需要从头训练对齐机制,数据和计算成本极高,而且学到的对齐比较“表面”,面对复杂语义理解任务就力不从心;
• 早期MLLM路线:虽然发现用MLLM做基础再微调效果更好,但没人说清背后的原因——是MLLM参数更多?还是有其他隐藏机制?大家只是盲目跟风微调,却不知道如何最大化利用MLLM的优势。
这篇研究正好解答了这个疑惑:MLLM在生成预训练阶段,就已经悄悄完成了跨模态的“隐性对齐”。
三、LCO-EMB的核心逻辑:给MLLM的“隐性对齐”做一次精准激活
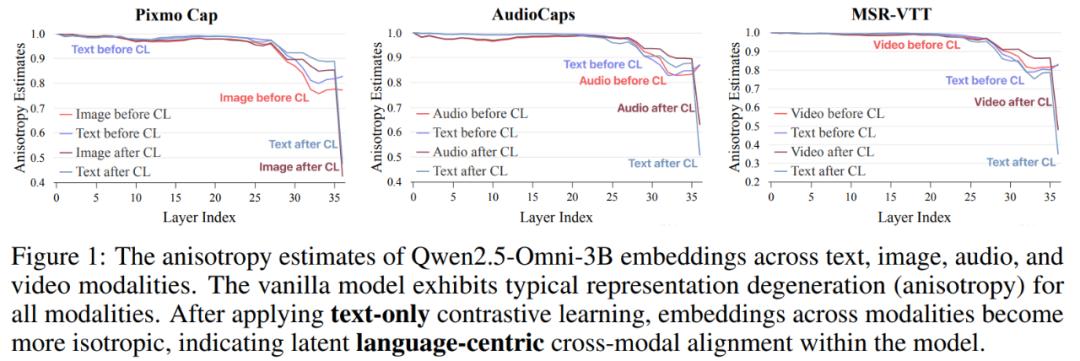
这篇研究的核心洞察特别简单却致命:MLLM在生成预训练时,语言解码器为了生成准确的文本,会自动把图像、音频、视频等多模态信息整合到同一个语义空间。就像一个全能实验室助手,虽然主要工作是“写实验报告”(生成文本),但在这个过程中,已经悄悄摸清了“显微镜数据”(图像)、“传感器数据”(音频)和“报告文字”(文本)之间的对应关系。
LCO-EMB框架并没有做复杂的架构改造,而是做了两件“四两拨千斤”的事:
1. 核心操作:文本单模态微调激活全模态能力
LCO-EMB只对MLLM的语言解码器做文本单模态对比学习微调,完全冻结模态编码器和投影层。这个过程就像给实验室助手做“专项记忆训练”——只训练它对文字的精准识别能力,却意外激活了它对所有实验数据的关联能力。
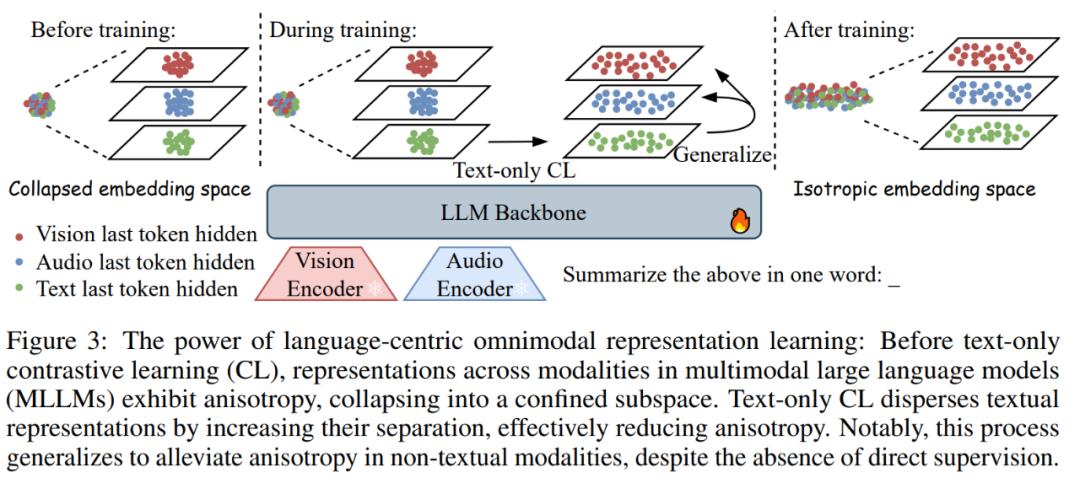
更神奇的是,这种文本微调的效果会自动迁移到图像、音频、视频等模态:原本混乱的多模态表征空间会变得规整,不同模态下表达同一语义的特征会自动聚在一起。比如训练时只让模型区分“猫”和“狗”的文本差异,微调后模型也能准确区分猫和狗的图像、甚至猫叫和狗叫的音频。
2. 关键技巧:用LoRA保护MLLM的“隐性对齐”
为了避免微调破坏MLLM原本的跨模态对齐,研究采用了LoRA(低秩适配)进行参数高效微调。这就像给精密仪器做校准,只调整关键部件的微小参数,不改动仪器的核心结构——既保留了MLLM的生成能力,又最大化激发了其表征潜力。
实验证明,这种方式比全量微调效果更好:全量微调会破坏原本的隐性对齐,而LoRA微调后的模型,在表征任务上更优,生成能力也没下降。
四、三大创新突破:不止是框架,更是多模态研究的新范式
1. 语言中心的全模态框架:用文本数据撬动所有模态
LCO-EMB最颠覆的地方在于“以一敌多”——只用文本数据(或少量多模态数据)就能训练全模态嵌入模型。对比传统方案:
• CLIP需要上亿级跨模态数据,训练耗时数百GPU小时;
• LCO-EMB只用276k文本数据(约0.37M多模态数据),训练耗时仅4-9 GPU小时,却在51个MIEB任务上超越了所有强基线。
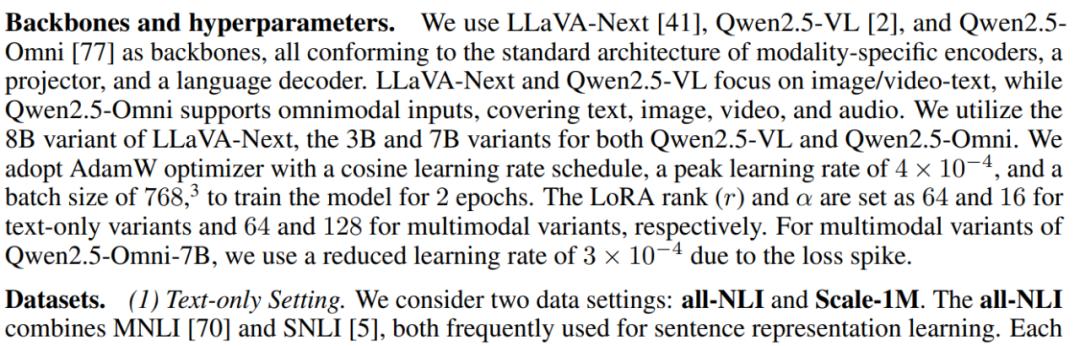
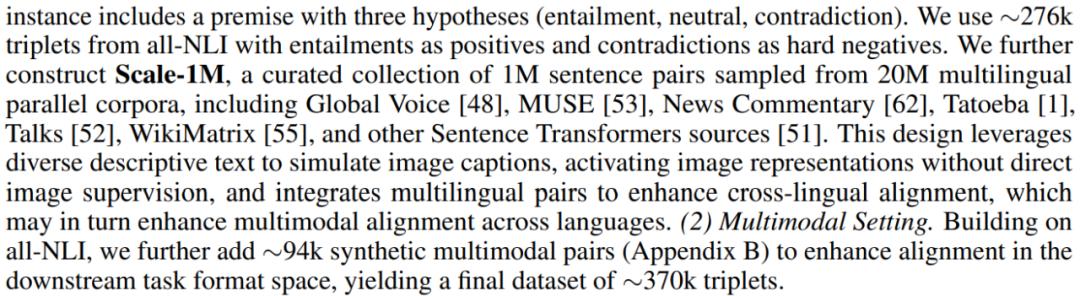
在多语言图像检索、文档理解等传统MLLM短板任务上,LCO-EMB也实现了反超——甚至文本单模态版本就超越了专门优化过PDF-文本对的商业模型Voyage Multimodal-3。
2. 生成-表征缩放定律(GRSL):揭开生成与表征的底层关联
这篇研究最亮眼的发现,是提出了“生成-表征缩放定律”:MLLM的生成能力越强,经过对比微调后的表征性能上限就越高。就像基础越好的学生,经过针对性辅导后进步越明显——模型在预训练阶段的生成能力,直接决定了它后续表征任务的性能天花板。
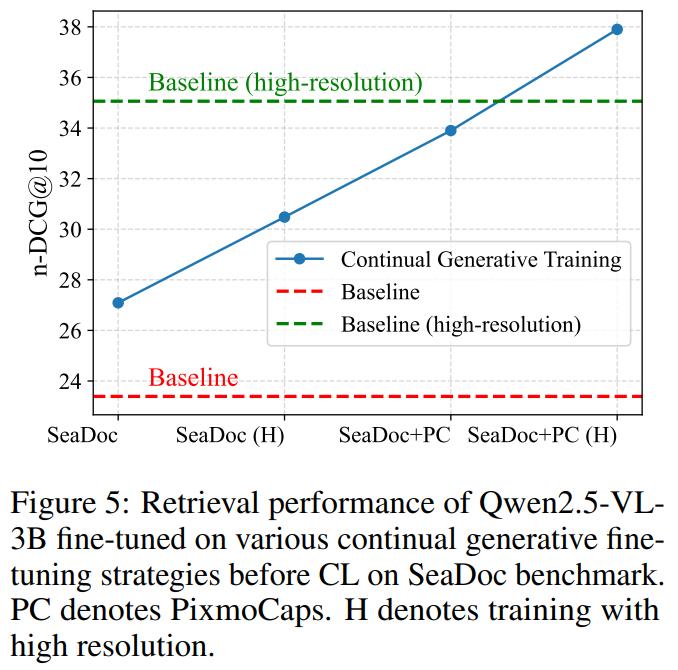
为了验证这个定律,研究团队还专门构建了一个高难度低资源基准SeaDoc(东南亚小语种视觉文档检索)。实验显示:通过持续的生成预训练提升MLLM的生成能力后,再用同样的文本微调流程,检索性能显著提升——这证明了提升生成能力是突破表征性能上限的关键路径。
3. 理论支撑:用PAC-Bayesian框架证明GRSL的合理性
研究没有停留在实验现象,还通过PAC-Bayesian泛化界给出了理论证明:MLLM的生成损失越低,其表征任务的性能上限就越高。简单来说,生成能力强的MLLM,已经在预训练阶段捕捉到了更多跨模态的互信息,这为后续的表征学习提供了更好的“初始基础”,让对比微调能达到更高的性能。
五、实验验证:在低资源、多任务场景下全面碾压
研究做了极其全面的实验,覆盖图像、音频、视频、文本等全模态,核心结果让人印象深刻:
1. 核心基准MIEB-Lite(51个任务):刷新SOTA
LCO-EMB的7B多模态版本在MIEB-Lite上取得了68.8的平均分,超越了所有强基线:
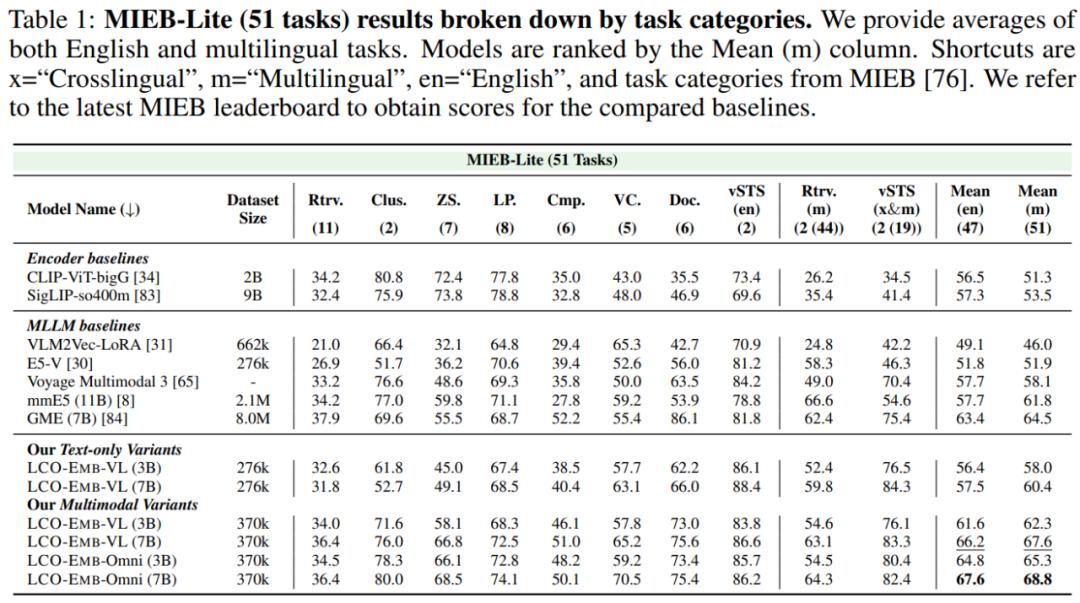
• 比用8M数据训练的GME(64.5分)高4.3分;
• 比商业模型Voyage Multimodal-3(58.1分)高10.7分;
• 即使是3B的文本单模态版本(58.0分),也能媲美商业模型。
更关键的是,LCO-EMB在传统MLLM的短板任务(如线性探测、聚类)上也表现出色,打破了“MLLM表征只擅长推理类任务”的固有认知。
2. 低资源场景SeaDoc:验证GRSL的实践价值
在东南亚小语种视觉文档检索任务中,通过持续生成预训练提升MLLM的OCR和生成能力后,检索性能(nDCG@10)从24分提升到34分以上——这证明在低资源场景下,提升生成能力是突破表征性能的有效路径。
3. 效率对比:算力成本降低50倍以上
对比CLIP-style的多模态对比学习:
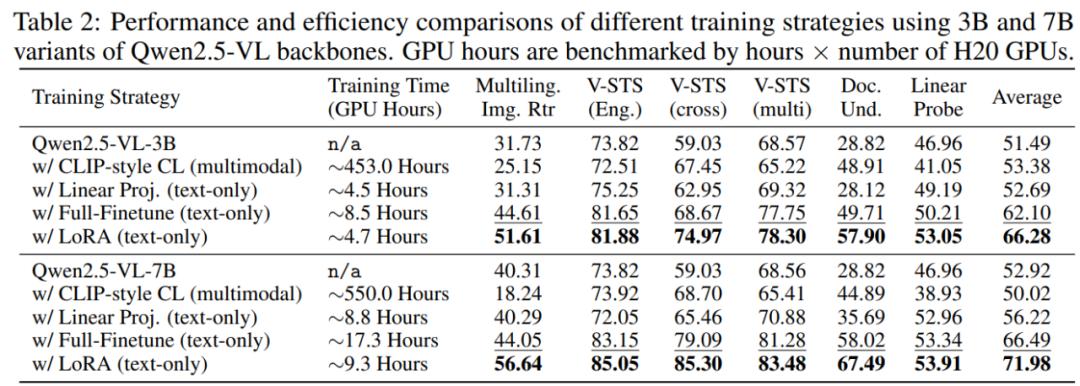
• CLIP-style训练需要453-550 GPU小时;
• LCO-EMB的LoRA微调仅需4.7-9.3 GPU小时;
• 数据量仅为传统方案的1/21,却实现了更好的性能。
六、落地前景与挑战:给科研和产业带来的实际价值
1. 科研视角:多模态研究的新范式
• 打破了“跨模态任务必须用跨模态数据训练”的固有认知,为低资源多模态研究提供了可复现的方案;
• GRSL定律为多模态模型的优化提供了明确方向:与其盲目堆跨模态数据,不如先提升模型的生成能力;
• 证明了参数高效微调(LoRA)在保护模型固有能力方面的关键作用,为大模型多任务适配提供了参考。
2. 产业视角:降低多模态落地门槛
• 数据成本大幅降低:不需要大规模跨模态标注,只用文本数据或少量合成数据就能训练;
• 计算成本可控:中小团队用少量GPU就能完成训练,不用依赖超算集群;
• 适用场景广泛:文档检索、跨语言图文匹配、音视频语义检索等场景都能直接落地。
3. 现存挑战
• 联合训练生成损失和对比损失的计算成本过高,目前还没找到高效的平衡方案;
• 在超大规模模型(如70B以上)上的表现还需验证,现有实验主要集中在3B-8B模型;
• 对模态差异极大的场景(如触觉数据与文本的对齐),效果还不明确。
七、总结:多模态研究的“降维打击”思路
这篇研究最让人震撼的不是复杂的架构设计,而是对MLLM固有能力的深刻洞察——与其花费巨大成本搭建跨模态对齐系统,不如利用MLLM已经具备的“隐性对齐”能力,通过简单的微调实现全模态表征的激活。
这种“借力打力”的思路,不仅解决了低资源多模态的核心痛点,更重构了多模态研究的逻辑:生成能力是表征能力的基础,提升生成能力就能突破表征性能的天花板。
对于正在做多模态研究的科研人员来说,这篇论文提供了可直接复现的方案;对于需要落地多模态技术的企业来说,LCO-EMB大幅降低了数据和计算成本。如果你也在被多模态的标注数据或训练成本困扰,这篇论文绝对值得仔细研读。
你们在做多模态落地时,是否也遇到过低资源场景的难题?或者在微调MLLM时,是否发现过生成能力与表征能力的关联?欢迎在评论区交流你的经验和思考。
参考资料
• 标题:Scaling Language-Centric Omnimodal Representation Learning
• 作者:Chenghao Xiao, Hou Pong Chan, Hao Zhang, Weiwen Xu, Mahani Aljunied, Yu Rong
• 机构:Alibaba Group DAMO Academy, Hupan Lab
• 链接:https://openreview.net/pdf?id=eA3Aum0rpA