Meta最新生成式广告模型GEM精读:加速广告推荐AI创新的中央大脑
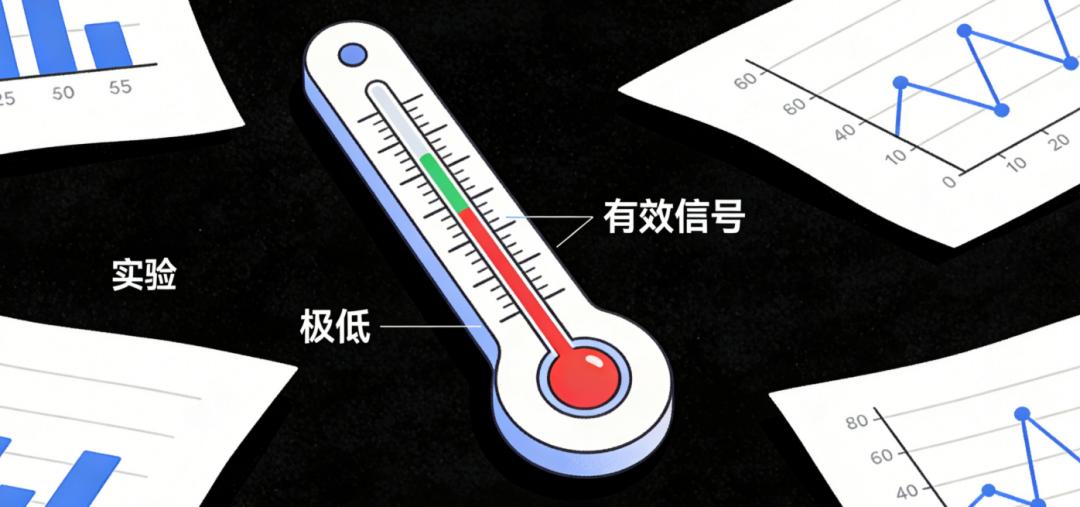
推荐系统优化有两个核心难题:一是用户-广告交互数据里有效信号(如点击、转化)太稀疏,模型总难学到稳定规律;二是用千级GPU训练时,硬件利用率(MFU)始终低于50%,算力浪费严重。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
直到看到Meta发布的Generative Ads Model(GEM)论文,才发现他们不仅解决了这些痛点,还把推荐系统的大模型范式做得相当成熟。今天就带大家拆解GEM的核心逻辑,不管你是做推荐系统科研,还是搞AI广告落地,都能从里面积累可复用的经验。
一、先搞懂:AI广告推荐的3大科研痛点,GEM到底在解决什么?
在聊技术细节前,得先明确GEM的应用场景——Meta的广告推荐系统,这是个典型的“高复杂度、高要求”推荐系统场景,背后藏着3个所有推荐系统研究者都头疼的共性问题:
1. 动态特征空间:数据多但“有用的少”
每天Meta平台有数十亿次用户-广告交互,但像“转化”这种关键信号,1000次交互里可能只有几次;更麻烦的是特征还在动态变——用户今天喜欢美妆,下周可能转向运动,广告格式也从图片更到短视频。这就像你做实验时,每天收集10万条数据,但只有10条能支撑结论,还得实时调整数据分类维度,传统模型很容易“学偏”或“学漏”。
2. 数据异构:多源信息难“捏合”
广告推荐要处理的数据源太杂了: 广告目标(是涨粉还是卖货)、广告创意(文本+图片+视频)、用户行为(在Facebook刷帖 vs 在Instagram看Reels)、测量信号(点击时长、完播率)。这就像你做跨学科实验,既要分析化学检测数据,又要处理生物影像,还要结合问卷调查结果,传统模型要么把这些数据“混为一谈”丢进网络,要么“各自为政”导致信息割裂。
3. 算力效率:大模型训练“又贵又慢”
做推荐系统的都知道,要提升性能,很容易陷入“堆参数量、堆GPU”的误区——训练推荐结果经常模型算力利用率(MFU)只有38%,相当于100块钱花出去,只有38块用在了“学知识”上。而GEM作为推荐系统领域的大模型,要处理海量的参数和数据,若不优化算力效率,根本不可能落地。
二、传统方案的4个局限:为什么之前的模型解决不了这些问题?
在GEM之前,Meta和行业里的推荐模型,其实已经尝试过不少方案,但都有明显短板,这也是我们科研中常踩的坑:
1. 架构效率低:传统模型要么只处理序列特征(如用户浏览历史),要么只处理非序列特征(如用户年龄、广告格式),就算两者都处理,也是简单拼接——就像你整理实验数据时,把“每日温度记录”和“设备参数”直接贴在一张表里,没找两者的关联,结果模型性能提升1%,参数量要涨50%,性价比极低。
2. 知识转移弱:推荐系统里有很多“小模型”(比如负责Facebook Feed的模型、负责Instagram Reels的模型),传统方案是让大模型“教”小模型时,直接把输出结果丢过去,没考虑小模型的场景差异——比如大模型学的是全平台数据,小模型只服务Instagram短视频场景,结果“老师教的”和“学生需要的”对不上,知识蒸馏效果只有预期的一半。
3. 长序列处理差:用户的行为序列可能长达几千条(比如一周内刷的1000条内容),传统模型要么截断序列(只看最近100条),要么用简单的RNN处理(容易忘早期信息)——就像你分析一个月的实验日志,只看最后3天的数据,或记不住前两周的关键变量,自然抓不准用户长期偏好。
4. 多域适配难:Facebook、Instagram、Business Messaging的用户行为差异极大(比如Facebook用户爱读长文,Instagram用户爱刷短视频),传统模型要么用“统一模型”忽略差异(导致各平台性能不均),要么用“独立模型”重复训练(浪费算力)。
三、GEM的核心创新:从架构到基建,3步打破传统困局
Meta的聪明之处在于,没有孤立解决某个问题,而是从“架构设计→知识转移→训练基建”做了闭环优化,每一步都踩在传统方案的痛点上。
1. 架构创新:双特征处理+跨特征学习,效率提4倍
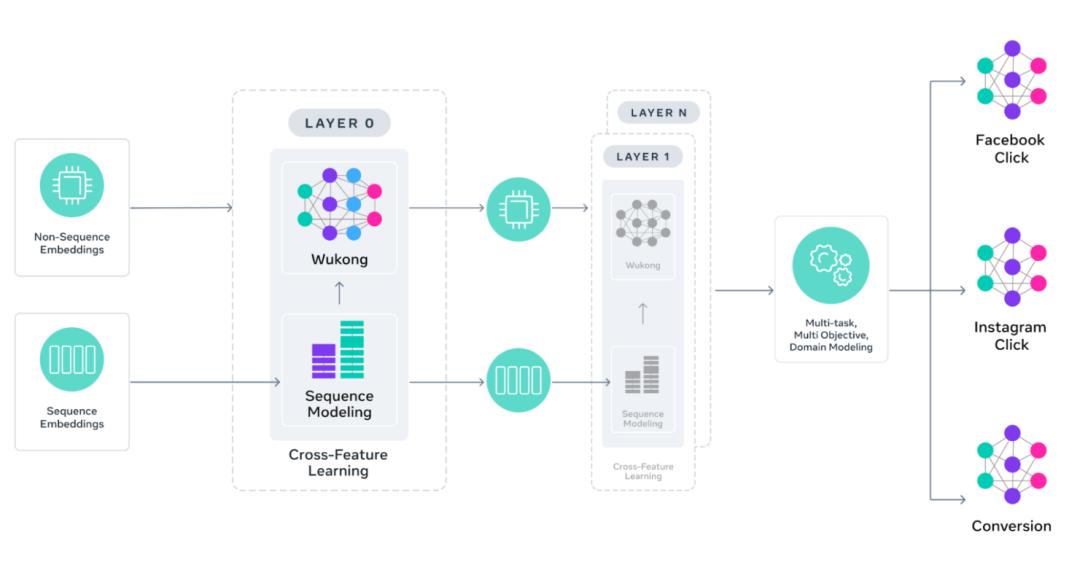
GEM的架构核心是“分而治之,再交叉融合”,专门解决特征异构和长序列问题,拆解成几个关键模块:
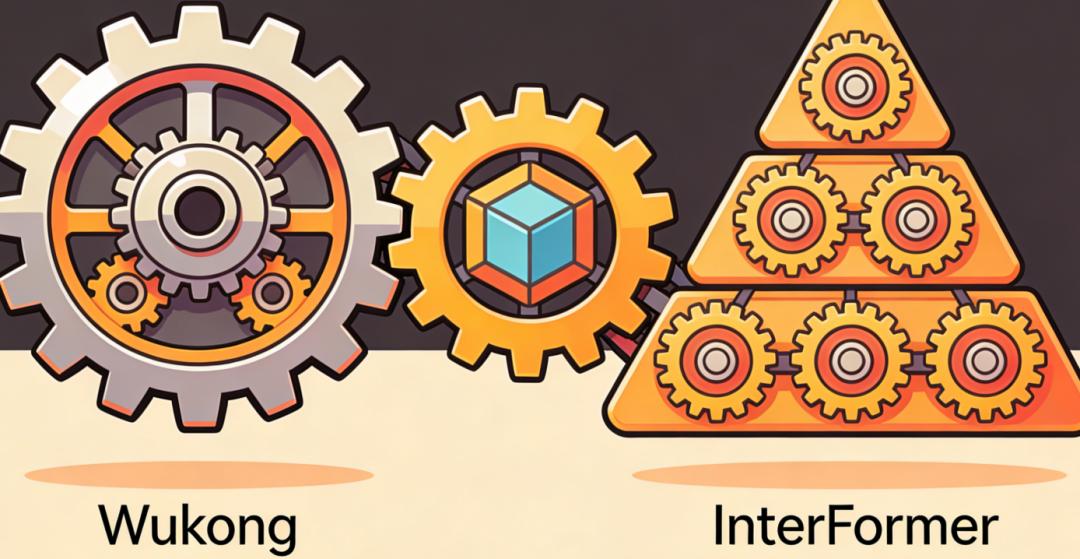
(1)非序列特征:Wukong模块——像分类整理实验样本,抓准关键关联
非序列特征(用户年龄、广告格式、地理位置等)的核心需求是“找对特征组合”——比如“25岁女性+美妆短视频广告”的转化概率,可能比“25岁男性+美妆短视频广告”高10倍。传统模型用简单的线性组合,抓不准这种复杂关联。
GEM改进了Wukong架构(之前Meta用于推荐的基础架构),加入“可堆叠因子机+跨层注意力”:把每个特征当成“实验样本的一个维度”,先让同类型特征(比如用户属性类、广告属性类)内部交互,再通过跨层注意力让不同类型特征关联——就像你先把实验数据按“温度”“压力”“反应时间”分类,在每类里找规律,再看“温度+压力”的组合对结果的影响。这种设计让Wukong模块既能横向覆盖更多特征(比如新增“广告创意风格”特征),又能纵向挖深交互(比如“年龄+广告格式+浏览时长”的三维关联),最终让非序列特征的处理效率提升2倍。
(2)序列特征:金字塔-并行结构——像分层分析长期实验日志,不丢细节
用户行为序列(比如一周内的点击、浏览记录)的难点是“长且杂”,传统模型处理1000条序列要丢30%的早期信息,GEM用“金字塔-并行结构”解决:
把长序列分成多层(比如按时间分成“最近1小时”“最近1天”“最近1周”),每一层用并行模块处理——就像你分析一个月的实验日志,先按“天”整理每日关键数据,再按“周”汇总趋势,最后看全月规律,既不遗漏早期细节,又能高效处理长序列。而且GEM的离线特征基建能存下数千条序列,存储成本只增加15%。
(3)跨特征学习:InterFormer——边整理日志边关联,不丢信息
传统方案处理完序列和非序列特征后,会把序列特征压缩成一个向量再拼接,很容易丢关键信号(比如用户上周点击过某类广告,压缩后可能被忽略)。GEM的InterFormer设计很巧妙:用“交替(interleaving)结构”,先做一轮序列学习(比如用Transformer学用户行为的时间规律),再做一轮跨特征交互(比如让“用户最近点击的3条美妆广告”和“用户年龄25岁”关联),循环迭代——就像你边整理实验日志(序列学习),边记录“今天的温度(非序列)和反应时间(序列)的关系”(跨特征交互),全程不丢原始信息。
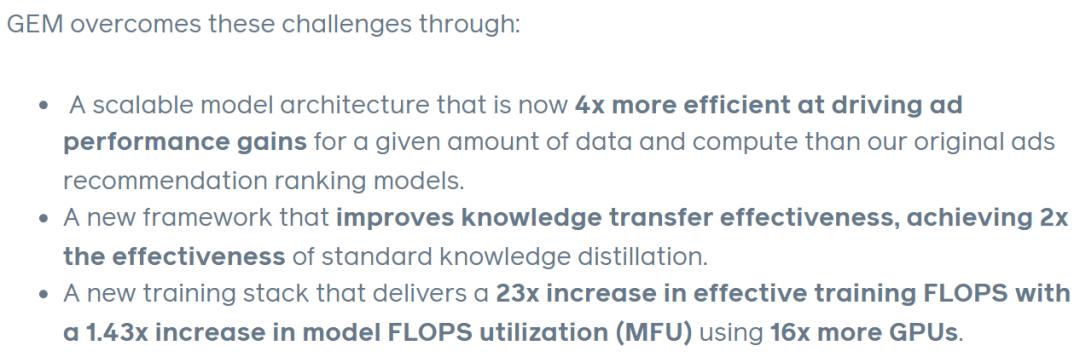
这套架构最终实现“4倍效率提升”:在相同数据和算力下,GEM的广告性能(转化预测准确率)是Meta原有推荐排序模型的4倍。
2. 知识转移:Student Adapter+分层策略,效果翻2倍
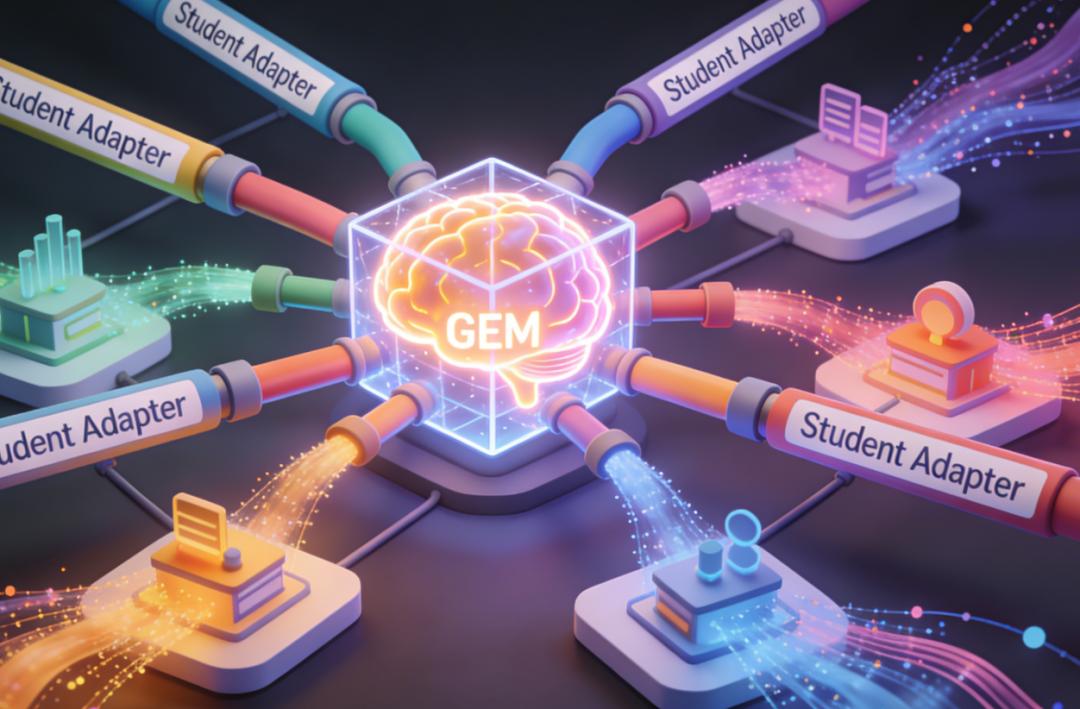
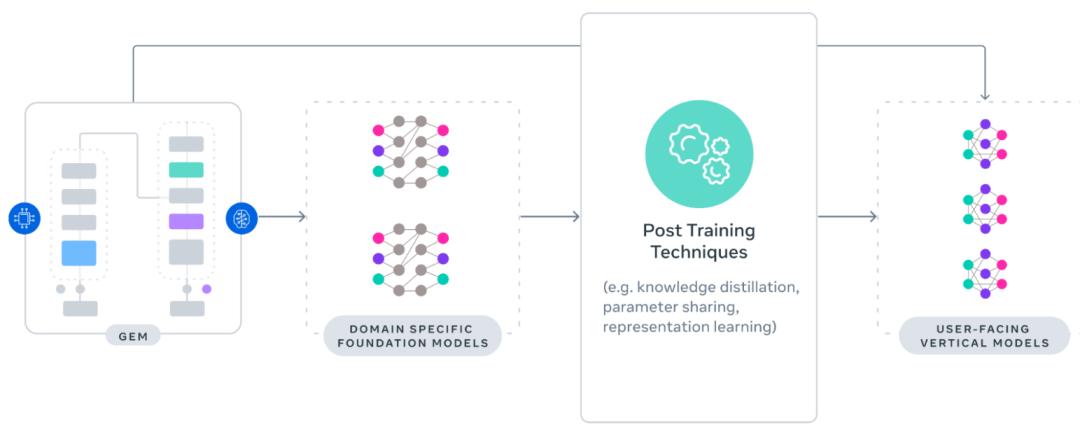
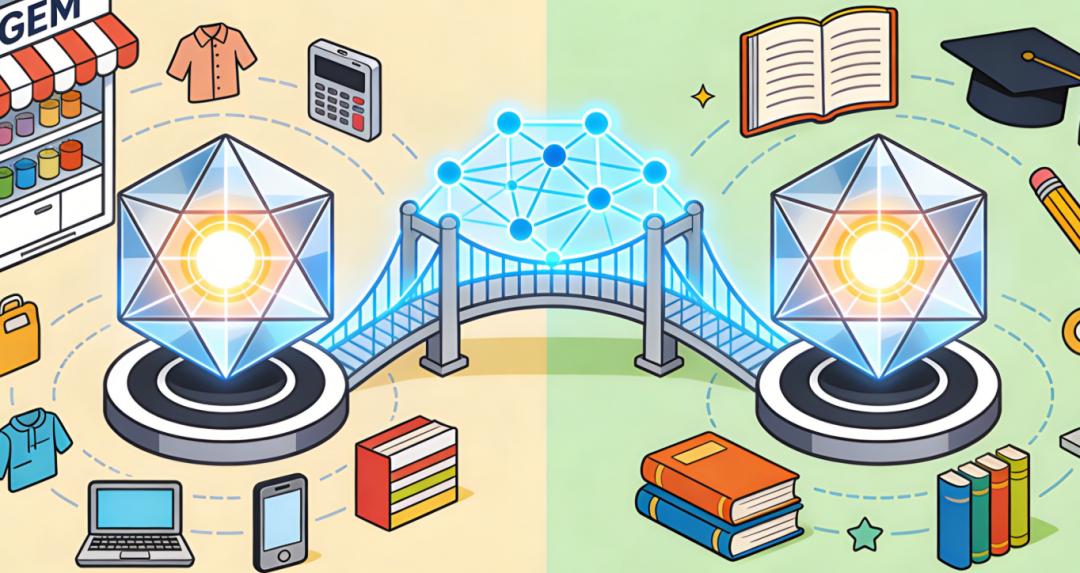
GEM作为“中央大脑”,要把知识传给数百个“小模型”(比如负责Facebook Feed的VM、负责Instagram Reels的VM),传统知识蒸馏的问题是“老师和学生的场景不匹配”——比如GEM学的是全平台数据,而Instagram VM只服务短视频场景,直接蒸馏会导致“老师的知识用不上”。
GEM的解决办法有两个,很值得科研中借鉴:
(1)Student Adapter:给“老师的答案”做校准,贴合学生场景
GEM在“老师模型(GEM)”和“学生模型(VM)”之间加了个轻量组件——Student Adapter,用学生模型的最新真实数据(比如Instagram VM的近期转化数据),调整老师模型的输出。就像你导师给你一个实验方案(老师输出),你根据实验室的实际设备(学生数据)做微调,让方案更落地。这个组件只有传统模型10%的参数量,却能让蒸馏效果提升50%,最终整体知识转移效率是标准蒸馏的2倍。
(2)分层转移:先到“领域FM”,再到“垂直VM”,避免知识断层
如果GEM直接给所有VM传知识,容易“一刀切”(比如给Business Messaging VM传Instagram的知识)。GEM设计了“GEM→领域FM→垂直VM”的分层策略:先把GEM的知识传给“领域专属FM”(比如Facebook领域FM、Instagram领域FM),让FM先适配领域特性,再传给该领域的VM。就像你先把通用实验方法(GEM)教给“化学组助手”(领域FM),助手再根据化学实验的细节(领域特性),教给具体做实验的学生(VM),知识传递更精准。
这套架构最终实现提高知识迁移的有效性,其效果是标准知识蒸馏的2倍。
3. 训练基建:多维度并行+GPU优化,算力利用率提23倍
大模型训练的核心是“用对算力”,GEM的训练基建做了3个关键优化,解决我们科研中常遇到的“GPU闲置、训练慢”问题:
(1)多维度并行:HSDP+2D稀疏并行,让GPU“各干擅长的活”
GEM的模型分“ Dense 部分”(比如Transformer层)和“稀疏部分”(比如用户/广告的 embedding 表),用不同并行策略:
• Dense 部分用HSDP(Hybrid Sharded Distributed Parallel):把模型参数分成多份,让不同GPU负责不同部分,同时数据也分片——就像实验室里,A设备处理温度数据,B设备处理压力数据,同时各自用不同批次的样本训练,既省内存又快。
• 稀疏部分用2D并行(数据并行+模型并行):Embedding表太大,单GPU存不下,就按“用户ID”分片(模型并行),同时每个分片用不同数据训练(数据并行)——就像你把10万用户的embedding分成10份,10个GPU各存1份,同时各用10%的数据更新,既解决存储问题,又不浪费算力。
(2)系统级优化:自定义 Kernels+PyTorch 2.0编译,榨干GPU性能
GEM做了两个实用优化:
• 自定义GPU kernels:针对用户行为的“变长序列”(比如有的用户序列100条,有的500条),写了专属 Kernels,把序列处理的速度提了3倍——传统 Kernels 处理变长序列会有“等待空闲”,自定义 Kernels 能动态分配资源,就像实验室里的自动移液器,能根据样本量调整吸液速度,不浪费时间。
• PyTorch 2.0图编译:开启自动算子融合和激活 Checkpointing——算子融合把多个小计算步骤合成一个(比如“特征归一化+线性变换”合并),像你把“称样品+溶解样品”两步合成一步做;激活 Checkpointing 只存关键中间结果,省内存,让GPU能处理更大批次的数据。
(3)启动与调度优化:5倍启动加速,减少GPU闲置
科研中常遇到“训练10小时,启动等2小时”的问题,GEM优化了 Trainer 初始化、数据读取、编译缓存:
• 编译缓存:把PyTorch 2.0的编译结果存下来,下次训练直接用,编译时间从1小时减到8分钟(7倍加速);
• 数据读取:用分布式数据缓存,避免每次训练都重新读原始数据,读取速度提3倍。
最终这套基建在有效训练浮点运算次数(FLOPS)上提高了23倍,在模型浮点运算次数利用率(MFU)上提高了1.43倍,同时使用的GPU数量增加了16倍。
四、实验验证:关键指标+落地效果,科研与产业都能参考
GEM不是“实验室模型”,而是已经在Meta全平台落地的,关键数据很扎实,适合科研人员对标:
1. 业务指标:转化率实实在在涨了
• Q2落地后:Instagram广告转化率涨5%,Facebook Feed广告转化率涨3%——要知道Meta的广告基数极大,5%的提升意味着每天多百万级的转化,很巨大的商业价值。
• Q3架构优化后:相同数据和算力下,性能收益翻倍——比如之前加10%数据,转化率涨1%,优化后涨2%,说明模型的“数据&计算利用效率”变高了。
2. 技术指标:效率和转移效果达标
3. 硬件环境:数千GPU集群,可复现性强
GEM的训练用了“数千GPU”(Meta没说具体型号,但推测是A100或H100级),采用多维度并行(HSDP+2D稀疏并行),软件栈基于PyTorch 2.0——这些都是行业通用的工具,科研团队只要有中等规模GPU集群(比如100+张A100),就能借鉴其架构和训练策略,不用依赖特殊硬件。
五、前景与挑战:GEM给AI推荐带来的启示,还有哪些坑要填?
GEM的价值不只是Meta自己用,更给整个推荐系统领域提供了“大模型范式”,但落地时还有两个关键问题要考虑:
1. 前景:多模态+全平台,还有很大空间
Meta提到未来GEM会加入文本、图片、音频、视频的多模态学习——比如用户看了美妆短视频(视频模态),又点赞了美妆文案(文本模态),GEM能把这些模态的信号融合,更精准判断偏好。另外,GEM还会覆盖Meta的所有平台(包括Business Messaging、VR设备),形成“全场景推荐闭环”,这对跨域推荐的科研很有参考意义。
2. 挑战:隐私与多平台适配,科研要避坑
• 隐私风险:GEM用了大量用户行为数据,虽然Meta有隐私保护措施,但小团队做类似模型时,很容易踩数据合规的坑——比如用用户的聊天数据训练,可能违反隐私法规,这需要在模型设计时就考虑“联邦学习”或“差分隐私”。
• 多平台适配:虽然GEM的分层转移解决了部分问题,但不同平台的“目标差异”(比如Facebook追求停留时长,Instagram追求转化)还是会导致模型偏向性——给追求停留时长的平台传转化导向的知识,效果会掉,需要在领域FM阶段就加入“目标权重”调整。
结尾:GEM的真正价值,是给推荐系统“降本增效”的范式
对科研人员来说,GEM的最大启示不是“堆大模型”,而是“用架构创新和工程优化,让大模型既有性能又有性价比”——之前做推荐系统时,总想着“参数量再大一点、GPU再多一点”,却忽略了特征交互、知识转移这些“细节优化”,结果成本高还没效果。GEM证明,推荐系统大模型的核心是“把数据用透、把算力用对”,这比盲目堆资源更重要。
最后想跟大家互动:你们在做知识蒸馏时,有没有遇到“老师模型和学生模型场景不匹配”的问题?是用类似Student Adapter的方法解决,还是调整了蒸馏损失函数?欢迎在评论区交流经验~
参考资料
• 标题:Meta’s Generative Ads Model (GEM): The Central Brain Accelerating Ads Recommendation AI Innovation
• 作者:Huayu Li, Xiaoyi Liu, Jade Nie, Ellie Wen, Chunzhi Yang, Jiyan Yang, Nancy Yu, Habiya Beg, Gil Arditi, Neeraj Bhatia
• 机构:Meta(原Facebook)
• 链接:https://engineering.fb.com/2025/11/10/ml-applications/metas-generative-ads-model-gem-the-central-brain-accelerating-ads-recommendation-ai-innovation/