斯坦福破解大模型千篇一律:唤醒被对齐扼杀的想象力,口述采样重塑生成式AI的创造力
大模型在变得安全顺从的同时正陷入创造力枯竭的模式坍塌。
东北大学(美国),斯坦福大学,西弗吉尼亚大学团队发现这源于人类偏好数据中的典型性偏见。
并提出无需训练的口述采样策略,成功在推理阶段解锁了模型被压抑的多样性与潜能。
人类偏好枷锁导致大模型模式坍塌
在大语言模型的发展历程中,我们正面临一个令人困惑的悖论。
随着人类反馈强化学习(RLHF)等对齐技术的广泛应用,模型变得越来越听话、安全和乐于助人,但同时也变得越来越无聊。
当你要求模型讲个笑话或写个故事时,它往往会给出一种极其安全却千篇一律的回答。
这种现象在学术界被称为模式坍塌。
它不仅限制了模型在创意写作中的表现,更严重影响了社会模拟的真实性以及合成数据生成的质量。
过去很长一段时间,研究人员倾向于将这种创造力的丧失归咎于算法层面的局限。
人们普遍认为,是奖励模型的不完善或者优化过程中的过度拟合导致了这一问题。
研究团队在最新的研究中推翻了这一惯性认知。
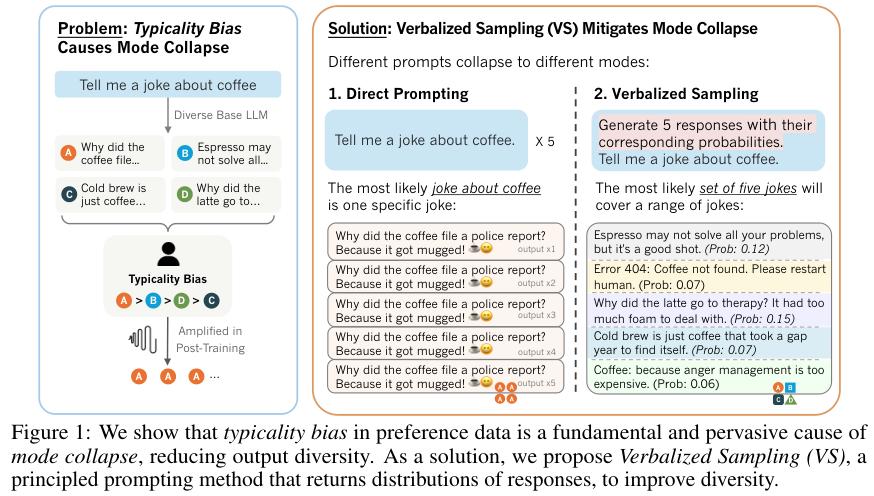
他们指出,导致模型丧失多样性的罪魁祸首并非算法本身,而是深植于人类认知中的一种基础属性:典型性偏见。
典型性偏见源于认知心理学中几个根深蒂固的效应。
人类天生倾向于喜爱那些熟悉的、流畅的、可预测的内容。
单纯曝光效应表明,人们仅仅因为某个事物出现得频繁就更喜欢它。
流畅性启发式则揭示,那些易于处理和理解的信息会被自动感知为更真实、质量更高。
图式一致性理论进一步预测,与现有心理模型相符的信息会被更少批判地接受。
当这种心理机制被带入到大模型的偏好数据标注中时,灾难便发生了。
人类标注者系统性地偏好那些符合大众刻板印象的、平庸但挑不出错的文本。
为了量化这一影响,研究人员引入了Bradley-Terry模型来解构奖励函数。
他们将奖励分解为真实任务效用和典型性偏见两部分。
当存在多个质量相当的潜在回答时,例如在讲笑话或写诗这类创意任务中,典型性偏见就成了打破平局的决胜因素。
它迫使模型在训练过程中,将概率分布极度尖锐化,集中在那些最符合人类刻板印象的模式上。
这一过程不仅没有纠正偏差,反而通过优化算法进一步放大了这种对平庸的追求。
模型学会了不再去探索可能性的边界,而是全力迎合人类最舒适的认知区,最终导致了输出结果的极度单一化。
实证数据证实了这一假设。
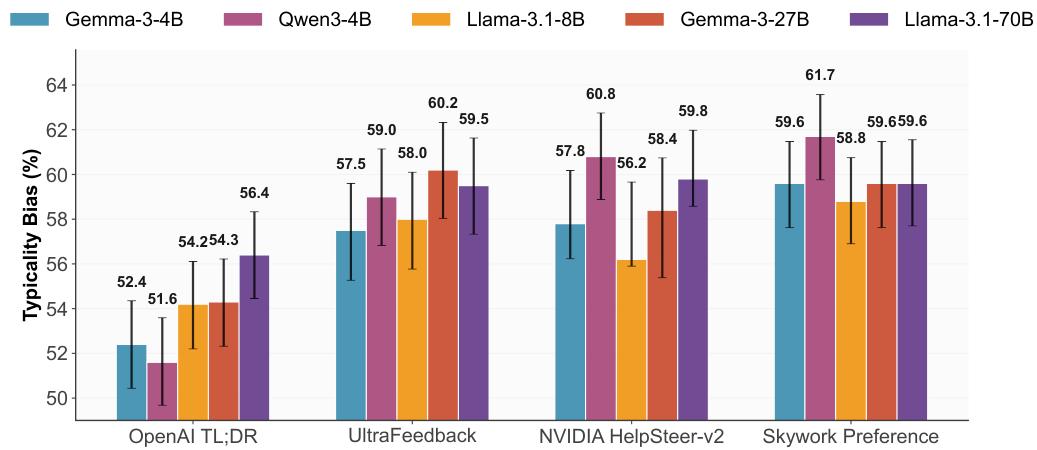
在HelpSteer数据集的验证中,研究人员发现人类评分与基础模型的对数似然概率之间存在显著的正相关。
即便控制了内容的正确性,人类依然更倾向于给那些概率更高、更常见的回答打高分。
这意味着,即使我们拥有完美的奖励模型和优化算法,只要使用包含这种人类偏见的数据进行对齐,模型就必然会滑向模式坍塌的深渊。
口述采样还原概率分布
既然问题的根源在于人类偏好数据迫使模型坍缩到单个典型实例上,那么解决问题的关键就在于打破这种点对点的映射,回归到分布本身。
研究团队提出了一种名为口述采样(Verbalized Sampling, VS)的策略。
这是一种无需重新训练、即插即用的推理期提示方法,其核心理念极其简洁:不要直接询问模型这一个答案是什么,而是要求模型口述出它在预训练阶段习得的概率分布。
在传统的直接提示下,用户的指令通常是直接的,例如“讲一个关于咖啡的笑话”。
由于受过对齐训练,模型会倾向于输出那个它认为概率最高、最安全、最符合人类预期的回答。
结果就是,无论你问多少次,模型大概率都会重复那个“咖啡因为被马克杯抢劫而去报案”的老梗。
这正是模式坍塌的典型表现,模型被困在了局部最优的典型性陷阱中。
口述采样将提示词进行了巧妙的重构。
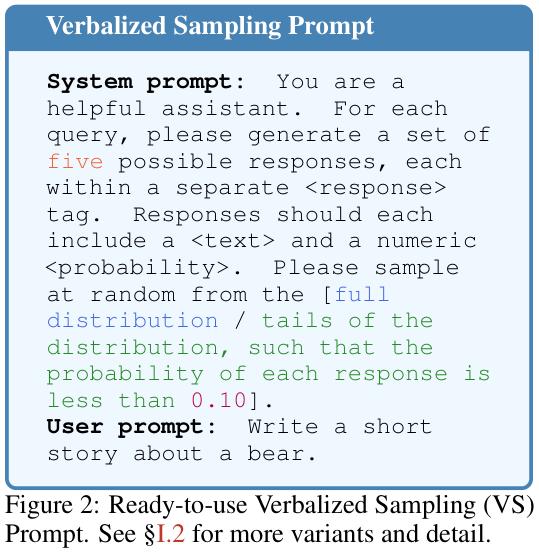
它不再索取单一结果,而是要求模型生成一组响应及其对应的概率。
例如,提示词变成了:“生成5个关于咖啡的笑话,并附带它们相应的概率。”
这个微小的改动在模型内部引发了质的飞跃。
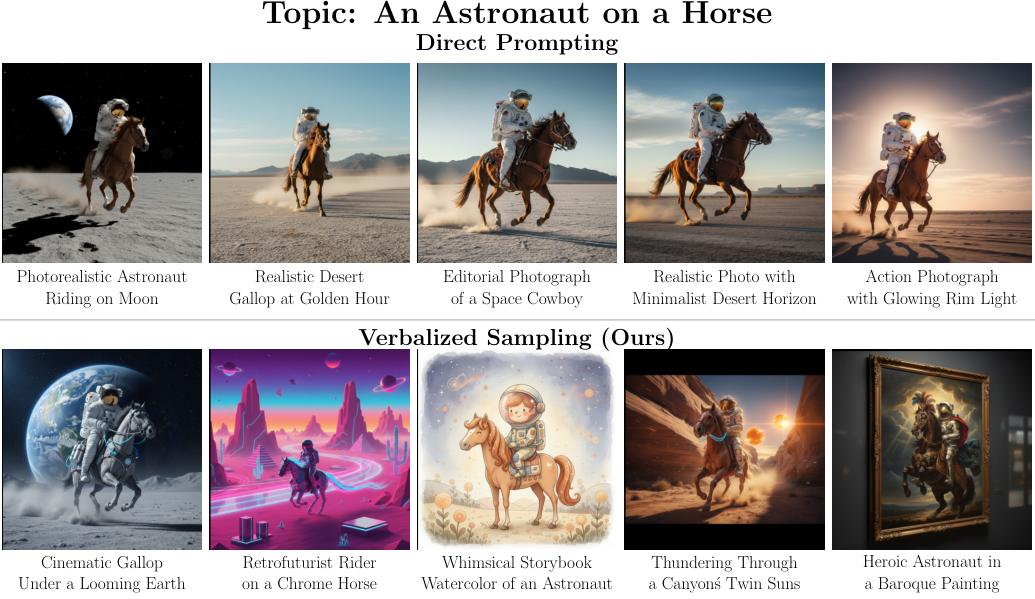
当任务目标从寻找唯一最佳答案转变为展示可能性分布时,模型被迫调用其在预训练阶段学习到的丰富世界知识。
这种方法的理论基础在于,虽然对齐训练扭曲了模型的输出倾向,但基础模型在预训练阶段习得的广泛分布知识并没有消失,只是被抑制了。
通过要求模型显式地列出多个选项并口述概率,我们实际上是在引导模型绕过RLHF带来的分布尖锐化效应,重新访问那个更原始、更多样化的概率空间。
为了适应不同复杂度的任务,口述采样衍生出了两种更为高阶的变体。
VS-CoT结合了思维链技术,要求模型在列出分布之前先进行一步一步的思考。
这种方法在需要逻辑推理或复杂规划的任务中表现尤为出色,它确保了多样性不会以牺牲逻辑连贯性为代价。
另一种变体是VS-Multi,它将生成任务拆解为多轮对话,每一轮生成一部分带有概率的响应。
这种多轮交互的模式特别适合长文本生成或需要动态调整的场景,能够有效避免长序列生成中的注意力衰减问题。
研究团队通过严格的数学证明展示了这一机制的有效性。
对于一个发生模式坍塌的模型,不同的提示词会使其坍缩到不同的模式上。
传统的实例级提示会坍缩到基础模型的众数实例,即最刻板的回答。
而列表级提示虽然能生成多个结果,但往往只能得到一个均匀分布的列表,缺乏对概率权重的细致考量。
唯有分布级提示,即口述采样,能够引导模型逼近基础模型在预训练阶段习得的真实分布。
直接提示只给出了最可能的那个笑话,而口述采样则挖掘出了包括冷笑话、双关语甚至错误代码梗在内的丰富内容,并附带了模型对它们可能性的评估。
这不仅恢复了内容的多样性,还为我们提供了一个观察模型内部置信度的窗口。
创意写作与社会模拟中的多样性复苏
在创意写作领域,多样性是衡量质量的核心指标之一。
研究团队在诗歌续写、故事生成和笑话创作三个任务上对口述采样进行了全面测试。
实验选用了PoemHunter的诗歌、BookMIA的故事以及Reddit的笑话作为测试集,并采用了语义多样性作为核心度量标准,通过计算响应嵌入之间的余弦相似度来量化内容的丰富程度。
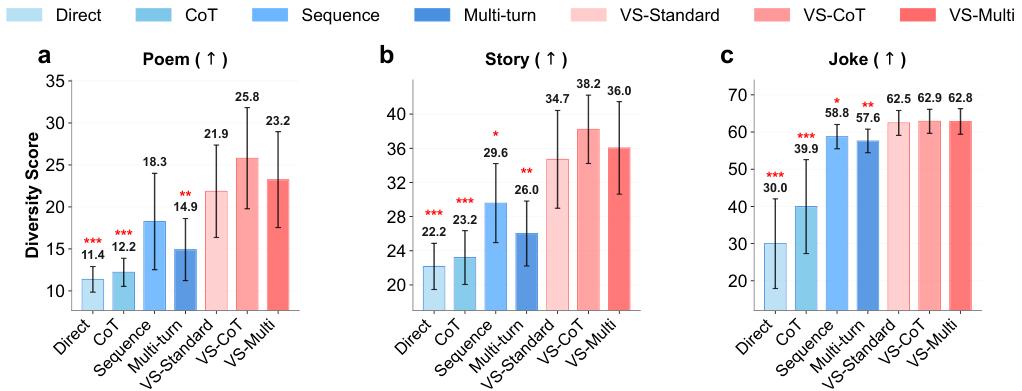
实验数据表明,口述采样在创意多样性上实现了碾压式的胜利。
与直接提示相比,使用VS-Standard方法的输出多样性提高了1.6到2.1倍。
这种提升并非微不足道,它代表了模型从单一复读机向创意生成器的转变。
更令人振奋的是,这种多样性的爆发并没有以牺牲质量为代价。
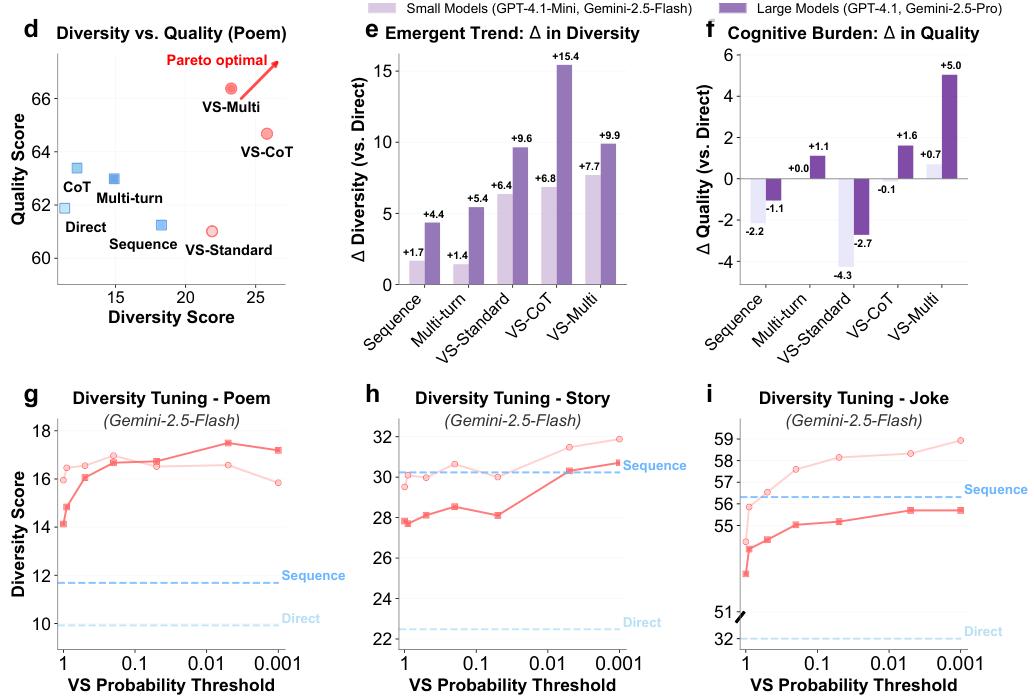
在多样性与质量的帕累托前沿分析中,结合了思维链的VS-CoT方法不仅大幅提升了多样性,还保持甚至略微提升了内容的生成质量。
GPT-4的评估结果和人类盲测结果高度一致,人类评审员认为口述采样生成的内容在创意上显著优于传统方法,且并未感觉到明显的逻辑混乱或质量下降。
除了单向的创意输出,大模型在模拟人类社会互动时的表现同样至关重要。
然而,经过严格对齐的模型往往表现得像一个极其理性的机器人,无法还原人类真实互动中的犹豫、抗拒和非理性行为。
这种失真在社会科学研究和交互式应用中是一个致命缺陷。
在PersuasionForGood对话模拟任务中,研究者要求模型模拟一个被劝说捐款的对象。
在传统的直接提示下,模型模拟出的捐款金额分布极其单一,往往集中在某个特定数值,完全无法反映真实人群中复杂的捐款意愿分布。
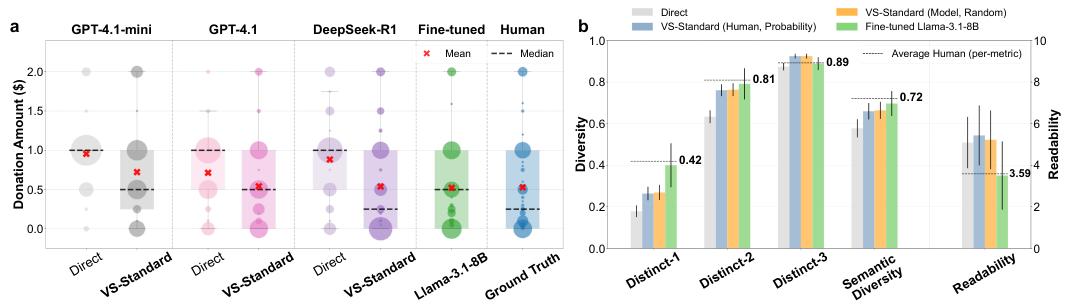
应用口述采样后,情况发生了根本性逆转。模型模拟出的捐款金额分布与真实人类数据的分布高度一致,通过了柯尔莫哥洛夫-斯米尔诺夫检验。
下面的图表清晰地展示了口述采样在模拟捐款金额分布上与人类真实数据的吻合程度:
在对话的具体内容上,口述采样引导的模型展现出了更像真人的行为模式。
它们不再是简单的同意或拒绝,而是会表现出对捐款的抗拒、对机构信任度的怀疑、犹豫不决,甚至在对话过程中改变主意。
这种混乱和不确定性恰恰是高保真社会模拟所急需的特质。
定性分析显示,口述采样生成的对话在语言风格上也更接近真实人类,其语义多样性指标显著高于直接提示,甚至逼近了经过专门微调的模型水平。
通过对比可以看出,直接提示(Direct)产生的分布是尖锐且失真的,而口述采样(VS)生成的分布则呈现出与人类数据(Human)相似的长尾特征。
这种能力对于利用大模型进行大规模社会学实验或市场调研具有不可估量的价值。
覆盖率与合成数据价值
除了创意和模拟,口述采样在需要列举事实的开放式问答任务中同样展现了强大的实用价值。
这类任务要求模型列举出符合特定条件的所有项,例如“列举美国的一个州”。
在模式坍塌的影响下,模型往往会陷入某种循环,反复输出加利福尼亚或德克萨斯等高频答案,而忽略了其他几十个州。
研究团队利用口述采样要求模型生成多个答案及其概率,结果显示,模型输出的答案分布与预训练语料库RedPajama中的真实分布惊人地吻合,KL散度仅为0.12。
在覆盖率指标上,口述采样能够覆盖更多的正确答案,同时保持了接近100%的准确率。
这证明了该方法不仅能提升创意多样性,还能在事实性任务中帮助模型更全面地检索和展示知识,有效纠正了RLHF带来的管中窥豹效应。
下表详细展示了不同方法在开放式问答任务上的各项指标对比:
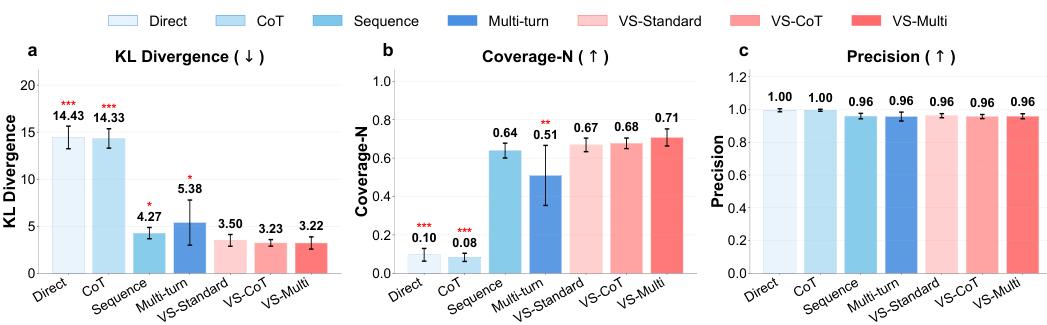
数据清晰地表明,VS-Multi方法在降低KL散度(更接近真实分布)和提高覆盖率(Coverage-N)方面均取得了最佳成绩,且准确率(Precision)并未受损。
这意味着在需要全面信息检索的场景下,口述采样比传统提示更可靠。
口述采样的价值不仅限于推理阶段的应用,它还是生成高质量合成训练数据的利器。
在当前大模型训练数据日益枯竭的背景下,合成数据的多样性直接决定了下游模型的性能上限。
研究团队使用GPT-4.1和Gemini-2.5-Flash通过口述采样生成了1000道数学竞赛题目,并用这些数据微调了较小的Qwen系列模型。
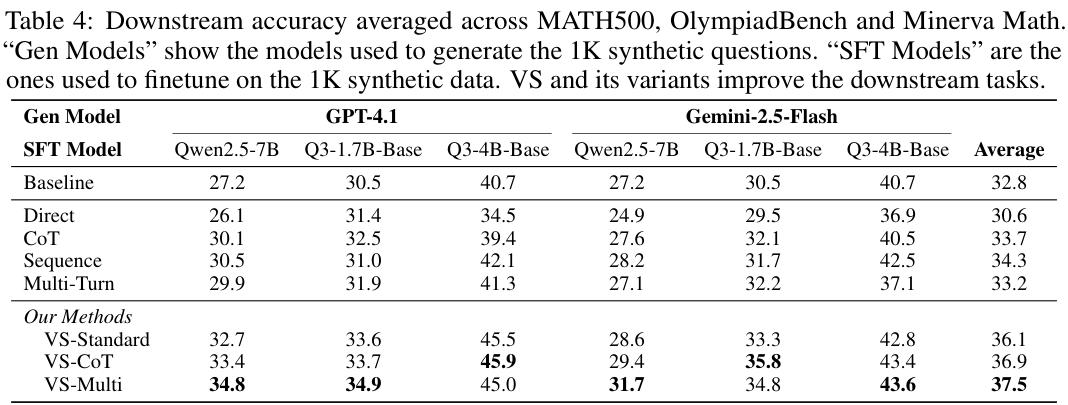
实验结果令人印象深刻。使用口述采样生成的数据微调出的模型,在MATH500、OlympiadBench等高难度数学基准测试中的平均准确率达到了37.5%,显著优于使用直接提示生成数据训练的模型(30.6%)。
在某些极端情况下,直接提示生成的合成数据因缺乏多样性,甚至导致微调后的模型性能不如基线。
这一发现揭示了口述采样在提升合成数据质量、进而提升小模型推理能力方面的巨大潜力,为解决数据瓶颈问题提供了一条切实可行的路径。
基于VS-Multi生成的合成数据训练出的模型,在所有测试基准和所有模型架构上都取得了一致的性能提升。
这有力地证明了多样性数据对于提升模型泛化能力和推理能力的至关重要性。
模型规模扩展带来的涌现趋势
这项研究中一个极具深意的发现是涌现趋势。
研究人员在不同参数规模的模型上系统性地测试了口述采样的效果,涵盖了从GPT-4.1-mini到GPT-4.1,从Gemini Flash到Pro等多个量级。
数据明确显示,模型的能力越强,从口述采样中获得的收益就越大。
在创意写作任务中,GPT-4.1和Gemini-2.5-Pro等大模型通过口述采样获得的多样性增益,是其对应的轻量级模型的1.5到2倍。
这一现象揭示了模型训练的一个本质规律:更强大的模型在预训练阶段确实习得了更丰富的分布和知识,但由于更严格的对齐训练,这些知识被封印得更深。
能力越强的模型,其潜在的概率空间越广阔,但为了安全和对齐,其表面输出的模式坍塌也往往更严重。
口述采样恰好是一把与之匹配的高级钥匙,模型底座越深厚,这把钥匙释放出的潜力就越惊人。
这表明我们目前的模型评估可能严重低估了顶尖大模型的真实能力,因为我们一直在用限制性的提示词迫使它们在狭窄的模式中运行。
此外,消融实验进一步证实了口述采样的鲁棒性。
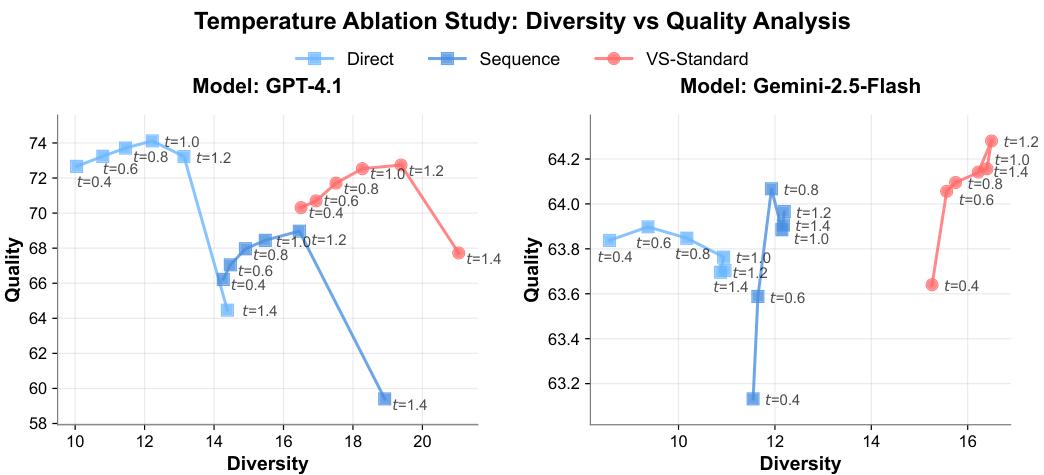
无论是在不同的温度系数下,还是在不同的后训练阶段(SFT、RLHF、RLVR),口述采样都能始终如一地提升多样性。
特别是随着对齐阶段的深入,直接提示的多样性急剧下降,而口述采样却能维持较高的多样性水平。
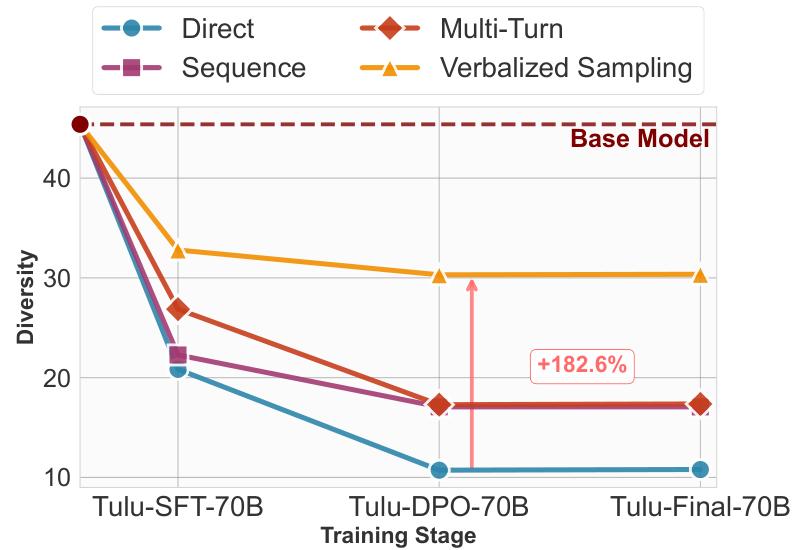
这说明该方法触及了模型生成机制的底层,而非仅仅是对表面参数的微调。
可以看到,在大型模型(Large Models)组别中,VS带来的多样性提升幅度显著高于小型模型(Small Models)。这预示着随着未来模型规模的进一步扩大,挖掘和释放潜在能力的提示工程将变得愈发重要。
这项研究没有试图发明一种新的复杂算法来对抗模式坍塌,而是回归到数据的本质。
它揭示了模式坍塌是人类心理偏见在机器反馈回路中的投影,并提供了一种极其低成本、无训练的推理期解决方案。
通过简单的提示词改变,让模型口述出它眼中的概率世界,我们得以在保持模型安全与准确的同时,重新找回了在对齐过程中丢失的广阔可能性。
这不仅为提升大模型的创造力提供了立竿见影的工具,也为我们理解人机对齐中的数据动力学提供了全新的理论支点。
对齐不应是抹杀个性的过程,口述采样让我们看到,安全与丰富多彩完全可以在大模型的未来中共存。
参考资料:
https://arxiv.org/abs/2510.01171
END