商汤推出NEO:原生多模态仅使用3.9亿图文对,性能比肩甚至超越数十亿数据模型
南洋理工大学S-Lab、西安交通大学和商汤科技的研究团队推出NEO原生多模态模型。
NEO在仅使用3.9亿图文对的情况下,实现了从零构建视觉感知能力,其性能在多项基准测试中比肩甚至超越依赖数十亿数据的模块化模型。
NEO模型证明了多模态能力不必依赖外部视觉编码器的拼接,而是可以通过重构底层图元,在单一Transformer架构中原生生长。
主流视觉语言模型的设计范式长期停留在模块化拼接阶段。
这种做法通常是将一个预训练好的视觉编码器,比如CLIP或者SigLIP,通过一个投射层连接到一个大语言模型上。
视觉编码器充当眼睛,投射层充当视神经,大语言模型充当大脑。
这种架构虽然构成了GPT-4V、Claude 3.5 Sonnet以及Qwen-VL等顶尖模型的基础,但它存在根本性的割裂。
视觉与语言的表征在数学空间上并不统一,训练过程需要分阶段来修补这种排异反应。
视觉编码器通常基于双向注意力机制,旨在一次性看清全图,而大语言模型基于因果注意力机制,旨在按时间顺序预测下一个词。
两者交互模式的先天差异,导致了复杂的对齐成本和潜在的性能损耗。
回归第一性原理
NEO有外挂任何现成的视觉模型,而是直接改造了大语言模型的底层结构,使其具备同时处理像素和文字的物理能力。
这种改造并非简单的混合训练,而是深入到了神经网络的图元级别。
NEO的设计哲学在于认为视觉和语言可以在同一个Transformer中实现同构。
为了实现这一目标,研究团队设计了一套原生VLM图元。
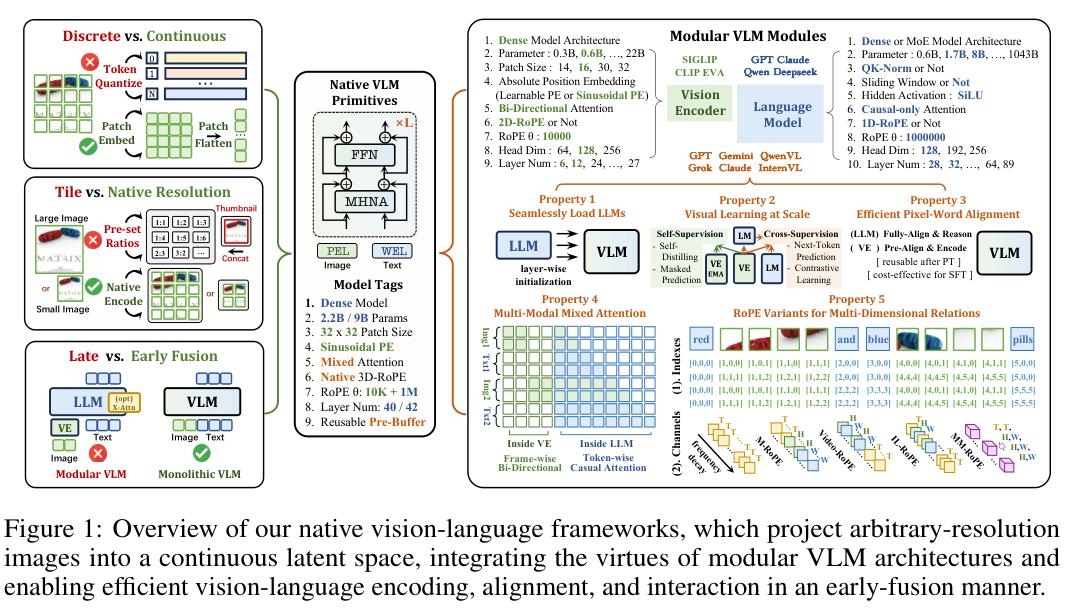
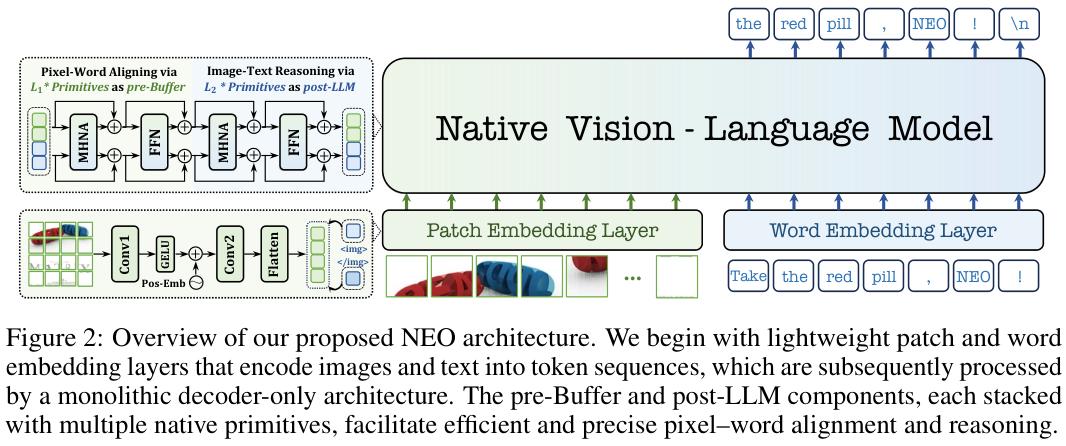
这套图元包含三个核心组件,分别解决了输入映射、注意力交互和空间位置编码三个关键问题。
在输入层,NEO摒弃了沉重的ViT编码器,设计了一个极简的补丁嵌入层。
该层由两个卷积层和一个GELU激活函数组成。
第一层卷积的步长设定为16,第二层为2,这意味着每个视觉Token对应原始图像中32乘以32的像素块。
这不仅是简单的卷积操作,还包含了类似Pixel Unshuffle的Token折叠处理。
为了让模型在单一序列中区分视觉信号的边界,NEO在视觉Token序列的首尾分别插入了特定的起始和结束标记。
文本输入则保持标准的Token化处理。
这两股截然不同的数据流在进入主干网络之前,就被映射到了同一个维度空间,为后续的深度融合奠定了数学基础。
核心引擎层面的改造在于多头原生注意力机制。
这是NEO的心脏,旨在解决视觉的空间性与语言的时间性之间的冲突。
文本生成遵循因果律,模型在预测下一个词时,只能看到之前的词,不能偷看后面。
视觉理解则需要上帝视角,像素点之间需要全方位的交互才能理解图像的全局结构。
NEO引入了混合掩码机制来调和这一矛盾。
在处理文本部分时,模型严格执行单向的因果注意力,保证语言生成的连贯性。
在处理图像部分时,所有视觉Token之间开启全连接的双向注意力,允许像素自由交互。
关键在于交互区域,文本Token可以关注到它之前的所有图像Token。
这种设计使得模型在保持语言生成逻辑的同时,能够随时调用视觉信息进行推理。
NEO最精妙的创新在于原生旋转位置编码。
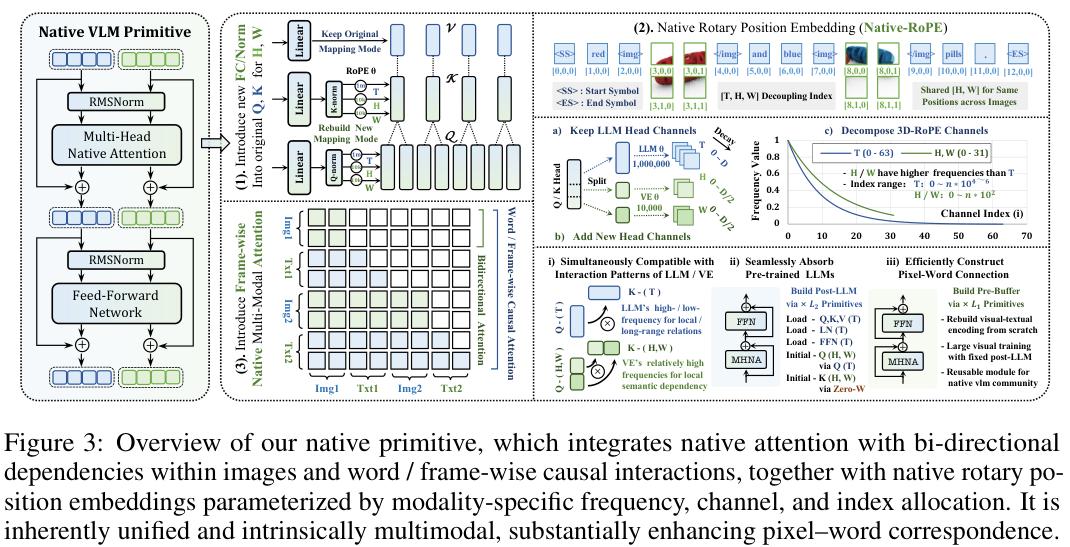
传统的位置编码通常是一维的,直接用于图像会丢失二维空间信息。
简单的二维位置编码又难以处理图文交织的复杂序列。
NEO提出了一种解耦策略,将Transformer的注意力头在物理上拆分为时间、高度和宽度三个维度的专员。
时间维度负责序列的先后顺序,主要服务于文本和视频帧序。
高度和宽度维度则专门负责图像的垂直和水平空间信息。
这种解耦不仅仅是逻辑上的区分,更是参数上的物理隔离。
对于文本Token,模型保留时间索引,将高度和宽度索引设为零。
对于图像Token,时间索引保持不变,因为整张图在时间线上是一个时刻,但赋予其唯一的高度和宽度坐标。
对于视频输入,时间索引随帧递增,空间索引随位置变化。
NEO保留了语言模型原始的查询和键头部维度给时间维度,以保护原有的语言能力。
模型新增了额外的头部维度专门用于高度和宽度,这增加了约10%的参数量。
这10%的增量专门用于建立视觉的空间坐标系。
频率分配是另一个关键细节。
图像通常需要捕捉高频的局部纹理,而大语言模型的默认频率通常较低,适合处理长程语义。
NEO发现这种频率失配会限制视觉感知能力。
原生旋转位置编码为高度和宽度维度设定了与视觉编码器相匹配的高频基数,而时间维度则保持低频设置。
这种设计让NEO在不干扰语言模型原有知识的前提下,自然生长出了理解二维图像空间结构的能力。
先分后合的训练策略
整个训练过程分为预训练、中期训练和监督微调三个阶段。
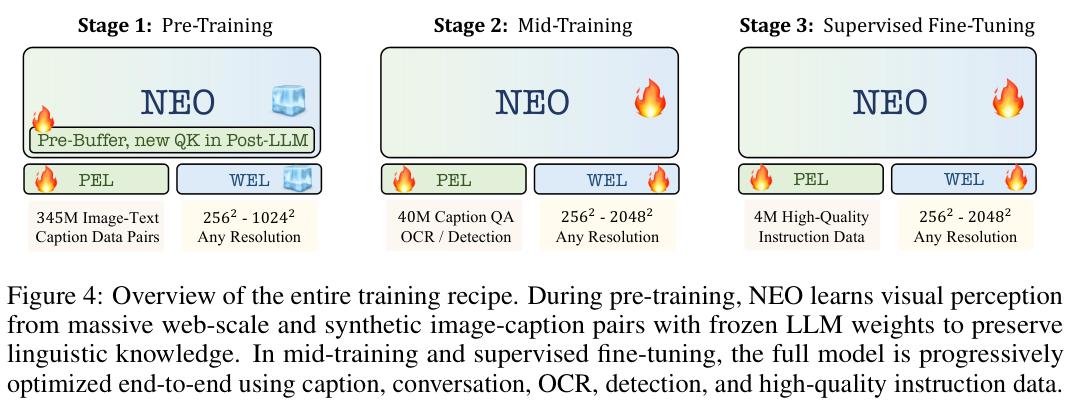
预训练阶段采用了独特的预缓冲与后置大模型策略。
NEO在这一阶段被人为地划分为两个部分。
预缓冲部分由数层原生图元堆叠而成,负责将原始像素转化为深层的语义表征。
后置大模型部分基于预训练的Qwen3系列模型,负责语言推理。
为了防止尚不成熟的视觉信号破坏大模型脆弱的语言知识,后置大模型的大部分参数在这一阶段是冻结的。
仅有新加入的高度和宽度维度参数以及连接层参与训练。
预缓冲充当了一个软性的视觉编码器,但它与大模型在结构上是同构的。
这一阶段使用了3.45亿张图文对,包括LAION-400M和COYO-700M等数据集的子集。
中期训练阶段旨在消除预缓冲与后置大模型之间的界限。
模型开始解冻,进行全参数的端到端训练。
数据质量在这一阶段得到了显著提升,引入了InternVL-1.5的训练语料。
这些语料包含高分辨率图像、光学字符识别数据和更复杂的图文对话。
这一步的目标是让视觉感知与语言推理深度纠缠,消除早期强制分割带来的隔阂。
监督微调阶段则是实战演练。
全模型在约400万条高质量指令数据上进行微调。
任务覆盖了视觉问答、多模态对话、数学推理和图表理解等领域。
此时的NEO已经完全成为一个单体模型,预缓冲的概念在逻辑上已经融入了整体网络。
这种渐进式的训练策略有效平衡了视觉学习的效率与语言能力的保持。
NEO架构性能的全面领先
NEO系列包括基于Qwen3-1.7B构建的NEO-2.2B和基于Qwen3-8B构建的NEO-9B。
在AI2D图表理解、MMMU多学科推理等十个权威基准测试中,NEO展现了极高的数据效率。
NEO-2.2B在多个榜单上超越了参数量相近的Qwen2-VL-2B和InternVL2.5-1.8B。
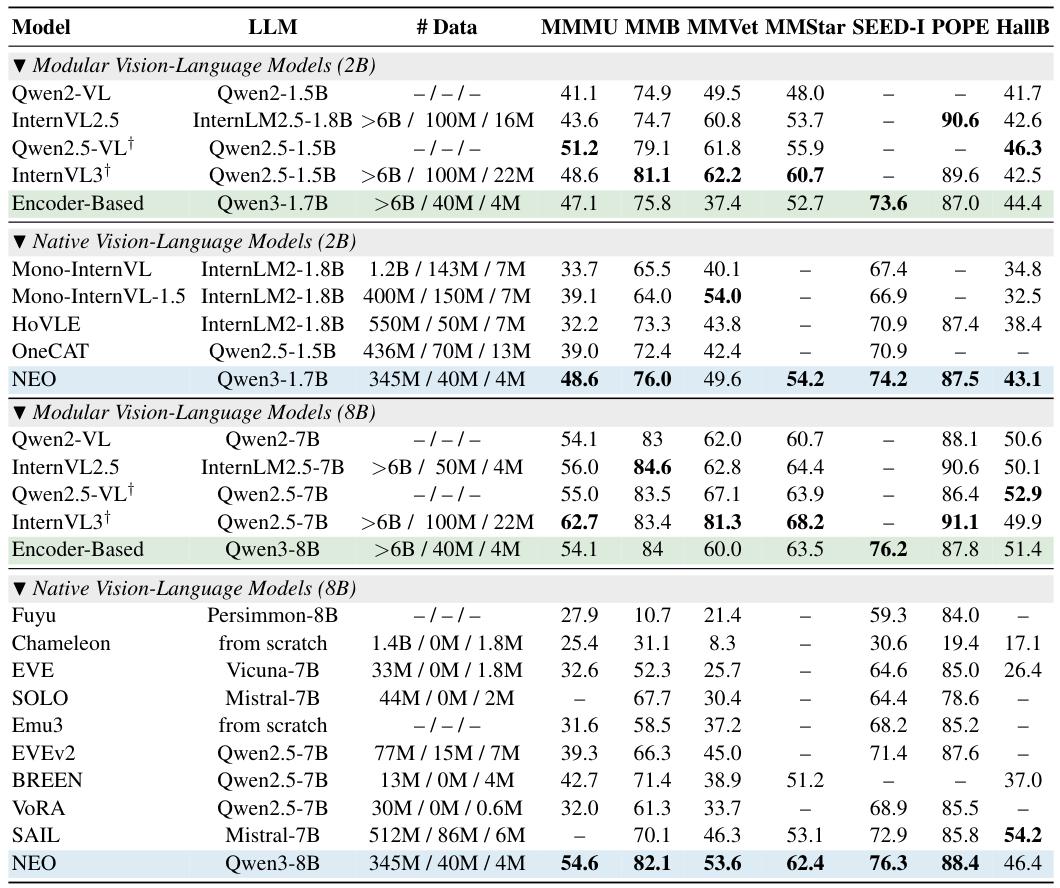
在MMMU测试中,NEO达到了48.6的分数,而Qwen2-VL仅为41.1。
NEO-9B在SEED-I和幻觉测试HallusionBench上表现优异,分别得分76.3和46.4。
这些成绩足以与经过数十亿数据训练的模块化模型互有胜负。
与同样采用原生架构的竞品相比,NEO的优势更为明显。
相比于Fuyu-8B在MMMU上27.9的得分,NEO-9B达到了54.6。
这巨大的分差直接证明了原生旋转位置编码和混合注意力机制的设计优越性。
消融实验进一步揭示了NEO成功的关键因素。
如果去除原生旋转位置编码,改用普通的一维位置编码,模型性能平均下降了近5个百分点。
这证实了将空间与时间维度解耦是原生视觉语言模型的必经之路。
混合注意力的表现优于纯因果注意力,证明了图像理解必须具备全局视野。
关于预缓冲深度的实验表明,对于2B模型,12层的预缓冲效果最佳。
对于9B模型,6层预缓冲足矣。
这说明模型规模越大,其底层本身具备的特征提取潜力越强,所需的额外缓冲越少。
NEO展现了原生架构的潜力,但也并非没有局限。
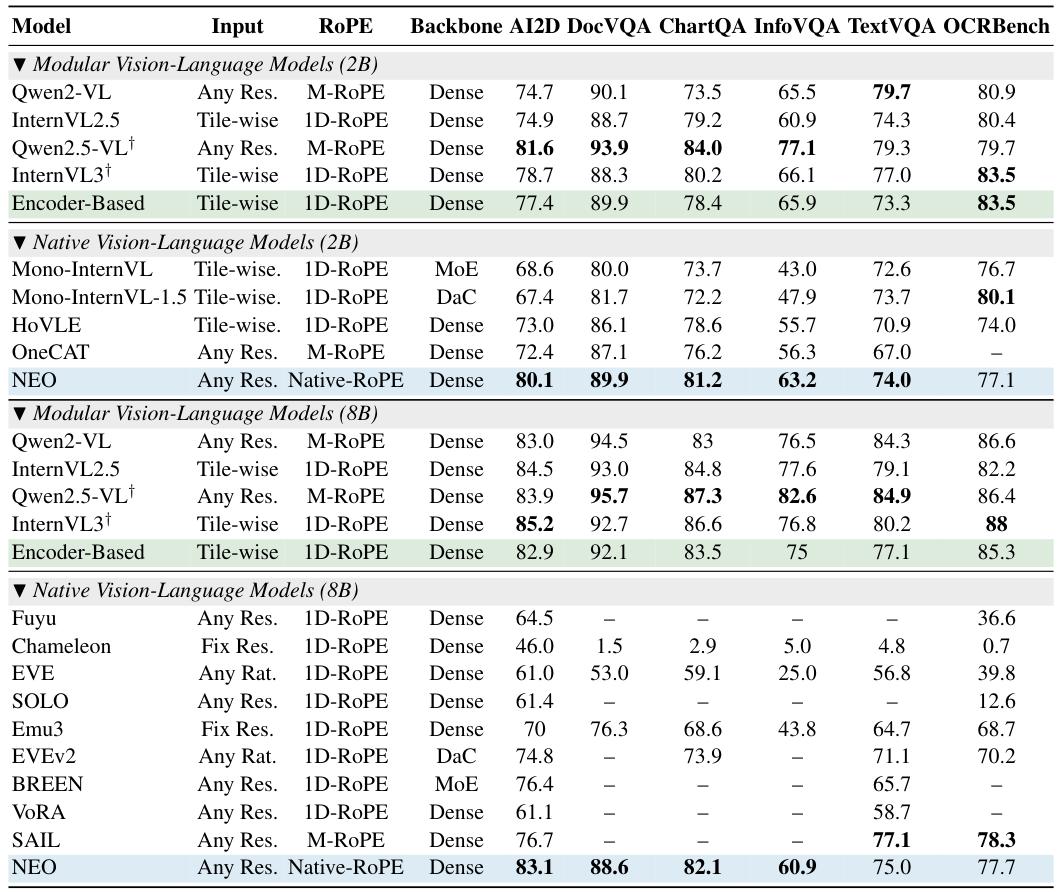
在极度依赖细粒度文本识别的任务上,如DocVQA,NEO-9B的表现甚至未能超过NEO-2.2B。
这暗示了当前的训练数据,特别是OCR数据的规模,可能仍不足以喂饱更大的原生模型。
NEO仅使用了3.9亿数据,而竞争对手通常使用数十亿数据。
这既证明了NEO的数据效率,也意味着它还有巨大的潜力等待通过扩大数据规模来释放。
NEO的出现是对多模态模型构建方式的一次重要修正。
它在工程上验证了多模态模型不需要拼凑。
通过精心设计的原生图元,特别是将空间编码与时序编码在底层物理结构上的解耦,模型可以在统一的架构内自然学会看和读。
NEO项目开源了一套可复用的原生图元组件。
未来的多模态研究或许将不再纠结于选择哪个视觉编码器,而是转向探索如何构建更纯粹、更统一的神经网络结构。
从像素到文字,NEO铺就了一条不再需要翻译官的直达之路。
参考资料:
https://github.com/EvolvingLMMs-Lab/NEO
https://huggingface.co/Paranioar
https://arxiv.org/abs/2510.14979
END