性能不减,吞吐量提升6.4倍!英伟达用混合算子和架构定义小模型新标准
NVIDIA最新的研究成果证明,在高性能计算设备上,越少的参数并不直接等同于越快的速度,真实的延迟取决于模型架构与硬件特性的深度契合。
NVIDIA 研究团队通过 Nemotron-Flash 系列模型,打破了业界长期以来对“深而瘦”架构的迷信,通过修正缩放定律、引入进化算法搜索混合算子以及改进训练策略,构建了一套面向真实设备延迟的全新设计哲学。
Nemotron-Flash 如何在算力为王的时代重新定义效率?
告别参数迷信,重构延迟物理学
长期以来,小型语言模型(Small Language Models)的设计陷入了一个思维定式,即只要减少参数数量,模型运行速度就会变快。
这种直觉在 CPU 或低端边缘设备上或许成立,但在 H100 GPU 这种并行计算怪兽面前,事情变得复杂起来。
NVIDIA 的研究人员发现,参数效率与延迟效率之间存在着巨大的鸿沟。
为了追求参数效率而设计的“深而瘦”模型,往往因为层数过多而导致严重的顺序依赖问题。
数据在深层网络中传输就像通过一道道安检,必须排队依次通过,这直接浪费了 GPU 强大的并行处理能力。
研究团队进行了一场反直觉的实验,他们构建了一系列深度从 6 层到 30 层不等的 Llama 架构模型,并在 A100 GPU 上进行了严格的延迟测试。
数据展示了一个残酷的事实:在相同的延迟预算下,层数较少但宽度较大的“矮胖”模型,往往比那些“深瘦”模型表现出更高的准确率。
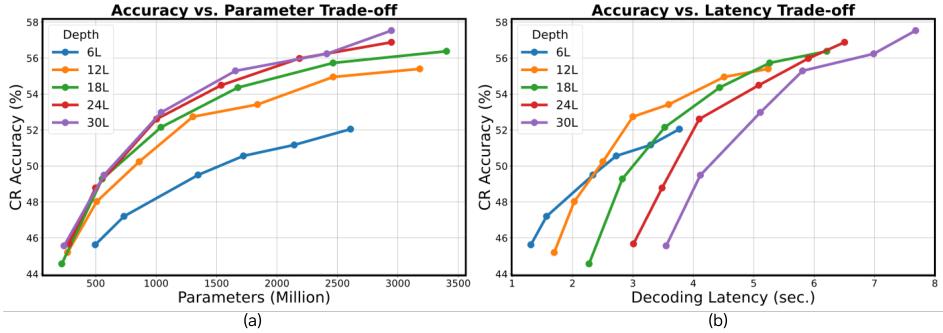
例如在 3 秒的延迟限制下,一个 12 层深的模型比 30 层深的模型更聪明。这直接挑战了 MobileLLM(移动大语言模型)等前作所推崇的设计准则。
为了将这一观察转化为可复用的科学定律,研究人员修正了经典的缩放定律(Scaling Laws)。
传统的定律只关注参数总量和数据量,而 Nemotron-Flash 的研究者将参数总量拆解为深度和宽度两个独立的变量。
他们提出了一个新的损失函数公式,允许在固定数据量的前提下,通过数学手段精确计算出深度和宽度对模型性能的边际效应。
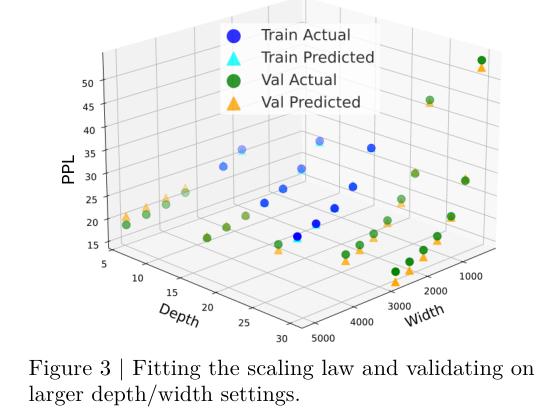
通过在小规模模型上进行拟合,研究者可以精确推导出在任意给定的延迟预算下,模型应该设计成多深、多宽才能达到最优的性能表现。
模型设计从经验主义走向了精确的工程计算,开发者不再需要盲目堆叠层数,而是可以根据目标硬件的物理特性,计算出那个完美的黄金深宽比。
混合算子的进化与选择
确立了模型的宏观身材之后,微观层面的算子选择成为了下一个突破口。
Transformer 架构的核心组件全注意力机制(Full Attention)虽然拥有完美的记忆能力,但其计算复杂度随着序列长度呈二次方增长,这在长文本处理中是致命的性能瓶颈。
学术界虽然提出了 Mamba 、RWKV、DeltaNet 等线性注意力机制试图解决这一问题,但这些线性算子往往在记忆回溯能力上表现不佳。
NVIDIA 的策略不再是单一算子的取舍,而是寻求混合架构的最优解。
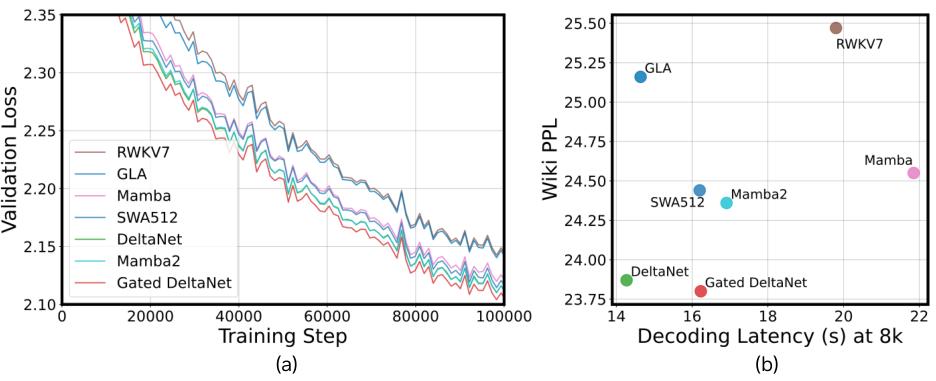
他们首先对现有的高效算子进行了地毯式的筛选和测试,将 Mamba2、GLA、DeltaNet、Gated DeltaNet 等新兴算子放入同一竞技场。
实验结果表明,DeltaNet 和 Gated DeltaNet 在语言建模任务上展现出了极高的潜力,而 Mamba2 虽然单打独斗稍逊一筹,但当它与 DeltaNet 结合时,两者之间产生了奇妙的化学反应,性能远超单一算子的简单叠加。
面对全注意力层、线性注意力层以及前馈神经网络(FFN)之间无数种可能的排列组合,人工试错显然是不现实的。
研究团队构建了一套基于进化算法的搜索框架,让算法自己去设计算法。
这个进化系统的核心在于一个关键发现:模型在训练初期的相对排名与最终训练完成后的排名具有高达 88.8% 的相关性。
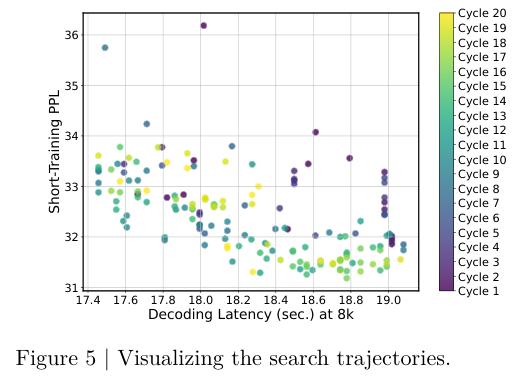
这意味着研究者可以用极短的训练时间作为代理指标,快速筛选出成千上万种架构设计的优劣。
经过多轮残酷的优胜劣汰,进化算法最终收敛出了一种交错式的混合架构。
Nemotron-Flash 采用了独特的模块化设计,将 DeltaNet、Mamba2 和全注意力层交织在一起。
具体的结构呈现出一种精密的韵律感:第一个模块块由 DeltaNet 和 Mamba2 交替组成,负责高效的信息吞吐;第二个模块块则引入了全注意力层,与 Mamba2 配合,确保模型在处理关键信息时拥有足够的记忆锚点。
这种由算法自动搜索出的结构,在保留了 Transformer 强大记忆力的同时,极大地释放了线性算子的速度优势。
拥有了优秀的骨架和器官,还需要高效的血液循环系统来维持模型的生命力。
在深度学习训练中,权重矩阵的数值往往会随着训练的进行而不断膨胀,这会导致梯度更新的相对效能逐渐降低。
就像推动一个巨大的物体,同样的力气产生的位移会越来越小,导致模型在训练后期的收敛速度变慢,精度难以进一步提升。
针对这一顽疾,NVIDIA 引入了权重归一化(Weight Normalization)技术。
这项技术的核心思想非常简洁有力:在每一次参数更新之后,强制将所有权重矩阵投影到一个单位球面上。
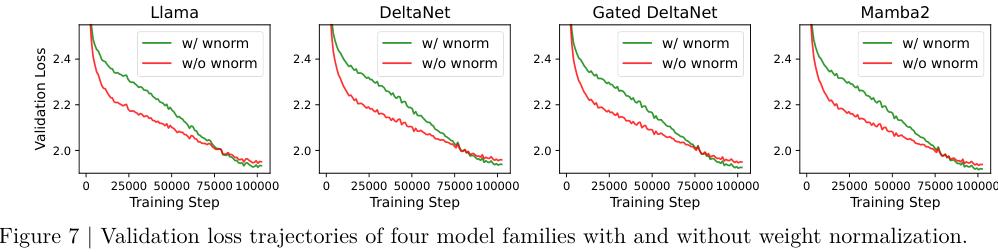
虽然未归一化的模型在训练初期因为步长不受限而下降较快,但引入权重归一化的模型在训练后期展现出了极强的韧性,收敛曲线更平滑、更低,最终的常识推理准确率提升了约 1.2%。
这不仅提升了单一任务的指标,更重要的是增强了模型在不同任务间的泛化能力,且相比于 nGPT(归一化 Transformer)等复杂方案,这种方法几乎不增加额外的计算开销。
除了权重归一化,Nemotron-Flash 还解决了一个线性注意力机制固有的缺陷。
线性算子依赖于一个隐状态来传递历史信息,但在解码的起始阶段,这个状态是空的,导致模型在处理开头几个 Token(词元)时往往处于一种“冷启动”的迷茫状态。
研究团队巧妙地引入了元 Token(Meta Tokens)机制,在输入序列的最前端强行插入一组可学习的虚拟 Token。
这些 Token 不代表任何实际含义,它们唯一的作用就是为线性算子提供预热,初始化内部的隐状态。仅需增加 256 个这样的元 Token,就足以让模型在处理长文本时迅速进入状态,显著提升了语言建模的稳定性。
性能基准的全面碾压
集成了上述所有创新技术,Nemotron-Flash 家族推出了 1B 和 3B 两个版本,其性能表现令人印象深刻。
研究团队不仅在传统的准确率指标上进行了测试,更引入了严格的延迟和吞吐量基准,确保数据能够反映真实部署环境下的表现。
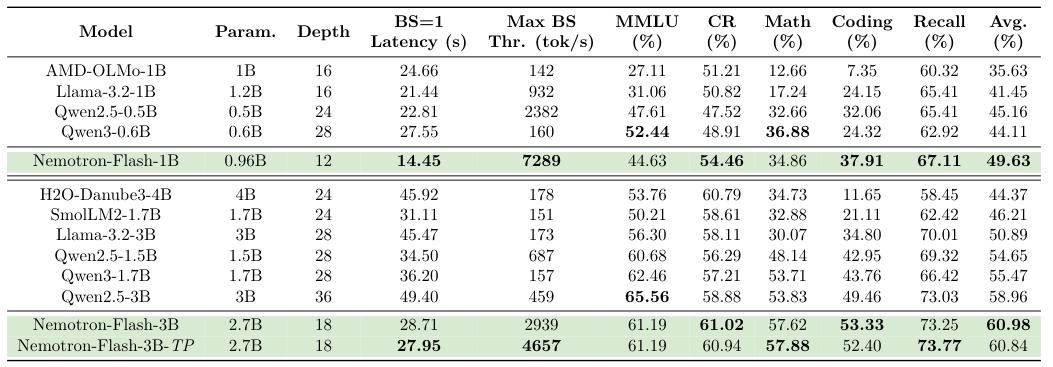
在与同级别模型 Qwen2.5-3B(千问)的对比中,Nemotron-Flash-3B 展现出了全方位的优势。
在 MMLU(大规模多任务语言理解)测试中两者旗鼓相当,但在更考验逻辑能力的数学和代码任务上,Nemotron-Flash 取得了显著领先,数学准确率达到了 57.62%,而对手仅为 48.14%。
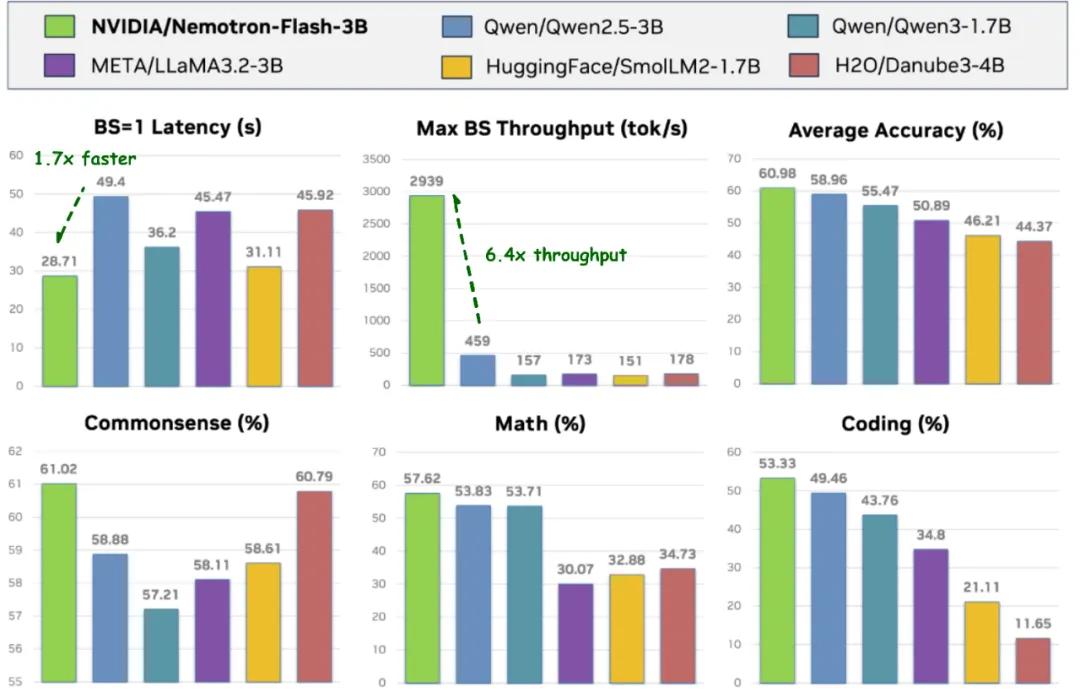
更具颠覆性的是速度层面的数据,Nemotron-Flash-3B 的最大吞吐量达到了惊人的每秒 2939 个 Token,是 Qwen2.5-3B 的 6.4 倍。
在单 Batch(批次)延迟测试中,其 28.71 毫秒的响应速度也远超同类产品。
为了探索性能的物理极限,研究团队还进行了一项关于注意力配置的消融实验。
全注意力层虽然重要,但也是显存和计算资源的最大消耗者。
实验测试了将大部分全注意力层替换为滑动窗口注意力(SWA)后的效果。
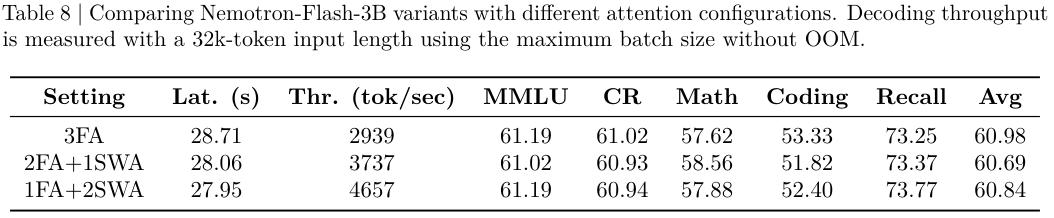
结果显示,当模型被配置为“1FA + 2SWA”(即全模型仅保留一层全注意力,其余为滑动窗口)时,吞吐量飙升至每秒 4657 个 Token,同时在常规基准测试中的准确率几乎没有损失。
这一发现为那些对速度有极端要求的应用场景提供了极具价值的参考配置。
此外,Nemotron-Flash 采用了类似于 Qwen 的大词表 Tokenizer(分词器)。
这是一个常被忽视的延迟优化细节,较大的词表意味着同一个句子被切分成的 Token 数量更少,从而直接减少了模型需要处理的序列长度。这种系统级的工程优化思维贯穿了 Nemotron-Flash 设计的全过程。
Nemotron-Flash 向业界证明,优秀的模型不应仅仅停留在论文的参数表上,更应运行在真实的芯片之中。
通过对硬件特性的深刻理解,结合进化算法的自动搜索和训练策略的数学优化,NVIDIA 成功打造出了一款既聪明又极速的混合架构模型。
参考资料:
https://arxiv.org/abs/2511.18890
https://huggingface.co/nvidia/Nemotron-Flash-1B
https://huggingface.co/nvidia/Nemotron-Flash-3B
END