两个LLM互相对线,推理能力起飞:康奈尔团队发布大模型版类GAN训练法
大型语言模型(LLMs)虽然通过可验证奖励的强化学习(RLVR)取得了显著进展,但仍然在很大程度上依赖外部监督(例如人工标注的数据)。自博弈(self-play)提供了一种有前景的替代方案,使模型能够通过与自身反复对抗来学习,从而减少对外部监督的依赖。GAN 则提供了另一种更具吸引力的训练范式:通过对抗式地训练两个模型,其中一个模型专注于生成具有挑战性的任务或对抗样本,另一个模型则专注于解决这些任务。
于是问题来了:LLM 是否也可以像 GAN 一样进行训练?我们的希望是,通过赋予每个模型不同的专门化角色,可以促进持续的竞争与共同进化,从而让它们能够解决单一模型可能从根本上无法胜任的任务。
为解决这一难题,来自康奈尔大学的 NLP 团队提出了PasoDoble ,一个面向大语言模型的全新类 GAN 训练框架。PasoDoble 通过对抗式地训练两个几乎相同的模型:Proposer 用于生成带有标准答案的高难度问题,Solver 则尝试解决这些问题。我们进一步利用高质量的数学预训练语料,并引入离线训练范式,以缓解潜在的训练不稳定性。值得注意的是,PasoDoble 在整个训练过程中不依赖任何监督信号。
论文题目:Better LLM Reasoning via Dual-play
论文链接:https://arxiv.org/pdf/2511.10395
项目主页:https://hcy123902.github.io/PasoDoble/
作者介绍:共同一作张正鑫,黄诚瑜为康奈尔大学计算机系博士,李奡翀为主要贡献者之一,Claire Cardie 为通讯作者以及导师。
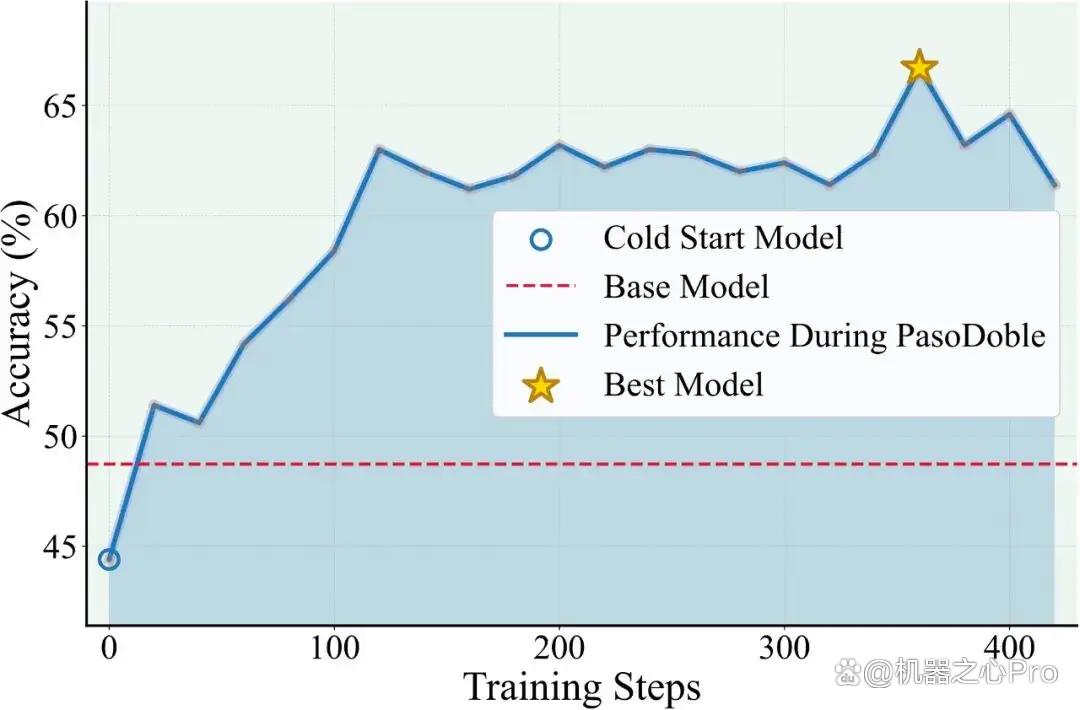
图为使用 Qwen3-1.7B 在 MATH-500 上评估的 Solver 在不同训练步骤中的训练动态。Solver 的整体准确率在无任何监督的情况下从 45% 提升至 67%。它在第 20 步之前就超过了基线模型,并在第 360 步达到最高的 67%。重要的是,PasoDoble 能够在数百个更新步骤中保持持续提升,展现出远强于相关工作 R-Zero 的扩展能力。
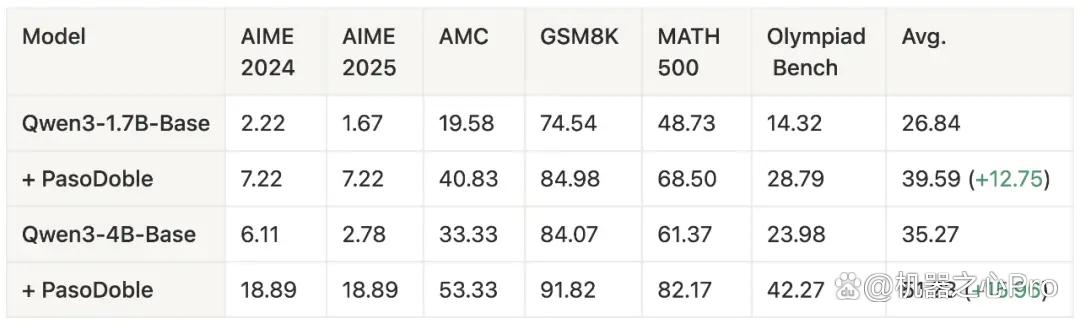
我们为每个问题采样六个回答,并报告 pass@1 的准确率。基线模型按照 Qwen 技术报告中的设置,使用 4-shot 提示进行评估;其他模型则使用 0-shot 提示进行评估。
我们发现,在完全无监督的情况下,PasoDoble 使 Qwen3-1.7B-Base 的数学任务平均性能提升约 13 个点,使 Qwen3-4B-Base 提升约 16 个点。
PasoDoble 方法概览
PasoDoble 由四个组件构成:Proposer (π_p)、Solver (π_s)、Knowledge Base (K),以及用于离线训练的题目缓冲区(Question Buffer)。Proposer 和 Solver 均从同一个预训练模型初始化,随后会进行初始的冷启动训练。
在在线训练中,每次迭代都会从知识库中采样一个知识片段(1),用于提示 Proposer 生成一批问答(QA)对(2)。随后,Solver 会针对每个问题生成多个解答尝试(3–4)。Solver 根据其答案是否与 Proposer 的标准答案一致来获得正确性奖励(5)。为评估问题的难度,我们计算 Solver 在该问题上的准确率(6),并将 Proposer 的难度奖励定义为该准确率的反比(7);同时,还会加入一个多样性奖励以鼓励生成新颖的问题(8)。这些奖励被组合得到 Proposer 的最终奖励(9)。只有那些具有非平凡难度、被判定为有效的问题才会被保留下来用于 Solver 的训练(10)。当至少存在一个有效问题时,两个模型都会同步更新(11),从而形成完整的在线训练循环。
在离线训练中,Proposer 会在 Solver 冻结的情况下首先更新若干步(11),并将生成的有效问题存入 Question Buffer(12)。随后,将 Proposer 冻结,Solver 则利用 Question Buffer 中的问题进行更新(13),从而构建其训练数据集。
Proposer Reward 是如何设计呢?
简而言之,Proposer 会因为生成困难(即 Solver 准确率低)且 多样(与近期问题不相似)的问题而获得奖励,但前提是这些问题是有效且格式良好的。
Proposer 的任务是生成既具有挑战性又多样化的数学问题。为引导这种行为,我们设计了一个由 难度 reward 和 多样性 reward两部分组成的 reward 机制。
1. 难度 Reward
我们希望 Proposer 能生成有挑战性的问题 —— 即 Solver 不能轻易答对的问题。我们用 Solver 的通过率来衡量难度:
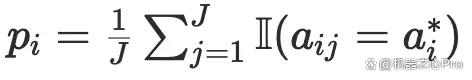
通过率 p_i 越低,问题越难,奖励就越高。具体地,难度奖励为:
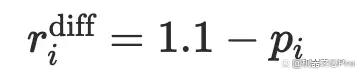
即使一个问题非常简单(例如 p_i = 1.0),奖励仍然为 0.1,以确保 Proposer 始终倾向于生成有效的问题,而不是生成错误或无意义的问题。
2. 多样性 Reward
我们还希望避免退化现象,例如 Proposer 反复生成同一种类型的问题。为此,我们将新生成的问题 q_i 与历史缓冲区 H 中的最近问题进行比较,采用 Jaccard 相似度:
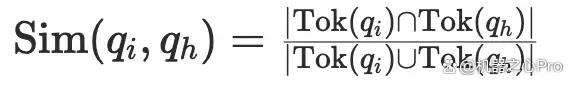
如果两个问题过于相似,我们将其视为重复:
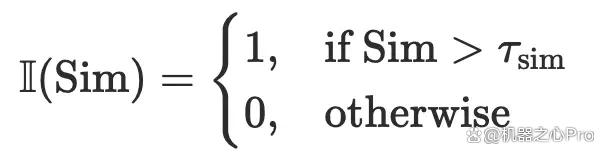
因此,多样性奖励定义为:
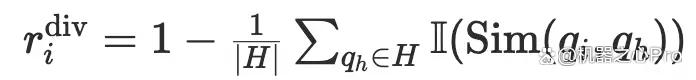
简而言之:问题越独特,奖励越高。
3. Proposer 最终奖励
我们只有在问题既有效又具有多样性的情况下才会对 Proposer 进行奖励:
有效性(Validity):通过率不能过低:
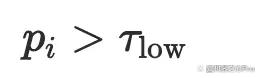
多样性(Diversity):不能过于重复:
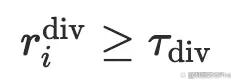
最终奖励为:
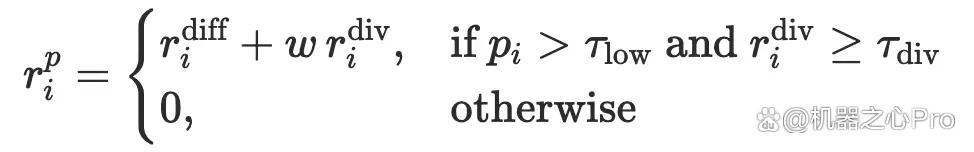
Solver Reward 是如何设计呢?
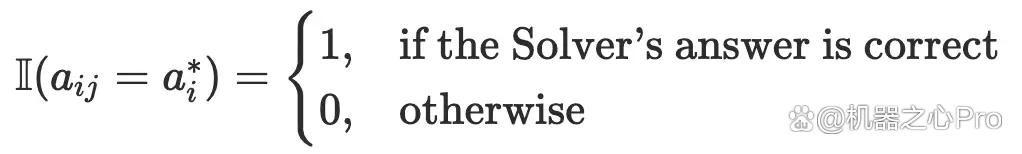
Solver 的训练仅依赖纯正确性奖励。
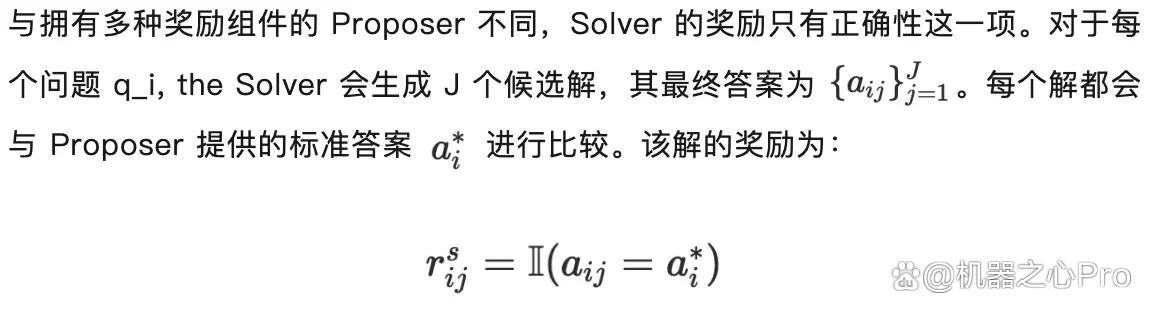
其中指标函数定义为:
实验设置
我们在多种模型规模上进行实验,包括 Qwen3-0.6B-Base、Qwen3-1.7B-Base、Qwen3-4B-Base、Qwen2.5-0.5B-Base、Qwen2.5-1.5B-Base 和 Qwen2.5-3B-Base,将它们分别用作 Proposer 和 Solver,然后执行冷启动训练。在冷启动之后,我们使用 GRPO 同时训练 Proposer 和 Solver,并在在线与离线两种设置下进行实验。更多超参数设置参见论文附录 B。我们使用 MegaMath-Pro-Max 预训练数据集作为知识库 K。
实验结果
主流数学 benchmark 的结果
我们在竞赛级数学基准上评估了我们的方法,包括 AIME 2024、AIME 2025、AMC、GSM8k、MATH-500 和 OlympiadBench。加粗表示最佳结果,下划线表示第二优。
PasoDoble 能显著提升模型在数学基准上的表现,尤其是在 Qwen2.5-1.5B/3B 和 Qwen3-1.7B/4B 模型上。此外,PasoDoble 的性能提升随着模型规模的增大而持续增强。
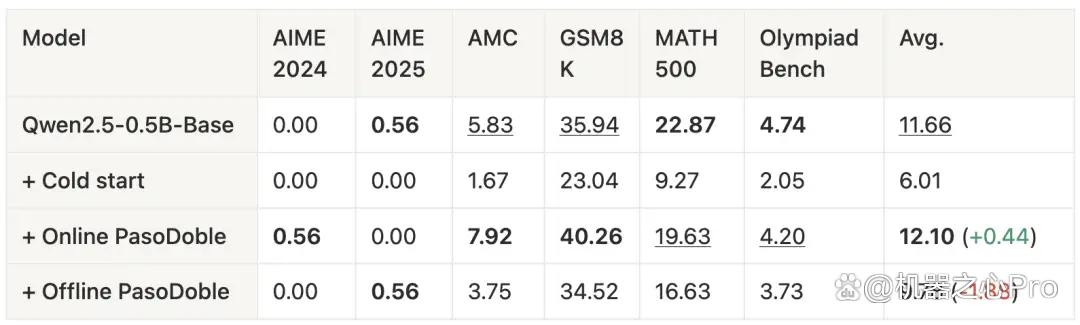
Qwen2.5-0.5B-Base 模型的实验结果。
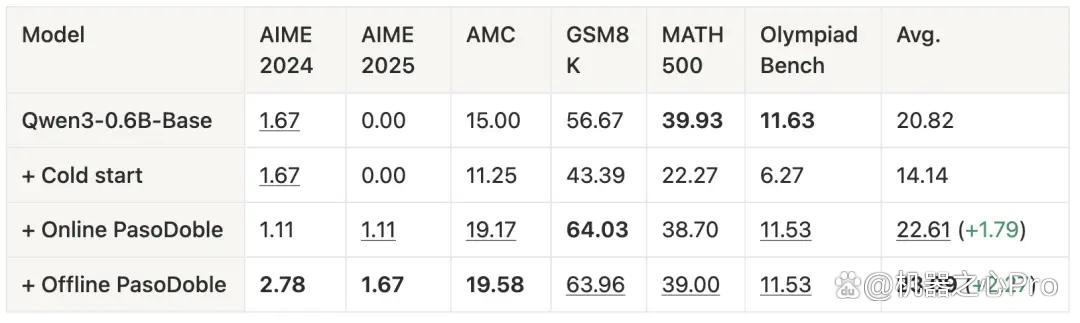
Qwen3-0.6B-Base 模型的实验结果。
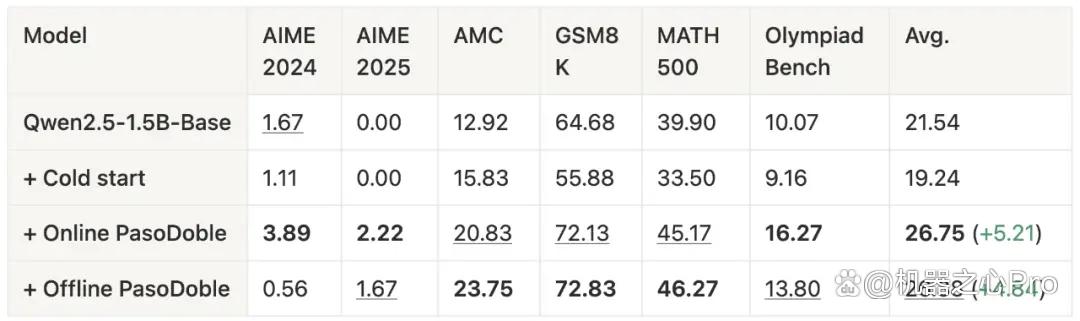
Qwen2.5-1.5B-Base 模型的实验结果。
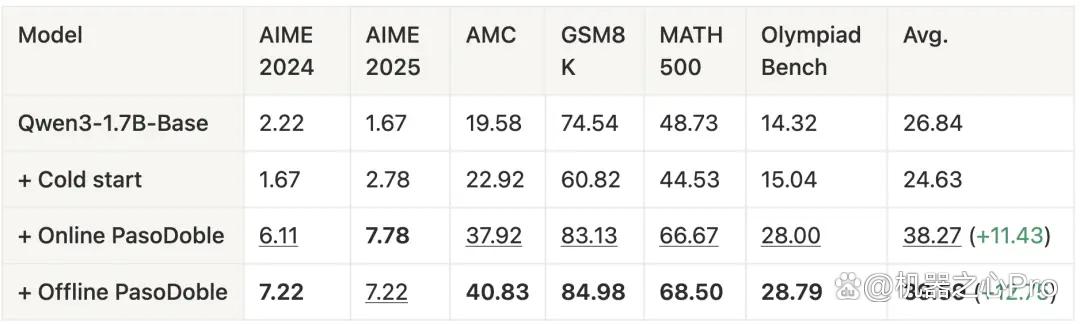
Qwen3-1.7B-Base 模型的实验结果。
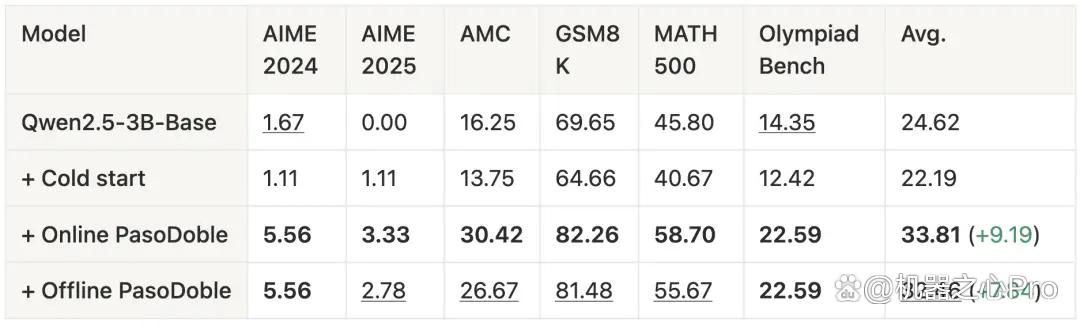
Qwen2.5-3B-Base 模型的实验结果。
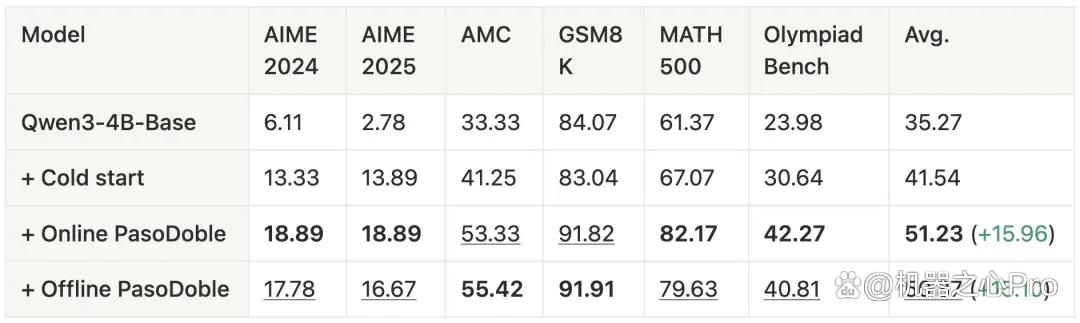
Qwen3-4B-Base 模型的实验结果。
Proposer 与随机奖励:Solver 到底学到了什么?
先前的研究表明,即使使用随机奖励也可能带来非平凡的提升。因此,我们在 Qwen3-1.7B 模型上采用在线训练范式进行了相关实验。
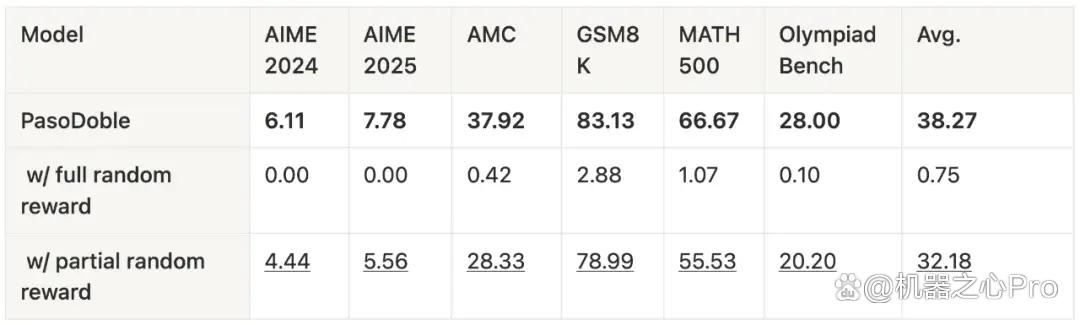
随机奖励的实验结果。
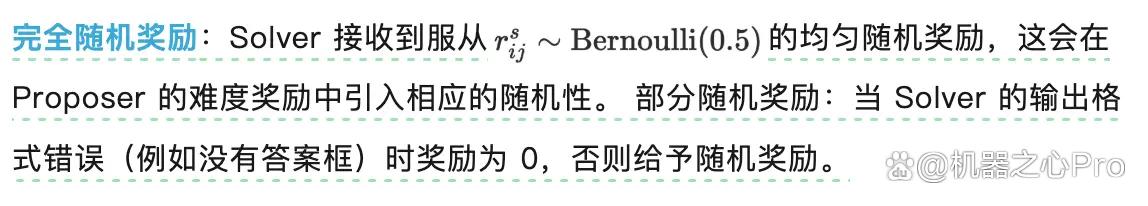
如上表所示,使用完全随机奖励进行训练会使 Solver 在所有数学基准上的平均准确率几乎跌至零。即便我们强制 Solver 以正确格式作答(部分随机奖励),其准确率仍然大幅下降。与我们原始设置形成的鲜明对比清楚地表明:Solver 在训练过程中确实从 Proposer 的答案中受益匪浅。
Proposer 生成的问题是由记忆驱动的,还是由推理驱动的?
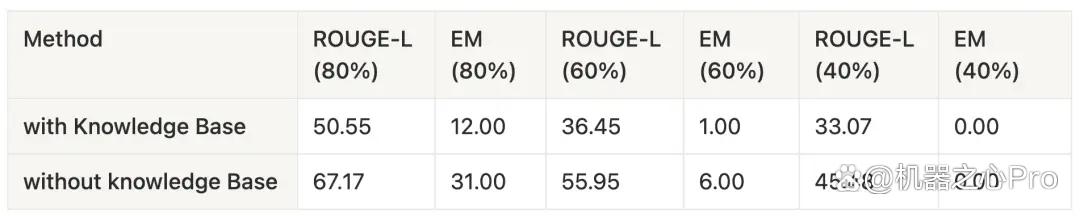
Qwen3-1.7B-Base 在不同提示前缀比例下(即 x% 表示向 Qwen3-1.7B-Base 提示前 x% 的 问题 )对 Proposer 在第 200 个检查点生成的问题进行评估,其 Exact Match(EM)和 ROUGE-L得分如上所示。所有评估均使用贪心解码,并且不使用聊天模板。
我们通过上表进行了分析。即使提示问题前缀重叠达到 80%,EM 也仅约为 12%(使用知识库)和 31%(不使用知识库),这表明绝大多数生成的问题来源于推理而非记忆。
总结
我们的研究表明,大语言模型可以通过类似 GAN 的双模型对抗式训练来提升数学推理能力,并在多个数学基准上取得可量化的性能提升。该方法还通过利用预训练知识增强后训练效果,在预训练与后训练之间建立了一座桥梁。
尽管如此,我们的方法也存在局限性,例如在 GPQA 等领域外任务中并未带来性能提升。未来的研究将探索将该框架拓展到其他领域,如代码与事实问答,并进一步研究更广泛的多模型训练范式,包括协作式、竞争式以及角色专门化等设置。这些方向可能对于解决远比单一模型能可靠处理的任务更加复杂的问题至关重要。
参考文献:
[1] Goodfellow, Ian, et al. "Generative adversarial networks." *Communications of the ACM* 63.11 (2020): 139-144.
[2] Huang, Chengsong, et al. "R-Zero: Self-Evolving Reasoning LLM from Zero Data." *arXiv preprint arXiv:2508.05004* (2025).
[3] Yang, An, et al. "Qwen3 technical report." *arXiv preprint arXiv:2505.09388* (2025).
[4] Shao, Zhihong, et al. "Deepseekmath: Pushing the limits of mathematical reasoning in open language models." *arXiv preprint arXiv:2402.03300* (2024).
[5] Wang, Zengzhi, et al. "Octothinker: Mid-training incentivizes reinforcement learning scaling." *arXiv preprint arXiv:2506.20512* (2025).
[6] Shao, Rulin, et al. "Spurious rewards: Rethinking training signals in rlvr." *arXiv preprint arXiv:2506.10947* (2025).
[7] Lin, Chin-Yew, and Franz Josef Och. "Automatic evaluation of machine translation quality using longest common subsequence and skip-bigram statistics." *Proceedings of the 42nd annual meeting of the association for computational linguistics (ACL-04)*. 2004.