复旦和阶跃让你无限分身:WithAnyone实现高保真、有灵魂且身份一致的单人或多人图像生成
复旦大学和阶跃AI发布了一个人物图像一致性编辑模型WithAnyone。
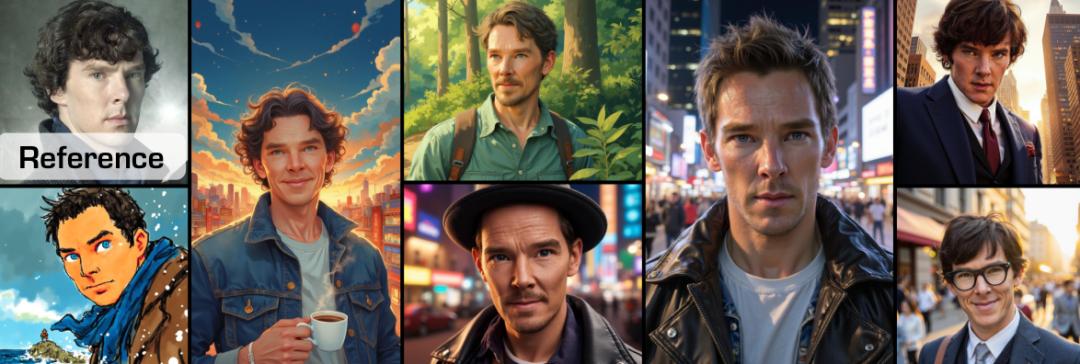
能让你实现无限分身,而且表情自然可跟随情景控制变化。
单人:
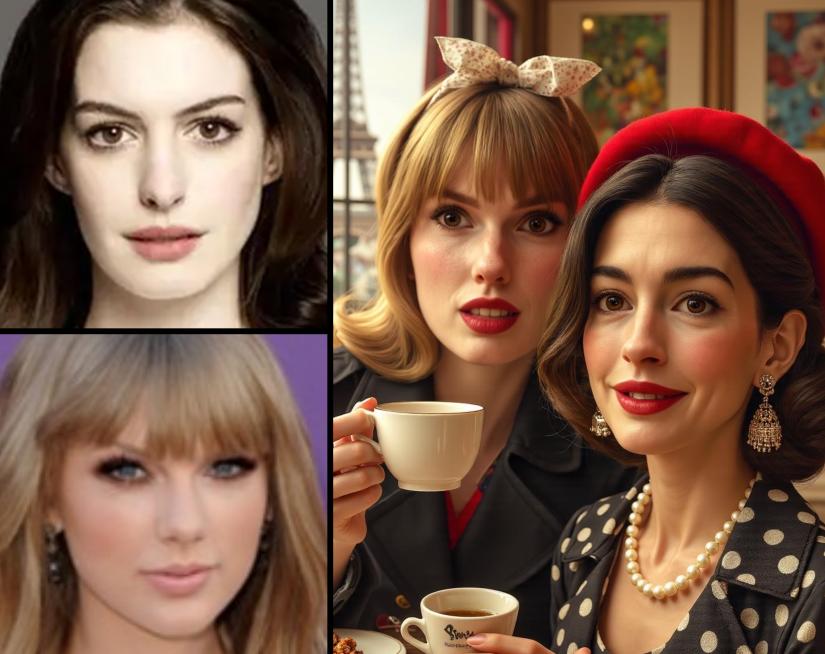
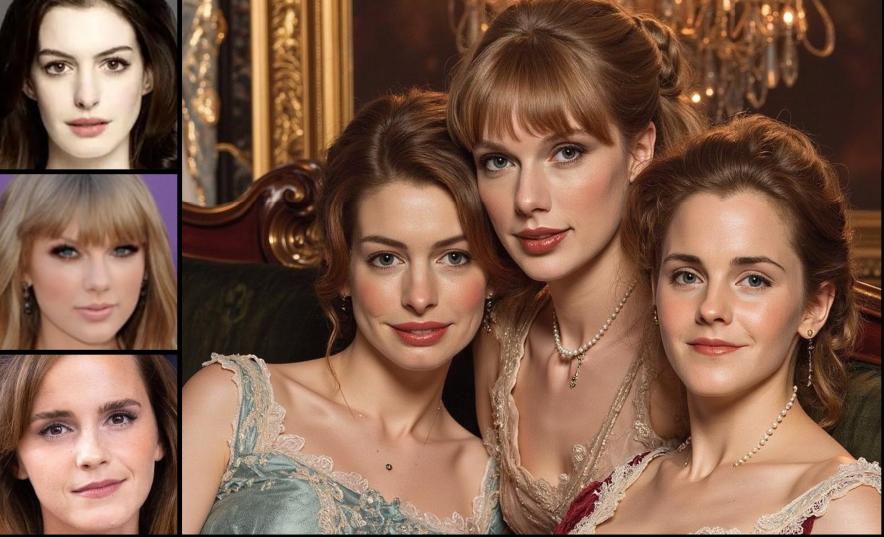
多人:
玩AI生图的人都知道,AI在生成图像,特别是人像参考方面,已经达到了令人惊叹的水平。
你给它一张参考照片,它就能生成一张看起来几乎一模一样的人脸。
但这种完美的相似性,正成为一个新的瓶颈。比如PuLID,InstantID等,表情生硬且无法泛化,生成多少图都是一个复制粘贴的脸,完全没有灵魂。
当保真度高到一定程度后,反而会弄巧成拙。
在现实世界中,同一个人在不同照片里的样子,会因为姿势、表情、妆容和光线等因素而有很大差异。
一个微笑的你和一个沉思的你,面部特征的相似度会有自然的浮动。
许多生成模型对参考图像的还原,远比这种自然变化要严格得多。
它们过度优化了相似性,代价是牺牲了那些本应存在的、合理的、生动的变化。
这就导致了一种普遍的失败模式,我们称之为复制粘贴伪影。
模型并没有真正理解一个人的身份特征,并以一种灵活可控的方式重新合成,而更像是在做一个精细的抠图和粘贴工作。
它把参考图像中的人脸,几乎原封不动地搬到了新的图像中。
这种模式极大地损害了模型的可控性,限制了生成图像的表现力,也削减了其实际应用价值。
想象一下,你上传一张自己面无表情的照片,然后输入提示词一个正在开怀大笑的人。
结果,模型生成了一张背景不同、但脸上依旧毫无表情的你。它无法违背参考照片提供的指令,无法创造出新的、符合要求的表情。
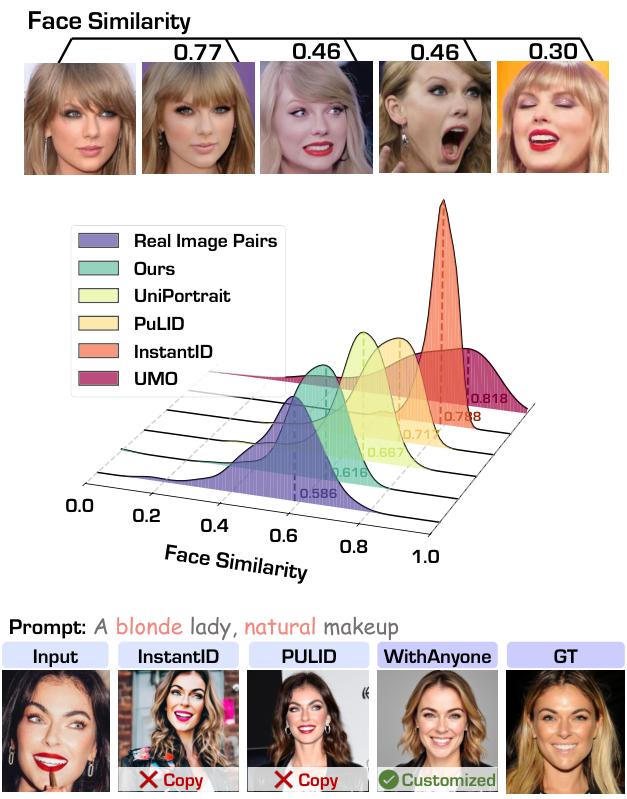
当提示词要求一位金发女士,化着淡雅的自然妆时,如果参考照片是浓妆,这些模型大概率会直接复制浓妆的特征,而不是生成一张符合描述的新图像。
它们擅长复制,却不擅长创造。
问题的根源:缺失的数据拼图
为什么会出现这种普遍的复制粘贴现象?
根本原因在于训练数据的匮乏。
虽然现在有许多大规模的人脸数据集,但它们并不适合用于训练可控的多身份生成模型。
关键在于,几乎没有哪个数据集能为每个身份都提供配对参考——也就是同一个人在不同表情、姿势、发型和视角下的多张图像。
数据的缺失,迫使大多数研究者只能采用一种基于重建的训练方式。简单来说,就是让模型学习输入A,输出A。参考图像和目标图像是同一张。
这种训练方式,本质上就是在鼓励模型去复制。模型学到的最优解就是:把输入原封不动地搬到输出,就能得到最高分。日积月累,模型就养成了复制粘贴的坏习惯,加剧了问题的产生。
为了从根源上解决这个挑战,研究者们构建了一个全新的、大规模的、开源的多身份数据集:MultiID-2M。
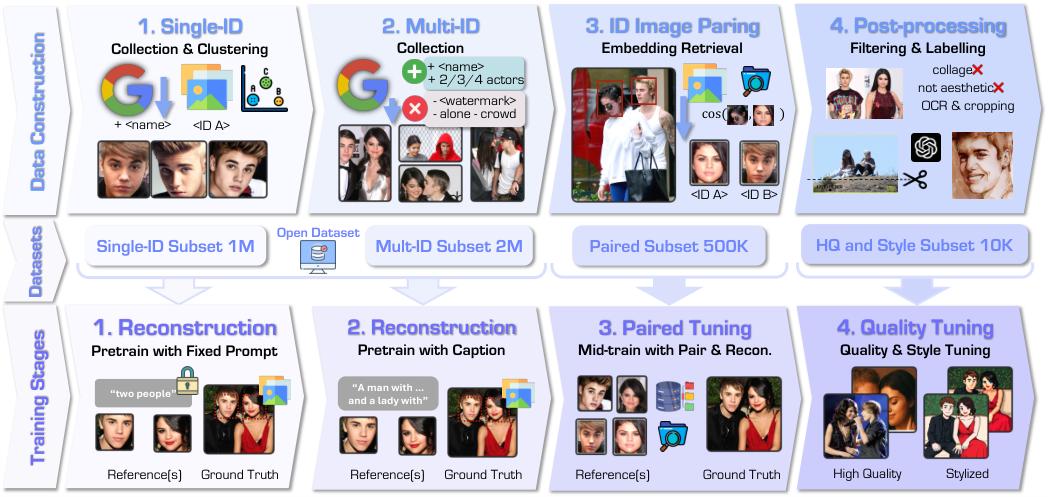
这个数据集的构建过程,堪称一个系统工程,分为四个阶段:
单身份数据的收集与聚类。团队基于身份相似性,从网络上收集并聚合了大量单个名人的照片。这确保了数据集中每个身份都有足够多的素材。
多身份数据的收集。团队有针对性地搜索包含多位名人的群组照片。他们使用期望的名人姓名和一系列负面关键词(例如,雕像、卡通、模仿者等)来过滤搜索结果,确保搜集到的是真实人物的合影。
身份图像的配对。这是最关键的一步。团队通过先进的嵌入检索技术,在海量的单人照片和多人合影之间,精准地匹配人脸。这就像一个超级人脸识别系统,能在一张合影中认出某个人,并从单人数据库中找到他或她的其他所有照片,从而建立起配对关系。
后处理。对所有数据进行严格的过滤和标注,剔除低质量、模糊或不相关的图像,确保最终数据集的纯净度和高质量。
最终诞生的MultiID-2M数据集,包含了50万张含有1到5位可识别名人的群组照片。对于其中的每一位名人,都提供了数百张个人图像作为配对参考,这些个人图像涵盖了极其丰富的表情、发型和视角变化。
除此之外,数据集中还包括150万张没有配对参考的群组照片,以增加场景的多样性。
整个数据集总共覆盖了约25,000个独特的身份,这些身份具有多样化的国籍和种族背景,为训练一个真正强大且无偏见模型提供了坚实的基础。
一把新尺子:如何科学地衡量复制粘贴
有了合适的数据,还需要一个科学的评估标准。
如果评价体系本身就奖励复制粘贴,那么模型自然会朝那个方向优化。
为了系统性地评估多身份图像生成方法,研究者提出了一个统一的群组照片生成基准:MultiID-Bench。
这个基准从训练数据中精心挑选了435个测试案例,这些案例中的身份通常是比较罕见或长尾的,更能考验模型的泛化能力。
每个案例都包含一张真实的群组照片(Ground Truth,简称GT)、照片中每个人的单张参考图像(作为模型的输入),以及一句描述这张真实照片场景的文本提示。
评估的核心在于身份保真度和生成质量。
用r、t、g分别代表参考图像、目标真实图像(GT)和模型生成图像的人脸嵌入向量。两个嵌入向量之间的相似度用Sim(a,b)表示。
特别定义了两个关键指标:
SimRef:生成图像与参考图像的相似度。
SimGT:生成图像与目标真实图像的相似度。
过去的研究大多只报告SimRef。这带来一个严重的问题:它会无意中偏爱复制粘贴。如果模型直接把参考图像的人脸复制过来,SimRef分数自然会很高,即使这完全违背了提示词中要求的姿势或表情变化。
相比之下,MultiID-Bench使用SimGT作为主要评判指标。
这个设计非常巧妙。它奖励的是对提示场景的忠实还原。当提示词要求生成一个与参考图姿势、表情不同的图像时,过度复制参考图反而会因为与真实目标图(GT)相差甚远而受到惩罚。
WithAnyone的诞生:为AI注入理解力
有了海量的高质量配对数据和科学的评估标准,研究者设计了WithAnyone模型,一个专为可控、高保真度的多身份生成而生的统一架构和训练方案。
其目标是超越简单的重建,实现对身份特征的稳健理解和合成。
WithAnyone的架构基于一个强大的模型FLUX。每个参考图像会经过两个编码器的处理:一个面部识别网络和一个通用的图像编码器。
面部识别网络负责提取能够区分身份的核心信号,也就是人脸的深层特征。
通用图像编码器则负责捕捉互补的中层特征,比如光照、皮肤纹理等。
一个非常关键的设计是,面部嵌入特征的作用范围被严格限制在图像中对应的人脸区域内。这确保了模型能够精确地捕捉身份特征,同时避免过度依赖参考图像中的低级细节,比如背景或特定的光斑。
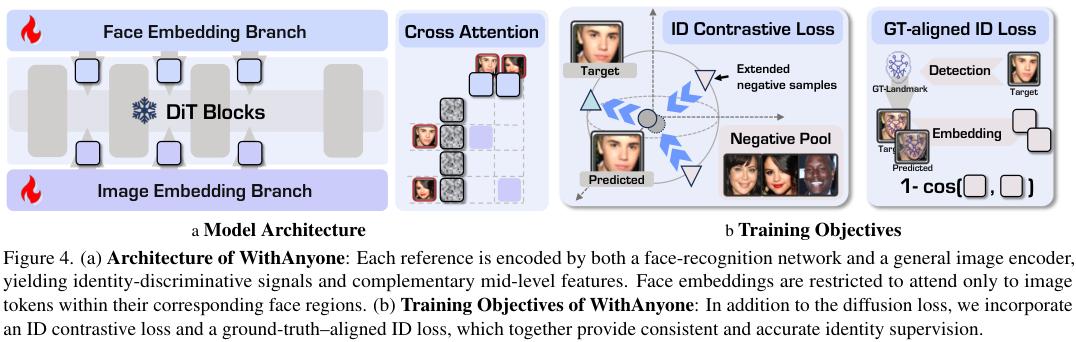
WithAnyone的训练核心,是三个协同工作的损失函数。
1,扩散损失 (Ldiff)
这是扩散模型的标准损失函数,负责最基本的图像生成任务。它通过不断去噪来学习如何从一个随机噪声图像,逐步生成一张清晰、真实的目标图像。
2,真实对齐的身份损失 (LID)
这是一个极其巧妙的创新。
为了计算身份相似度损失,模型需要提取生成人脸的特征,而这通常需要先检测面部的关键点(如眼睛、鼻子、嘴巴的位置)并进行对齐。
问题在于,在训练过程中,模型生成的图像是带有噪声的、不完整的。从这样的图像中提取关键点,结果非常不可靠。
WithAnyone提出了一种更高效、更准确的方法:直接使用真实目标图像(GT)的关键点,来对齐正在生成的带噪声图像。这样一来,无论噪声水平有多高,模型都能获得一个稳定且准确的对齐基准。
3,带扩展负样本的身份对比损失 (LCL)
为了进一步强化身份的独特性,研究者引入了身份对比损失。
这个损失函数的目标很明确:在特征空间中,将生成的图像g拉向其正确的参考图像r,同时将它推离其他所有不相关的身份。
得益于MultiID-2M数据集的庞大规模和清晰的身份标签,模型可以在每次计算时,从数千个其他身份中抽取负样本。
这种海量的、多样化的负样本,极大地提高了模型区分不同身份的能力。
复制粘贴伪影主要源于单一的重建式训练。为了打破这个模式,WithAnyone采用了一个循序渐进的四阶段训练管道。
使用固定提示的重建预训练。这个阶段使用完整的MultiID-2M以及其他一些人脸数据集,大约持续2万步。
使用完整标题的重建预训练。这个阶段旨在将身份学习与文本条件生成对齐,让模型理解如何根据文本来调整图像内容,同时保持身份。这个阶段持续4万步,结束后,模型的身份相似性指标达到峰值。
配对调整。这是打破复制粘贴模式的关键一步。在这一阶段,一半的训练样本被替换为从MultiID-2M中抽取的配对实例。
质量调整。这个阶段旨在提升生成图像的感知保真度,比如纹理细节、光影效果,并提高模型的风格鲁棒性和可迁移性,使其能够适应更多样的风格要求。
更高保真度,更少复制粘贴
实验结果有力地证明了WithAnyone的成功。
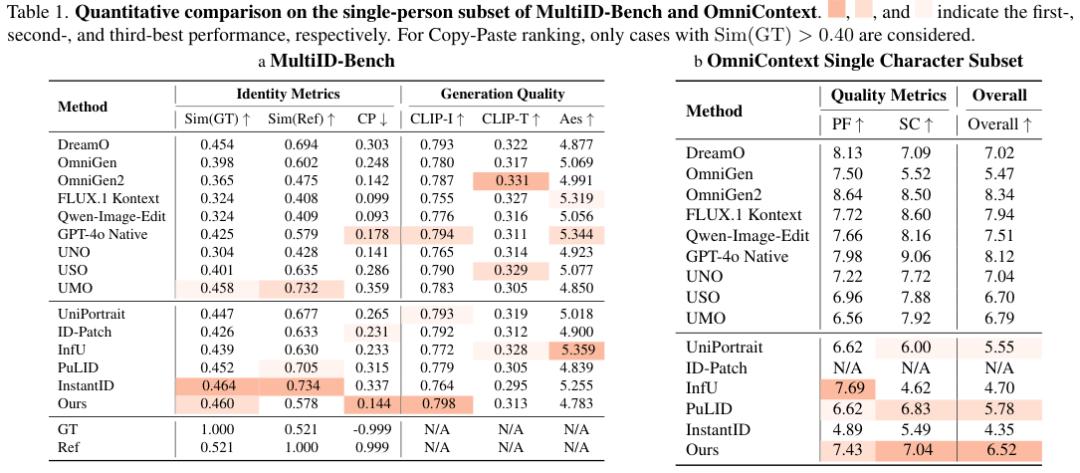
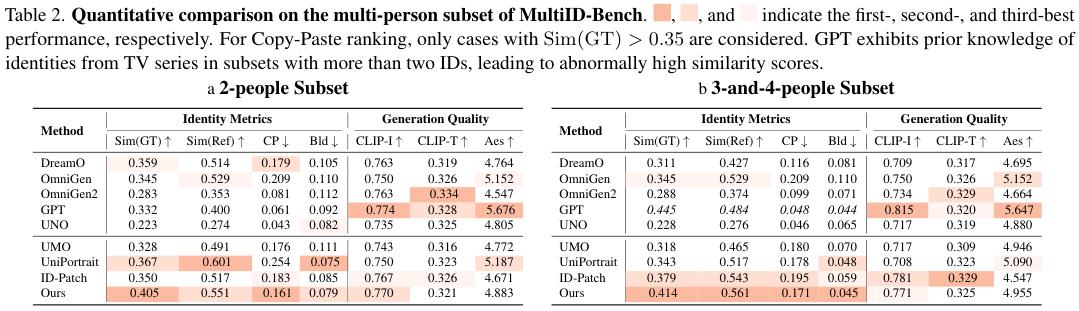
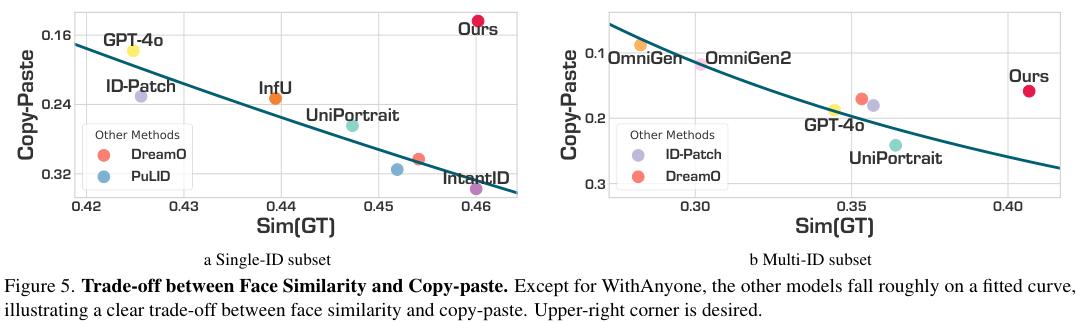
定量结果中,可以观察到一个非常明显的权衡关系。
对于绝大多数现有模型来说,更高的面部相似性(SimGT)几乎总是伴随着更强的复制粘贴伪影(MCP)。
它们似乎都落在一条回归曲线上,表明它们提高相似性分数的主要手段,就是更直接地复制参考人脸的特征。
WithAnyone显著地偏离了这条曲线。
它在所有模型中,实现了相对于真实目标(GT)最高的面部相似性,同时保持了极低的复制粘贴分数。
这说明WithAnyone成功地打破了保真度与复制之间长期存在的此消彼长的权衡。它学到的是如何合成身份,而不是复制身份。
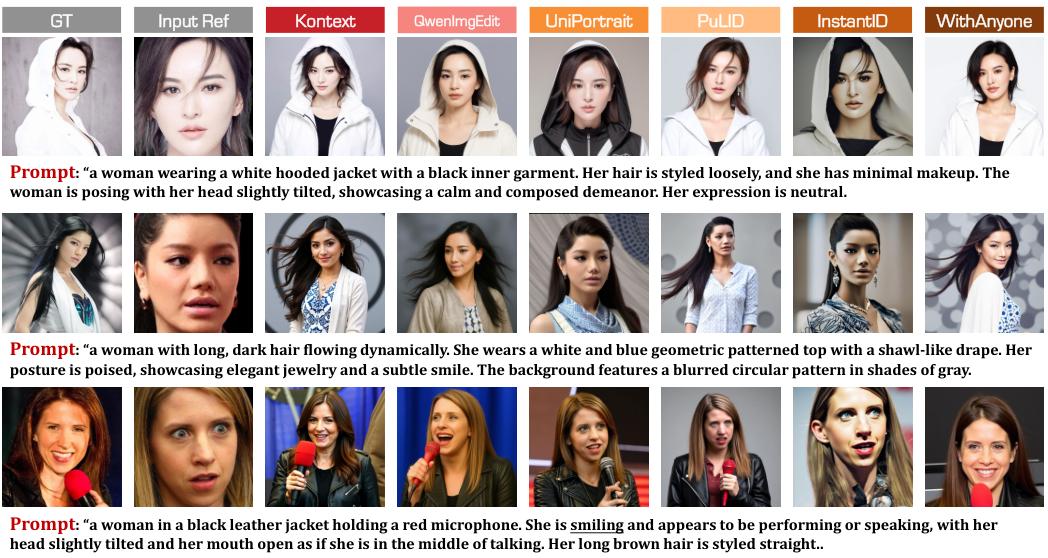
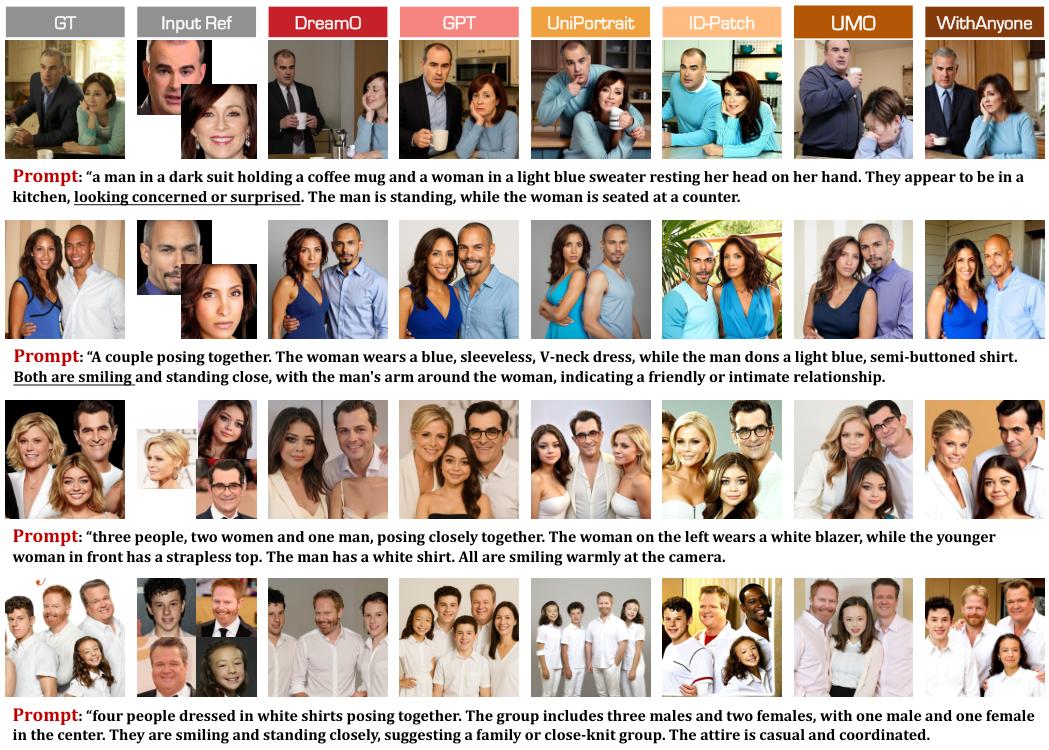
定性比较结果更加直观。
通用的定制或编辑模型,在保持身份一致性方面仍然存在明显短板。很多基于VAE(变分自编码器)的方法,要么产生严重的复制粘贴伪影,要么生成的人脸与目标身份相去甚远。
而专攻身份定制的模型,也难以摆脱复制粘贴的困扰。例如,当参考图像是中性表情时,它们很难根据提示让主体微笑,也经常无法调整头部姿势或眼睛的注视方向。
相比之下,WithAnyone生成的面部既灵活又可控,同时忠实地保留了核心的身份特征。无论是微笑、转头还是改变眼神,都能精准响应提示词的要求。
复制粘贴伪影是当前身份定制方法的一个常见枷锁,而过去的面部相似性度量,又通过隐式地奖励直接复制而加剧了这个问题。
WithAnyone通过一个全新的基准MultiID-Bench,首次识别并量化了这种失败模式,并提出了一套完整的解决方案。
研究者精心构建了大规模配对数据集MultiID-2M,并开发了能够明确抑制平凡复制的训练策略和损失函数。
WithAnyone在显著减少复制粘贴伪影的同时,保持甚至在许多情况下提高了身份相似性,从而打破了保真度与复制之间长期存在的权衡。
免费试玩:
https://huggingface.co/spaces/WithAnyone/WithAnyone_demo
参考资料:
https://github.com/Doby-Xu/WithAnyone
https://doby-xu.github.io/WithAnyone/
https://arxiv.org/abs/2510.14975
https://huggingface.co/WithAnyone/WithAnyone
https://huggingface.co/datasets/WithAnyone/MultiID-2M
https://huggingface.co/datasets/WithAnyone/MultiID-Bench
END