从DistServe到Rubin CPX:AI推理架构18个月的颠覆性演进
一篇学术论文,在18个月内,重塑了价值万亿的AI计算产业。
这个故事的核心,源于对一个根本问题的洞察:我们与大语言模型交互的每一瞬间,背后都隐藏着两种截然不同的计算任务,而传统方法却强迫它们在同一个舞台上共舞,造成了巨大的资源浪费与性能瓶颈。
故事的主角是来自加州大学圣迭戈分校(UCSD)Hao AI实验室的DistServe架构,它提出的预填充-解码分离思想,如同一把锋利的手术刀,精准地切开了这个困扰业界已久的难题。
一个根植于物理现实的矛盾
当我们向一个聊天机器人输入一个问题时,比如请帮我总结一下《百年孤独》的主要情节,直到它吐出第一个字之前,系统正在执行一个叫作预填充(Prefill)的繁重任务。
这个阶段,GPU需要处理我们输入的全部提示词,进行一次复杂且庞大的矩阵运算,这是一个纯粹的计算密集型(Compute-bound)工作。
它的速度,取决于GPU核心能提供的原始算力有多强,也就是每秒能进行多少次浮点运算。
在这个阶段,GPU的算力被发挥到极致,但其内存带宽的利用率却相对较低。
一旦第一个字,比如“百”生成后,系统就进入了解码(Decode)阶段。
解码是一个自回归的过程,模型会把“百”作为新的输入,去预测下一个字“年”…… 如此循环往复,一个字一个字地生成。这个过程的计算量远小于预填充,因为每次只处理一个新生成的令牌(Token)。
此时,性能的瓶颈不再是算力,而是内存带宽(Memory-bound)。
系统需要频繁、高速地读写一个名为键值缓存(Key-Value Cache, KV Cache)的关键数据。
这个缓存里存储了之前所有内容的上下文信息,模型需要靠它才能理解接下来要生成什么。解码阶段的流畅度,几乎完全取决于GPU显存与计算核心之间数据传输的速度。
预填充需要强大的大脑(算力),解码需要宽阔的神经通路(内存带宽)。
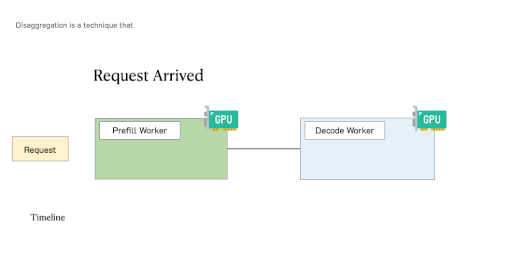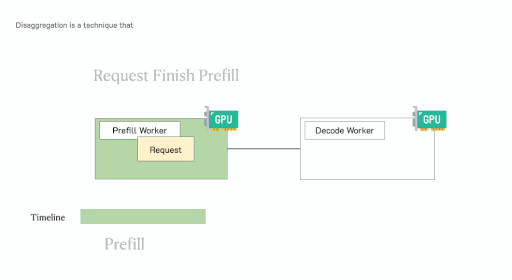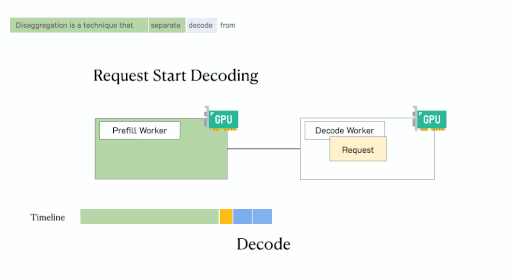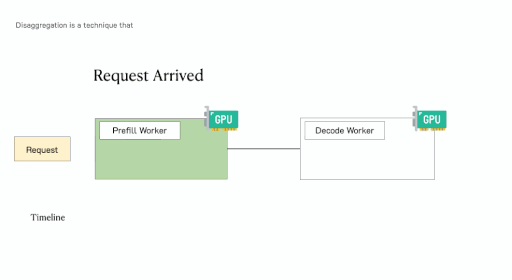
传统的大语言模型服务系统,将这两个特性迥异的阶段放在同一块GPU上处理。
预填充时,宝贵的内存带宽被闲置;解码时,强大的算力核心在打瞌睡。二者互相干扰,资源利用率极低。
这种结构性的冲突,导致了我们经常遇到的体验问题:要么是提交问题后要等很久才有第一个字(首个令牌时间,Time to First Token, TTFT长),要么是文字生成过程断断续续,不流畅(每输出令牌时间, Time Per Output Token, TPOT高)。
为了更科学地衡量服务质量,DistServe论文提出了有效吞吐量(Goodput)的概念。
它不再是简单地看系统一秒能处理多少请求,而是看在满足TTFT和TPOT这两个服务等级目标(Service Level Objective, SLO)的前提下,成功处理了多少请求。这才是用户真正能感知到的、有意义的性能指标。
一个简洁的方案解决了根本矛盾
DistServe的解决方案,其核心思想简单到可以用两个字概括:分开。
既然预填充和解码是两种完全不同的任务,那就把它们分配到不同的GPU实例上去执行。
这个看似简单的分离设计,从根本上消除了资源竞争。
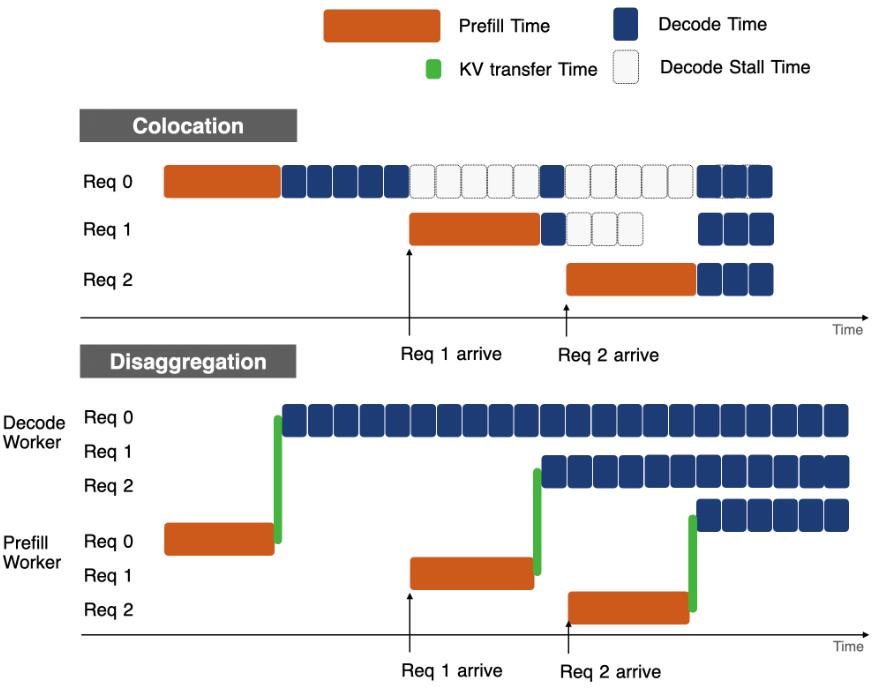
专门负责预填充的GPU实例,可以配置更多的计算资源,采用张量并行(Tensor Parallelism, TP)策略来分解巨大的矩阵运算,最大化算力利用。
专门负责解码的GPU实例,则可以配置更高的内存带宽,采用流水线并行(Pipeline Parallelism, PP)策略来高效处理源源不断的单令牌生成请求。
每个阶段都能在最适合自己的硬件配置和并行策略下运行,如同让举重冠军专心去举重馆,让短跑冠军专心去田径场。
分离后,一个显而易见的问题随之而来:预填充完成后生成的KV Cache,如何高效地传递给解码实例?如果这个传输过程耗时太长,分离带来的优势就会被抵消。
DistServe设计了一个带宽感知放置算法(Bandwidth-aware Placement Algorithm)来解决这个问题。
这个算法足够聪明,它会自动将执行预填充和解码任务的GPU实例,尽可能地部署在同一个物理服务器节点内。这样,它们之间的数据传输就可以利用服务器内部速度最快的NVLink高带宽总线。
为了让这套系统能够自动化运行,DistServe还设计了两大核心算法组件。
一个是放置算法(Placement Algorithm)。
它像一个运筹帷幄的将军,只需要告诉它模型大小、预期的工作负载(比如请求到达率、问题长度分布)、服务质量目标(TTFT/TPOT)以及服务器集群的网络结构,它就能在几秒钟内计算出最优的资源分配方案:需要多少个GPU,预填充和解码各分配多少,每个阶段具体采用什么样的并行策略,以及它们应该被放置在哪些物理服务器上。
另一个是在线调度(Online Scheduling)。
它采用了简单的先进先出(First-Come-First-Served, FCFS)策略,但加入了三个关键优化。
它会智能地组合或拆分请求,让每个批次的处理时间尽可能均衡,减少流水线中的气泡或空闲。
它采用拉取模式传输KV Cache,解码实例按需获取数据,避免了在流量洪峰时被数据淹没导致内存溢出。
系统会持续监控工作负载的变化,一旦发现用户行为模式发生显著改变(例如,平均问题长度突然增加),就会自动触发放置算法进行重规划,动态调整资源配置。
软件生态因此而重构
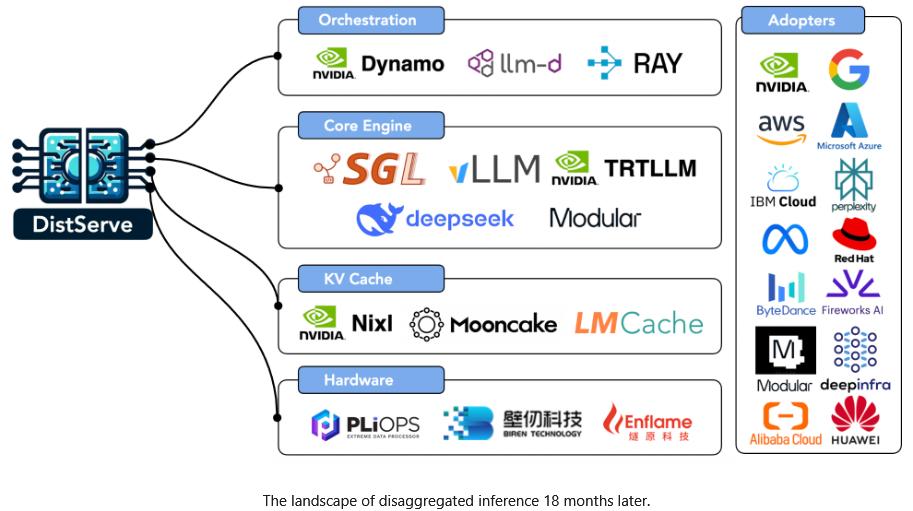
一个足够深刻的理论创新,必然会引发整个生态系统的连锁反应。DistServe的分离架构思想,在2025年迎来了产业界全面的接纳与集成,从最顶层的编排框架,到底层的核心引擎,都围绕这一思想进行了重构。
英伟达(NVIDIA)在2025年的GTC大会上发布的Dynamo框架,是这一思想产业化的里程碑。
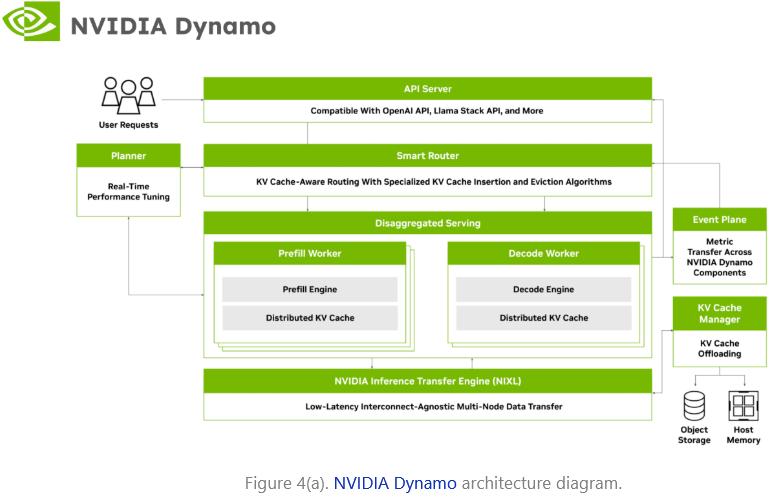
Dynamo将预填充和解码的工作节点(Worker)视为系统中的一等公民,通过一个KV感知路由器(KV-aware Router)来高效地分发请求。
它还拥有一个集中的GPU规划器(GPU Planner),能够持续分析所有GPU的状态,实现资源的自动扩缩容和负载均衡。
Dynamo底层集成了英伟达自家的NIXL(低延迟点对点推理传输库),将NVLink、InfiniBand、PCIe(高速串行计算机扩展总线标准)等多种传输硬件抽象为统一的接口,在最新的GB200 NVL72服务器架构上,创造了MLPerf(机器学习性能基准测试)的新纪录。
与此同时,基于Kubernetes(一个开源的容器编排系统)生态也涌现出llm-d这样的项目。
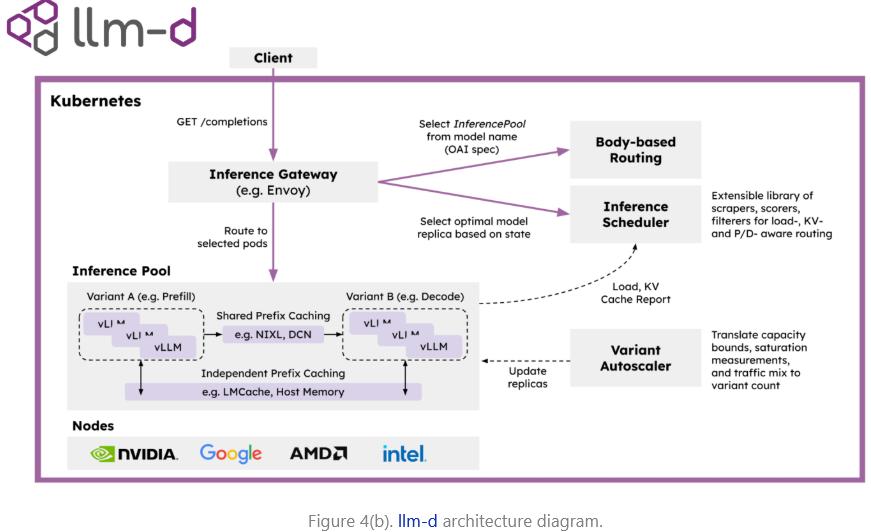
它将预填充和解码服务定义为两个可以独立部署和扩展的服务,天然支持在异构GPU集群中进行弹性部署,为云原生的多租户环境提供了强大的故障隔离和自动伸缩能力。
云计算服务商Ray也迅速跟进,其Ray Serve提供了一键式的分离推理部署方案,让开发者可以轻松地集成SGLang和vLLM等业界主流推理引擎。
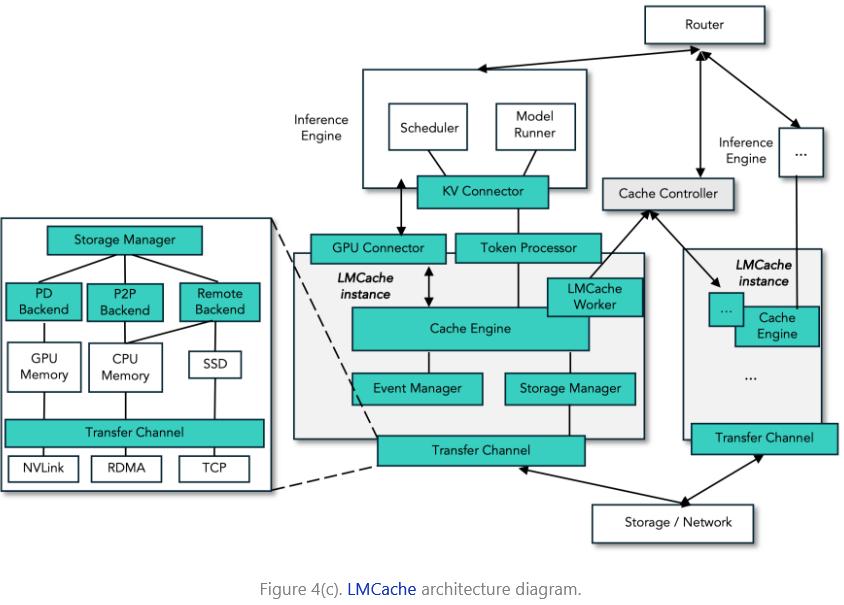
既然KV Cache是连接预填充和解码的桥梁,那么围绕它进行优化就成了新的焦点。芝加哥大学团队开发的LMCache,通过批量数据传输和I/O(输入/输出)流水线优化,极大地加速了KV Cache在不同实例间的移动。
而来自月之暗面(Kimi AI)团队的MoonCake项目,则将这一思想推向了极致。
它在FAST'25(一个顶级存储系统会议)上获得了最佳论文奖。
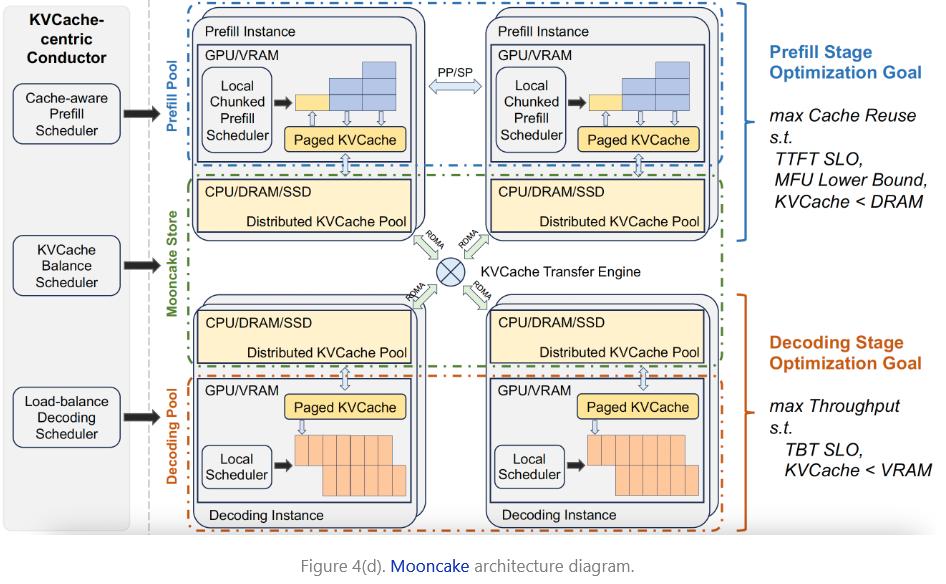
MoonCake构建了一个中心化的KV Cache平台,将集群中所有未被充分利用的存储介质,比如CPU(中央处理器)的DRAM(动态随机存取存储器)和SSD(固态硬盘),池化成一个统一的缓存资源。
这意味着,任何一个预填充实例完成计算后,可以将状态传递给集群中任何一个有空闲的解码实例,实现了资源的高度解耦和灵活调度。
SGLang作为领先的推理引擎,率先深度集成了分离架构。
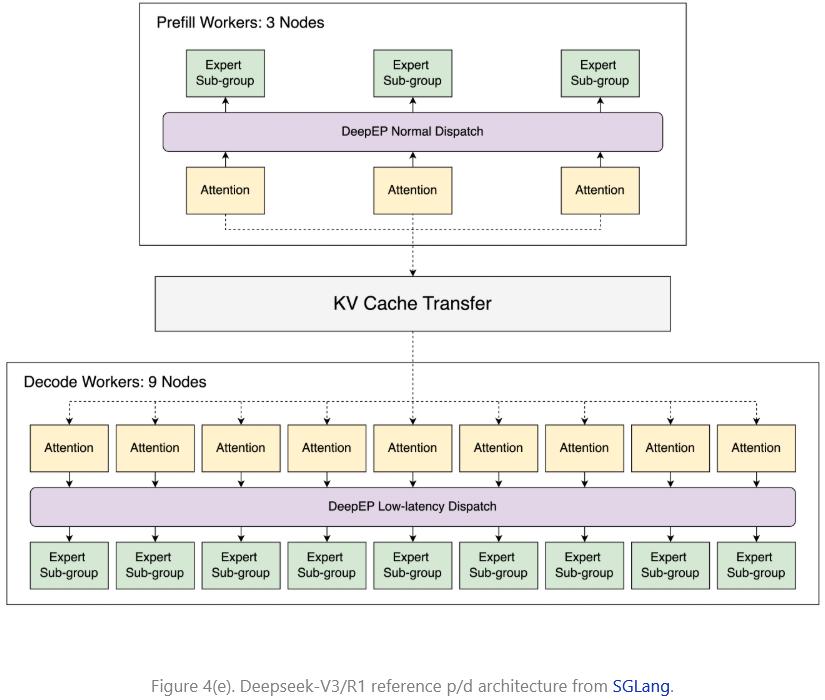
在一个由96个H100 GPU组成的集群中,研究人员为DeepSeek-R1模型配置了3个节点(24个GPU)进行预填充,9个节点(72个GPU)进行解码。
最终实现了每秒处理52.3k输入令牌和22.3k输出令牌的惊人吞吐量,首次在开源社区复现了DeepSeek官方博客公布的性能数据。
当这套系统迁移到2025年9月发布的GB200 NVL72服务器上时,预填充和解码的吞吐量又分别跃升了3.8倍和4.8倍。
另一款广受欢迎的引擎vLLM,在与llm-d 0.3版本结合后,在H200 GPU上也展现出强大的性能。
英伟达自家的TensorRT-LLM更是与Dynamo框架原生集成,在GB200 NVL72上运行DeepSeek-R1模型,实现了超过60k TPS(每秒处理的令牌数)的性能。
这些数据冰冷而精确,它们共同指向一个事实:分离架构已经不是一个停留在纸面上的理论,而是被业界最顶尖的软硬件公司和开源社区全面采纳,并转化为实实在在生产力的新标准。
DistServe的原始论文数据显示,在处理聊天、代码补全、文档摘要等多种任务时,其请求处理能力最高可以达到传统一体化系统(如vLLM)的4.48倍。在满足同样延迟约束的条件下,它能承受的请求压力是后者的10.2倍。
下面的表格清晰地展示了在处理ShareGPT数据集时,OPT-175B模型在不同请求速率下的服务质量(SLO)达成率。
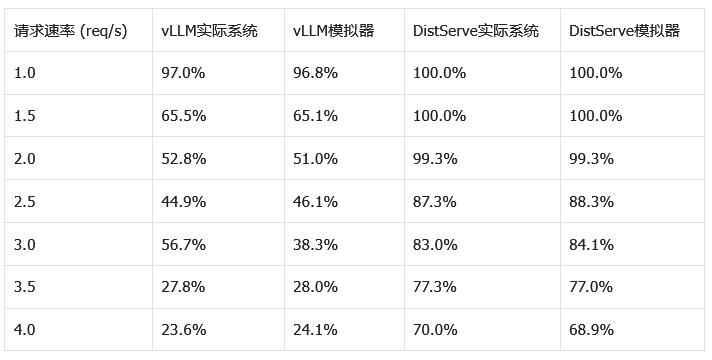
DistServe与vLLM在不同请求速率下的SLO达成率对比(OPT-175B, ShareGPT数据集)
可以看到,当请求速率增加到每秒4个时,DistServe依然能保证70%的请求满足服务质量要求,而vLLM系统在请求速率达到每秒2.5个时,达成率就已经跌破了45%。
如果说软件生态的全面拥抱,证明了分离架构的正确性,那么硬件厂商为其量身定制专用芯片,则是对这一思想的最高认可。
2025年9月,英伟达发布了一款名为Rubin CPX的全新GPU。
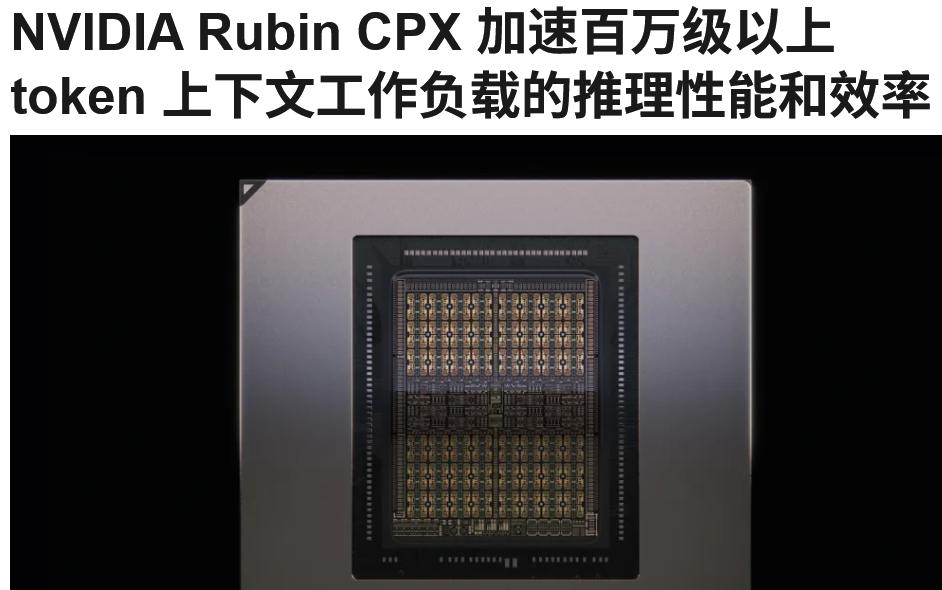
它的特殊之处在于,它不是一款通用GPU,而是一款专为长上下文预填充阶段设计的芯片。
它拥有惊人的30 PFLOPS(每秒千万亿次浮点运算)的NVFP4算力,配备128GB的GDDR7(第七代图形双倍数据速率内存),以及相比GB300 NVL72提升3倍的注意力机制计算加速。
Rubin CPX不会单独工作,它将与标准的Rubin GPU协同,构成一个完整的、硬件级别的分离式服务解决方案。
在Vera Rubin NVL144 CPX机架中,会包含144个标准Rubin GPU和144个Rubin CPX GPU,再加上36个Vera CPU。整个机架能提供高达8 EFLOPS(每秒百亿亿次浮点运算)的AI算力。
这个设计决策极具深意。
英伟达意识到,与其让昂贵的、配备HBM(高带宽内存)的通用GPU去执行计算密集但对内存带宽要求不那么极致的预填充任务,不如设计一款成本更低、算力更专注的芯片来专门处理。
Rubin CPX采用GDDR7而非更昂贵的HBM内存,就是出于这种成本效益的考量。
知名科技分析机构SemiAnalysis指出,Rubin CPX的发布,将迫使所有竞争对手重新审视自己的产品路线图。
如果AMD(超威半导体公司)和其它定制芯片厂商不能在下一代产品中推出类似的专用预填充芯片,他们的客户将在以token经济学为核心的AI市场中处于严重的成本劣势。
英伟达通过Dynamo软件框架 + Rubin CPX专用硬件的组合拳,再一次用软硬件协同的方式,将自己的生态护城河挖得更深。
从成本和能效来看,这一架构的优势同样显著。
根据SemiAnalysis InferenceMAX的基准测试数据,在处理一个1200亿参数的GPT模型时,GB200 NVL72服务器的总拥有成本(TCO)比传统的单节点系统优化了4倍。
在能效方面,GB200 NVL72每消耗一兆瓦电力所能生成的令牌数量,是上一代H200单节点的8倍。
回顾这18个月的技术演进,从2024年1月DistServe论文首次提交,到2025年9月英伟达发布Rubin CPX专用芯片,我们看到了一条清晰的脉络:一个源自第一性原理的深刻洞察,如何通过严谨的系统设计和工程实现,最终推动了整个产业的范式转移。
当然,分离架构并非没有挑战。
它增加了系统的复杂性,对工程实现能力提出了更高的要求。
这也是为什么在2024年,它的采用率还相对有限。KV Cache的跨节点传输、动态重规划算法的精确性、以及更多系统组件带来的运维复杂度,都是需要持续优化的工程问题。
但这些都无法掩盖其核心思想的光芒。
DistServe源于对真实世界工作负载的深刻理解,并提出简洁而根本的解决方案。
Hao AI Lab的工作不仅是单纯的性能提升,更重要的是,它建立了一套可组合、可优化的全新技术栈,为未来百万令牌上下文、复杂的智能体系统等更具挑战性的AI工作负载,铺平了道路。
参考资料:
https://hao-ai-lab.github.io/blogs/distserve-retro/
https://arxiv.org/pdf/2401.09670
https://hao-ai-lab.github.io/
END