360 FG-CLIP:全球最强双语视觉语言模型,细粒度理解新突破!
随着多模态技术的飞速发展,视觉与语言的精准对齐成为研究热点。FG-CLIP 作为 360 人工智能研究院推出的创新模型,专为解决细粒度视觉语言对齐问题而设计,尤其在中英文双语任务上取得了显著突破。
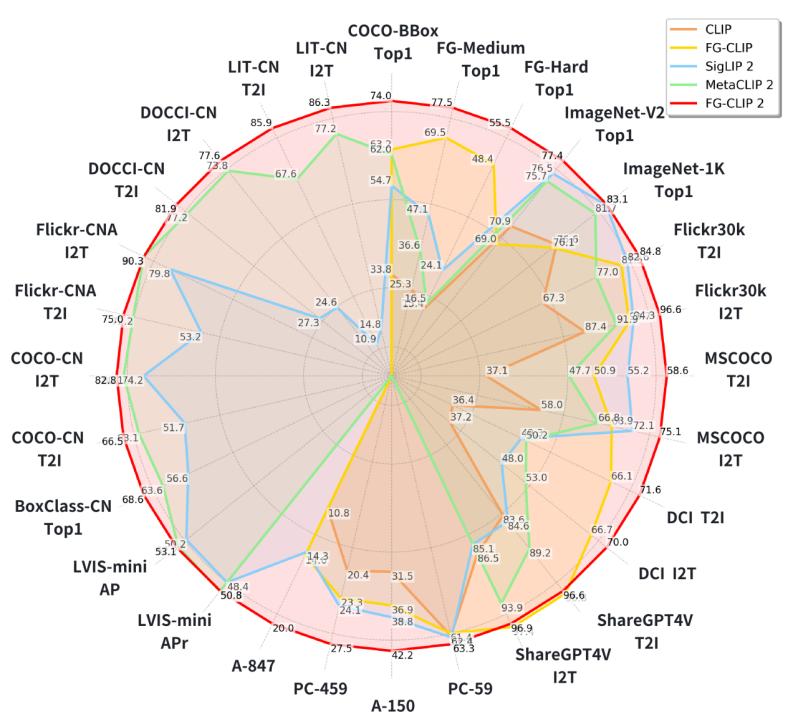
FG-CLIP 是由 360 人工智能研究院推出的双语细粒度视觉语言对齐模型,旨在提升图像与文本之间的精准匹配能力。该模型通过层次化对齐架构和丰富的细粒度监督信号,实现了对图像细节的精准理解,同时支持中英文双语任务。FG-CLIP 在 29 项权威基准测试中全面超越了 Google 的 SigLIP 2 和 Meta 的 MetaCLIP 2,展现出卓越的性能,成为全球领先的视觉语言模型。
(一)细粒度视觉语言理解
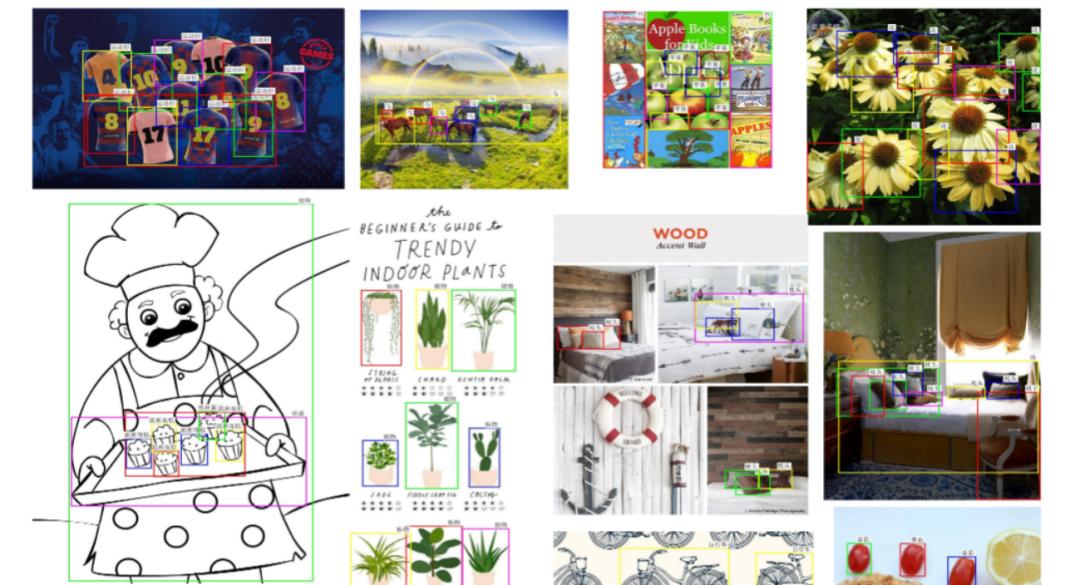
FG-CLIP 能精准理解图像中的细节信息,包括物体的属性、空间关系等,解决了传统模型在细粒度识别上的不足。例如,它能够区分相似物体的细微差别,如“红色的苹果”与“绿色的苹果”,并准确匹配对应的文本描述,显著提升了视觉与语言的对齐精度。
(二)双语支持
FG-CLIP 实现了中英文双语的原生支持,能够同时处理两种语言的任务。无论是在图像检索、物体识别还是语言描述生成中,它都能在中英文之间无缝切换,为多语言应用场景提供了强大的支持,尤其适合国际化应用。
(三)层次化对齐架构
FG-CLIP 采用层次化对齐架构,通过全局语义对齐和细粒度视觉语言学习,逐步提升模型对图像细节的理解能力。这种架构不仅能够把握宏观场景,还能精准定位微观细节,使模型在复杂场景下表现出色。
(四)动态注意力机制
FG-CLIP 引入了动态注意力机制,能够智能聚焦图像的关键区域。例如,在识别“戴帽子的人”时,模型会自动聚焦到人物的头部区域,从而更好地处理复杂的视觉语言任务,提高识别的准确性和效率。
(五)优化双语协同策略
FG-CLIP 通过优化双语协同策略,解决了中英文理解不平衡的问题。它在训练过程中引入了大量双语数据,确保模型在两种语言任务中都能达到较高的性能,提升了模型在多语言环境中的整体表现。
(一)两阶段分层学习框架
FG-CLIP 采用两阶段分层学习框架,逐步提升视觉 - 语言对齐能力。第一阶段通过大规模图像 - 文本对进行全局语义对齐,每对数据包含短文本描述和长文本描述,为跨模态理解奠定基础。第二阶段引入区域级监督信号和多种细粒度目标,进一步强化模型对局部细节的理解和区分能力。
(二)富细粒度监督信号
FG-CLIP 引入了丰富的细粒度监督信号,包括区域 - 文本匹配和长描述建模。例如,通过 RoIAlign 提取图像区域特征并与短语级描述对齐,提升细粒度视觉理解能力。同时,引入文本内模态对比损失(TIC),更好地区分语义相似的描述。
(三)双语多模态数据训练
FG-CLIP 在训练中使用大规模中英文图像 - 文本对,确保强大的双语性能。英文数据采用增强版 LAION-2B 数据集,中文数据则结合 Wukong、Zero 和大规模内部数据。这种双语数据策略使模型在两种语言任务中均表现出色。
(四)动态分辨率机制
FG-CLIP 采用动态分辨率机制,自适应处理不同尺寸的输入图像。模型根据输入图像的最大尺寸动态选择目标分辨率,避免不必要的缩放,确保训练和推理的一致性。这种机制显著提升了模型的灵活性和适应性。
(一)家庭机器人
FG-CLIP 能精准理解复杂家庭指令,如“拿起茶几上屏幕有裂痕的手机”,帮助机器人快速定位并执行任务。这种细粒度的理解能力显著提升机器人在家庭环境中的实用性和交互体验,使其能够更好地协助日常家务和照顾老人儿童。
(二)安防监控
在安防领域,FG-CLIP 可快速识别监控画面中的目标人物或物品,如“寻找戴黑色鸭舌帽的可疑人员”。其强大的视觉语言对齐能力提高了监控系统的效率和准确性,为公共安全和私人场所提供更可靠的保障。
(三)电商领域
FG-CLIP 能精准理解商品描述,提升“以文搜图”的精度,降低多语言标注成本。它支持中英文双语,帮助电商平台优化用户体验,快速匹配商品图片,提高购物效率,尤其在跨境电商业务中优势明显。
(四)自动驾驶
FG-CLIP 可准确识别道路环境中的物体和场景,如“识别前方车道上是否有障碍物”,为自动驾驶系统提供更可靠的视觉理解。其高并发响应速度和细粒度识别能力,显著提升了自动驾驶的安全性和可靠性。
(五)医疗影像
FG-CLIP 能辅助医生进行图像诊断,如“识别 X 光片中的异常区域”,帮助快速定位病变部位。其双语支持功能还可以用于多语言医疗报告生成,提升医疗影像诊断的效率和准确性。
(六)教育领域
FG-CLIP 可用于智能教育工具,如“识别图片中的物体并提供相关知识”,丰富教学内容。它支持中英文双语,帮助学生更好地理解视觉信息,提升学习体验,尤其在语言学习和科学教育中效果显著。
conda create -n FGCLIP2 python=3.10 -yconda activate FGCLIP2cd FG-CLIP && pip install -e .
(二)加载模型
import torchfrom PIL import Imagefrom transformers import (AutoImageProcessor,AutoTokenizer,AutoModelForCausalLM,)model_root = "fgclip2-base-patch16"model = AutoModelForCausalLM.from_pretrained(model_root,trust_remote_code=True).cuda()device = model.devicetokenizer = AutoTokenizer.from_pretrained(model_root)image_processor = AutoImageProcessor.from_pretrained(model_root)
(三)检索示例
def determine_max_value(image):w,h = image.sizemax_val = (w//16)*(h//16)if max_val > 784:return 1024elif max_val > 576:return 784elif max_val > 256:return 576elif max_val > 128:return 256else:return 128img_root = "cat_dfclor.jpg"image = Image.open(img_root).convert("RGB")image_input = image_processor(images=image, max_num_patches=determine_max_value(image), return_tensors="pt").to(device)# NOTE Short captions: max_length=64 walk_type="short"(default)# NOTE Long captions: max_length=196 walk_type="long"captions = ["一个简约风格的卧室角落,黑色金属衣架上挂着多件米色和白色的衣物,下方架子放着两双浅色鞋子,旁边是一盆绿植,左侧可见一张铺有白色床单和灰色枕头的床。","一个简约风格的卧室角落,黑色金属衣架上挂着多件红色和蓝色的衣物,下方架子放着两双黑色高跟鞋,旁边是一盆绿植,左侧可见一张铺有白色床单和灰色枕头的床。","一个简约风格的卧室角落,黑色金属衣架上挂着多件米色和白色的衣物,下方架子放着两双运动鞋,旁边是一盆仙人掌,左侧可见一张铺有白色床单和灰色枕头的床。","一个繁忙的街头市场,摊位上摆满水果,背景是高楼大厦,人们在喧闹中购物。"]captions = [caption.lower() for caption in captions]caption_input = tokenizer(captions, padding="max_length", max_length=196, truncation=True, return_tensors="pt").to(device)with torch.no_grad():image_feature = model.get_image_features(**image_input)text_feature = model.get_text_features(**caption_input,walk_type="long")image_feature = image_feature / image_feature.norm(p=2, dim=-1, keepdim=True)text_feature = text_feature / text_feature.norm(p=2, dim=-1, keepdim=True)logits_per_image = image_feature @ text_feature.Tlogit_scale, logit_bias = model.logit_scale.to(text_feature.device), model.logit_bias.to(text_feature.device)logits_per_image = logits_per_image * logit_scale.exp() + logit_bias
FG-CLIP 作为一款创新的双语细粒度视觉语言对齐模型,凭借其强大的技术架构和卓越的性能表现,为多模态理解领域带来了新的突破。其在多个应用场景中的广泛适用性,使其成为未来多模态技术发展的重要方向之一。
项目官网:https://360cvgroup.github.io/FG-CLIP/
Github 仓库:https://github.com/360CVGroup/FG-CLIP
arXiv 技术论文:https://arxiv.org/pdf/2510.10921
点亮“关注”,设为“星标”,精彩不迷路!与你携手探索AI的无限可能,精彩内容持续更新!🚀